Stable Diffusion kurz erklärt
Stable Diffusion ist ein quelloffenes latentes Diffusionsmodell (LDM): ein neuronales Netz, das darauf trainiert wurde, Zufallsrauschen nach und nach in ein Bild zu verwandeln, gesteuert von einem Text. Entwickelt wurde es von der CompVis-Gruppe der Ludwig-Maximilians-Universität München zusammen mit Runway und mit Rechenleistung von Stability AI auf Bildern trainiert, die die gemeinnützige Organisation LAION gesammelt hat. Die Methode stammt aus dem Paper High-Resolution Image Synthesis with Latent Diffusion Models (Rombach und Kollegen, CVPR 2022).
Die Gewichte wurden am 22. August 2022 veröffentlicht. Das ist der Teil, der alles verändert hat. DALL-E 2 und Midjourney gab es schon, aber hinter Wartelisten und Credits, auf fremden Servern. Stable Diffusion war eine 4 GB große Datei, die auf einer Grafikkarte mit 8 GB Speicher lief, ohne Konto und mit einem Sicherheitsfilter, den man abschalten konnte.
Innerhalb von Wochen kamen die Weboberflächen und das Inpainting, dann die Feintunings, die LoRAs und ControlNet. Vier Jahre später bedeutet der Name zweierlei. Im engen Sinn die Modellfamilie von 1.4 bis 3.5. Im weiten Sinn die ganze Praxis, Bildmodelle auf dem eigenen Rechner laufen zu lassen.
Was folgt, erklärt die Maschine selbst, mit dem Vokabular, das Ihnen in jeder Oberfläche begegnet: latenter Raum, VAE, U-Net, CLIP, Sampler, Guidance-Skala, Seed. Formeln sind nicht nötig, aber ein paar Zahlen helfen.
Wie funktioniert Stable Diffusion? Drei Netze und eine Schleife
Stable Diffusion ist nicht ein Netz, sondern drei, die nacheinander laufen.
- Ein Text-Encoder liest den Prompt und verwandelt ihn in eine Liste von Zahlen. Bei Stable Diffusion 1.5 sind das 77 Tokens, jedes durch 768 Zahlen beschrieben; 2.048 bei SDXL, das zwei Encoder verwendet.
- Ein Entrauscher, ein U-Net in den Versionen 1 bis XL und ein Transformer (MMDiT) ab Version 3, beginnt mit einem Block aus Zufallsrauschen und bereinigt ihn in 20 bis 30 Schritten, wobei er in jedem Schritt die Textzahlen konsultiert. Er arbeitet nicht auf Pixeln, sondern auf einer kompakten Fassung des Bildes, dem Latent, das im sogenannten latenten Raum lebt: 4 × 64 × 64 Zahlen für ein Bild mit 512 Pixeln, 4 × 128 × 128 für die 1024 Pixel von SDXL.
- Ein Decoder verwandelt dieses Latent in die endgültigen Pixelwerte, Rot, Grün und Blau: 3 × 512 × 512 oder 3 × 1024 × 1024 bei SDXL.
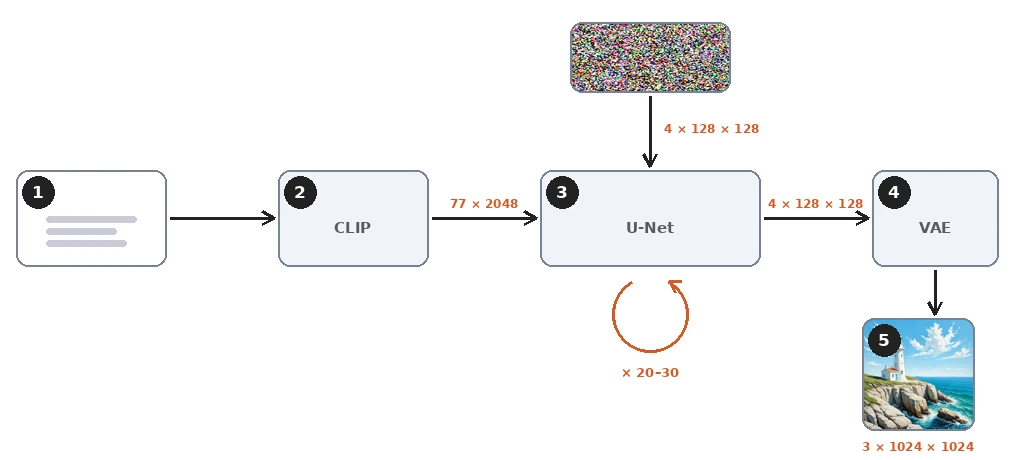
Dabei wird nichts gesucht und nichts kopiert. In der Datei steckt keine Bilddatenbank. Die 2 bis 16 GB Gewichte enthalten, was das Netz darüber gelernt hat, wie Bildunterschriften und Bilder zusammengehören, und jedes Ergebnis wird aus Rauschen berechnet. Das Netz kann sich dennoch Bilder einprägen, die im Training sehr oft vorkamen, und Forscher haben einige Hundert davon extrahiert, aber das ist die Ausnahme.
Was ist ein Diffusionsmodell? Lernen, Rauschen zu entfernen
Der Vorwärtsprozess: Rauschen hinzufügen
Die Idee hinter der Diffusion ist einfach zu formulieren. Man nimmt ein Foto mit seiner Bildunterschrift. Man fügt ihm eine dosierte Menge Zufallsrauschen hinzu. Man lässt ein Netz raten, welches Rauschen hinzugefügt wurde, wobei es die Bildunterschrift kennt. Man vergleicht seine Schätzung mit der Wahrheit und korrigiert das Netz ein wenig.
Das Hinzufügen des Rauschens ist der Vorwärtsprozess. Er folgt einem festen Schedule mit tausend Stufen, von einem leichten Korn bei Stufe 50 bis zu reinem Rauschen bei Stufe 999. Das Netz sieht den Schedule nie ablaufen; es sieht immer nur ein verrauschtes Bild auf einer Stufe.
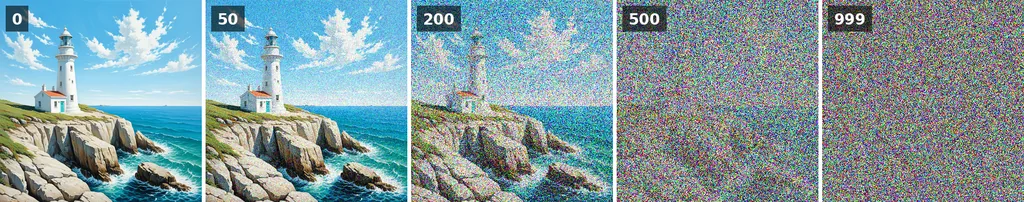
Macht man das über Milliarden von Beispielen, ist das Ergebnis ein Rauschprädiktor: Bekommt er ein verrauschtes Bild, dessen Rauschstufe und einen Text, sagt er, was das Rauschen wahrscheinlich ist. Das Trainingsziel ist schlicht der Abstand zwischen dem vorhergesagten und dem echten Rauschen. Das Training von Stable Diffusion 1 dauerte laut seiner Modellkarte etwa 150.000 Stunden auf A100-GPUs im Rechenzentrum.
Der Rückwärtsprozess: der Rauschprädiktor bei der Arbeit
Die Erzeugung lässt die Lektion rückwärts laufen. Das ist der Rückwärtsprozess. Man beginnt mit reinem Rauschen, das der Seed bestimmt. Man fragt den Prädiktor, was das Rauschen ist, entfernt einen Teil davon und fragt erneut. DDPM, das Paper von 2020, das die Diffusion praxistauglich machte, tat das in tausend kleinen Schritten.
Der Sampler, in manchen Oberflächen auch Scheduler genannt, ist die Regel, die festlegt, wie groß jeder Schritt ist und ob etwas frisches Rauschen wieder hinzugefügt wird. Bessere Sampler, DDIM, Euler und die DPM++-Familie, machen größere Schritte auf demselben Pfad, weshalb heute 20 bis 30 Schritte genügen.
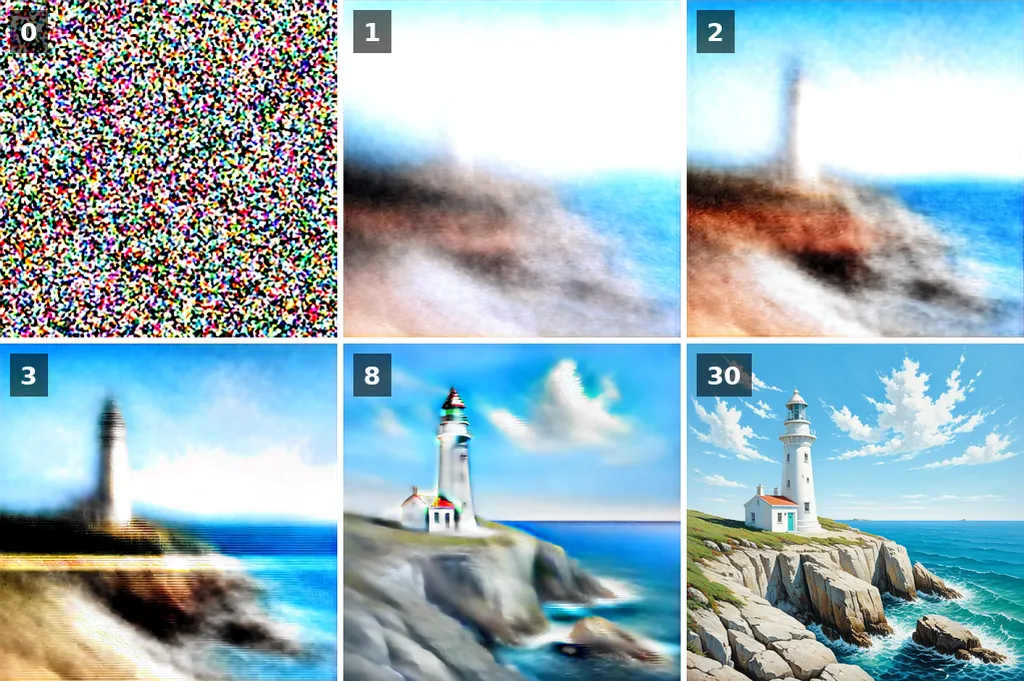
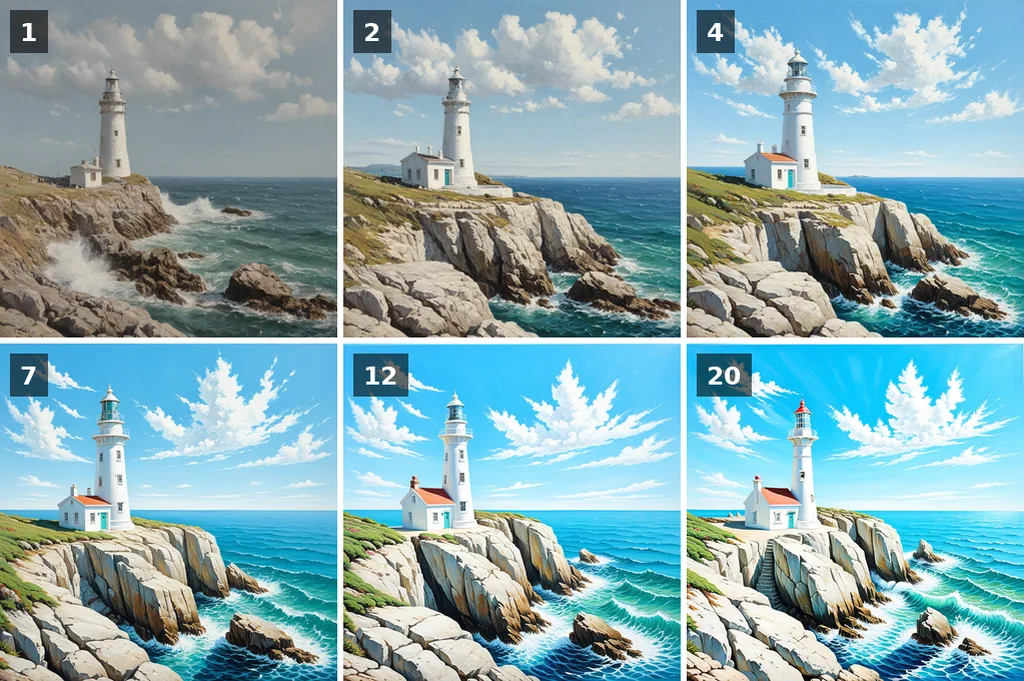
Die Abbildung zeigt den Teil, den man sich merken sollte. In jedem Schritt hält das Modell eine Schätzung des fertigen Bildes, und diese Schätzung steht früh fest. Die ersten zwei oder drei Schritte, solange das Rauschen stark ist, legen die Komposition fest: wo der Horizont liegt, wo der Leuchtturm steht, wie viel Himmel zu sehen ist. Die späteren Schritte verfeinern Textur und kleine Details.
Der Schieberegler unten geht alle dreißig Schätzungen desselben Renderings durch.
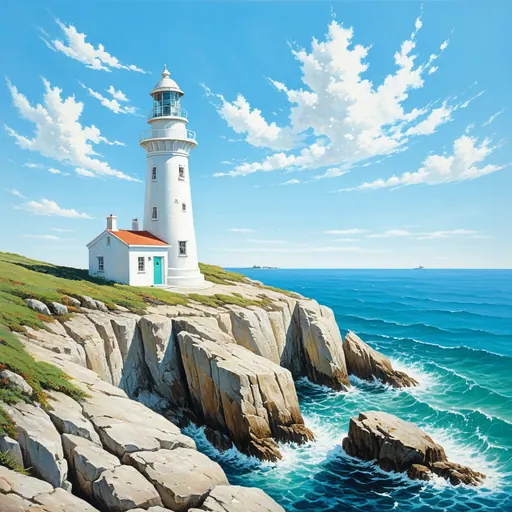
Daraus folgen zwei praktische Konsequenzen. Wer die Zahl der Schritte ändert, ändert die Details und manchmal die Komposition, weil die frühen Schritte auf anderen Werten landen; das Bild wird nicht einfach schärfer. Und derselbe Seed bei einer anderen Bildgröße startet von einem anderen Rauschblock, liefert also ebenfalls ein anderes Bild. Wählen Sie zuerst die Größe, dann suchen Sie einen Seed.
Latente Diffusion: der VAE-Trick, der es auf eine Gaming-Karte bringt
Frühere Diffusionsmodelle arbeiteten auf Pixeln. Ein Bild mit 512 × 512 Pixeln besteht aus 786.432 Zahlen, und der Prädiktor musste sie alle in jedem seiner Schritte lesen und schreiben. Pixelmodelle wie DALL-E 2 und Imagen umgingen das, indem sie bei 64 Pixeln diffundierten und Hochskalierungsnetze anhängten, und veröffentlicht wurden sie ohnehin nie.
Stable Diffusion fügt einen Variational Autoencoder hinzu, den VAE. Sein Encoder staucht ein Bild um den Faktor acht pro Seite in vier Kanäle: 4 × 64 × 64, also 16.384 Zahlen, 48-mal weniger. Die Diffusion läuft vollständig in diesem komprimierten Raum, dem latenten Raum. Erst ganz am Ende erweitert der Decoder des VAE das Ergebnis zu Pixeln.

Das Latent ist kein kleines Bild. Seine vier Kanäle sind ein Code, den der Decoder zu lesen weiß, und kein einzelner Kanal sieht ganz wie das Bild aus. Aber die Anordnung überlebt die Kompression, und genau das erlaubt dem Entrauscher, die Komposition in einem so kleinen Raum festzulegen.
Deshalb beeinflusst auch die Wahl des VAE Farbe und feine Details: Jede latente Zahl steht für einen 8 × 8 Pixel großen Ausschnitt, und der Decoder erfindet, was darin liegt. Stable Diffusion 3 wechselte genau aus diesem Grund zu einem Latent mit 16 Kanälen, und feine Details und kleiner Text wurden damit besser.
CLIP und Cross-Attention: wie der Text das Bild steuert
Drei Bausteine verwandeln Wörter in eine Richtung für den Entrauscher.
Tokenizer und Text-Encoder: wie CLIP einen Prompt liest
Der Tokenizer zerlegt den Prompt in Tokens, ganze häufige Wörter oder Bruchstücke seltenerer. Stable Diffusion 1.5 und SDXL lesen höchstens 77 Tokens, zwei davon Start- und Endmarker, also etwa 50 bis 60 englische Wörter. Darüber hinaus wird der Text abgeschnitten, sofern die Oberfläche ihn nicht in mehrere Durchgänge aufteilt. Setzen Sie das Wichtigste an den Anfang.
Der Text-Encoder von 1.5 ist CLIP, ein Netz, das OpenAI auf 400 Millionen Paaren aus Bildern und Bildunterschriften trainiert hat, mit einer einzigen Aufgabe: die Zahlen, die eine Bildunterschrift beschreiben, nah an die Zahlen zu bringen, die ihr Bild beschreiben. Nach diesem Training tragen die Zahlen für „lighthouse“ bereits in sich, wie Leuchttürme aussehen. SDXL betreibt zwei solche Encoder nebeneinander, der zweite ein offener Nachbau, von LAION auf zwei Milliarden Paaren neu trainiert. Stable Diffusion 3 ergänzt einen dritten, T5, der ganze Sätze liest.
Cross-Attention im U-Net
Cross-Attention ist der Ort, an dem der Text auf das Bild trifft. Das U-Net ist ein Stapel von Faltungsblöcken, die das Latent verkleinern und wieder vergrößern, mit Skip-Verbindungen zwischen gleich großen Stufen. Zwischen diesen Blöcken sitzen Attention-Schichten. In jedem Schritt schaut jede Region des Latents auf die 77 Token-Vektoren und gewichtet, welche davon sie betreffen. Die Himmelsregion achtet auf „sunset“ und „clouds“, der Fels auf „cliff“. Deshalb wirken sich Wortreihenfolge, Wiederholung und die Gewichtungssyntax der Oberflächen aus, und deshalb färbt ein Stilwort am Anfang das ganze Bild.
Das ist auch die Grenze der ersten Versionen. CLIP hat aus kurzen Alt-Texten gelernt, versteht also Listen von Motiven und Stilen gut und Beziehungen zwischen ihnen schlecht. „A red cube on a blue sphere“ kommt in 1.5 oft vertauscht heraus. Der Prompt-Leitfaden zeigt, was zuverlässig funktioniert.
Guidance-Skala, Negativ-Prompt und Seed: die drei Einstellungen
Drei Einstellungen tauchen in jeder Stable-Diffusion-Oberfläche auf. Sie entsprechen direkt der Mechanik von oben.
Die Guidance-Skala, die CFG-Skala, kurz für classifier-free guidance (CFG), entscheidet, wie stark der Text durchgesetzt wird. In jedem Schritt macht der Entrauscher tatsächlich zwei Vorhersagen: eine mit dem Prompt und eine mit einem leeren Prompt. Die Differenz der beiden ist die Richtung, die der Prompt vorgibt. Die endgültige Vorhersage ist die leere plus diese Differenz, multipliziert mit der Guidance-Skala. Bei 1 wird die Vorhersage mit Prompt unverändert übernommen, ohne Schub: Das Bild folgt dem Text nur lose, mit matten Farben und einem grauen Himmel, wo der Prompt einen blauen verlangt hat. Um 5 bis 8 folgt es dem Prompt eng, mit natürlichen Farben. Jenseits von 12 wird der Kontrast hart, die Farben übersättigen und die Pinselstriche werden grob.
Der Negativ-Prompt ersetzt den leeren Prompt dieser zweiten Vorhersage. Statt nichts zu lesen, liest der zweite Durchgang „blurry, text, watermark“, und die Guidance drängt davon weg. Das kostet nichts extra, da der zweite Durchgang ohnehin läuft, und es wirkt nur, wenn die Guidance über 1 liegt. Der Leitfaden zum Negativ-Prompt liefert bewährte Listen.
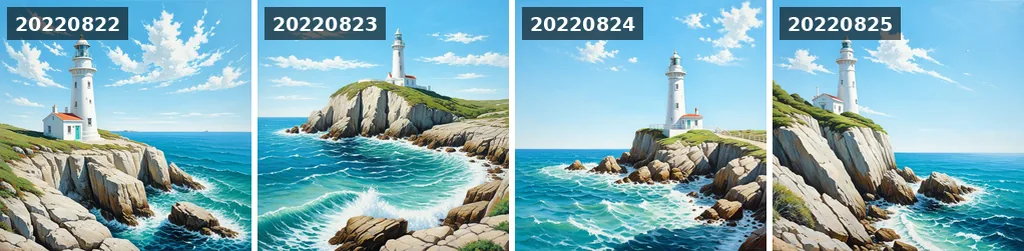
Der Seed ist die Zahl, aus der das Startrauschen erzeugt wird. Gleicher Seed, gleicher Prompt, gleiche Einstellungen und gleiches Modell ergeben auf derselben Software und Hardware dasselbe Bild, bis aufs Pixel; eine andere Oberfläche oder eine andere Karte zieht das Rauschen anders. Ändern Sie den Seed, ändert sich die Komposition, weil die ersten Schritte einen anderen Rauschblock lesen. Ändern Sie ein Wort des Prompts und behalten den Seed, bleibt das Bild meist weitgehend erhalten. So verfeinert man einen Prompt.
Vom U-Net zum Transformer: die Versionen von 1.5 bis 3.5
Sechs Hauptgenerationen erschienen in zwei Jahren, die ersten beiden von CompVis und Runway, die übrigen von Stability AI. Jede veränderte mindestens eines der drei Netze.
| Version | Datum | Entrauscher | Text-Encoder | Native Größe |
|---|---|---|---|---|
| 1.4 und 1.5 | August und Oktober 2022 | U-Net, 860 Millionen Parameter | CLIP ViT-L | 512 px |
| 2.0 und 2.1 | November und Dezember 2022 | U-Net gleicher Bauart, von Grund auf neu trainiert | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Juli 2023 | U-Net, 2,6 Milliarden, plus ein Refiner | CLIP ViT-L und OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | November 2023 | SDXL, destilliert auf 1 bis 4 Schritte | Wie SDXL | 512 px |
| 3 Medium | Juni 2024 | Diffusion-Transformer (MMDiT), 2 Milliarden | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Oktober 2024 | MMDiT, 8 Milliarden; Medium 2,5 Milliarden | Dieselben drei | 1024 px |
1.5 bleibt eines der am häufigsten feingetunten Modelle überhaupt, mit Zehntausenden Community-Checkpoints und LoRAs, und es läuft noch immer mit 4 GB Grafikspeicher. SDXL ist das Arbeitspferd: bessere Hände, Gesichter und Komposition und native Ausgabe mit 1024 Pixeln. 3 und 3.5 ersetzten das U-Net durch einen Transformer, der Text- und Bild-Tokens gemeinsam verarbeitet, was endlich lesbaren Text in Bildern möglich machte: Setzen Sie die Wörter im Prompt in Anführungszeichen. Der Vergleich SDXL gegen Stable Diffusion 3 zeigt dieselben Prompts auf beiden.
Auch die Lizenzen änderten sich. 1.5 steht unter der Lizenz CreativeML OpenRAIL-M und SDXL unter OpenRAIL++-M, beide frei für die kommerzielle Nutzung mit einer Liste verbotener Verwendungen. Die 3.x-Modelle stehen unter der Stability AI Community License, kostenlos unter einer Million Dollar Jahresumsatz.
Was man damit machen kann: Bild-zu-Bild, Inpainting, ControlNet, LoRA
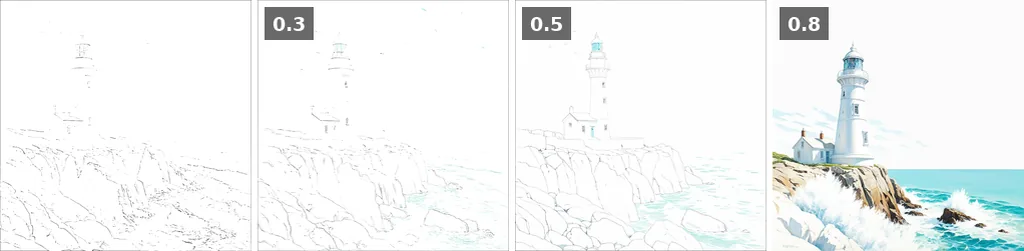
Text-zu-Bild ist nur der Anfang, denn jedes Teil der Pipeline lässt sich wiederverwenden. Kodieren Sie eine Skizze in ein Latent, fügen Sie nur einen Teil des Rauschens hinzu und entrauschen Sie von dort aus, und Sie haben Bild-zu-Bild, img2img in den Oberflächen: Die Einstellung Stärke, oder Denoise, ist die Menge an Rauschen, die Sie hinzufügen. Die Idee stammt aus SDEdit. Maskieren Sie einen Bereich des Latents, und Sie haben Inpainting, oder Outpainting, wenn die Maske außerhalb des Bildrahmens liegt. Hängen Sie ein kleines Nebennetz an, das eine Pose, eine Tiefenkarte oder Kanten liest, und Sie haben ControlNet. Trainieren Sie ein paar Millionen zusätzliche Gewichte auf zwanzig Fotos, und Sie haben ein LoRA, das dem Modell ein Gesicht oder einen Stil beibringt. Das Hochskalieren übernehmen eigene Superresolution-Modelle.
Um es selbst zu betreiben, reicht eine aktuelle NVIDIA-Karte mit 6 GB Grafikspeicher (VRAM) für 1.5 und 8 GB für SDXL. AMD-Karten laufen über ROCm, Apple Silicon über das MPS-Backend. Der Installations-Leitfaden behandelt die drei wichtigsten Oberflächen. Ohne Karte brauchen die Werkzeuge dieser Seite keine Hardware: Stable Diffusion XL und Stable Diffusion 1.5 laufen auf der GPU der Seite mit live angezeigter Warteschlange, dokumentierte Prompts zeigen, was jede Einstellung bewirkt, und 1.731 Künstlerstile zeigen, was das Modell über Maler gelernt hat.
Stable Diffusion vs. Midjourney vs. DALL-E
Gegenüber Midjourney und den Bildmodellen von OpenAI liegt der Unterschied nicht in der Qualität, sondern in der Kontrolle. Die Gewichte sind öffentlich und das Modell läuft lokal: Ihre Bilder bleiben auf Ihrer Festplatte, Sie wählen das Modell, Sie setzen den Seed und Sie können jede Komponente austauschen. Dafür verlangt es mehr von Ihnen. Midjourney verlangt einen Satz und liefert ein poliertes Bild; Stable Diffusion verlangt ein Modell, einen Prompt, einen Negativ-Prompt und eine Guidance-Skala und liefert genau das, was Sie eingestellt haben.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Gewichte | Öffentlich, herunterladbar | Geschlossen | Geschlossen |
| Läuft auf dem eigenen Rechner | Ja, 6 bis 8 GB VRAM | Nein | Nein |
| Preis | Lokal kostenlos; kostenlose Werkzeuge online | Abo | Abo oder pro Bild |
| Kontrolle | Seed, Modell, LoRA, ControlNet, Inpainting, jede Einstellung | Parameter und Stilreferenzen | Konversation |
| Feintuning | Ja, durch jeden | Nein | Nein |
| Text in Bildern | Schwach vor 3, gut ab 3.5 | Gut seit v6 | Sehr gut |
Dasselbe Diffusionsprinzip treibt heute Modelle anderer Labore an, mit anderen Encodern und anderen Lizenzen: FLUX von Black Forest Labs, gegründet von den ursprünglichen Autoren von Stable Diffusion, und Qwen-Image von Alibaba. Sie laufen in denselben Oberflächen, mit denselben Seeds, Schritten und Samplern, sodass das meiste auf dieser Seite übertragbar bleibt. Ihre Guidance funktioniert anders, FLUX dev hat keinen Negativ-Prompt, und sie bevorzugen ganze Sätze gegenüber Stichwortlisten.
Quellen und Weiterverwendung der Abbildungen
Die Primärquellen, in der Reihenfolge, in der die Seite ihnen begegnet:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: das Stable-Diffusion-Paper.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: Vorwärts- und Rückwärtsprozess und der Schedule mit tausend Schritten.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho und Salimans, 2022: die Guidance-Skala.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, und Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL und Stable Diffusion 3.
Weiterverwendung der Abbildungen. Die Renderings und Diagramme auf dieser Seite stehen unter CC BY 4.0: Verwenden Sie sie in einem Kurs, einem Vortrag oder einem Artikel, mit einem Link auf diese Seite. Jedes Rendering verwendet Stable Diffusion XL, euler, 30 Schritte, CFG 6, Seed 20220822, den Prompt unten und den Negativ-Prompt „text, watermark, signature, blurry, low quality, storm, dark clouds, sunset“.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesDiese Seite zitieren.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion