Stable Diffusion בקצרה
Stable Diffusion הוא מודל דיפוזיה לטנטי (LDM) בקוד פתוח: רשת נוירונים שאומנה להפוך רעש אקראי לתמונה, מעט בכל פעם, בהכוונה של טקסט. הוא נבנה על ידי קבוצת CompVis מאוניברסיטת לודוויג מקסימיליאן במינכן יחד עם Runway, ואומן בכוח מחשוב של Stability AI על תמונות שאסף הארגון ללא מטרות רווח LAION. השיטה מגיעה מהמאמר High-Resolution Image Synthesis with Latent Diffusion Models (Rombach ועמיתיו, CVPR 2022).
המשקלים פורסמו ב-22 באוגוסט 2022. זה החלק ששינה הכול. DALL-E 2 ו-Midjourney כבר היו קיימים, אבל מאחורי רשימות המתנה וקרדיטים, על שרתים של מישהו אחר. Stable Diffusion היה קובץ של 4 GB שרץ על כרטיס מסך עם 8 GB זיכרון, בלי חשבון ועם מסנן בטיחות שאפשר לכבות.
בתוך שבועות הגיעו ממשקי הווב וה-inpainting, ואחריהם ה-fine-tunes, ה-LoRAs ו-ControlNet. ארבע שנים אחר כך השם מציין שני דברים. במובן הצר, משפחת המודלים מ-1.4 עד 3.5. במובן הרחב, כל הפרקטיקה של הרצת מודלי תמונה על המחשב שלכם.
ההמשך מסביר את המכונה עצמה, עם אוצר המילים שתפגשו בכל ממשק: מרחב לטנטי, VAE, U-Net, CLIP, sampler, guidance scale, seed. לא צריך אף נוסחה, אבל כמה מספרים עוזרים.
איך Stable Diffusion עובד? שלוש רשתות ולולאה אחת
Stable Diffusion אינו רשת אחת אלא שלוש, שרצות זו אחר זו.
- מקודד טקסט קורא את הפרומפט והופך אותו לרשימת מספרים. ב-Stable Diffusion 1.5 אלה 77 טוקנים, שכל אחד מהם מתואר ב-768 מספרים; 2,048 ב-SDXL, שמריץ שני מקודדים.
- denoiser, U-Net בגרסאות 1 עד XL וטרנספורמר (MMDiT) מגרסה 3 והלאה, מתחיל מבלוק של רעש אקראי ומנקה אותו לאורך 20 עד 30 צעדים, תוך התייעצות עם מספרי הטקסט בכל צעד. הוא לא עובד על פיקסלים אלא על גרסה דחוסה של התמונה, ה-latent, שחי במה שנקרא המרחב הלטנטי: 4 × 64 × 64 מספרים לתמונה של 512 פיקסלים, 4 × 128 × 128 ל-1024 הפיקסלים של SDXL.
- מפענח הופך את ה-latent הזה לערכי הפיקסלים הסופיים, אדום, ירוק וכחול: 3 × 512 × 512, או 3 × 1024 × 1024 ב-SDXL.
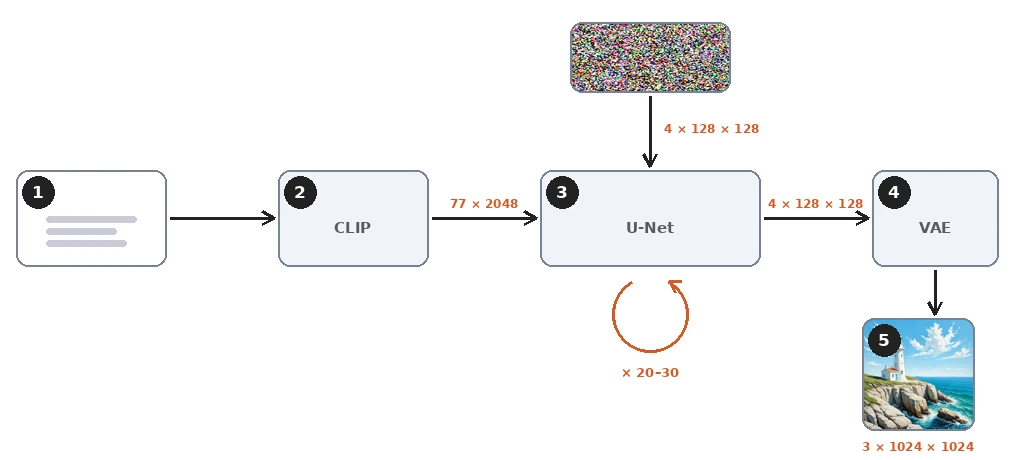
בדרך לא מתבצעים שום חיפוש ושום העתקה. אין מאגר תמונות בתוך הקובץ. המשקלים, 2 עד 16 GB, מחזיקים את מה שהרשת למדה על הקשר בין כיתובים לתמונות, וכל פלט מחושב מרעש. הרשת עדיין יכולה לשנן תמונות שהופיעו פעמים רבות באימון, וחוקרים חילצו כמה מאות מהן, אבל זה היוצא מן הכלל.
מה זה מודל דיפוזיה? ללמוד להסיר רעש
התהליך הקדמי: הוספת רעש
את הרעיון שמאחורי דיפוזיה קל לנסח. קחו תצלום עם הכיתוב שלו. הוסיפו לו כמות מדודה של רעש אקראי. בקשו מרשת לנחש איזה רעש נוסף, כשהיא מכירה את הכיתוב. השוו את הניחוש שלה לאמת ותקנו את הרשת מעט.
הוספת הרעש היא התהליך הקדמי (forward process). היא עוקבת אחרי סולם קבוע (schedule) של אלף רמות, מגרעיניות קלה ברמה 50 ועד רעש טהור ברמה 999. הרשת לעולם לא רואה את לוח הזמנים רץ; היא רואה רק תמונה רועשת אחת ברמה אחת בכל פעם.
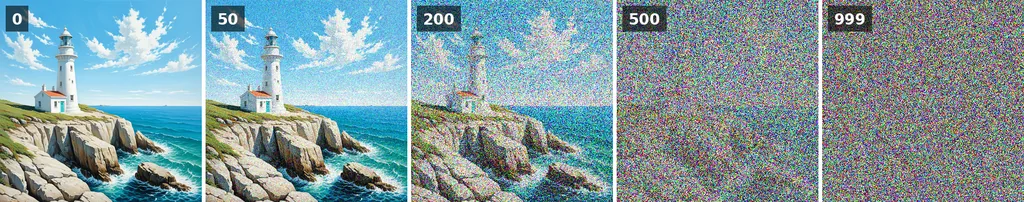
עשו את זה על מיליארדי דוגמאות והתוצאה היא מנבא רעש: בהינתן תמונה רועשת, רמת הרעש שלה וטקסט, הוא אומר מה הרעש כנראה. מטרת האימון היא בסך הכול הפער בין הרעש החזוי לרעש האמיתי. אימון Stable Diffusion 1 לקח כ-150,000 שעות על מעבדי A100 של מרכזי נתונים, לפי כרטיס המודל שלו.
התהליך ההפוך: מנבא הרעש בפעולה
היצירה מריצה את הלקח לאחור. זה התהליך ההפוך (reverse process). מתחילים מרעש טהור, שאותו בוחר ה-seed. שואלים את המנבא מה הרעש, מסירים חלק ממנו, שואלים שוב. DDPM, המאמר מ-2020 שהפך דיפוזיה למעשית, עשה את זה באלף צעדים קטנים.
ה-sampler, שנקרא גם scheduler בחלק מהממשקים, הוא הכלל שקובע כמה גדול כל צעד והאם מוסיפים בחזרה מעט רעש טרי. samplers טובים יותר, DDIM, Euler ומשפחת DPM++, עושים צעדים גדולים יותר לאורך אותו מסלול, ולכן 20 עד 30 צעדים מספיקים היום.
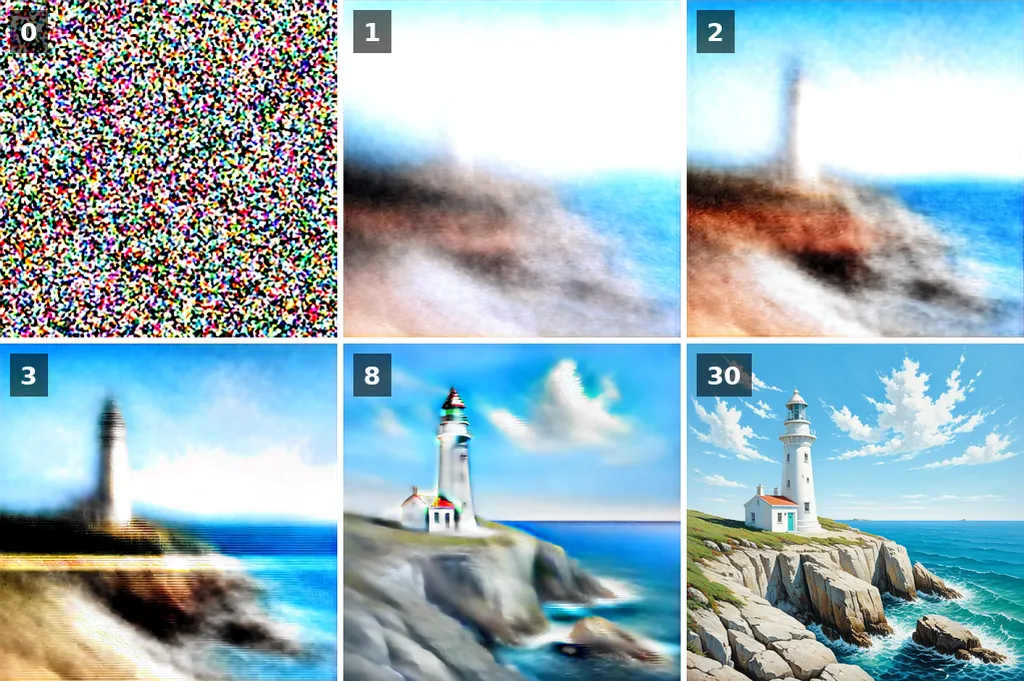
האיור מראה את החלק ששווה לזכור. בכל צעד המודל מחזיק ניחוש של התמונה המוגמרת, והניחוש מתייצב מוקדם. שניים-שלושה הצעדים הראשונים, כשהרעש עדיין כבד, קובעים את הקומפוזיציה: איפה האופק, איפה עומד המגדלור, כמה שמיים יש. הצעדים המאוחרים יותר מלטשים מרקם ופרטים קטנים.
המחוון שלמטה עובר על כל שלושים הניחושים של אותו רינדור.
מכאן נובעות שתי מסקנות מעשיות. שינוי מספר הצעדים משנה את הפרטים ולפעמים את הקומפוזיציה, כי הצעדים הראשונים נוחתים על ערכים אחרים; הוא לא פשוט מחדד את אותה תמונה. ואותו seed בגודל תמונה אחר מתחיל מבלוק רעש אחר, ולכן נותן גם הוא תמונה אחרת. קודם בוחרים גודל, ואז מחפשים seed.
דיפוזיה לטנטית: הטריק של ה-VAE שמאפשר להריץ אותו על כרטיס משחקים
מודלי דיפוזיה מוקדמים יותר עבדו על פיקסלים. תמונה של 512 × 512 היא 786,432 מספרים, והמנבא היה צריך לקרוא ולכתוב את כולם בכל אחד מצעדיו. מודלי פיקסלים כמו DALL-E 2 ו-Imagen עקפו את זה בדיפוזיה ב-64 פיקסלים ובהוספת רשתות הגדלה, ובכל מקרה הם מעולם לא שוחררו.
Stable Diffusion מוסיף variational autoencoder, ה-VAE. המקודד שלו דוחס תמונה בפקטור שמונה בכל ציר לארבעה ערוצים: 4 × 64 × 64, או 16,384 מספרים, פי 48 פחות. הדיפוזיה רצה כולה במרחב הדחוס הזה, המרחב הלטנטי. רק בסוף ממש המפענח של ה-VAE מרחיב את התוצאה לפיקסלים.

ה-latent אינו תמונה קטנה. ארבעת הערוצים שלו הם קוד שהמפענח יודע לקרוא, ואף ערוץ בודד לא נראה ממש כמו התמונה. אבל הפריסה שורדת את הדחיסה, וזה מה שמאפשר ל-denoiser להכריע על קומפוזיציה במרחב כל כך קטן.
זו גם הסיבה שבחירת ה-VAE משפיעה על צבע ועל פרטים עדינים: כל מספר לטנטי מייצג ריבוע של 8 × 8 פיקסלים, והמפענח ממציא מה נמצא בתוך הריבוע. Stable Diffusion 3 עבר ל-latent של 16 ערוצים בדיוק מהסיבה הזאת, ופרטים עדינים וטקסט קטן השתפרו איתו.
CLIP ו-cross-attention: איך הטקסט מכוון את התמונה
שלושה חלקים הופכים מילים לכיוון עבור ה-denoiser.
Tokenizer ומקודד טקסט: איך CLIP קורא פרומפט
ה-tokenizer חותך את הפרומפט לטוקנים, מילים נפוצות שלמות או חלקים של מילים נדירות יותר. Stable Diffusion 1.5 ו-SDXL קוראים לכל היותר 77 טוקנים, שניים מהם סמני התחלה וסוף, בערך 50 עד 60 מילים באנגלית. מעבר לזה הטקסט נחתך, אלא אם הממשק מפצל אותו לכמה מקטעים. שימו את מה שחשוב ביותר בהתחלה.
מקודד הטקסט של 1.5 הוא CLIP, רשת ש-OpenAI אימנה על 400 מיליון זוגות של תמונות וכיתובים, עם משימה אחת: לקרב את המספרים שמתארים כיתוב למספרים שמתארים את התמונה שלו. אחרי האימון הזה, המספרים של "lighthouse" כבר מכילים את המראה של מגדלורים. SDXL מריץ שני מקודדים כאלה זה לצד זה, השני אימון-מחדש פתוח של LAION על שני מיליארד זוגות. Stable Diffusion 3 מוסיף שלישי, T5, שקורא משפטים שלמים.
Cross-attention בתוך ה-U-Net
Cross-attention הוא המקום שבו הטקסט פוגש את התמונה. ה-U-Net הוא רצף של בלוקי קונבולוציה שמכווצים את ה-latent ואז מגדילים אותו בחזרה, עם skip connections בין גדלים תואמים. בין הבלוקים האלה יושבות שכבות attention. בכל צעד, כל אזור ב-latent מסתכל על 77 וקטורי הטוקנים ושוקל אילו מהם נוגעים לו. אזור השמיים שם לב ל-"sunset" ול-"clouds", הסלע ל-"cliff". זו הסיבה שלסדר המילים, לחזרות ולתחביר המשקלים של הממשקים יש השפעה, ושמילת סגנון בהתחלה צובעת את כל התמונה.
זה גם הגבול של הגרסאות הראשונות. CLIP למד מטקסטים חלופיים קצרים, ולכן הוא מבין היטב רשימות של נושאים וסגנונות ומבין גרוע יחסים ביניהם. "A red cube on a blue sphere" יוצא לעתים קרובות הפוך ב-1.5. מדריך הפרומפטים מראה מה עובד באופן אמין.
Guidance scale, פרומפט שלילי ו-seed: שלוש ההגדרות
שלוש הגדרות מופיעות בכל ממשק של Stable Diffusion. הן ממופות ישירות למנגנון שתואר למעלה.
ה-guidance scale, קיצור של הנחיה ללא מסווג (classifier-free guidance, CFG), הוא זה שקובע כמה חזק הטקסט נדחף. בכל צעד ה-denoiser למעשה מבצע שתי תחזיות: אחת עם הפרומפט ואחת עם פרומפט ריק. ההפרש בין השתיים הוא הכיוון שהפרומפט נותן. התחזית הסופית היא התחזית הריקה ועוד ההפרש הזה כפול ה-guidance scale. ב-1 התחזית עם הפרומפט משמשת כמות שהיא, בלי דחיפה: התמונה עוקבת אחרי הטקסט באופן רופף, עם צבעים עמומים ושמיים אפורים במקום שבו הפרומפט ביקש כחולים. סביב 5 עד 8 היא עוקבת אחרי הפרומפט מקרוב עם צבעים טבעיים. מעבר ל-12 הניגודיות מתקשחת, הצבעים מתרווים ומשיכות המכחול נעשות גסות.
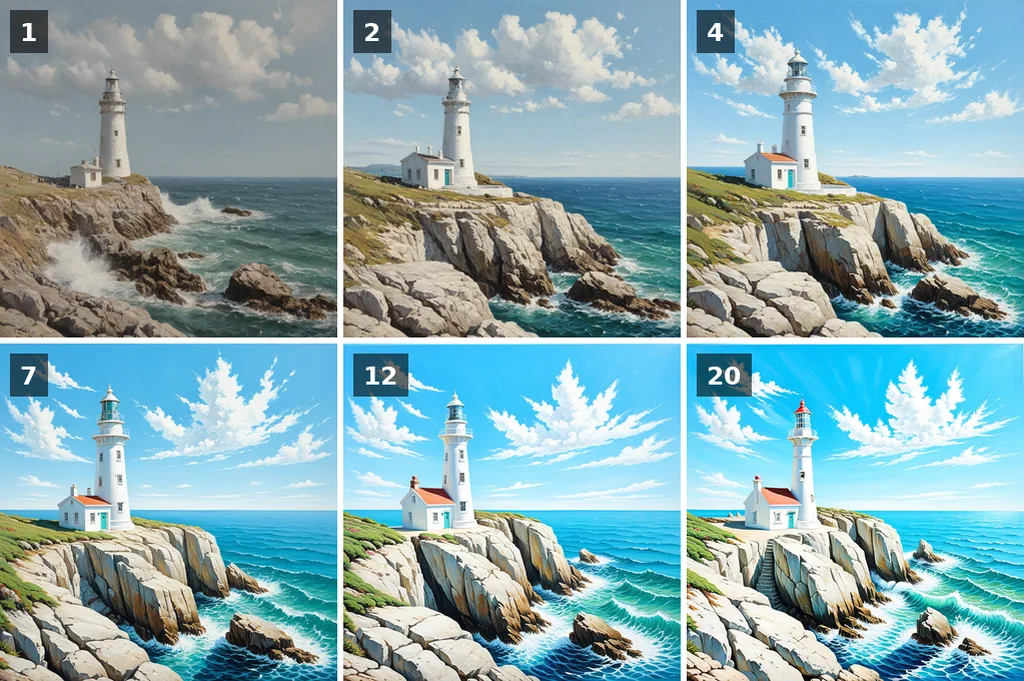
הפרומפט השלילי מחליף את הפרומפט הריק של התחזית השנייה. במקום לקרוא כלום, המעבר השני קורא "blurry, text, watermark", וה-guidance דוחף הרחק ממנו. זה לא עולה שום דבר נוסף, כי המעבר השני רץ ממילא, וזה עובד רק כשה-guidance מעל 1. מדריך הפרומפט השלילי נותן רשימות שעובדות.
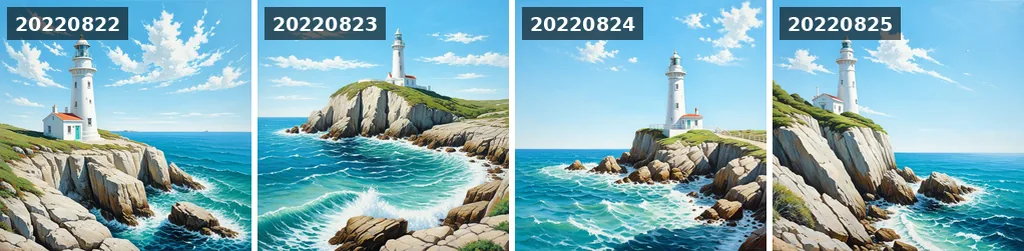
ה-seed הוא המספר שמייצר את רעש ההתחלה. אותו seed, אותו פרומפט, אותן הגדרות ואותו מודל נותנים את אותה תמונה, עד הפיקסל, על אותן תוכנה וחומרה; ממשק אחר או כרטיס אחר מגרילים את הרעש אחרת. שנו את ה-seed והקומפוזיציה משתנה, כי הצעדים הראשונים קוראים בלוק רעש אחר. שנו מילה אחת בפרומפט ושמרו על ה-seed, ורוב התמונה בדרך כלל נשארת. כך מלטשים פרומפט.
מ-U-Net לטרנספורמר: הגרסאות מ-1.5 עד 3.5
שישה דורות עיקריים הופיעו בשנתיים, שני הראשונים מ-CompVis ו-Runway, השאר מ-Stability AI. כל אחד שינה לפחות אחת משלוש הרשתות.
| גרסה | תאריך | Denoiser | מקודדי טקסט | גודל טבעי |
|---|---|---|---|---|
| 1.4 ו-1.5 | אוגוסט ואוקטובר 2022 | U-Net, 860 מיליון פרמטרים | CLIP ViT-L | 512 px |
| 2.0 ו-2.1 | נובמבר ודצמבר 2022 | U-Net באותו תכנון, אומן מחדש מאפס | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | יולי 2023 | U-Net, 2.6 מיליארד, ועוד refiner | CLIP ViT-L ו-OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | נובמבר 2023 | SDXL מזוקק ל-1 עד 4 צעדים | כמו SDXL | 512 px |
| 3 Medium | יוני 2024 | Diffusion transformer (MMDiT), 2 מיליארד | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | אוקטובר 2024 | MMDiT, 8 מיליארד; Medium 2.5 מיליארד | אותם שלושה | 1024 px |
1.5 נשאר אחד המודלים עם הכי הרבה fine-tunes בעולם, עם עשרות אלפי checkpoints ו-LoRAs מהקהילה, והוא עדיין רץ על 4 GB של זיכרון וידאו. SDXL הוא סוס העבודה: ידיים, פנים וקומפוזיציה טובות יותר, ופלט טבעי של 1024 פיקסלים. 3 ו-3.5 החליפו את ה-U-Net בטרנספורמר שמטפל בטוקני טקסט ותמונה יחד, וזה מה שסוף סוף אפשר טקסט קריא בתמונות: שימו את המילים במירכאות בפרומפט. ההשוואה בין SDXL ל-Stable Diffusion 3 מראה את אותם פרומפטים על שניהם.
גם הרישיונות השתנו. 1.5 נמצא תחת רישיון CreativeML OpenRAIL-M ו-SDXL תחת OpenRAIL++-M, שניהם חופשיים לשימוש מסחרי עם רשימת שימושים אסורים. מודלי 3.x נמצאים תחת Stability AI Community License, חופשי מתחת למיליון דולר הכנסה שנתית.
מה אפשר לעשות איתו: image-to-image, inpainting, ControlNet, LoRA
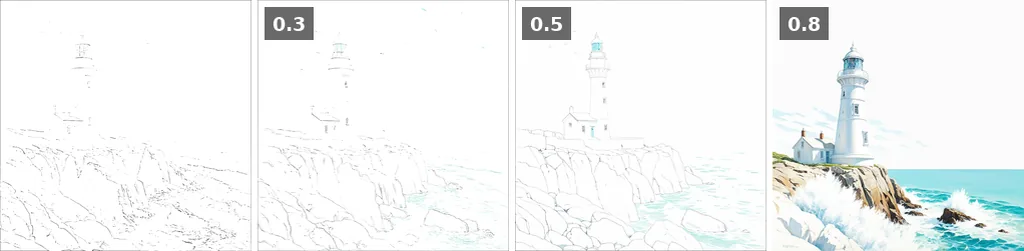
טקסט לתמונה הוא רק ההתחלה, כי כל חלק בצינור העיבוד ניתן לשימוש חוזר. קודדו סקיצה ל-latent, הוסיפו רק חלק מהרעש והסירו רעש משם, וקיבלתם image-to-image, img2img בממשקים: הגדרת ה-strength, או denoise, היא כמה רעש מוסיפים. הרעיון מגיע מ-SDEdit. מסכו אזור אחד ב-latent וקיבלתם inpainting, או outpainting כשהמסכה מחוץ לפריים. הוסיפו רשת צדדית קטנה שקוראת תנוחה, מפת עומק או קווי מתאר, וקיבלתם ControlNet. אמנו כמה מיליוני משקלים נוספים על עשרים תצלומים וקיבלתם LoRA שמלמד את המודל פנים או סגנון. מודלי super-resolution ייעודיים מטפלים בהגדלת תמונות.
כדי להריץ את זה בעצמכם, כרטיס NVIDIA עדכני עם 6 GB של זיכרון וידאו (VRAM) מספיק ל-1.5 ו-8 GB ל-SDXL. כרטיסי AMD עובדים דרך ROCm, Apple Silicon דרך ה-backend של MPS. מדריך ההתקנה מכסה את שלושת הממשקים העיקריים. בלי כרטיס, הכלים באתר הזה לא צריכים שום חומרה: Stable Diffusion XL ו-Stable Diffusion 1.5 רצים על ה-GPU של האתר עם תור שמוצג בזמן אמת, פרומפטים מתועדים מראים מה כל הגדרה עושה, ו-1,731 סגנונות אמנים מראים מה המודל למד על ציירים.
Stable Diffusion מול Midjourney מול DALL-E
מול Midjourney ומודלי התמונה של OpenAI, ההבדל אינו באיכות אלא בשליטה. המשקלים פומביים והמודל רץ מקומית: התמונות שלכם נשארות על הדיסק שלכם, אתם בוחרים את המודל, אתם קובעים את ה-seed ואתם יכולים להחליף כל רכיב. בתמורה הוא דורש מכם יותר. Midjourney מבקש משפט ונותן תמונה מלוטשת; Stable Diffusion מבקש מודל, פרומפט, פרומפט שלילי ו-guidance scale, ונותן לכם בדיוק את מה שהגדרתם.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| משקלים | פומביים, ניתנים להורדה | סגורים | סגורים |
| רץ על המחשב שלכם | כן, 6 עד 8 GB של VRAM | לא | לא |
| מחיר | חינם מקומית; כלים חינמיים אונליין | מנוי | מנוי או לפי תמונה |
| שליטה | Seed, מודל, LoRA, ControlNet, inpainting, כל הגדרה | פרמטרים ורפרנסים לסגנון | שיחה |
| Fine-tuning | כן, על ידי כל אחד | לא | לא |
| טקסט בתמונות | חלש לפני 3, טוב מ-3.5 | טוב מאז v6 | טוב מאוד |
אותו עקרון דיפוזיה מניע היום מודלים ממעבדות אחרות, עם מקודדים אחרים ורישיונות אחרים: FLUX של Black Forest Labs, שהוקמה על ידי המחברים המקוריים של Stable Diffusion, ו-Qwen-Image של Alibaba. הם רצים באותם ממשקים, עם אותם seeds, צעדים ו-samplers, ולכן רוב הדף הזה תקף גם להם. ה-guidance שלהם עובד אחרת, ל-FLUX dev אין פרומפט שלילי, והם מעדיפים משפטים מלאים על פני רשימות מילות מפתח.
מקורות, ואיך לעשות שימוש חוזר באיורים
המקורות הראשוניים, לפי סדר הופעתם בדף:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach ואחרים, 2022: המאמר של Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho ואחרים, 2020: התהליך הקדמי וההפוך וסולם אלף הצעדים.
- Learning Transferable Visual Models From Natural Language Supervision, Radford ואחרים, 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho ו-Salimans, 2022: ה-guidance scale.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, ו-Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL ו-Stable Diffusion 3.
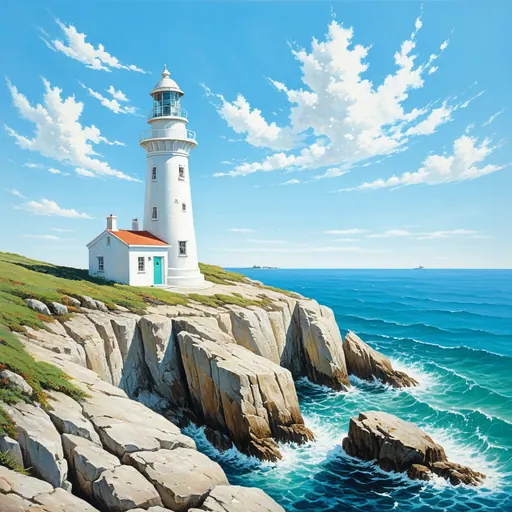
שימוש חוזר באיורים. הרינדורים והתרשימים בדף הזה משוחררים תחת CC BY 4.0: השתמשו בהם בקורס, בהרצאה או במאמר עם קישור לדף הזה. כל רינדור משתמש ב-Stable Diffusion XL, euler, 30 צעדים, CFG 6, seed 20220822, הפרומפט שלמטה, והפרומפט השלילי "text, watermark, signature, blurry, low quality, storm, dark clouds, sunset".
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesלציטוט הדף הזה.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion