Stable Diffusion を一言で
Stable Diffusion はオープンソースの潜在拡散モデル(LDM)です。ランダムなノイズを、文章に導かれながら少しずつ一枚の絵に変えていくよう学習したニューラルネットワークです。ミュンヘンのルートヴィヒ・マクシミリアン大学の CompVis グループが Runway とともに開発し、Stability AI の計算資源を使って、非営利団体 LAION が収集した画像で学習されました。手法は論文 High-Resolution Image Synthesis with Latent Diffusion Models(Rombach ら、CVPR 2022)に基づいています。
重みは2022年8月22日に公開されました。すべてを変えたのはこの点です。DALL-E 2 や Midjourney はすでに存在していましたが、順番待ちとクレジット制の向こう側、他人のサーバーの上にありました。Stable Diffusion は 4 GB のファイルで、メモリ 8 GB のグラフィックカードで動き、アカウントは不要で、セーフティフィルターは自分で切れるものでした。
数週間のうちに Web インターフェースとインペインティングが登場し、続いて追加学習モデル、LoRA、ControlNet が生まれました。四年後の今、この名前は二つの意味を持ちます。狭い意味では、1.4 から 3.5 までのモデル群。広い意味では、画像モデルを自分のマシンで動かすという営み全体です。
以下では、どのインターフェースでも出会う語彙を使って、この機械そのものを説明します。潜在空間、VAE、U-Net、CLIP、サンプラー、ガイダンススケール、シード。数式は要りませんが、いくつかの数字は役に立ちます。
Stable Diffusion の仕組み:三つのネットワークと一つのループ
Stable Diffusion は一つのネットワークではなく、順番に動く三つのネットワークです。
- テキストエンコーダがプロンプトを読み、数値の列に変えます。Stable Diffusion 1.5 では 77 トークンで、それぞれが 768 個の数値で表されます。二つのエンコーダを動かす SDXL では 2,048 個です。
- ノイズ除去器は、バージョン 1 から XL までは U-Net、バージョン 3 以降はトランスフォーマー(MMDiT)で、ランダムなノイズの塊から出発し、20〜30 ステップかけてノイズを取り除いていきます。各ステップでテキストの数値を参照します。扱うのはピクセルではなく、画像の圧縮版である潜在表現(latent)で、これは潜在空間と呼ばれる場所にあります。512 ピクセルの画像なら 4 × 64 × 64 個、SDXL の 1024 ピクセルなら 4 × 128 × 128 個の数値です。
- デコーダがその潜在表現を最終的なピクセル値、つまり赤・緑・青に変えます。3 × 512 × 512、SDXL では 3 × 1024 × 1024 です。
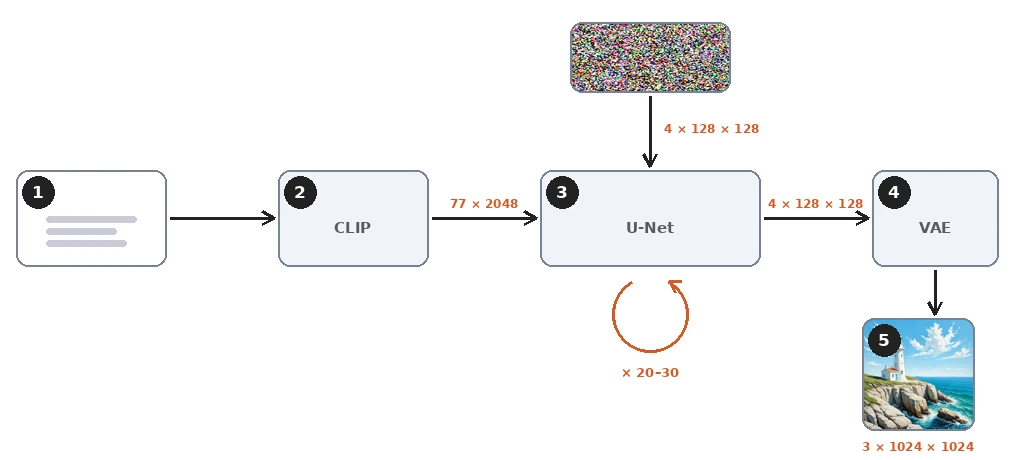
この過程で何かを検索したり複製したりすることはありません。ファイルの中に画像のデータベースはありません。2〜16 GB の重みが保持しているのは、キャプションと画像がどう結びつくかについてネットワークが学んだことであり、出力はすべてノイズから計算されます。それでも、学習時に何度も現れた画像をネットワークが記憶することはあり、研究者はそのうち数百枚を抽出していますが、それは例外です。
拡散モデルとは?ノイズを取り除くことを学ぶ
順過程:ノイズを加える
拡散の考え方は、言葉にすれば単純です。キャプション付きの写真を一枚用意します。そこに決まった量のランダムノイズを加えます。キャプションを知らされたネットワークに、どんなノイズが加えられたかを当てさせます。その答えを正解と比べ、ネットワークを少しだけ修正します。
ノイズを加える側が順過程(forward process)です。千段階の固定スケジュールに従い、レベル 50 のかすかな粒子から、レベル 999 の完全な砂嵐まで進みます。ネットワークがこのスケジュールの進行を見ることはなく、一度に見るのは、あるレベルのノイズ画像一枚だけです。
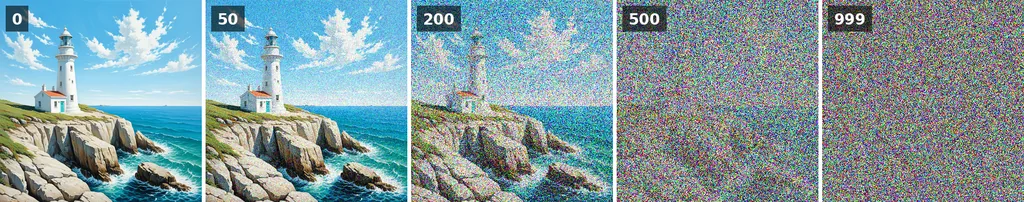
これを数十億の例で繰り返すと、ノイズ予測器ができあがります。ノイズの乗った画像、そのノイズレベル、そして文章を与えると、ノイズがおそらく何であるかを答えます。学習の目的関数は、予測したノイズと実際のノイズの差だけです。モデルカードによれば、Stable Diffusion 1 の学習にはデータセンター用 GPU の A100 で約 150,000 時間かかりました。
逆過程:ノイズ予測器を働かせる
生成は、この学習を逆向きに実行します。それが逆過程(reverse process)です。シードが選んだ純粋なノイズから出発します。予測器にノイズが何かを尋ね、その一部を取り除き、また尋ねます。拡散を実用的にした2020年の論文 DDPM は、これを千回の小さなステップで行っていました。
サンプラー(インターフェースによってはスケジューラとも呼ばれます)は、各ステップの大きさと、少量の新しいノイズを戻すかどうかを決める規則です。DDIM、Euler、DPM++ 系といった優れたサンプラーは、同じ経路をより大きな歩幅で進みます。今日では 20〜30 ステップで足りるのはそのためです。
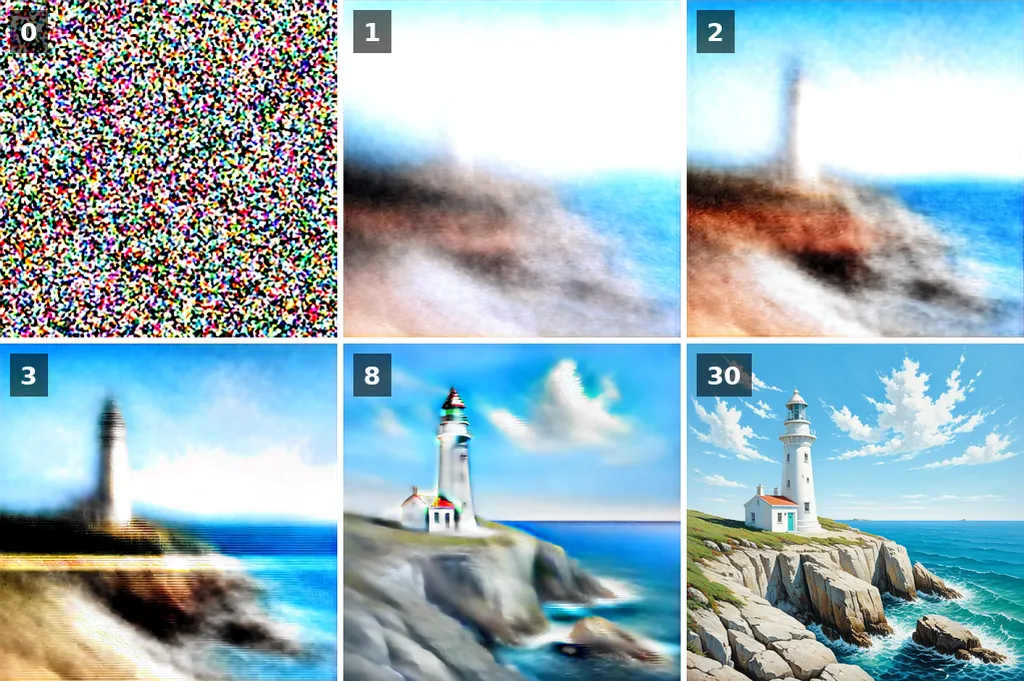
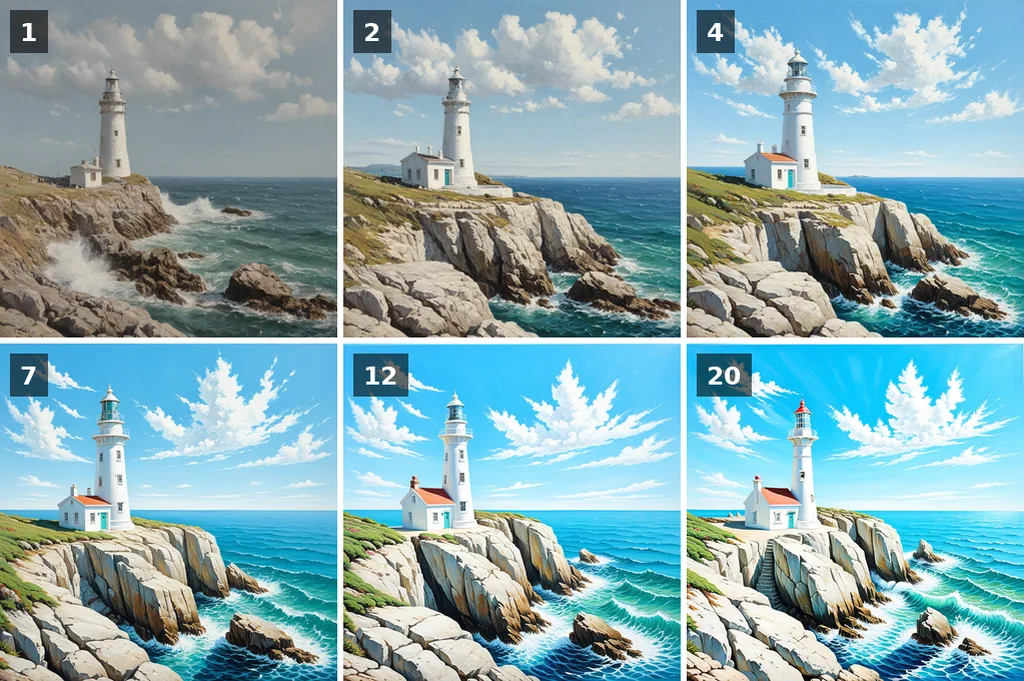
この図が示しているのが、覚えておくべき要点です。モデルは各ステップで完成画像の推定を持っており、その推定は早い段階で落ち着きます。ノイズがまだ重い最初の二、三ステップで構図が決まります。水平線の位置、灯台の立つ場所、空の広さです。後のステップは質感と細部を磨きます。
下のスライダーは、同じ生成の三十の推定すべてを順に見せます。
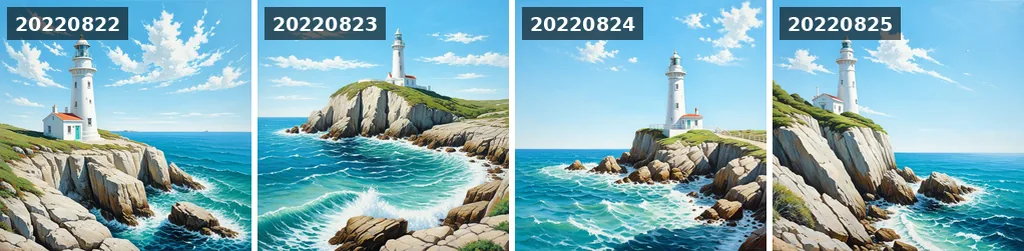
ここから実用上の帰結が二つ出てきます。ステップ数を変えると細部が変わり、ときには構図も変わります。初期のステップが別の値に着地するからで、同じ絵がただ鮮明になるわけではありません。また、同じシードでも画像サイズが違えば出発点のノイズの塊が別物になるため、やはり別の絵になります。まずサイズを決め、それからシードを探してください。
潜在拡散:ゲーミング用カードに収める VAE の工夫
初期の拡散モデルはピクセルを直接扱っていました。512 × 512 の画像は 786,432 個の数値で、予測器は各ステップでそのすべてを読み書きしなければなりませんでした。DALL-E 2 や Imagen のようなピクセルモデルは、64 ピクセルで拡散してから拡大用のネットワークを足すことで回避しましたが、いずれにせよ公開されることはありませんでした。
Stable Diffusion は変分オートエンコーダ、つまり VAE を加えます。そのエンコーダは画像を縦横それぞれ八分の一に圧縮し、四つのチャンネルにします。4 × 64 × 64、つまり 16,384 個の数値で、48 分の 1 です。拡散はこの圧縮された空間、潜在空間の中だけで実行されます。最後の最後に VAE のデコーダが結果をピクセルに展開します。

潜在表現は小さな絵ではありません。その四つのチャンネルはデコーダが読み方を知っている符号であり、どのチャンネルも単独では画像にあまり似ていません。しかし配置は圧縮後も保たれるので、ノイズ除去器はこの小さな空間の中で構図を決められるのです。
VAE の選択が色や細部に影響するのもこのためです。潜在表現の数値一つは 8 × 8 ピクセルの区画に対応し、その区画の中身はデコーダが作り出します。Stable Diffusion 3 がまさにこの理由で 16 チャンネルの潜在表現に移行し、細部と小さな文字がそれで改善しました。
CLIP とクロスアテンション:文章はどう画像を導くのか
言葉をノイズ除去器を導く方向に変えるのは、三つの部品です。
トークナイザーとテキストエンコーダ:CLIP はプロンプトをどう読むか
トークナイザーはプロンプトをトークンに切り分けます。よくある単語はそのまま一語、珍しい単語は断片にします。Stable Diffusion 1.5 と SDXL が読めるのは最大 77 トークンで、うち二つは開始と終了の印です。英語で 50〜60 語ほどです。それを超えた文章は、インターフェースが複数のパスに分割しないかぎり切り捨てられます。最も重要なものを先頭に置いてください。
1.5 のテキストエンコーダは CLIP です。OpenAI が 4 億組(400M)の画像とキャプションで学習させたネットワークで、課題はただ一つ、キャプションを表す数値を、その画像を表す数値に近づけることでした。この学習の後では、「lighthouse(灯台)」の数値がすでに灯台の見た目を含んでいます。SDXL はこうしたエンコーダを二つ並べて動かし、二つ目は LAION が 20 億組で再学習したオープンなものです。Stable Diffusion 3 はさらに三つ目として、文全体を読む T5 を加えます。
U-Net の中のクロスアテンション
クロスアテンションは、文章と絵が出会う場所です。U-Net は、潜在表現を縮小してから元の大きさに戻す畳み込みブロックの積み重ねで、同じサイズ同士がスキップ接続で結ばれています。それらのブロックの間にアテンション層があります。各ステップで、潜在表現の各領域が 77 個のトークンベクトルを見て、どれが自分に関係するかを重み付けします。空の領域は「sunset」と「clouds」に注目し、岩は「cliff」に注目します。語順、繰り返し、インターフェースの重み付け記法が効果を持つのはこのためで、先頭に置いたスタイル語が画像全体を染めるのもこのためです。
これは初期バージョンの限界でもあります。CLIP は短い alt テキストから学んだため、被写体やスタイルの列挙はよく理解しますが、それらの間の関係は苦手です。「A red cube on a blue sphere(青い球の上の赤い立方体)」は、1.5 ではしばしば入れ替わって出てきます。プロンプトガイドに、確実に効く書き方をまとめています。
ガイダンススケール、ネガティブプロンプト、シード:三つの設定
どの Stable Diffusion インターフェースにも三つの設定が現れます。これらは上で説明した仕組みに直接対応しています。
ガイダンススケールは、分類器なしガイダンス(classifier-free guidance、CFG)の略で、文章をどれだけ強く効かせるかを決めます。各ステップでノイズ除去器は実際には二つの予測を行います。プロンプトありの予測と、空のプロンプトでの予測です。両者の差がプロンプトの与える方向です。最終的な予測は、空の予測に、その差をガイダンススケール倍したものを足したものです。1 ではプロンプトありの予測がそのまま使われ、押す力はありません。画像は文章にゆるく従い、色は沈み、プロンプトが青空を求めても空は灰色になります。5〜8 あたりではプロンプトに忠実で、色も自然です。12 を超えるとコントラストが硬くなり、色は飽和し、筆致は荒くなります。
ネガティブプロンプトは、その二つ目の予測の空のプロンプトを置き換えます。二回目のパスは何も読まない代わりに「blurry, text, watermark」を読み、ガイダンスはそこから遠ざかる方向に押します。二回目のパスはどのみち実行されるので追加コストはなく、効くのはガイダンスが 1 より大きいときだけです。ネガティブプロンプトガイドに実用的なリストがあります。
シードは出発点のノイズを生成する数値です。同じシード、同じプロンプト、同じ設定、同じモデルなら、同じソフトとハードウェアではピクセル単位で同じ画像が得られます。別のインターフェースや別のカードではノイズの引き方が違います。シードを変えると構図が変わります。最初のステップが別のノイズの塊を読むからです。プロンプトの一語だけ変えてシードを保てば、絵の大部分はたいてい保たれます。プロンプトはこうして磨いていきます。
U-Net からトランスフォーマーへ:1.5 から 3.5 までのバージョン
二年間で六つの主要な世代が登場しました。最初の二つは CompVis と Runway、残りは Stability AI によるものです。どの世代も三つのネットワークのうち少なくとも一つを変えています。
| バージョン | 公開日 | ノイズ除去器 | テキストエンコーダ | ネイティブサイズ |
|---|---|---|---|---|
| 1.4 と 1.5 | 2022年8月と10月 | U-Net、パラメータ 860M | CLIP ViT-L | 512 px |
| 2.0 と 2.1 | 2022年11月と12月 | 同じ設計の U-Net をゼロから再学習 | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | 2023年7月 | U-Net、2.6B、加えて refiner | CLIP ViT-L と OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | 2023年11月 | SDXL を 1〜4 ステップに蒸留 | SDXL と同じ | 512 px |
| 3 Medium | 2024年6月 | 拡散トランスフォーマー(MMDiT)、2B | CLIP ViT-L、OpenCLIP bigG、T5-XXL | 1024 px |
| 3.5 Large、Large Turbo、Medium | 2024年10月 | MMDiT、8B。Medium は 2.5B | 同じ三つ | 1024 px |
1.5 は今も最も多く追加学習されたモデルの一つで、コミュニティ製のチェックポイントと LoRA が数万本あり、今でも 4 GB のビデオメモリで動きます。SDXL は主力です。手、顔、構図が改善され、1024 ピクセルをネイティブで出力します。3 と 3.5 は U-Net をトランスフォーマーに置き換え、テキストと画像のトークンを一緒に扱うようにしました。画像の中に読める文字を入れることをついに可能にしたのがこれで、プロンプトでは語句を引用符で囲みます。SDXL と Stable Diffusion 3 の比較では、同じプロンプトを両方で試しています。
ライセンスも変わりました。1.5 は CreativeML OpenRAIL-M ライセンス、SDXL は OpenRAIL++-M で、どちらも禁止用途の一覧付きで商用利用が無料です。3.x 系は Stability AI Community License で、年間収益が百万ドル未満なら無料です。
何ができるのか:image-to-image、インペインティング、ControlNet、LoRA
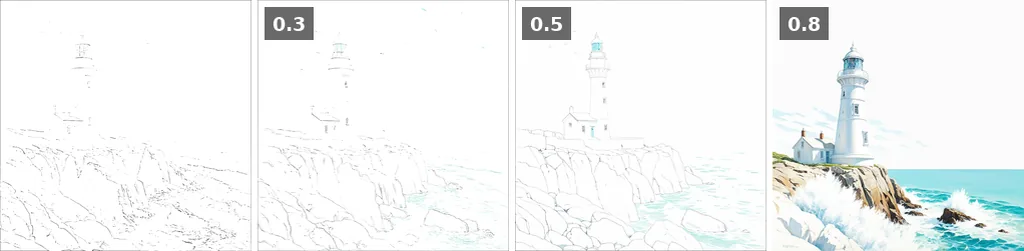
テキストから画像を作るのは入口にすぎません。パイプラインのどの部品も再利用できるからです。スケッチを潜在表現に符号化し、ノイズを一部だけ加えてそこからノイズ除去を行えば、image-to-image、インターフェースでいう img2img になります。strength あるいは denoise の設定は、加えるノイズの量です。この発想は SDEdit に由来します。潜在表現の一領域をマスクすればインペインティング、マスクが画面の外にあればアウトペインティングです。ポーズ、深度マップ、輪郭線を読む小さな補助ネットワークを足せば ControlNet になります。二十枚の写真で数百万個の追加の重みを学習させれば、モデルに顔やスタイルを教える LoRA になります。拡大は専用の超解像モデルが担います。
自分で動かすなら、1.5 にはビデオメモリ(VRAM)6 GB の比較的新しい NVIDIA カードで十分で、SDXL には 8 GB あれば足ります。AMD カードは ROCm で、Apple Silicon は MPS バックエンドで動きます。インストールガイドで主要な三つのインターフェースを扱っています。カードがなくても、このサイトのツールにはハードウェアが要りません。Stable Diffusion XL と Stable Diffusion 1.5 はサイト自身の GPU で動き、待ち行列をリアルタイムで表示します。記録付きのプロンプトは各設定が何をするかを示し、1,731 人の画家スタイルはモデルが画家について何を学んだかを示します。
Stable Diffusion vs Midjourney vs DALL-E
Midjourney や OpenAI の画像モデルと比べたときの違いは、品質ではなく制御です。重みは公開され、モデルはローカルで動きます。画像は自分のディスクに留まり、モデルを選び、シードを決め、どの部品でも入れ替えられます。その代わり、求められることは多くなります。Midjourney は一文を受け取って仕上がった絵を返しますが、Stable Diffusion はモデル、プロンプト、ネガティブプロンプト、ガイダンススケールを求め、設定したとおりのものをそのまま返します。
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| 重み | 公開、ダウンロード可 | 非公開 | 非公開 |
| 自分のパソコンで動く | はい、VRAM 6〜8 GB | いいえ | いいえ |
| 価格 | ローカルでは無料。オンラインにも無料ツール | サブスクリプション | サブスクリプションまたは画像ごと |
| 制御 | シード、モデル、LoRA、ControlNet、インペインティング、すべての設定 | パラメータとスタイル参照 | 会話 |
| 追加学習 | はい、誰でも | いいえ | いいえ |
| 画像内の文字 | 3 より前は弱く、3.5 から良好 | v6 から良好 | 非常に良い |
同じ拡散の原理が、今では他の研究所のモデルも動かしています。エンコーダもライセンスも別物です。Stable Diffusion の原著者たちが設立した Black Forest Labs の FLUX、Alibaba の Qwen-Image です。同じインターフェースで、同じシード、ステップ、サンプラーで動くので、このページの大半はそのまま当てはまります。ガイダンスの働きは異なり、FLUX dev にはネガティブプロンプトがなく、キーワードの列挙より完全な文を好みます。
出典と、図の再利用について
一次資料を、ページに登場する順に挙げます。
- High-Resolution Image Synthesis with Latent Diffusion Models、Rombach ら、2022:Stable Diffusion の論文。
- Denoising Diffusion Probabilistic Models、Ho ら、2020:順過程と逆過程、千ステップのスケジュール。
- Learning Transferable Visual Models From Natural Language Supervision、Radford ら、2021:CLIP。
- Classifier-Free Diffusion Guidance、Ho と Salimans、2022:ガイダンススケール。
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis、2023、および Scaling Rectified Flow Transformers for High-Resolution Image Synthesis、2024:SDXL と Stable Diffusion 3。
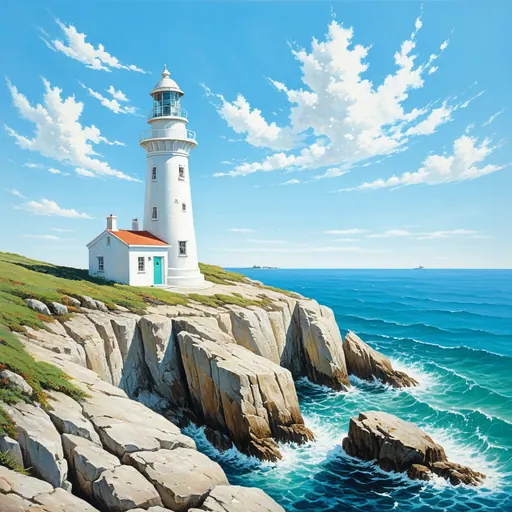
図の再利用。このページの生成画像と図は CC BY 4.0 で公開しています。このページへのリンクを添えれば、授業、講演、記事で再利用できます。すべての生成画像は Stable Diffusion XL、euler、30 ステップ、CFG 6、シード 20220822、下のプロンプト、そしてネガティブプロンプト「text, watermark, signature, blurry, low quality, storm, dark clouds, sunset」を使っています。
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesこのページを引用するには。
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion