Qwen-Image 2.1 とは
Qwen-Image 2.1 は、一つのチェックポイントで二つの仕事をこなします。テキストから画像を生成し、一文と最大10枚の参照画像で既存の画像を編集します。生成部分は 70億パラメータの拡散トランスフォーマーです。Qwen3-VL 8B のテキストエンコーダと組み合わされ、ComfyUI では別ファイルとして読み込みます。
エンコーダが言語モデルだからこそ、キーワードの羅列ではなく、文章全体、レイアウトの指示、引用符で囲んだ語を読み取れます。
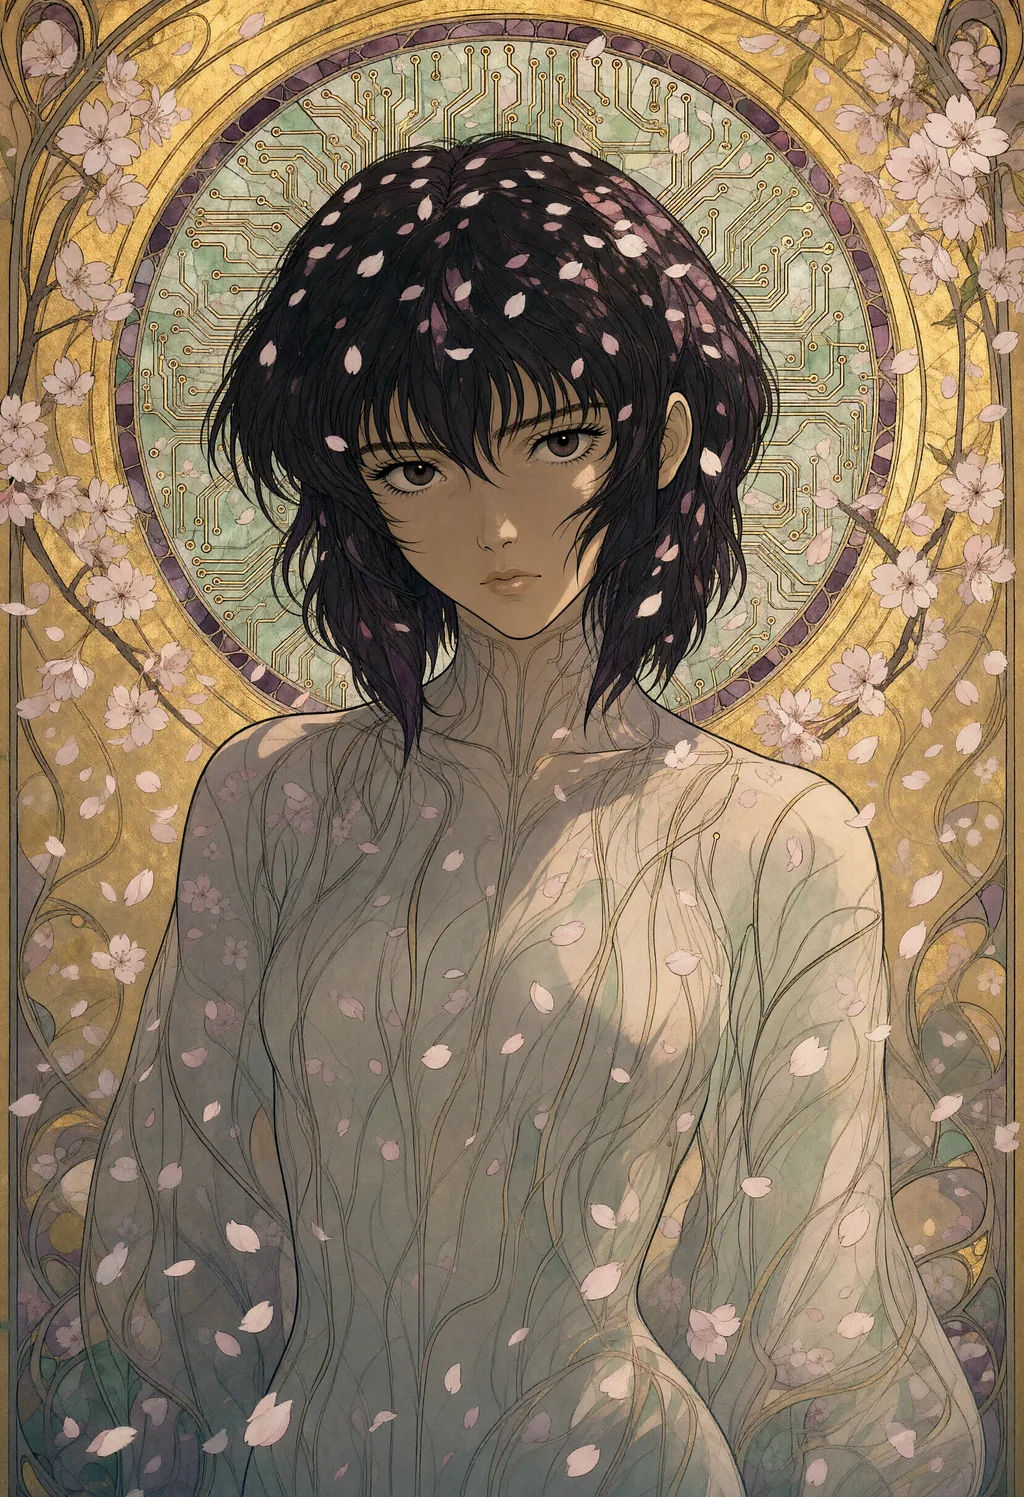
Qwen は 2.1 を、質感、タイポグラフィ、ポートレートの照明が改善されたと説明しています。アップスケーラーなしのネイティブ 2K で動作します。正方形なら 2048 × 2048、3:2 なら 2528 × 1696、16:9 なら 2752 × 1536 です。プロンプトで透明な背景を求めると、本物のアルファチャンネルも出力できます。
代償は時間です。VRAM 16 GB の民生用カードでは、int8 ウェイトで 1 メガピクセルの画像に約40秒かかります。4 メガピクセルの画像は、下記の設定で約4分半かかります。
ダウンロードの前に知っておくことが一つあります。ウェイトは Qwen Research License の下にあり、研究と評価のみに使えます。商用利用には Qwen から別途ライセンスを得る必要があります。2025年8月に公開された最初の Qwen-Image は Apache 2.0 でした。2.1 は違います。
Qwen-Image 2.1 のプロンプトの書き方
タグではなく文章を書きます。テキストエンコーダは言語モデルです。語順、前置詞、引用符を読み取り、すべてを文字どおりに受け取ります。「lighthouse cat」は灯台に描かれた猫になります。
以下の構成が、約千枚の画像を通じて最も良い結果を出しました。この順番を守ってください。
- 技法と被写体を最初に:「An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms」。冒頭で決めた技法が、その後のすべてを染めます。
- 舞台:場所、時代、天候、あるいは空気を満たしているもの。「in falling cherry blossoms」「in the 1980s」「during a blizzard」。
- 光とその方向:「lit from the front by soft diffuse light, with gentle shadows」。方向は守られます。ただの「dramatic light」は守られません。
- 構図:「close-up of the subject, looking at the viewer」、ミディアムショット、俯瞰、広大な風景の中の小さな被写体。
- 素材とパレット:「flowing ink lines, flat gold leaf background, muted jade and plum」。モデルが 2K で最も美しく描くのはここです。
- 制約はプロンプトの中に書く:「no lettering, no watermark」「five fingers on each hand」。ガイダンス1ではネガティブプロンプトが無視されるため、プロンプト自体がこれらを担う必要があります。
上のイラストのプロンプト全文を、この順番のまま示します:An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
文字は、引用符で囲んで場所を指定すればうまくいきます。「A banner above the door reads 'OPEN ALL NIGHT'」は、大文字でもそうでなくても、ほぼ毎回正しく描かれます。
逆も成り立ちます。文字を求めていない店先、ダイナー、ゲームセンターには、勝手に看板が生えてきます。ファサードのある場面では必ず「no lettering」と書いてください。
モデルが知らないキャラクターは、警告なしに似た何かに置き換えられます。Marsupilami はサルになりました。モスラと Marvin the Martian は正しく描かれました。
プロンプト例ページにある Qwen のカードはすべてこの構成に従っており、シード、サイズ、設定が付いています。
効く設定、計測結果
ComfyUI の公式テンプレートはガイダンス(CFG)1 で25ステップを使います。モデルカードは40ステップです。下記の設定は CFG 3 に落ち着きました。
2026年10月16日に同じシードで最終確認したところ、最も細部が豊かで、最も忠実な画像が得られたのは次の設定です:
| 設定 | 値 |
|---|---|
| ガイダンス(CFG) | 3、ネガティブプロンプト付き |
| ネガティブプロンプト | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| モデルパッチ | APG(eta 1、norm threshold 10、momentum 0.3)、次に FreSca(low 1、high 2、cutoff 8)、サンプラーの手前に |
| サンプラー | euler、simple スケジューラー |
| ステップ | 1 メガピクセルで25、2.5 と 4 メガピクセルで20 |
| LoRA | なし |
ガイダンスは、場面を変えない唯一の設定です。同じシードとサイズなら、CFG 1 と CFG 3 の構図はほぼ同じです。違うのは描き込みです。
CFG 1 では画像が平板になり、細かな質感が失われます。刺繍のステッチはただの布になります。カートゥーンの顔から瞳と口が消えます。金属からリベットが消えます。
CFG 1 のまま30ステップに増やすとシャープさは戻りますが、素材感とコントラストは戻りません。一度だけ試した 2 メガピクセルでは、40ステップできれいな画像になるものの、やはり平板で、プロンプトの読み取りも不安定でした。
APG は CFG 3 の彩度過多を抑えます。FreSca は高周波を引き締めます。どちらもガイダンスが1より大きいときにだけ働きます。
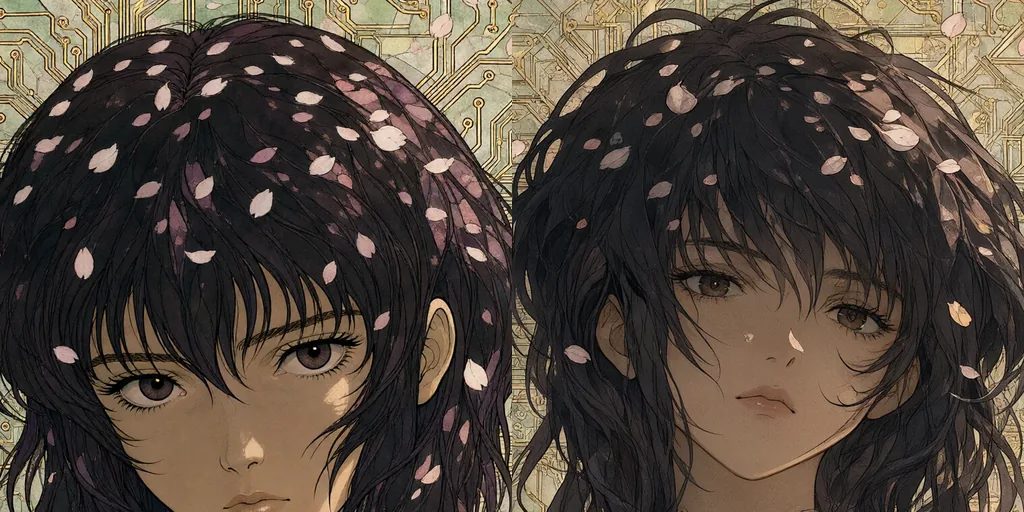
ガイダンスを1より上げると、ステップごとに2回目のパスが走ります。そのため CFG 1 は2倍速くなります。テストに使ったカードでは、4 メガピクセルの画像で 120〜135秒に対して 255〜275秒です。10組のテストペアすべてで、遅いほうに価値がありました。
解像度とステップ:何が画像を変えるか
他の拡散モデルと同じく、Qwen-Image 2.1 はサイズを変えても画像を拡大縮小しません。同じシードの別テイクになるため、1 メガピクセルで見つけたシードは 2K には引き継がれません。
1 メガピクセルから 2.5 または 4 に上げると、テストしたすべてのペアで違う絵になりました。2.5 と 4 メガピクセルの間では、10組中8組で構図が保たれました。
下のイラストでは、動いたのは細部だけです。2.5 メガピクセルでは、回路パターンが光輪を離れて髪へ移りました。
ステップ数も、差が大きければ画像を変えます。20と25ステップはほぼ同じ絵です。16ステップはずれます。つまり、1 メガピクセルでプレビューして同じ画像を大きく描く方法はありません。先にサイズを決め、それからシードを選んでください。
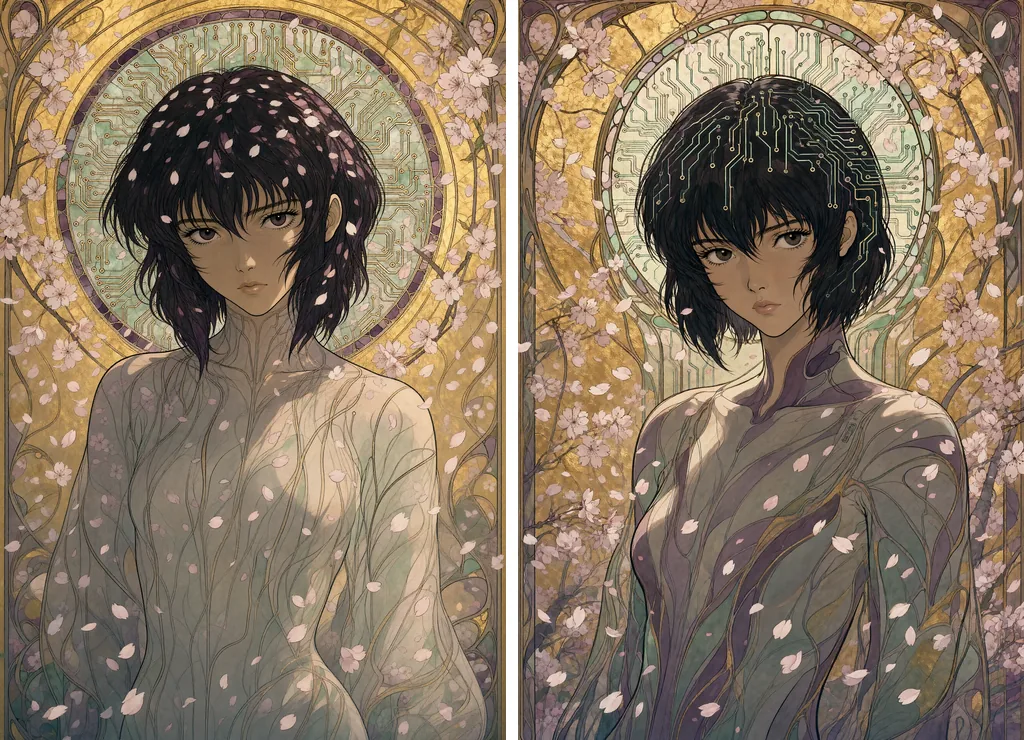
CFG 3、APG と FreSca、int8 ウェイト、16 GB の民生用カード1枚で、横長またはそれに相当する縦長で計測した時間:
| サイズ | ステップ | 1枚あたりの時間 |
|---|---|---|
| 1 メガピクセル(1216 × 832) | 25 | 約40秒 |
| 2.5 メガピクセル(1920 × 1312) | 20 | 120〜135秒 |
| 4 メガピクセル(2432 × 1664) | 20 | 255〜275秒 |
| 4 メガピクセル | 25 | 315〜335秒 |
2.5 メガピクセルでは、同じ部分を 100% で比べると 4 より細部がやや柔らかくなります。しかしプロンプトのスタイルへの追従は 4 と同等以上で、10組のテストペアでは勝ることもありました。刺繍は、4 メガピクセルより 2.5 メガピクセルのほうがステッチがはっきり見えました。
1024 ピクセルで配信するギャラリーなら、2.5 メガピクセル・20ステップが最適点です。印刷なら 4 メガピクセル・20ステップです。
高速化:Turbo、ガイド付き Turbo、その他
Turbo。Qwen は 2026年10月9日に Qwen-Image-2.1-Turbo を公開しました。固定のシグマスケジュールで CFG 1・8ステップで動く蒸留チェックポイントです。Comfy-Org から int8 ファイルとして、またベースモデル用の LoRA として配布され、ComfyUI に専用テンプレートがあります。10月17日に、このガイドの CFG 3 の描画と同じ10個のシードとサイズで、テンプレートどおりのグラフを使って計測しました。
| 設定 | 1枚あたりの時間 |
|---|---|
| Turbo チェックポイント、8ステップ、CFG 1、1 メガピクセル | 9〜10秒 |
| Turbo チェックポイント、8ステップ、CFG 1、4 メガピクセル | 38〜39秒 |
| 後述のガイド付き Turbo:Turbo チェックポイント、8ステップ、APG と FreSca 付きの CFG 3、4 メガピクセル | 66〜71秒 |
| ベースチェックポイント+Turbo LoRA、8ステップ、CFG 1、4 メガピクセル | 52〜55秒 |
| ベースチェックポイント、CFG 3、20ステップ、4 メガピクセル | 255〜275秒 |
4 メガピクセルで7倍、1 メガピクセルで4倍速くなります。画像もきれいです。シャープで、光も良く、10個のシードで解剖学的な破綻はなく、ベースモデルと同じプロンプトで文字も正しく描かれます。プロンプトの物体はきちんと存在し、ベースモデルより良いこともあります。レースカーに乗ったカメは、ベースモデルではどの描画でも抜け落ちていましたが、Turbo では現れました。
失われるのは技法です。10個のシードのうち写真以外のプロンプトすべてで、蒸留モデルは写真的なリアリズムへ流れました。ワニの刺繍はワニの写真になりました。木炭画は粒子を失いました。切り紙の Marvin the Martian はソフビのフィギュアになりました。ファサードに勝手に生える文字はベースモデルと同じです。
10個のシードでは、ベースチェックポイントに載せた LoRA は Turbo チェックポイントと同じ画像を出し、ただ遅いだけでした。ダウンロードすべきはチェックポイントのほうです。シードは、サイズ変更のときと同様にベースモデルとは別の絵を出します。ライセンスは同じで、研究と評価のみです。
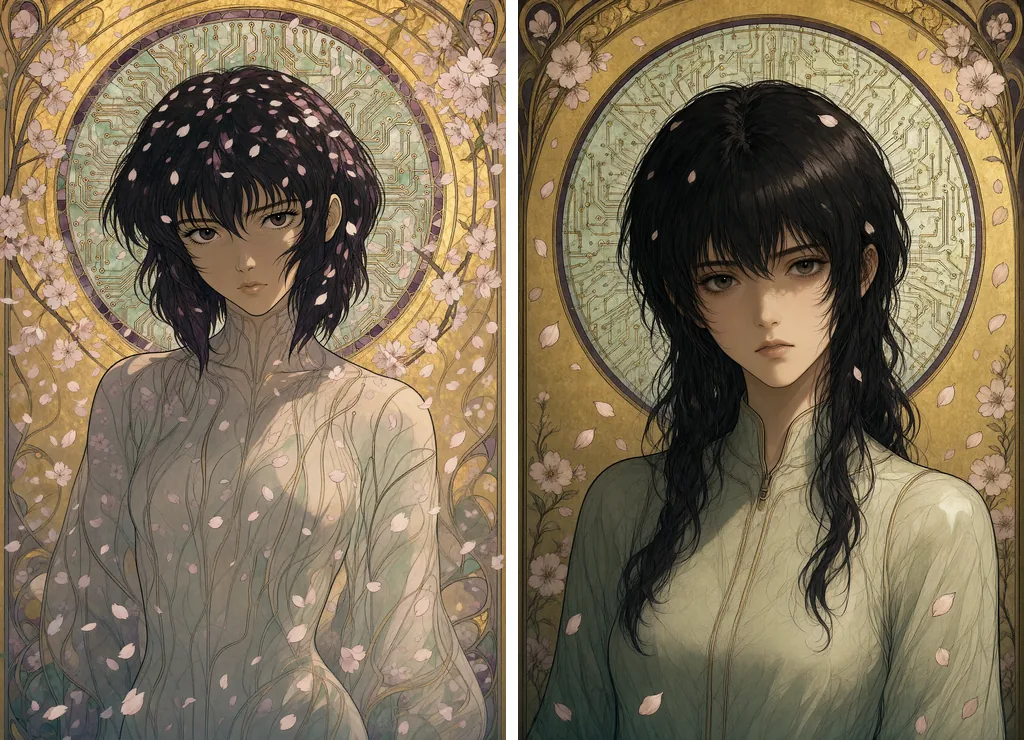
ガイド付き Turbo。Turbo は CFG 1 に固定されているわけではありません。2026年10月17日に、同じ10個のシードとこのガイドのイラストでテストしました。Turbo のチェックポイントと8つの固定シグマはそのままに、ベース設定のガイダンス部分だけを持ち込みます。CFG 3、ネガティブプロンプト、APG、次に FreSca です。
グラフは Turbo テンプレートそのものです。CFGGuider を 1 から 3 に変え、ネガティブプロンプトを入力し、ローダーとガイダーの間のモデル経路に APG、次に FreSca を挿入します。ManualSigmas ノードとサンプラーはそのままです。
結果は Turbo の構図を保ったまま、CFG 1 が平板にしていたものを取り戻します。コントラスト、彩度、細部です。このガイドのイラストでは、光輪の回路パターンがくっきりと金色に戻り、花びらも戻ります。10個のテストシードでも、鱗、毛並み、刺繍のベストが同じように引き締まります。取り戻せないのは技法です。刺繍はワニの写真のままです。
代償はステップごとの2回目のパスです。4 メガピクセルの画像で 38〜39秒に対して 66〜71秒です。それでもベースモデルより4倍近く速いままです。
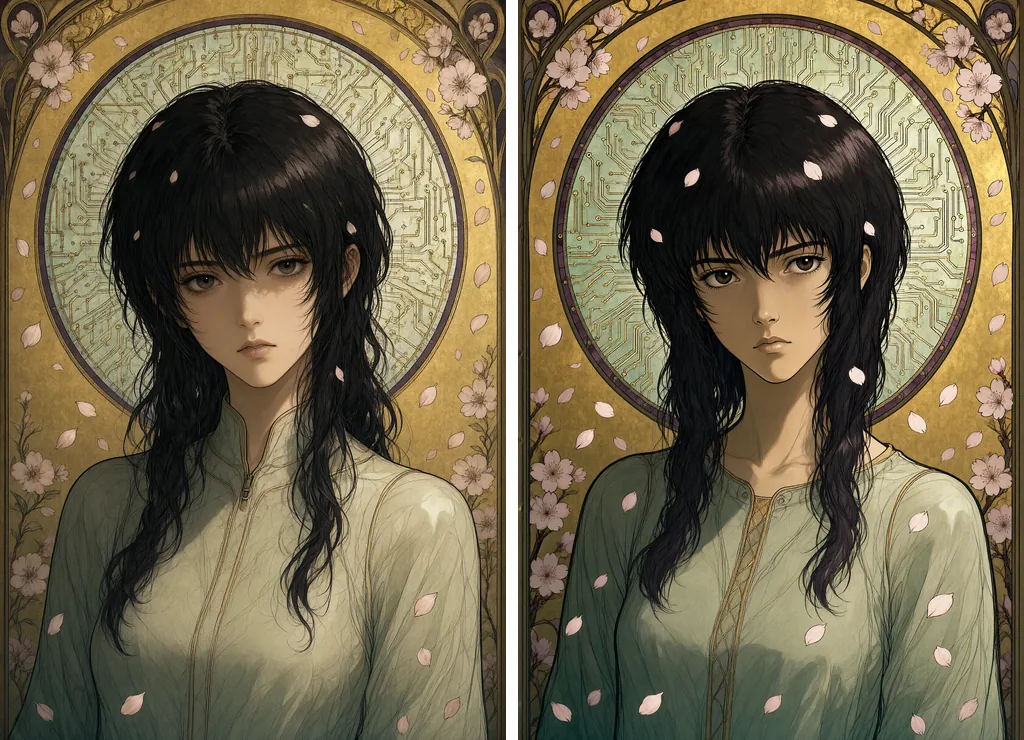
ワークフローをダウンロードする。 ガイド付き Turbo の ComfyUI ワークフロー(JSON)は、このイラストをそのまま再現します:1664 × 2432、シード 57658043、APG と FreSca 付きの CFG 3、このガイドのネガティブプロンプト。ファイルを ComfyUI にドロップしてください。最後のセクションで挙げた3つのモデルファイルが必要です。CC BY 4.0 のもとで、このページへのリンクを添えれば自由に再利用できます。
ステップを増やして Turbo を助けようとしてはいけません。ベースモデルのつもりで、4 メガピクセル・CFG 3 で20ステップと simple スケジューラーを与えると、焼きすぎになります。硬い髪の毛、粒子の粗い光輪、押し上げられたコントラストです。しかも169秒かかります。蒸留チェックポイントには8つのシグマが必要です。
妥当な使い分けはこうです。素の Turbo は下書きモードとして、選別のために1時間あたり7倍の候補を出します。ガイド付き Turbo は、写真的またはすっきりした線のプロンプトに細部が速く必要なときに使います。CFG 3 のベースモデルは、絵画、素描、工芸など、技法そのものが要点になるものに使います。
その他の蒸留版。LightX2V は 2026年10月13日に 2.1 用の 4ステップ Lightning LoRA を公開しました。コミュニティ製の 8ステップ LoRA、Turbo8 もあります。どちらも Turbo と同じく CFG 1 で動きます。ここでは計測していません。
プレフィックスキャッシュのノード。ComfyUI の QwenImage21Cache ノードは、モデルがすでに保持しているキャッシュのデバイスと精度を設定するだけです。既定値では何も変わりません。int8 モードはキャッシュを半分にし、2K や複数の参照画像を使う編集でメモリが足りなくなるときに助けになります。今回のテストでは、目に見える劣化はありませんでした。
ステップを減らす。16ステップは時間を約2割節約しますが、構図が変わり、20ステップよりシャープになることもありません。時間が制約なら、ステップより先にサイズを下げてください。
Qwen-Image 2.1 をローカルで動かす
ComfyUI はこのモデルをネイティブにサポートしています。3つのファイルをいつものフォルダに置きます。拡散モデルは diffusion_models、Qwen3-VL テキストエンコーダは text_encoders、VAE は vae です。
16 GB のカードなら、Comfy-Org が公開している int8 版を選んでください。bf16 ウェイトも動きますが、システムメモリにあふれ出し、目に見える利点もなく2〜6倍の時間がかかります。
グラフは短いものです:
- UNETLoader、タイプ
qwen_imageの CLIPLoader、VAELoader。 - プロンプトとネガティブプロンプトをまとめて受け取り、両方のコンディショニングを出力する TextEncodeQwenImage21。
- 選んだサイズの空の潜在画像。
- モデル経路上の APG、次に FreSca。
- euler と simple スケジューラーで CFG 3 の KSampler、そして VAEDecode。
透明画像にするには、モデルカードが推奨する形で被写体を包みます。「This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.」とし、PNG で保存します。
メモリ:1 メガピクセルなら、int8 モデル、エンコーダ、VAE はシステムメモリに触れずに 16 GB で動きます。ComfyUI はプロンプトのエンコードが終わると、エンコーダを VRAM から退避させます。4 メガピクセルではプレフィックスキャッシュを int8 にし、メモリ不足になることは一度もありませんでした。セッション最初の1枚は、ファイルの読み込みのぶん時間がかかります。