מה זה Qwen-Image 2.1
Qwen-Image 2.1 הוא checkpoint אחד לשתי משימות. הוא יוצר תמונה מטקסט, והוא עורך תמונה קיימת לפי משפט ועד עשר תמונות ייחוס. חלק היצירה הוא diffusion transformer של 7 מיליארד פרמטרים. הוא מצומד למקודד טקסט Qwen3-VL 8B, שנטען ב-ComfyUI כקובץ נפרד.
מודל שפה כמקודד הוא מה שמאפשר לו לקרוא משפטים שלמים, הוראות פריסה ומילים במירכאות, במקום רשימות מילות מפתח.
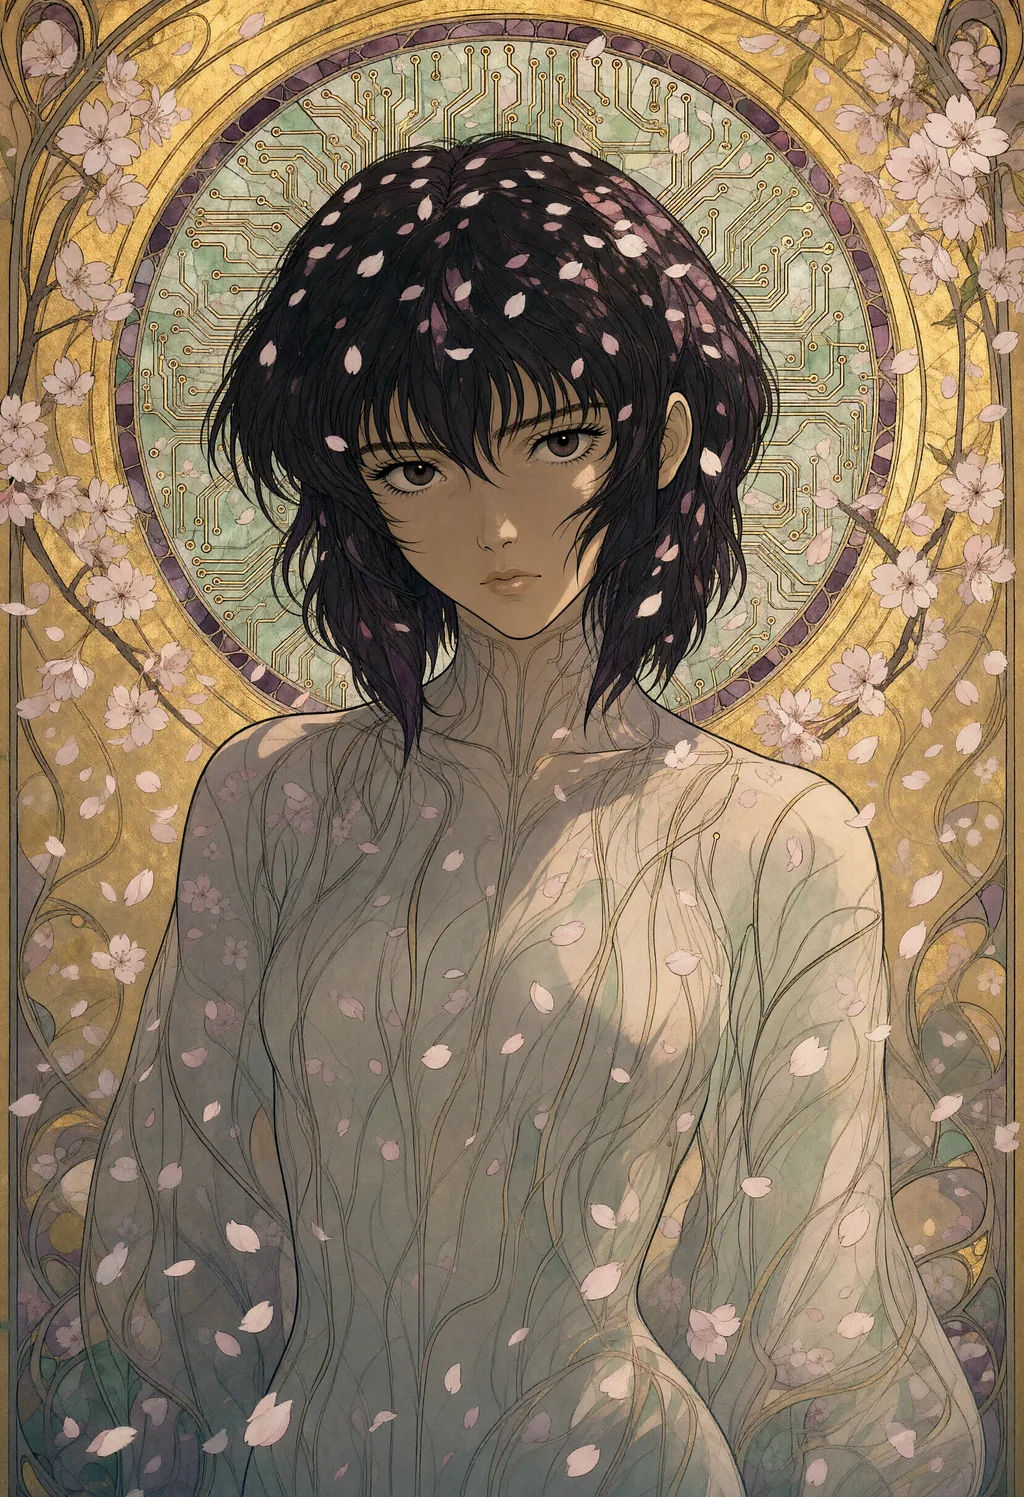
Qwen מציגה את 2.1 כטוב יותר בטקסטורות, בטיפוגרפיה ובתאורת פורטרטים. הוא עובד ב-2K מקורי בלי upscaler: 2048 × 2048 לריבוע, 2528 × 1696 ל-3:2, 2752 × 1536 ל-16:9. הוא גם יכול להוציא ערוץ אלפא אמיתי כשהפרומפט מבקש רקע שקוף.
המחיר הוא זמן. על כרטיס ביתי עם 16 GB של זיכרון וידאו, משקולות ה-int8 לוקחות כ-40 שניות לתמונה של 1 מגה-פיקסל. תמונה של 4 מגה-פיקסל לוקחת כארבע דקות וחצי עם ההגדרות שלמטה.
דבר אחד שכדאי לדעת לפני ההורדה. המשקולות נמצאות תחת Qwen Research License: למחקר ולהערכה בלבד. כל שימוש מסחרי דורש רישיון נפרד מ-Qwen. ה-Qwen-Image הראשון, ששוחרר באוגוסט 2025, היה תחת Apache 2.0. גרסה 2.1 לא.
איך כותבים פרומפט ל-Qwen-Image 2.1
כתבו משפטים, לא תגיות. מקודד הטקסט הוא מודל שפה. הוא קורא סדר מילים, מילות יחס ומירכאות, ולוקח הכול כפשוטו. "lighthouse cat" הופך לחתול שמצויר על מגדלור.
המבנה שלמטה נתן את התוצאות הטובות ביותר לאורך כאלף תמונות. שמרו על הסדר הזה.
- מדיום ונושא קודם: "An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms". המדיום שנקבע בהתחלה צובע את כל מה שבא אחריו.
- סביבה: מקום, תקופה, מזג אוויר, או מה שממלא את האוויר. "in falling cherry blossoms", "in the 1980s", "during a blizzard".
- אור עם הכיוון שלו: "lit from the front by soft diffuse light, with gentle shadows". לכיוון מצייתים. ל-"dramatic light" לבדו לא.
- מסגור: "close-up of the subject, looking at the viewer", medium shot, מבט מלמעלה, הנושא זעיר בנוף עצום.
- חומרים ופלטה: "flowing ink lines, flat gold leaf background, muted jade and plum". זה מה שהמודל מרנדר הכי טוב ב-2K.
- הגבלות, כתובות בתוך הפרומפט: "no lettering, no watermark", "five fingers on each hand". ב-guidance של 1 הפרומפט השלילי לא נלקח בחשבון, ולכן הפרומפט עצמו צריך לשאת אותן.
הפרומפט המלא של האיור שלמעלה, בסדר הזה: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
טקסט עובד כשהוא במירכאות וממוקם. "A banner above the door reads 'OPEN ALL NIGHT'" יוצא נכון כמעט בכל פעם, באותיות גדולות או לא.
גם ההפך נכון. חזית חנות, דיינר או אולם משחקים בלי טקסט מבוקש יצמיחו שלט מומצא. אז אמרו "no lettering" בכל פעם שבסצנה יש חזית.
דמויות שהמודל לא מכיר מוחלפות בכפיל, בלי אזהרה. ה-Marsupilami הפך לקוף. Mothra ו-Marvin the Martian יצאו נכון.
כל כרטיס Qwen בדף דוגמאות הפרומפטים בנוי לפי המבנה הזה, עם ה-seed, הגודל וההגדרות שלו.
הגדרות שעובדות, במדידה
התבנית הרשמית של ComfyUI רצה ב-guidance (CFG) של 1 עם 25 צעדים. כרטיס המודל משתמש ב-40 צעדים. ההגדרות שלמטה התייצבו על CFG 3.
בבדיקה האחרונה, ב-16 באוקטובר 2026, על אותם seeds, ההגדרות האלה נתנו את התמונות המפורטות והנאמנות ביותר:
| הגדרה | ערך |
|---|---|
| Guidance (CFG) | 3, עם פרומפט שלילי |
| פרומפט שלילי | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| פאצ'ים למודל | APG (eta 1, norm threshold 10, momentum 0.3) ואז FreSca (low 1, high 2, cutoff 8), לפני ה-sampler |
| Sampler | euler, scheduler מסוג simple |
| צעדים | 25 ב-1 מגה-פיקסל, 20 ב-2.5 וב-4 מגה-פיקסל |
| LoRA | ללא |
ה-guidance הוא ההגדרה היחידה שלא משנה את הסצנה. באותו seed ובאותו גודל, CFG 1 ו-CFG 3 נותנים כמעט אותה קומפוזיציה. מה ששונה הוא הרינדור.
ב-CFG 1 התמונה שטוחה יותר ומאבדת טקסטורה עדינה. תפרי רקמה הופכים לבד. פרצוף מצויר מאבד את האישונים ואת הפה. מתכת מאבדת את המסמרות.
דחיפת CFG 1 ל-30 צעדים מחזירה את החדות, אבל לא את החומרים ולא את הניגודיות. ב-2 מגה-פיקסל, גודל שנוסה פעם אחת, 40 צעדים נותנים תמונה נקייה שעדיין שטוחה יותר, והמודל קורא את הפרומפט בצורה פחות אמינה.
APG מונע מ-CFG 3 רוויית-יתר. FreSca מחדד את התדרים הגבוהים. שניהם פועלים רק כשה-guidance גבוה מ-1.
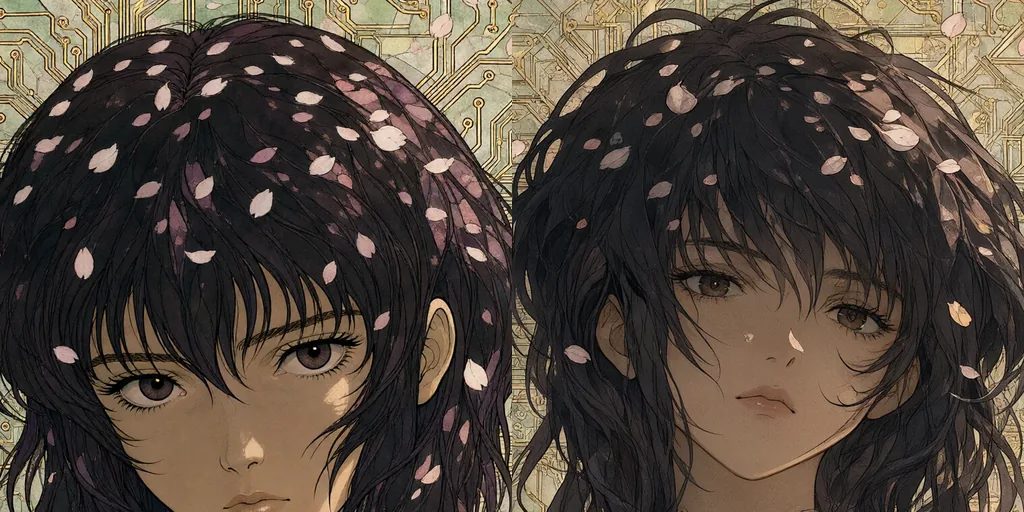
guidance מעל 1 עולה מעבר שני בכל צעד, ולכן CFG 1 מהיר פי שניים. על כרטיס הבדיקה זה 120 עד 135 שניות לעומת 255 עד 275 לתמונה של 4 מגה-פיקסל. האיטי יותר היה שווה את זה בכל אחד מעשרת זוגות הבדיקה.
רזולוציה וצעדים: מה משנה את התמונה
כמו כל מודל דיפוזיה, Qwen-Image 2.1 לא משנה את המידות של התמונה כשהגודל משתנה. הוא מפיק טייק אחר של אותו seed, ולכן seed שנמצא ב-1 מגה-פיקסל לא עובר ל-2K.
מעבר מ-1 מגה-פיקסל ל-2.5 או ל-4 נתן תמונה אחרת בכל זוג שנבדק. בין 2.5 ל-4 מגה-פיקסל הקומפוזיציה החזיקה בשמונה זוגות מתוך עשרה.
באיור שלמטה זזו רק הפרטים. ב-2.5 מגה-פיקסל נתיבי המעגלים עברו מההילה אל השיער.
גם שינוי מספר הצעדים משנה את התמונה כשהפער גדול. 20 ו-25 צעדים נותנים כמעט אותה תמונה. 16 צעדים נסחפים. כך שאין דרך לעשות תצוגה מקדימה ב-1 מגה-פיקסל ולרנדר את אותה תמונה בגדול. בחרו קודם את הגודל, ואז את ה-seed.
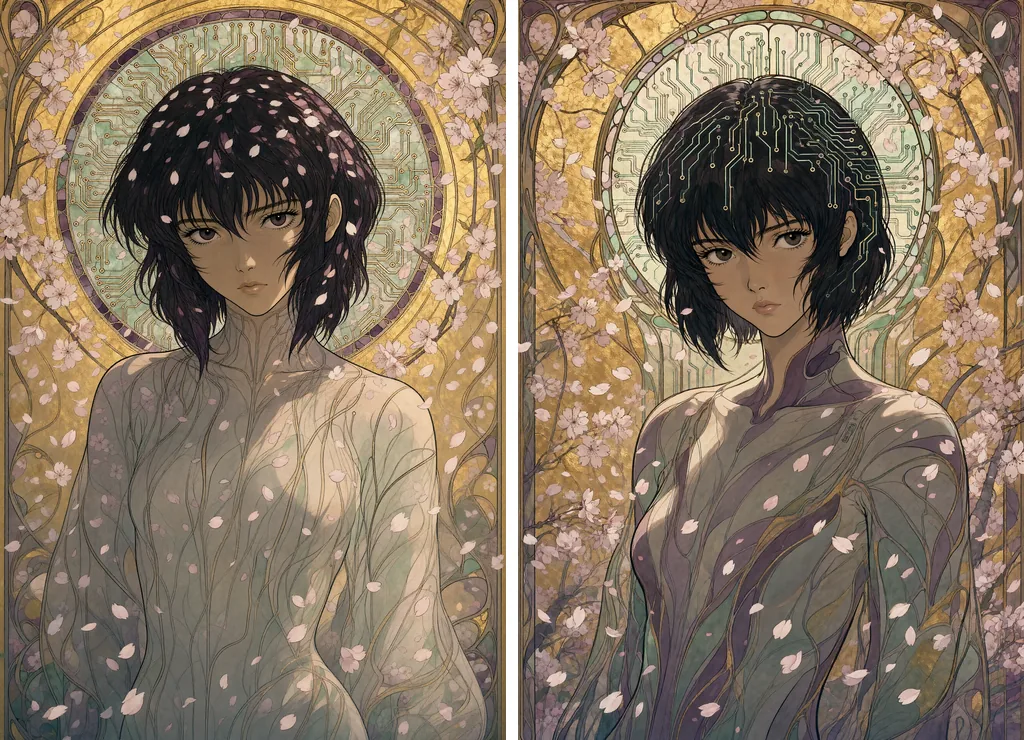
זמנים שנמדדו עם CFG 3, APG ו-FreSca, משקולות int8, על כרטיס ביתי אחד של 16 GB, לרוחב או במקבילה לאורך:
| גודל | צעדים | זמן לתמונה |
|---|---|---|
| 1 מגה-פיקסל (1216 × 832) | 25 | כ-40 שניות |
| 2.5 מגה-פיקסל (1920 × 1312) | 20 | 120 עד 135 שניות |
| 4 מגה-פיקסל (2432 × 1664) | 20 | 255 עד 275 שניות |
| 4 מגה-פיקסל | 25 | 315 עד 335 שניות |
ב-2.5 מגה-פיקסל הפירוט רך מעט יותר מאשר ב-4 כשמשווים את אותו אזור ב-100 %. אבל המודל עוקב אחרי סגנון הפרומפט לפחות באותה מידה, ובעשרת זוגות הבדיקה לפעמים טוב יותר. רקמה הראתה את התפרים שלה בבירור רב יותר ב-2.5 מגה-פיקסל מאשר ב-4.
לגלריה שמוגשת ב-1024 פיקסלים, 2.5 מגה-פיקסל ב-20 צעדים הם האיזון הטוב ביותר. להדפסה, 4 מגה-פיקסל ב-20 צעדים.
האצה: Turbo, Turbo מונחה והשאר
ה-Turbo. Qwen שחררה את Qwen-Image-2.1-Turbo ב-9 באוקטובר 2026. זהו checkpoint מזוקק שרץ ב-8 צעדים ב-CFG 1 עם לוח sigma קבוע. Comfy-Org מפיצה אותו כקובץ int8 וכ-LoRA למודל הבסיס, עם תבניות משלו ב-ComfyUI. הוא נמדד ב-17 באוקטובר על אותם עשרה seeds וגדלים כמו רינדורי ה-CFG 3 של המדריך הזה, עם הגרף המדויק של התבנית.
| הגדרה | זמן לתמונה |
|---|---|
| checkpoint של Turbo, 8 צעדים, CFG 1, 1 מגה-פיקסל | 9 עד 10 שניות |
| checkpoint של Turbo, 8 צעדים, CFG 1, 4 מגה-פיקסל | 38 עד 39 שניות |
| Turbo מונחה, מתואר למטה: checkpoint של Turbo, 8 צעדים, CFG 3 עם APG ו-FreSca, 4 מגה-פיקסל | 66 עד 71 שניות |
| checkpoint הבסיס עם ה-Turbo LoRA, 8 צעדים, CFG 1, 4 מגה-פיקסל | 52 עד 55 שניות |
| checkpoint הבסיס, CFG 3, 20 צעדים, 4 מגה-פיקסל | 255 עד 275 שניות |
מהיר פי שבעה ב-4 מגה-פיקסל, פי ארבעה ב-1. התמונות נקיות: חדות, מוארות היטב, בלי מעידות אנטומיה בעשרת ה-seeds, כיתוב נכון באותם פרומפטים כמו מודל הבסיס. האובייקטים של הפרומפט נמצאים שם, לפעמים טוב יותר מאשר במודל הבסיס. הצבה במכונית המרוץ שלה, שמודל הבסיס השמיט בכל רינדור, הופיעה עם Turbo.
מה שהוא מאבד הוא המדיום. בכל פרומפט לא-צילומי מעשרת ה-seeds, המודל המזוקק נסחף לריאליזם צילומי. רקמה של תנין הפכה לצילום של תנין. רישום פחם איבד את הגרעיניות שלו. Marvin the Martian מנייר גזור הפך לצעצוע ויניל. כיתוב מומצא על חזיתות זהה למודל הבסיס.
בעשרת ה-seeds ה-LoRA על checkpoint הבסיס נתן את אותן תמונות כמו ה-checkpoint של Turbo, רק לאט יותר. לכן ה-checkpoint הוא זה שכדאי להוריד. seed נותן תמונה שונה מזו של מודל הבסיס, כמו בכל שינוי גודל. הרישיון זהה: למחקר ולהערכה בלבד.
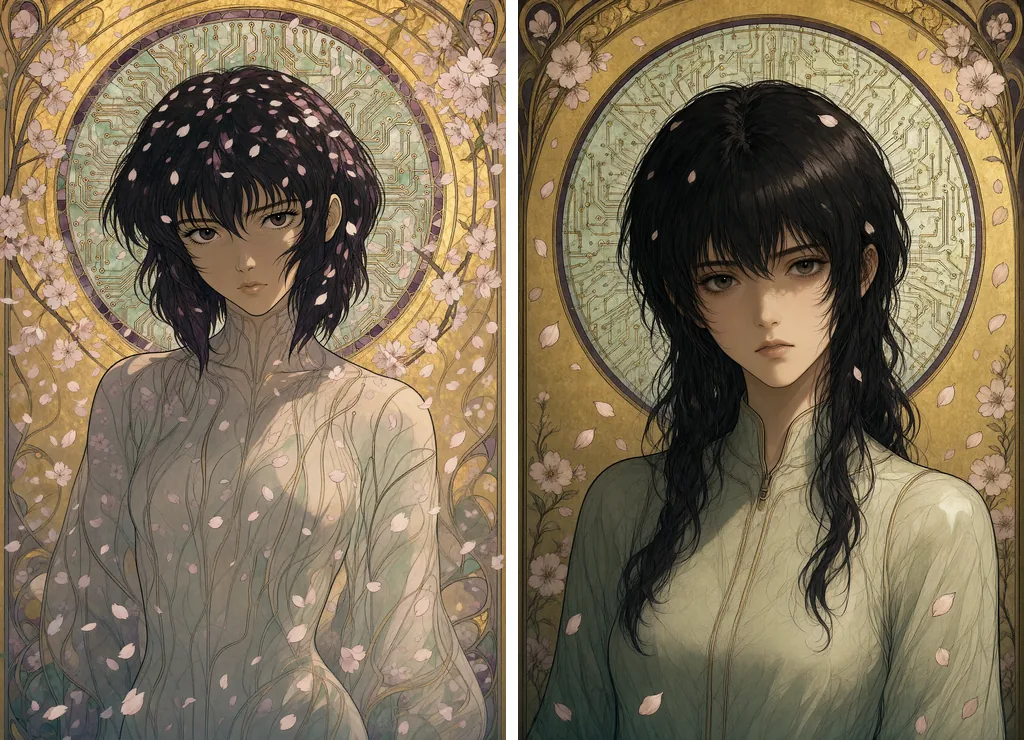
ה-Turbo המונחה. ה-Turbo לא נעול על CFG 1. נבדק ב-17 באוקטובר 2026 על אותם עשרה seeds ועל האיור של המדריך הזה. שמרו על ה-checkpoint שלו ועל 8 ערכי ה-sigma הקבועים שלו, וקחו רק את בלוק ה-guidance של ההגדרה הבסיסית: CFG 3, הפרומפט השלילי, APG ואז FreSca.
הגרף הוא תבנית ה-Turbo עצמה. הגדירו את ה-CFGGuider שלה ל-3 במקום 1, מלאו את הפרומפט השלילי, והכניסו APG ואז FreSca על נתיב המודל בין ה-loader ל-guider. הצומת ManualSigmas וה-sampler נשארים כפי שהם.
התוצאה שומרת על הקומפוזיציה של ה-Turbo ומחזירה את מה ש-CFG 1 שיטח: ניגודיות, רוויה ופרטים עדינים. באיור של המדריך הזה, נתיבי המעגלים של ההילה חוזרים חדים ומוזהבים, ועלי הכותרת חוזרים. בעשרת seeds הבדיקה, הקשקשים, הפרווה והווסט הרקום מתחדדים באותו אופן. מה שהיא לא מחזירה הוא המדיום. הרקמה נשארת צילום של תנין.
המחיר הוא המעבר השני בכל צעד: 66 עד 71 שניות לתמונה של 4 מגה-פיקסל לעומת 38 עד 39. זה עדיין כמעט פי ארבעה מהר יותר ממודל הבסיס.
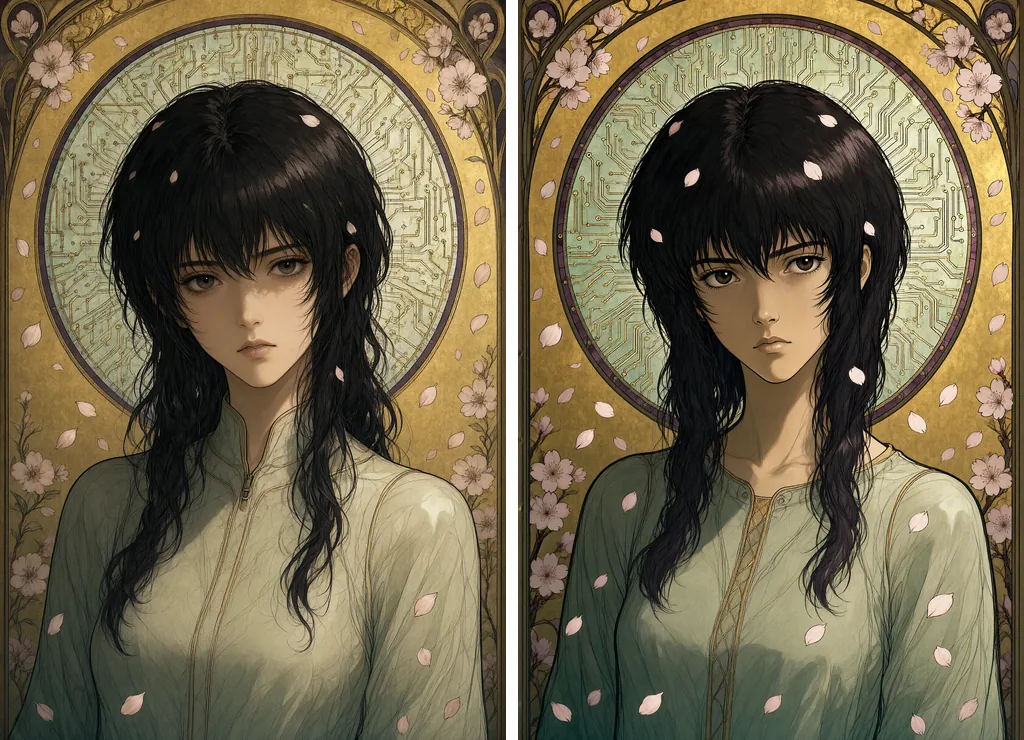
הורידו את ה-workflow. ה-workflow של ComfyUI ל-Turbo המונחה (JSON) מרנדר את האיור הזה כמות שהוא: 1664 × 2432, seed 57658043, CFG 3 עם APG ו-FreSca, הפרומפט השלילי של המדריך הזה. גררו את הקובץ לתוך ComfyUI; הוא מצפה לשלושת קובצי המודל שנזכרים בסעיף האחרון. חופשי לשימוש חוזר תחת CC BY 4.0, עם קישור לעמוד הזה.
אל תנסו לעזור ל-Turbo עם יותר צעדים. כשהוא מקבל 20 צעדים ו-scheduler מסוג simple ב-4 מגה-פיקסל ו-CFG 3, כאילו היה מודל הבסיס, הוא נשרף: קווצות שיער קשות, הילה גרעינית, ניגודיות מוגזמת. וזה לוקח 169 שניות. ה-checkpoint המזוקק רוצה את 8 ערכי ה-sigma שלו.
חלוקה הגיונית. ה-Turbo הרגיל כמצב טיוטה, עם פי שבעה מועמדים בשעה לבחור מהם. ה-Turbo המונחה כשפרומפט צילומי או בעל קווים נקיים צריך פירוט מהר. מודל הבסיס ב-CFG 3 לכל מה שמצויר, מרושם או עשוי ביד, שבו המדיום עצמו הוא העיקר.
זיקוקים אחרים. LightX2V פרסמה Lightning LoRA של 4 צעדים ל-2.1 ב-13 באוקטובר 2026. קיים גם LoRA קהילתי של 8 צעדים, Turbo8. שניהם רצים ב-CFG 1 כמו ה-Turbo. אף אחד מהם לא נמדד כאן.
צומת מטמון הקידומת. הצומת QwenImage21Cache של ComfyUI רק קובע את ההתקן ואת הדיוק של המטמון שהמודל ממילא שומר. בברירות המחדל שלו הוא לא משנה כלום. מצב ה-int8 שלו מקטין את המטמון בחצי, וזה עוזר כשהזיכרון אוזל ב-2K או בעריכה עם כמה תמונות ייחוס. לא נראה איתו שום אובדן בבדיקות האלה.
פחות צעדים. 16 צעדים חוסכים כחמישית מהזמן, אבל משנים את הקומפוזיציה ולא מרוויחים חדות לעומת 20. אם הזמן הוא המגבלה, הורידו קודם את הגודל ורק אז את הצעדים.
הרצת Qwen-Image 2.1 מקומית
ComfyUI תומך במודל באופן מובנה. שלושה קבצים נכנסים לתיקיות הרגילות: מודל הדיפוזיה ב-diffusion_models, מקודד הטקסט Qwen3-VL ב-text_encoders, ה-VAE ב-vae.
על כרטיס של 16 GB, קחו את גרסאות ה-int8 ש-Comfy-Org פרסמה. משקולות ה-bf16 גם עובדות, אבל הן גולשות לזיכרון המערכת ולוקחות פי שניים עד פי שישה זמן בלי רווח נראה לעין.
הגרף קצר:
- UNETLoader, CLIPLoader עם הסוג
qwen_image, VAELoader; - TextEncodeQwenImage21, שמקבל את הפרומפט ואת הפרומפט השלילי יחד ומוציא את שני ה-conditionings;
- latent ריק בגודל שנבחר;
- APG ואז FreSca על נתיב המודל;
- KSampler ב-CFG 3 עם euler וה-scheduler מסוג simple, ואז VAEDecode.
לתמונה שקופה, עטפו את הנושא בנוסח שכרטיס המודל ממליץ עליו: "This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent." ואז שמרו כ-PNG.
זיכרון: ב-1 מגה-פיקסל, מודל ה-int8, המקודד וה-VAE רצים ב-16 GB בלי לגעת בזיכרון המערכת. ComfyUI מוציא את המקודד מזיכרון הווידאו ברגע שהפרומפט מקודד. ב-4 מגה-פיקסל מטמון הקידומת הוגדר ל-int8, והזיכרון אף פעם לא נגמר. התמונה הראשונה בסשן לוקחת יותר זמן בזמן שהקבצים נטענים.