Hvad Qwen-Image 2.1 er
Qwen-Image 2.1 er ét checkpoint til to opgaver. Den genererer et billede ud fra tekst, og den redigerer et eksisterende billede ud fra en sætning og op til ti referencebilleder. Genereringsdelen er en diffusion transformer med 7 milliarder parametre. Den er parret med en Qwen3-VL 8B-tekst-encoder, som indlæses i ComfyUI som en separat fil.
En sprogmodel som encoder er det, der gør, at den læser hele sætninger, layoutanvisninger og ord i anførselstegn frem for nøgleordslister.
Qwen præsenterer 2.1 som bedre til teksturer, typografi og portrætlys. Den arbejder i native 2K uden opskalering: 2048 × 2048 til et kvadrat, 2528 × 1696 til 3:2, 2752 × 1536 til 16:9. Den kan også levere en ægte alfakanal, når prompten beder om en gennemsigtig baggrund.
Prisen er tid. På et almindeligt grafikkort med 16 GB videohukommelse tager int8-vægtene cirka 40 sekunder om et billede på 1 megapixel. Et billede på 4 megapixel tager cirka fire et halvt minut med indstillingerne nedenfor.
Én ting skal man vide, før man henter den. Vægtene er udgivet under Qwen Research License: kun forskning og evaluering. Enhver kommerciel brug kræver en særskilt licens fra Qwen. Den første Qwen-Image, udgivet i august 2025, var Apache 2.0. Version 2.1 er det ikke.
Sådan skriver du en prompt til Qwen-Image 2.1
Skriv sætninger, ikke tags. Tekst-encoderen er en sprogmodel. Den læser ordstilling, forholdsord og anførselstegn, og den tager alt bogstaveligt. En "lighthouse cat" bliver til en kat tegnet på et fyrtårn.
Strukturen nedenfor gav de bedste resultater over cirka tusind billeder. Hold denne rækkefølge.
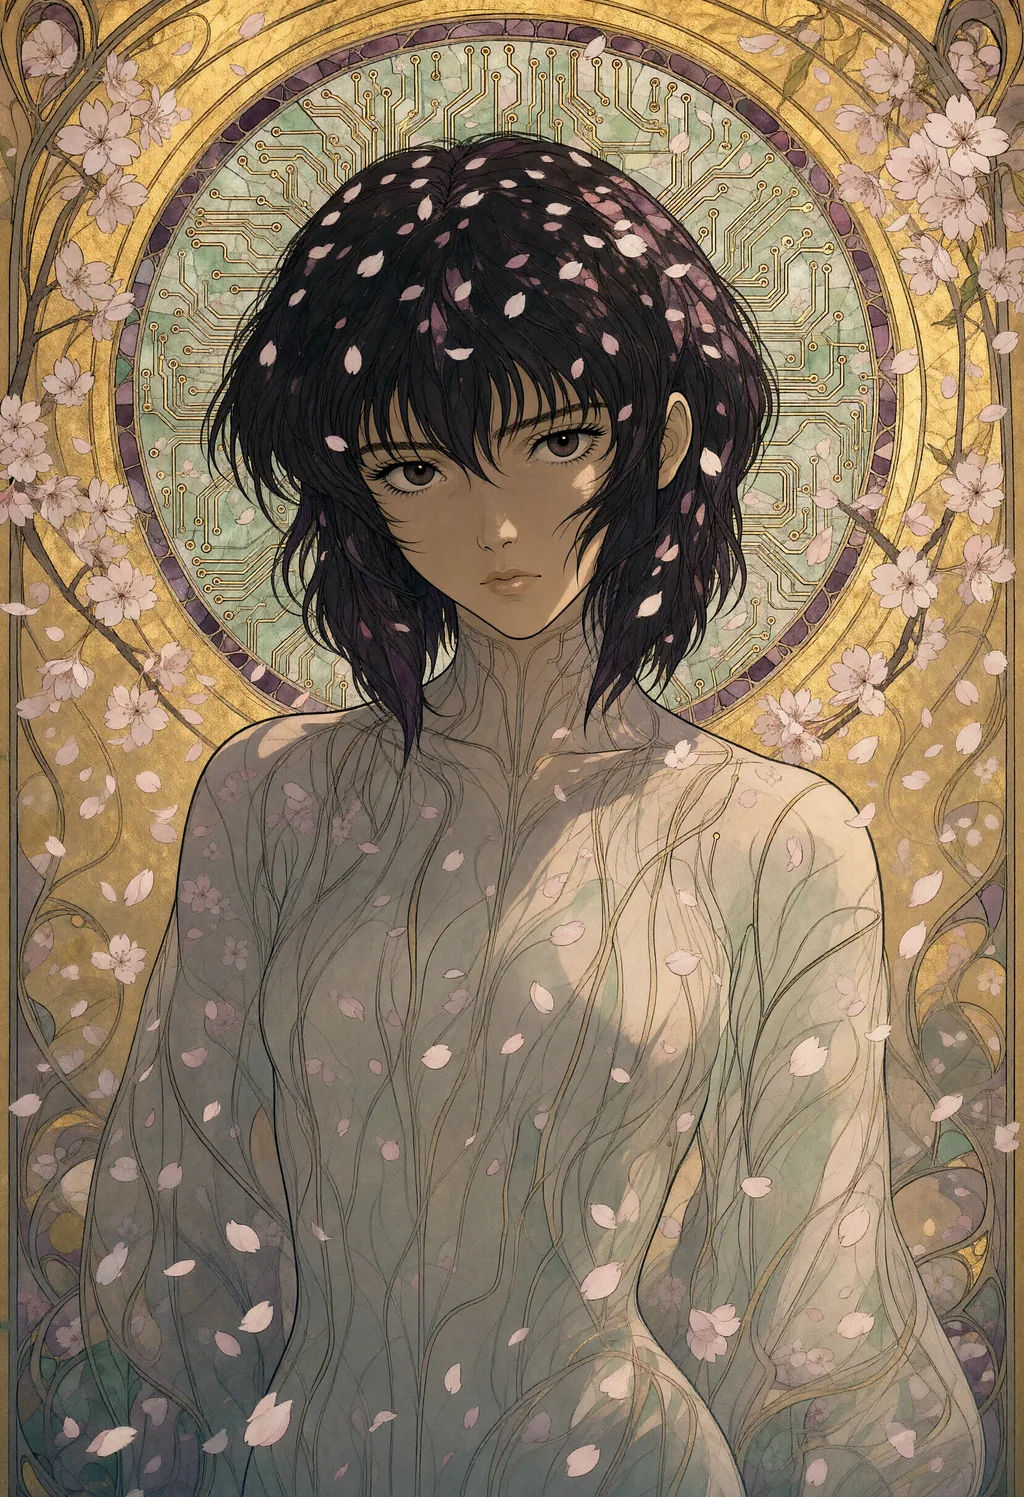
- Medie og motiv først: "An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms". Mediet, der står først, farver alt det efterfølgende.
- Omgivelser: sted, epoke, vejr eller det, der fylder luften. "in falling cherry blossoms", "in the 1980s", "during a blizzard".
- Lys med retning: "lit from the front by soft diffuse light, with gentle shadows". Retningen bliver fulgt. Et nøgent "dramatic light" bliver det ikke.
- Beskæring: "close-up of the subject, looking at the viewer", medium shot, set oppefra, motivet bittelille i et vældigt landskab.
- Materialer og palet: "flowing ink lines, flat gold leaf background, muted jade and plum". Det er det, modellen gengiver bedst i 2K.
- Begrænsninger, skrevet ind i prompten: "no lettering, no watermark", "five fingers on each hand". Ved guidance 1 ignoreres den negative prompt, så prompten selv må bære dem.
Hele prompten til illustrationen ovenfor, i den rækkefølge: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Tekst virker, når den står i anførselstegn og har fået en plads. "A banner above the door reads 'OPEN ALL NIGHT'" kommer rigtigt ud næsten hver gang, med eller uden store bogstaver.
Det omvendte gælder også. En butiksfacade, en diner eller en spillehal uden ønsket tekst får et opdigtet skilt. Sig derfor "no lettering", hver gang scenen indeholder en facade.
Figurer, modellen ikke kender, erstattes uden varsel af en dobbeltgænger. Marsupilami blev til en abe. Mothra og Marvin the Martian kom rigtigt ud.
Hvert Qwen-kort på siden med prompteksempler følger denne struktur, med seed, størrelse og indstillinger.
Indstillinger, der virker, målt
Den officielle ComfyUI-skabelon kører med en guidance (CFG) på 1 og 25 steps. Modelkortet bruger 40 steps. Indstillingerne nedenfor endte på CFG 3.
Senest testet den 16. oktober 2026, på de samme seeds, gav disse indstillinger de mest detaljerede og mest prompttro billeder:
| Indstilling | Værdi |
|---|---|
| Guidance (CFG) | 3, med en negativ prompt |
| Negativ prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Modelpatches | APG (eta 1, norm threshold 10, momentum 0,3) og derefter FreSca (low 1, high 2, cutoff 8), før sampleren |
| Sampler | euler, scheduler simple |
| Steps | 25 ved 1 megapixel, 20 ved 2,5 og 4 megapixel |
| LoRA | intet |
Guidance er den eneste indstilling, der ikke ændrer scenen. Med samme seed og størrelse giver CFG 1 og CFG 3 næsten samme komposition. Det, der adskiller dem, er gengivelsen.
Ved CFG 1 er billedet fladere og mister fin tekstur. Broderisting bliver til stof. Et tegnefilmsansigt mister pupiller og mund. Metal mister sine nitter.
Skruer man CFG 1 op til 30 steps, vender skarpheden tilbage, men hverken materialerne eller kontrasten. Ved 2 megapixel, en størrelse prøvet en enkelt gang, giver 40 steps et rent billede, der stadig er fladere, og prompten læses mindre pålideligt.
APG holder CFG 3 fra at overmætte. FreSca skærper de høje frekvenser. Begge virker kun, når guidance er over 1.
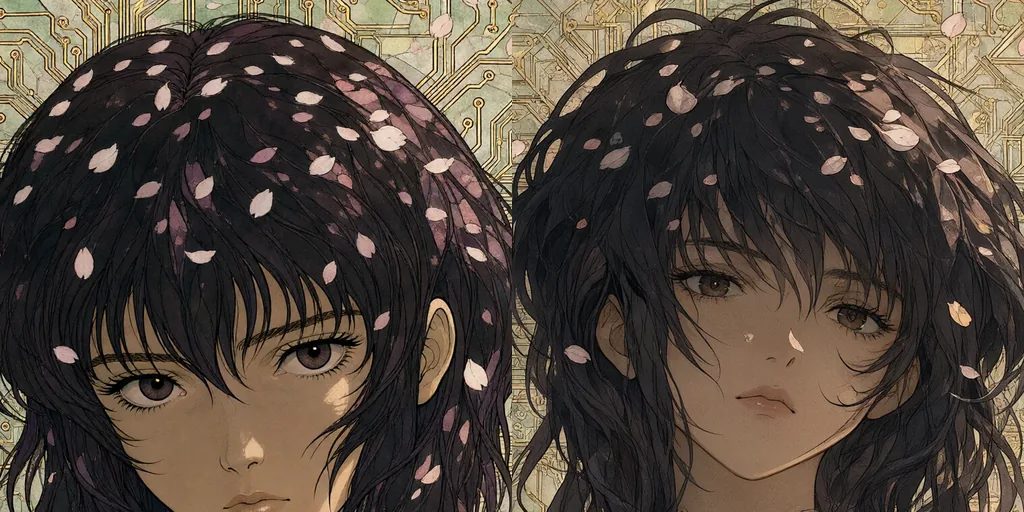
Guidance over 1 koster en ekstra gennemkørsel pr. trin, så CFG 1 er dobbelt så hurtig. På testkortet er det 120 til 135 sekunder mod 255 til 275 for et billede på 4 megapixel. Det langsommere var umagen værd i hvert eneste af ti testpar.
Opløsning og steps: hvad der ændrer billedet
Som enhver diffusionsmodel skalerer Qwen-Image 2.1 ikke billedet, når størrelsen ændres. Det giver en ny udgave af samme seed, så et seed fundet i 1 megapixel kan ikke overføres til 2K.
At gå fra 1 megapixel til 2,5 eller 4 gav et andet billede i hvert testet par. Mellem 2,5 og 4 megapixel holdt kompositionen i otte par ud af ti.
I illustrationen nedenfor flyttede kun detaljerne sig. Ved 2,5 megapixel vandrede printbanerne fra glorien over i håret.
At ændre antallet af steps ændrer også billedet, når springet er stort. 20 og 25 steps giver næsten samme billede. 16 steps driver væk. Der er altså ingen måde at lave en forhåndsvisning i 1 megapixel på og gengive det samme billede større. Vælg størrelsen først, så seedet.
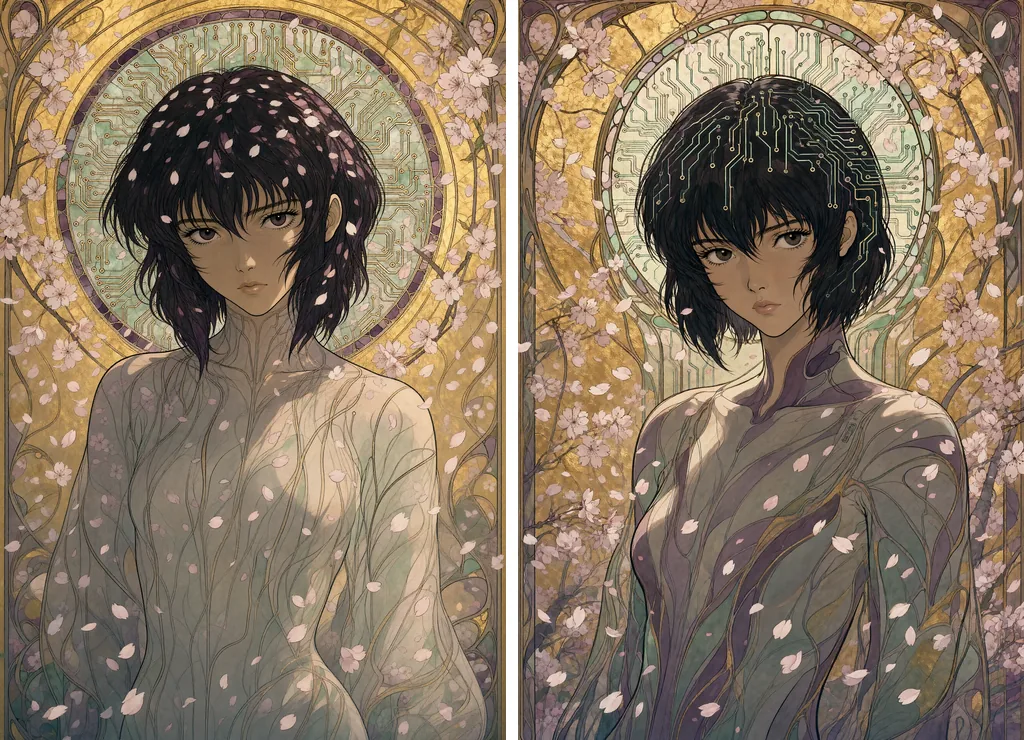
Tider målt med CFG 3, APG og FreSca, int8-vægte, på ét almindeligt grafikkort med 16 GB, i liggende format eller det tilsvarende stående:
| Størrelse | Steps | Tid pr. billede |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | cirka 40 s |
| 2,5 megapixel (1920 × 1312) | 20 | 120 til 135 s |
| 4 megapixel (2432 × 1664) | 20 | 255 til 275 s |
| 4 megapixel | 25 | 315 til 335 s |
Ved 2,5 megapixel er detaljerne lidt blødere end ved 4, når man sammenligner samme område ved 100 %. Men modellen følger promptens stil mindst lige så godt, og i de ti testpar nogle gange bedre. Et broderi viste sine sting tydeligere ved 2,5 megapixel end ved 4.
Til et galleri, der vises i 1024 pixels, er 2,5 megapixel ved 20 steps det bedste kompromis. Til et print, 4 megapixel ved 20 steps.
Hurtigere: Turbo, Turbo med guidance og resten
Turbo. Qwen udgav Qwen-Image-2.1-Turbo den 9. oktober 2026. Det er et destilleret checkpoint, der kører i 8 steps ved CFG 1 med et fast sigma-skema. Comfy-Org leverer det som int8-fil og som LoRA til basismodellen, med egne skabeloner i ComfyUI. Det blev målt den 17. oktober på de samme ti seeds og størrelser som denne guides CFG 3-gengivelser, med skabelonens nøjagtige graf.
| Indstilling | Tid pr. billede |
|---|---|
| Turbo-checkpoint, 8 steps, CFG 1, 1 megapixel | 9 til 10 s |
| Turbo-checkpoint, 8 steps, CFG 1, 4 megapixel | 38 til 39 s |
| Turbo med guidance, beskrevet nedenfor: Turbo-checkpoint, 8 steps, CFG 3 med APG og FreSca, 4 megapixel | 66 til 71 s |
| Basis-checkpoint plus Turbo-LoRA, 8 steps, CFG 1, 4 megapixel | 52 til 55 s |
| Basis-checkpoint, CFG 3, 20 steps, 4 megapixel | 255 til 275 s |
Syv gange hurtigere ved 4 megapixel, fire gange ved 1. Billederne er rene: skarpe, godt belyste, ingen anatomifejl på de ti seeds, tekst rigtig på de samme prompts som basismodellen. Promptens objekter er med, nogle gange bedre end med basismodellen. Skildpadden i sin racerbil, som basismodellen havde udeladt i hver eneste gengivelse, dukkede op med Turbo.
Det, den mister, er mediet. På hver eneste ikke-fotografiske prompt blandt de ti seeds drev den destillerede model mod fotografisk realisme. Et broderi af en krokodille blev til et fotografi af en krokodille. En kultegning mistede sin kornethed. En Marvin the Martian i papirklip blev til en vinylfigur. Opdigtede bogstaver på facader er de samme som med basismodellen.
På de ti seeds gav LoRA'et på basis-checkpointet de samme billeder som Turbo-checkpointet, bare langsommere. Så det er checkpointet, man skal hente. Et seed giver et andet billede end med basismodellen, som ved enhver ændring af størrelsen. Licensen er den samme: kun forskning og evaluering.
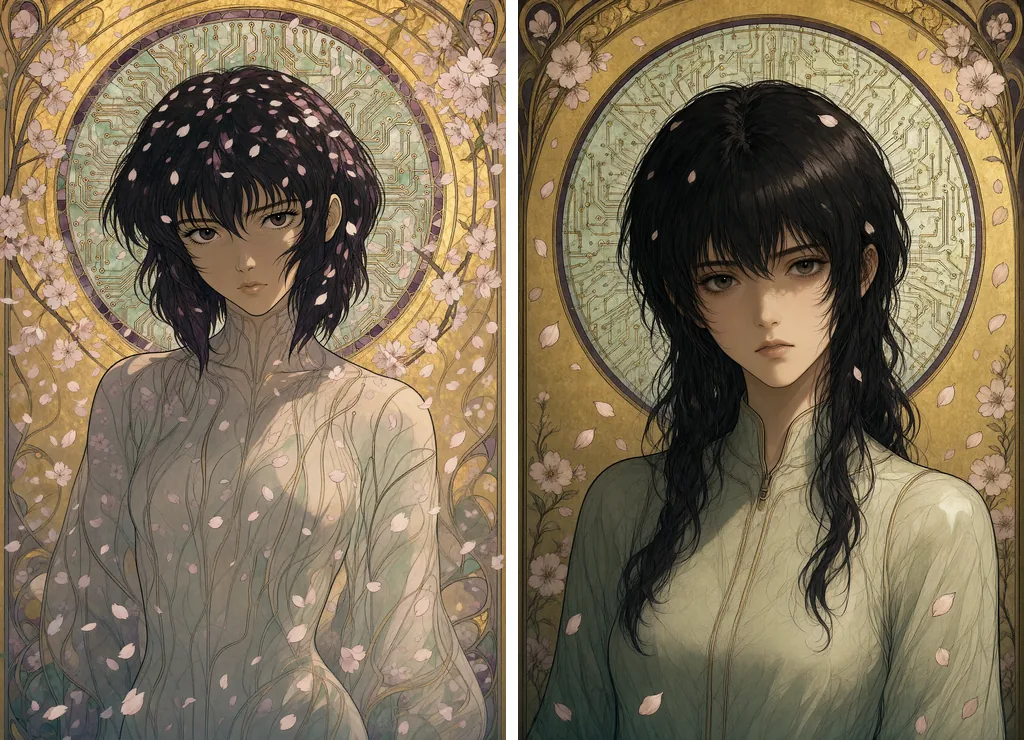
Turbo med guidance. Turbo er ikke låst til CFG 1. Testet den 17. oktober 2026 på de samme ti seeds plus denne guides illustration. Behold dens checkpoint og dens 8 faste sigmaer, og tag kun guidance-blokken fra basisindstillingen: CFG 3, den negative prompt, APG og derefter FreSca.
Grafen er selve Turbo-skabelonen. Sæt dens CFGGuider til 3 i stedet for 1, udfyld den negative prompt, og indsæt APG og derefter FreSca på modelstien mellem loaderen og guideren. ManualSigmas-noden og sampleren bliver, som de er.
Resultatet beholder Turbos komposition og genvinder det, CFG 1 havde gjort fladt: kontrast, mætning og fine detaljer. På denne guides illustration kommer gloriens printbaner tilbage skarpe og forgyldte, og kronbladene vender tilbage. På de ti test-seeds bliver skællene, pelsen og den broderede vest skarpere på samme måde. Det, den ikke genvinder, er mediet. Broderiet forbliver et fotografi af en krokodille.
Prisen er den ekstra gennemkørsel pr. trin: 66 til 71 sekunder for et billede på 4 megapixel mod 38 til 39. Det er stadig næsten fire gange hurtigere end basismodellen.
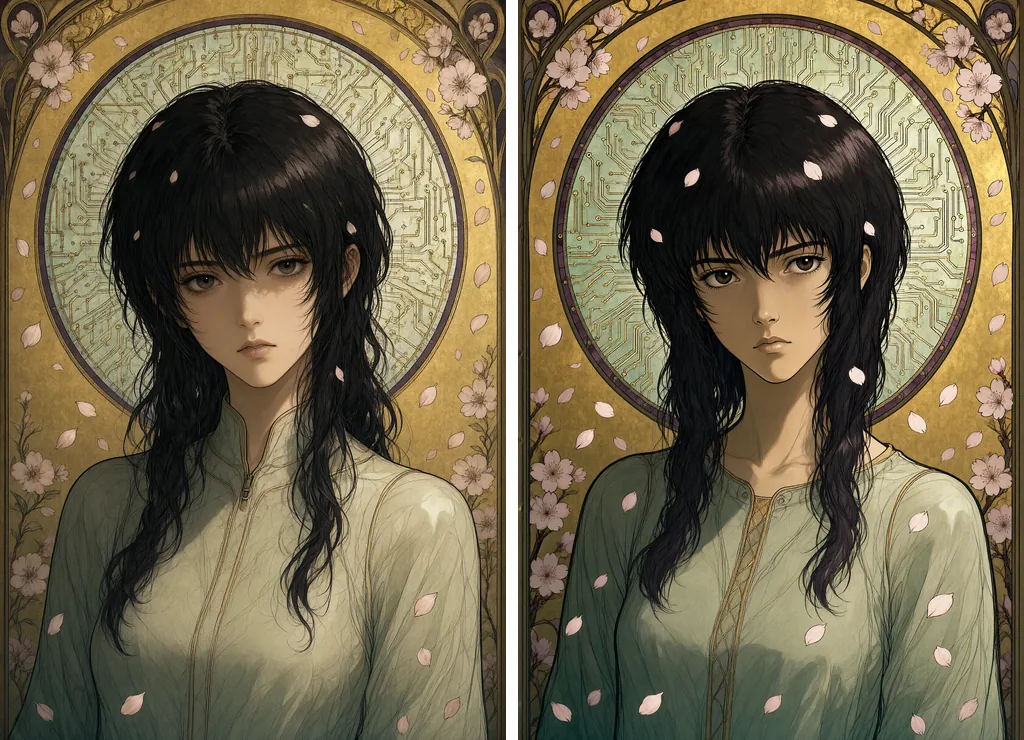
Hent workflowet. ComfyUI-workflowet til Turbo med guidance (JSON) renderer denne illustration, som den er: 1664 × 2432, seed 57658043, CFG 3 med APG og FreSca, denne guides negative prompt. Træk filen ind i ComfyUI; det forventer de tre modelfiler, der er nævnt i sidste afsnit. Fri til genbrug under CC BY 4.0 med et link til denne side.
Prøv ikke at hjælpe Turbo med flere steps. Med 20 steps og scheduleren simple ved 4 megapixel og CFG 3, som var den basismodellen, overdriver den: hårde hårstrå, en kornet glorie, presset kontrast. Og den tager 169 sekunder. Det destillerede checkpoint vil have sine 8 sigmaer.
En fornuftig fordeling. Den rene Turbo som kladdetilstand, med syv gange flere kandidater i timen at vælge imellem. Turbo med guidance, når en fotografisk eller rentegnet prompt hurtigt skal have detaljer. Basismodellen ved CFG 3 til alt, der er malet, tegnet eller håndlavet, hvor selve mediet er pointen.
Andre destillationer. LightX2V udgav et 4-step Lightning LoRA til 2.1 den 13. oktober 2026. Der findes også et 8-step LoRA fra fællesskabet, Turbo8. Begge kører ved CFG 1 ligesom Turbo. Ingen af dem er målt her.
Prefix-cache-noden. ComfyUI's QwenImage21Cache-node sætter kun enhed og præcision for den cache, modellen i forvejen holder. Med standardværdierne ændrer den ingenting. Dens int8-tilstand halverer cachen, hvilket hjælper, når hukommelsen bliver knap i 2K eller ved redigering med flere referencebilleder. Der var intet synligt tab med den i disse tests.
Færre steps. 16 steps sparer cirka en femtedel af tiden, men ændrer kompositionen og vinder ingen skarphed i forhold til 20. Er tiden begrænsningen, så sænk størrelsen før antallet af steps.
Kør Qwen-Image 2.1 lokalt
ComfyUI understøtter modellen native. Tre filer skal i de sædvanlige mapper: diffusionsmodellen i diffusion_models, Qwen3-VL-tekst-encoderen i text_encoders, VAE'en i vae.
På et kort med 16 GB skal du tage de int8-udgaver, Comfy-Org har udgivet. bf16-vægtene virker også, men løber over i systemhukommelsen og tager to til seks gange længere uden synlig gevinst.
Grafen er kort:
- UNETLoader, CLIPLoader med typen
qwen_image, VAELoader; - TextEncodeQwenImage21, som tager prompten og den negative prompt samlet og udsender begge conditionings;
- en tom latent i den valgte størrelse;
- APG og derefter FreSca på modelstien;
- en KSampler ved CFG 3 med euler og scheduleren simple, derefter VAEDecode.
Til et gennemsigtigt billede pakker du motivet ind i den form, modelkortet anbefaler: "This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent." Gem derefter som PNG.
Hukommelse: ved 1 megapixel kører int8-modellen, encoderen og VAE'en i 16 GB uden at røre systemhukommelsen. ComfyUI flytter encoderen ud af videohukommelsen, så snart prompten er kodet. Ved 4 megapixel var prefix-cachen sat til int8, og hukommelsen løb aldrig tør. Det første billede i en session tager længere tid, mens filerne indlæses.