Mi a Qwen-Image 2.1
A Qwen-Image 2.1 egyetlen checkpoint két feladatra: képet generál szövegből, és meglévő képet szerkeszt egy mondat és legfeljebb tíz referenciakép alapján. A generáló rész egy 7 milliárd paraméteres diffúziós transzformer, párban egy Qwen3-VL 8B szövegkódolóval; ez az a fájl, amelyet a ComfyUI betölt hozzá. A nyelvi modell mint kódoló teszi lehetővé, hogy kulcsszólisták helyett egész mondatokat, elrendezési utasításokat és idézőjelbe tett szavakat olvasson, és a tesztjeink ezt igazolják. Ha a prompt átlátszó hátteret kér, valódi alfa-csatornás képet is kiad.
A Qwen szerint a 2.1 a textúrákban, a tipográfiában és a portrémegvilágításban javult, és natív 2K-ban dolgozik: 2048 × 2048 négyzetnél, 2528 × 1696 3:2-nél, 2752 × 1536 16:9-nél, felskálázó nélkül. Az ára az idő. Egy 16 GB videomemóriás otthoni kártyán az int8 súlyokkal egy 1 megapixeles kép körülbelül 40 másodperc, egy 4 megapixeles pedig körülbelül négy és fél perc az alábbi beállításokkal.
Mindenekelőtt: a súlyok a Qwen Research License alatt állnak, kizárólag kutatásra és kiértékelésre, és bármilyen kereskedelmi használathoz külön licenc kell a Qwentől. Az első, 2025 augusztusában kiadott Qwen-Image Apache 2.0 licencű volt; a 2.1 nem az.
Hogyan írj promptot a Qwen-Image 2.1-hez
Mondatokat írj, ne címkéket. A szövegkódoló nyelvi modell: olvassa a szórendet, az elöljárószavakat és az idézőjeleket, és mindent szó szerint vesz. A „lighthouse cat” egy világítótoronyra rajzolt macska lesz. Az alábbi felépítés, ebben a sorrendben, adta nekünk a legjobb eredményt nagyjából ezer képen.
- Először a médium és a téma: „An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. Az elöl megadott médium mindent átszínez, ami utána jön.
- Helyszín: hely, korszak, időjárás, vagy ami a levegőt betölti. „in falling cherry blossoms”, „in the 1980s”, „during a blizzard”.
- Fény, az irányával együtt: „lit from the front by soft diffuse light, with gentle shadows”. Az irányt követi; a puszta „dramatic light”-ot nem.
- Képkivágás: „close-up of the subject, looking at the viewer”, félközeli, felülnézet, a téma aprón egy hatalmas tájban.
- Anyagok és paletta: „flowing ink lines, flat gold leaf background, muted jade and plum”. Ezt rendereli a modell a legjobban 2K-ban.
- Tiltások, a promptba írva: „no lettering, no watermark”, „five fingers on each hand”. 1-es guidance mellett a negatív prompt figyelmen kívül marad, ezért magának a promptnak kell hordoznia őket.
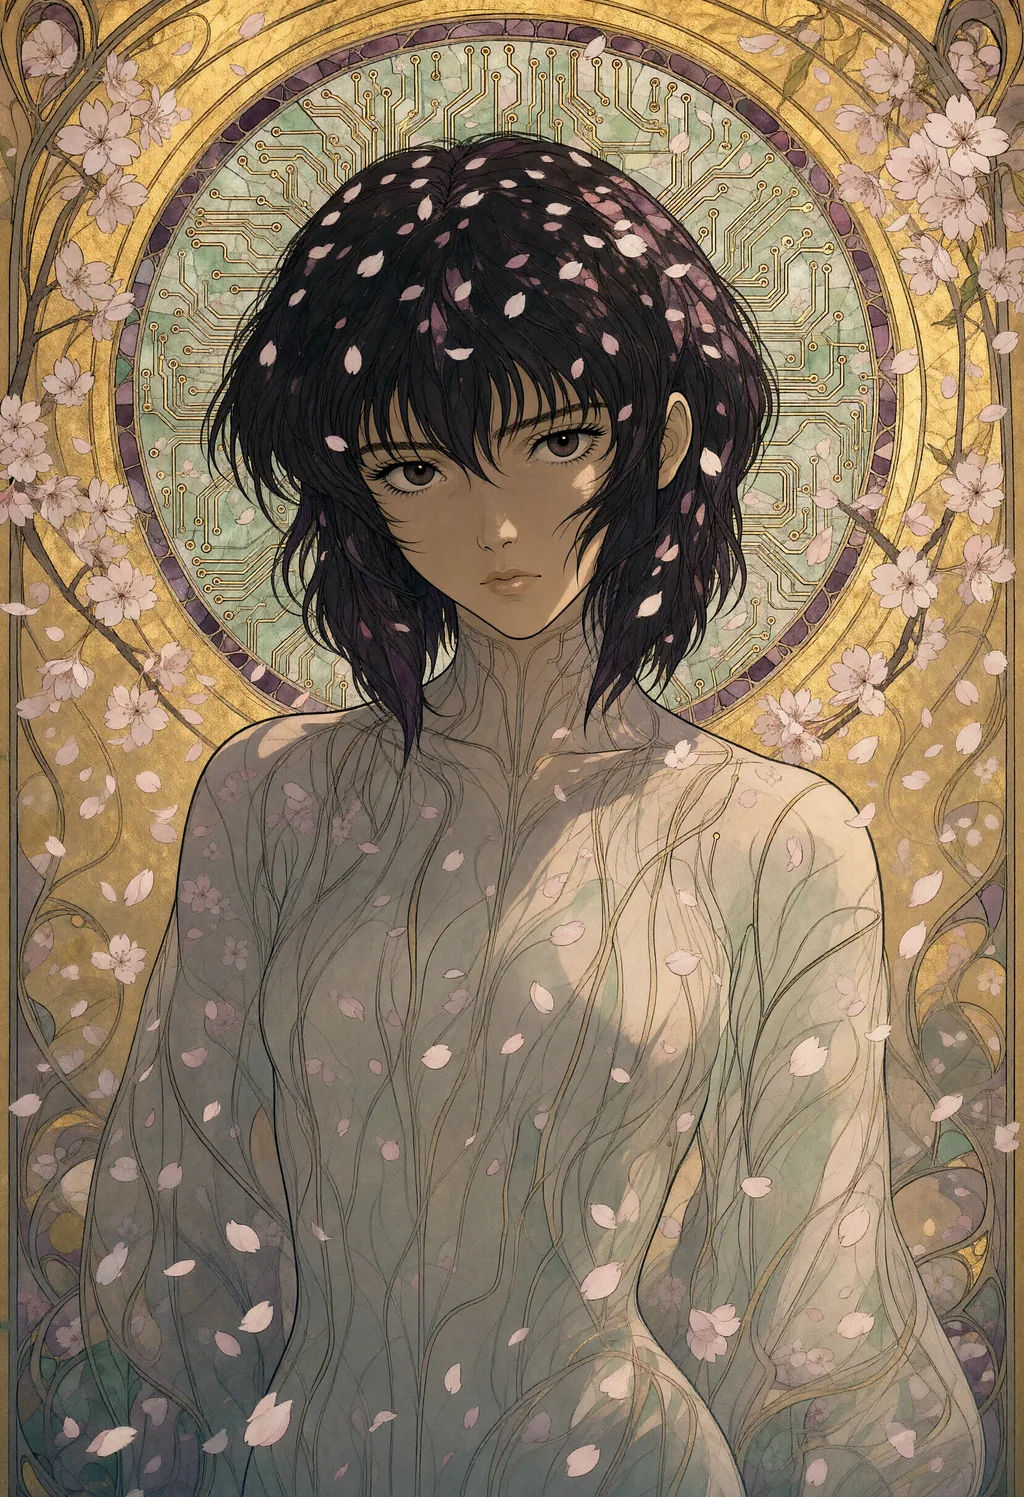
A fenti illusztráció teljes promptja, ebben a sorrendben: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
A szöveg akkor működik, ha idézőjelben van, és a helye is meg van adva: „a banner above the door reads 'OPEN ALL NIGHT'” szinte mindig jól jön ki, csupa nagybetűvel vagy anélkül. A fordítottja is igaz: egy kirakat, egy étkezde vagy egy játékterem, ahová nem kértél szöveget, kitalált feliratot növeszt, ezért írd oda a „no lettering”-et, valahányszor homlokzat van a jelenetben. A modell által nem ismert szereplőket figyelmeztetés nélkül hasonmásra cseréli: a Marsupilamiból majom lett, míg Mothra és Marvin the Martian jól sikerült. A promptpéldák oldalunk minden Qwen-kártyája ezt a felépítést követi, a seedjével, méretével és beállításaival együtt.
Beállítások, amelyek működnek, lemérve
A hivatalos ComfyUI-sablon 1-es guidance-szel (CFG) és 25 lépéssel fut, a modellkártya pedig 40 lépést használ. Mi magasabb guidance-t választottunk. A legutóbbi, 2026. október 16-i teszten, azonos seedeken, ezek a beállítások adták a legrészletesebb és leghűbb képeket:
| Beállítás | Érték |
|---|---|
| Guidance (CFG) | 3, negatív prompttal |
| Negatív prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Modellpatch-ek | APG (eta 1, norm threshold 10, momentum 0.3), majd FreSca (low 1, high 2, cutoff 8), a sampler előtt |
| Sampler | euler, simple scheduler |
| Lépések | 25 lépés 1 megapixelnél, 20 lépés 4 megapixelnél |
| LoRA | nincs |
A guidance az egyetlen beállítás, amely nem változtatja meg a jelenetet: azonos seed és méret mellett a CFG 1 és a CFG 3 szinte ugyanazt a kompozíciót adja, a különbség a renderelésben van. CFG 1-en a kép laposabb, és elveszti a finom textúrát: a hímzés öltései szövetté válnak, egy rajzfilmarc elveszti a pupilláit és a száját, a fémről eltűnnek a szegecsek. Ha a CFG 1-et 30 lépésre toljuk, az élesség visszajön, de az anyagok és a kontraszt nem; 40 lépés 2 megapixelen tiszta, de még mindig laposabb, és kevésbé megbízhatóan követte a promptot. Az APG megakadályozza, hogy a CFG 3 túltelítsen, a FreSca pedig élesíti a magas frekvenciákat; mindkettő csak 1 fölötti guidance mellett hat.
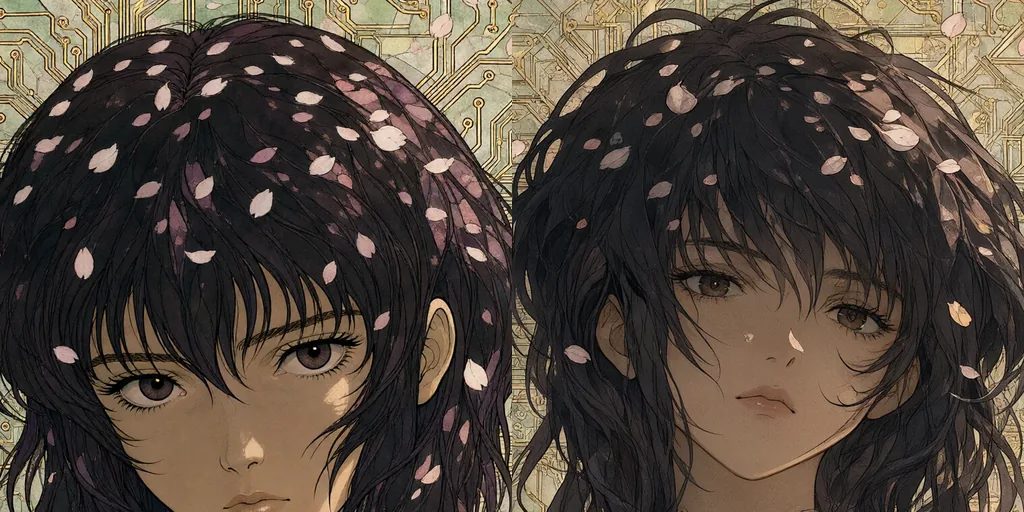
Az 1 fölötti guidance ára egy második menet lépésenként: a CFG 1 kétszer gyorsabb. A mi kártyánkon ez 120–135 másodperc a 255–275-tel szemben egy 4 megapixeles képnél, és a lassabb mind a tíz tesztpárban megérte.
Felbontás és lépésszám: mi változtatja meg a képet
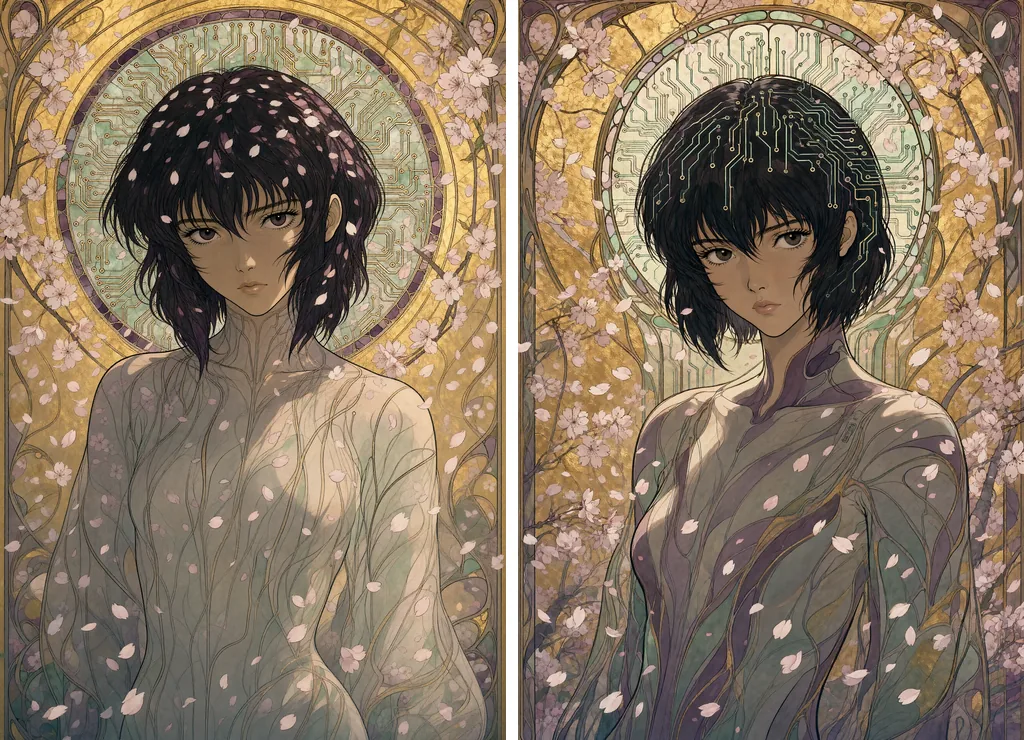
Két dolog lepett meg minket. A méret megváltoztatása nem méretezi át a képet, hanem ugyanannak a seednek egy másik felvételét adja. 1 megapixelről 2,5-re vagy 4-re váltva mindig más képet kaptunk; 2,5 és 4 megapixel között a kompozíció tíz párból nyolcban megmaradt, ahogy az alábbi illusztráción is, ahol csak a részletek mozdultak el: 2,5 megapixelen az áramköri vezetősávok a glóriából a hajba vándoroltak. A lépésszám módosítása is megváltoztatja a képet, ha a különbség nagy: 20 és 25 lépés szinte ugyanazt a képet adja, 16 lépésnél elcsúszik. Nincs tehát mód arra, hogy 1 megapixelen előnézetet készíts, majd ugyanazt a képet nagyobban rendereld. Először a méretet válaszd ki, azután a seedet.
CFG 3, APG és FreSca mellett, int8 súlyokkal, egyetlen 16 GB-os otthoni kártyán mért idők:
| Méret | Lépések | Idő képenként |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | kb. 40 s |
| 2,5 megapixel (1920 × 1312) | 20 | 120–135 s |
| 4 megapixel (2432 × 1664) | 20 | 255–275 s |
| 4 megapixel | 25 | 315–335 s |
2,5 megapixelen a részletek kicsit lágyabbak, mint 4-en, ha ugyanazt a területet 100%-on hasonlítod össze, de a modell legalább ugyanolyan jól követi a prompt stílusát, a tíz tesztpárunkban néha jobban is: egy hímzés 2,5 megapixelen megtartotta a látható öltéseit, 4-en fotóvá változott. Egy 1024 pixelen kiszolgált galériához 2,5 megapixel 20 lépéssel az ideális. Nyomtatáshoz 4 megapixel 20 lépéssel.
Gyorsítások: a hivatalos Turbo, lemérve
Az első Lightning LoRA. A 2025-ös, 8 lépéses Qwen-Image-Lightning LoRA-t az első Qwen-Image modellen tanították, amelynek figyelemrétegei 3072 szélesek. A Qwen-Image 2.1 4096-ot használ. A ComfyUI figyelemsúlyonként egy hibát ír ki, átugorja őket, és a csupasz modellt rendereli 8 lépésben: első ránézésre elég éles, de a LoRA-t nem kapod meg, és egy nem desztillált modell 8 lépéses képe nem az, amit akartál.
A hivatalos Turbo. A Qwen 2026. október 9-én adta ki a Qwen-Image-2.1-Turbo modellt: desztillált checkpoint, amely 8 lépésben, CFG 1-en, rögzített szigma-ütemezéssel fut; a Comfy-Org int8 fájlként és az alapmodellhez való LoRA-ként szállítja, saját sablonokkal a ComfyUI-ban. Október 17-én mértük le, ugyanazon a tíz seeden és méreten, mint a CFG 3-as rendereléseinket, a sablon pontos gráfjával.
| Beállítás | Idő képenként |
|---|---|
| Turbo checkpoint, 8 lépés, 1 megapixel | 9–10 s |
| Turbo checkpoint, 8 lépés, 4 megapixel | 38–39 s |
| Alap checkpoint plusz Turbo LoRA, 8 lépés, 4 megapixel | 52–55 s |
| A mi beállításunk, CFG 3, 20 lépés, 4 megapixel | 255–275 s |
Hétszer gyorsabb 4 megapixelen, négyszer 1-en, és a képek tiszták: élesek, jól megvilágítottak, anatómiai hiba nélkül a tíz seedünkön, a szöveg ott jó, ahol az alapmodellnek is jó. A prompt tárgyai ott vannak, néha jobban, mint az alapmodellnél: a versenyautójában ülő teknős, amelyet az alapmodell minden renderelésünkből kihagyott, a Turbo modellel megjelent. Amit elveszít, az a médium. A desztillált modell a fotorealizmus felé sodródik, bármit kér is a prompt: egy krokodilhímzésből krokodilfotó lett, egy szénrajz elvesztette a szemcséit, egy papírkivágásos Marvin the Martian vinilfigurává vált. A homlokzatok kitalált feliratai ugyanolyanok, mint az alapmodellnél. Az alap checkpointra tett LoRA ugyanazokat a képeket adja, mint a Turbo checkpoint, csak lassabban, tehát a checkpointot érdemes letölteni. Egy seed más képet ad, mint az alapmodellel, akárcsak méretváltásnál, és a licenc ugyanaz: kizárólag kutatás és kiértékelés.
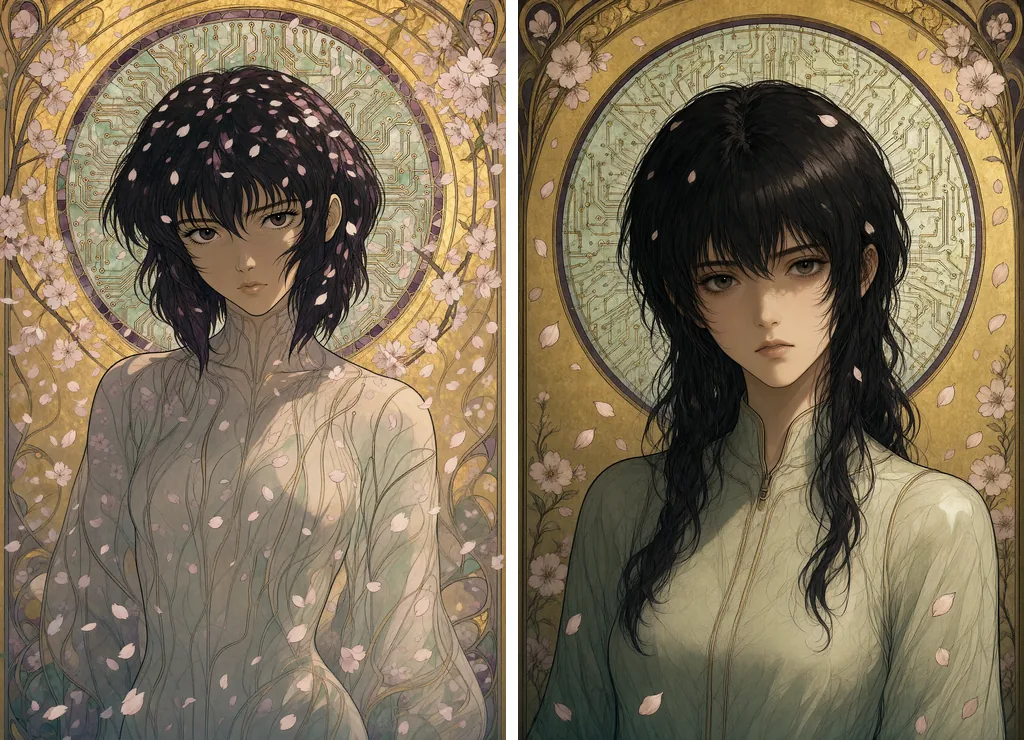
Mi vázlat módként használjuk. Hétszer több jelölt óránként a válogatáshoz, a végső renderelés pedig CFG 3-mal mindenhez, ami festett, rajzolt vagy kézműves. Fotószerű promptoknál a Turbo eredménye gyakran jó úgy, ahogy van.
Más desztillációk. A LightX2V 2026. október 13-án tett közzé egy 4 lépéses Lightning LoRA-t a 2.1-hez, és létezik egy közösségi 8 lépéses LoRA is, a Turbo8; mindkettő CFG 1-en fut, mint a hivatalos Turbo. Ezeket nem mértük le.
A prefix-cache csomópont. A ComfyUI QwenImage21Cache csomópontja csak annak a gyorsítótárnak az eszközét és pontosságát állítja be, amelyet a modell amúgy is vezet; alapértékeken semmit sem változtat. Az int8 módja felezi a gyorsítótárat, és segít, ha 2K-ban vagy több referenciaképes szerkesztésnél elfogy a memória. Látható veszteséget nem tapasztaltunk vele.
Kevesebb lépés. A 16 lépés az idő körülbelül ötödét takarítja meg, de megváltoztatja a kompozíciót, és nem élesebb a 20-nál. Ha az idő a korlát, előbb a méretet csökkentsd, és csak utána a lépésszámot.
A Qwen-Image 2.1 futtatása helyben
A ComfyUI natívan támogatja a modellt. Három fájl kerül a szokásos mappákba: a diffúziós modell a diffusion_models, a Qwen3-VL szövegkódoló a text_encoders, a VAE a vae mappába. 16 GB-os kártyán a Comfy-Org által közzétett int8 változatokat válaszd: a bf16 súlyok is működnek, de átcsordulnak a rendszermemóriába, és kétszer-hatszor tovább tartanak azonos képekért.
A gráf rövid: UNETLoader, CLIPLoader qwen_image típussal, VAELoader, a TextEncodeQwenImage21 csomópont, amely a promptot és a negatív promptot együtt fogadja, és mindkét kondicionálást kiadja, egy üres latens a kívánt méretben, majd APG és FreSca a modell útvonalán, egy KSampler CFG 3-mal, euler samplerrel és simple schedulerrel, végül VAEDecode. Átlátszó képhez foglald a témát a modellkártya ajánlott formájába: „This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.”, és mentsd PNG-ként.
Memória: az int8 modell, a kódoló és a VAE 1 megapixelen bőven elfér 16 GB-ban; a 4 megapixelt int8-ra állított prefix-cache-sel futtattuk, és soha nem fogyott el a memória. A munkamenet első képe tovább tart, amíg a fájlok betöltődnek.