Mi a Qwen-Image, röviden
A Qwen-Image a Qwen képgeneráló vonala; a Qwen az Alibaba felhőrészlegének modellcsaládja. 2025 augusztusában jelent meg 20 milliárd paraméteres modellként, Apache 2.0 licenc alatt, technikai jelentéssel. A szövegével tűnt ki. A bekezdések, táblák és címkék olvashatóan jöttek ki, angolul és főleg kínaiul, ott, ahol a Stable Diffusion 1.5 és az SDXL krikszkrakszot adott, a 2024-es modellek pedig legfeljebb néhány angol szóig jutottak.
A jelenlegi nyílt kiadás a Qwen-Image 2.1, amely 2026. szeptember 20-án jelent meg. Kisebb és gyorsabb modell: 7 milliárd paraméter a képgenerátorban, plusz egy 8 milliárd paraméteres vizuális-nyelvi kódoló. Egyetlen checkpoint két feladatot lát el. Képet generál szövegből, és meglévő képet szerkeszt egy mondat és legfeljebb tíz referenciakép alapján. Natív 2K-t és valódi átlátszó képeket ad ki. A licence már nem Apache: kizárólag kutatás és kiértékelés.
A Stable Diffusionhöz és a FLUX-hoz hasonlóan diffúziós modell, amely a ComfyUI-ban fut egy otthoni videokártyán, és ugyanolyan promptot olvas. A különbség belül van, és ezt magyarázza el a működésről szóló szakasz.
Mit tud a Qwen-Image 2.1
Szövegből kép natív 2K-ban. A modell közvetlenül, felskálázó nélkül rendereli a 2048 × 2048-as négyzetet, a 2528 × 1696-ot 3:2-ben és a 2752 × 1536-ot 16:9-ben. A promptot szövegként olvassa, így a mondatok, az elöljárószavak és az elrendezési utasítások működnek, az idézőjelbe tett szavak pedig úgy jelennek meg, ahogy írva vannak: az “a banner above the door reads ‘OPEN ALL NIGHT’” a beállítási útmutató tesztpromptjain betűhíven jött ki. A beállítási útmutató adja meg a legjobban működő promptszerkezetet és a lemért beállításokat.
Szerkesztés ugyanazzal a checkpointtal. Adj neki egy képet és egy mondatot, és megváltoztatja a képet: kicserél egy tárgyat, átstilizál egy jelenetet, szöveget ad hozzá. Adj neki legfeljebb tíz referenciaképet, és összerakja őket, a karaktert vagy a terméket képről képre egységesen tartva. A területeket maszkkal vagy egy rajzolt körrel lehet kijelölni. A helyi javításokhoz nem kell külön inpainting checkpoint: ugyanaz a modell a területet támpontként veszi.
Átlátszó kimenet. Kérj RGBA képet átlátszó háttérrel, és a modell valódi alfa-csatornát állít elő, nem kivágást: a VAE három helyett négy pixelcsatornát kódol és dekódol. A logók, matricák és rétegezett elemek elhelyezésre készen jönnek ki.
Prompt-átírás. A Qwen két kísérőmodellt ad, Qwen3.5-VL 9B finomhangolásokat, amelyek a rövid promptot a generátor által kedvelt részletes formára bontják ki: egyet generáláshoz, egyet szerkesztéshez. A ComfyUI a sablonjaiban opcióként kínálja őket, alapból kikapcsolva; nem kötelezőek.
Sebesség. Egy 16 GB-os otthoni kártyán az int8 súlyok körülbelül 40 másodpercet vesznek igénybe egy 1 megapixeles képhez, és négy-öt percet 4 megapixelhez a beállítási útmutató minőségi beállításaival. A 2026. október 9-én kiadott, desztillált Turbo checkpoint 8 lépésben renderel, 4 megapixelen nagyjából hétszer gyorsabban, a médium árán: a rajzok, a hímzések és a papírkivágások a fotó felé sodródnak.
Qwen-Image vs Stable Diffusion: hogyan működik
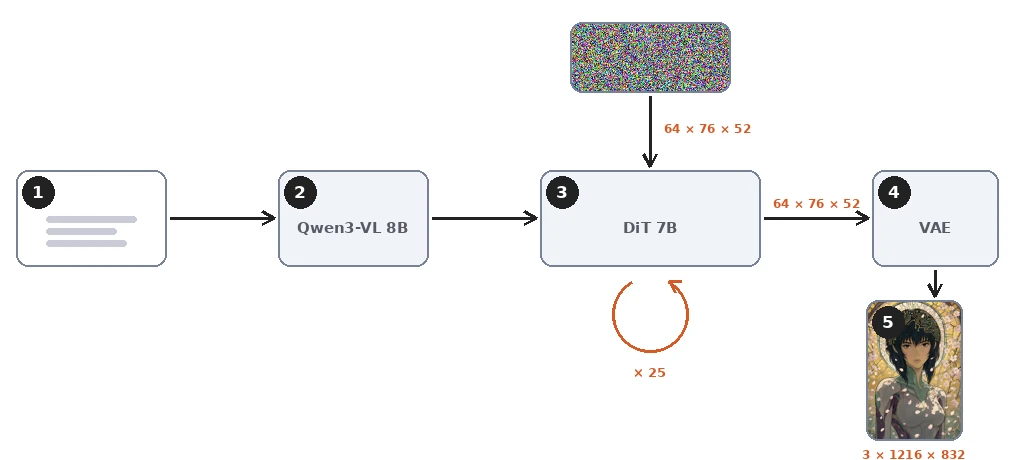
A Qwen-Image 2.1 diffúziós modell, így a Stable Diffusion útmutatóban elmagyarázott mechanika érvényes rá. Egy szövegkódoló beolvassa a promptot. Egy zajtalanító egy tömörített latensen dolgozik több lépésen át. Egy dekódoló a latenst pixelekké alakítja. A különbség abban van, hogy a három részhez mit választottak. Az alábbi tényeket a modell repozitóriuma adja; a Qwen a 2.1-hez nem adott ki technikai jelentést.
Vizuális-nyelvi modell a CLIP helyett
A Stable Diffusion 1.5 és az SDXL a CLIP-pel olvassa a promptot, egy hálóval, amelyet rövid képaláírások és képek párosítására tanítottak. A Qwen-Image 2.1 a Qwen3-VL 8B-vel olvassa, egy teljes értékű, nyolcmilliárd paraméteres vizuális-nyelvi modellel, amely nagyobb magánál a képgenerátornál. Szerkesztésnél ugyanez a kódoló olvassa a referenciaképeket. Ezért működik a beállítási útmutató promptszerkezete. A mondatok, az elöljárószavak, az idézett szöveg és az elrendezési utasítások pontosan azok, amiknek az értelmezésére egy nyelvi modell készült. A CLIP kódoló hajlamos ezeket fogalmak halmazává lapítani.
Egyáramú transzformer a U-Net helyett
A zajtalanító egy 32 rétegű, 7 milliárd paraméteres diffúziós transzformer. Az SDXL U-Netet használ, konvolúciós blokkokat figyelmi rétegekkel közöttük. A Stable Diffusion 3 is transzformerre váltott, az MMDiT-re, amelyben a szöveg- és a képtokenek két áramban, külön súlyokkal haladnak, és csak az egyes rétegek figyelmében találkoznak. A Qwen-Image 2.1 egy lépéssel tovább megy: a szöveg- és a képtokenek egyetlen sorozatot alkotnak, és ugyanazokon a súlyokon mennek át, ezt jelenti az „egyáramú”, a single-stream. A 2025-ös első Qwen-Image egy 20 milliárd paraméteres, kétáramú MMDiT volt; a 2.1 ennek nagyjából a harmada.
A figyelmének két részlete a gyakorlatban is számít. A szövegtokeneket kauzálisan olvassa, mint egy nyelvi modell, és minden kép, akár referencia, akár generált, egyetlen blokk, amelynek tokenjei mind látják egymást. A sorrend: először a prompt, azután a referenciaképek, végül a generált kép, és egy token sosem néz arra, ami utána jön. Így a prompt és a referenciaképek sosem látják a készülő képet, és a számításnak a hozzájuk tartozó része, a prefix, minden lépésben azonos: egyszer számolják ki, és a zajtalanítási lépéseken át gyorsítótárban marad. A ComfyUI QwenImage21Cache csomópontja csak azt választja meg, hol él ez a gyorsítótár, milyen pontossággal, vagy hogy használják-e egyáltalán.
64 csatornás latens, tizenhatszoros tömörítéssel
A Stable Diffusion VAE-je a képet oldalanként nyolcadára zsugorítja 4 csatornába, a 3-as verzióban 16-ba. A Qwen-Image 2.1 VAE-je oldalanként tizenhatodára, 64 csatornába. Három helyett négy pixelcsatornát is kódol és dekódol, vöröset, zöldet, kéket és alfát, így ad ki a modell valódi RGBA képeket ugyanabból a 64 csatornás latensből. Egy 832 × 1216-os képnél a latens 64 csatorna 52 × 76-os rácsból áll: körülbelül 253 000 szám 3 millió pixelértékre, tizenkétszer kevesebb.
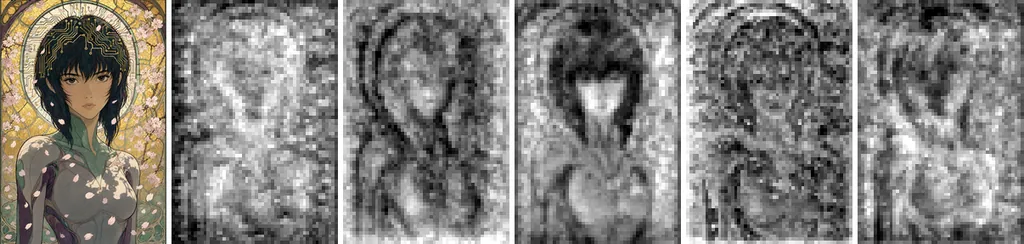
Minden latenspozíció egy token a transzformernek, így egy 1 megapixeles kép 3 952 token, egy 4 megapixeles 15 808. Ez a rács nem durvább, mint a Stable Diffusion 3-é vagy az első Qwen-Image-é, amelyek a 8-szoros latensüket a transzformer előtt 2 × 2-es foltokba csoportosítják. A 2.1 annyit változtat, hogy ezt a csoportosítást maga a VAE végzi, 64 csatornában. A figyelem költsége a tokenek számának négyzetével nő, ezért kerül a 4 megapixel jóval többe, mint négyszer 1 megapixel.
Flow matching a zajbecslés helyett
A Stable Diffusion 1.5-öt és az SDXL-t arra tanították, hogy a képhez adott zajt jósolják meg. A Qwen-Image-et, mint a Stable Diffusion 3-at és a FLUX-ot, flow matching módszerrel tanítják. A háló a zajos latensből a tiszta felé mutató irányt jósolja meg, egyenes vonal mentén. A sampler azután Euler-lépésekkel követi ezt az irányt. A repozitórium meg is nevezi ezt a schedulert: flow matching diszkrét Euler-lépésekkel és dinamikus eltolással (shift). Az első Qwen-Image jelentés írja le a tanítási célt, egy sebességcélt egyenes pályák mentén, és a 2.1 schedulere arra utal, hogy ez nem változott.
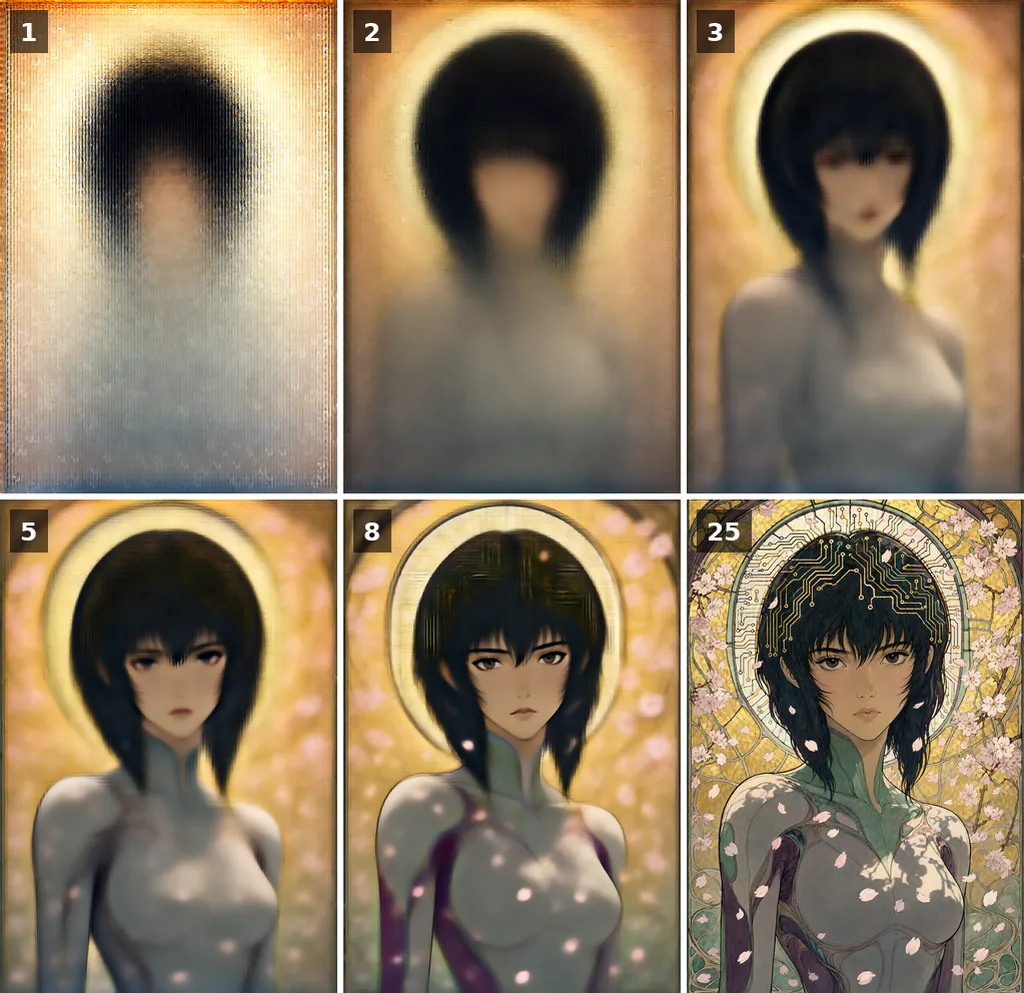
Az alábbi ábra azt mutatja, hogyan néz ki útközben a modell becslése a kész képről. A kompozíció az első lépésekben rögzül, a részletek később érkeznek. Ez a durvától a finomig haladó sorrend minden diffúziós modellben közös; a flow matching főként a lépések elosztását változtatja meg, és ezt hangolja a dinamikus shift.
Egymás mellett
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Szövegkódoló | CLIP ViT-L és OpenCLIP bigG | Két CLIP kódoló és T5-XXL | Qwen3-VL 8B, vizuális-nyelvi modell |
| Zajtalanító | U-Net, 2,6 milliárd paraméter | Kétáramú MMDiT, 8 milliárd | Egyáramú diffúziós transzformer, 7 milliárd, 32 réteg |
| Latens | 4 csatorna, 8× tömörítés | 16 csatorna, 8× | 64 csatorna, 16×, alfával |
| Tanítási cél | Zajbecslés | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Natív méret | 1024 px | 1024 px | 2048 px |
| Szerkesztés | Külső inpainting modell | Nincs hivatalos szerkesztőmodell, csak ControlNetek | Ugyanaz a checkpoint, legfeljebb 10 referenciakép |
| Licenc | OpenRAIL++-M | Community License | Qwen Research License |
Mindez nem változtat azon, hogyan vezérled a modellt. A guidance, a lépések, a seed és a méret úgy viselkedik, mint bármely diffúziós modellben; csak a legjobban működő számok mások, és a beállítási útmutató ezeket méri le.
A verziók, a Qwen-Image-től a 2.1-ig
A számozás zavaró, mert az architektúrát követi, nem a kiadási csatornát. A 2026 februárjában bejelentett, súlyokként soha ki nem adott Qwen-Image 2.0 vezette be azt a könnyebb felépítést, amelyet most a 2.1 nyíltan szállít. A 2026 júliusában bejelentett Qwen-Image 3.0 egy nagyobb zászlóshajó, amely csak az Alibaba API-ján át érhető el. A Qwen nem magyarázta meg a sémát; az alábbi dátumok a projekt repozitóriumaiból, a 3.0 esetében a Qwen bejelentéséből származnak.
| Kiadás | Dátum | Mi ez | Súlyok |
|---|---|---|---|
| Qwen-Image | 2025. augusztus 4. | 20 milliárd paraméteres kétáramú MMDiT Qwen2.5-VL 7B kódolóval; szövegből kép | Nyílt, Apache 2.0 |
| Qwen-Image-Edit, majd Edit-2509 és Edit-2511 | 2025 augusztusától decemberéig | Szerkesztőmodellek ugyanazon az alapon; több referenciakép a 2509-től; egy rétegezett RGBA modell, a Qwen-Image-Layered, decemberben | Nyílt, Apache 2.0 |
| Qwen-Image-2512 | 2025. december 31. | A 20 milliárdos vonal utolsó szövegből kép kiadása | Nyílt, Apache 2.0 |
| Qwen-Image 2.0 | 2026. február 10. | A felépítés, amelyet a 2.1 örököl: Qwen3-VL kódoló, 64 csatornás VAE, natív 2K, legfeljebb 1 000 tokenes utasítások; technikai jelentés 2026 májusában | Nem jelent meg |
| Qwen-Image 3.0 | 2026. július 21. | Zászlóshajó az Alibaba API-ja mögött: legfeljebb 4 500 tokenes promptok, infografikák és storyboardok egy menetben renderelve | Csak API |
| Qwen-Image 2.1 | 2026. szeptember 20. | 7 milliárd paraméteres egyáramú transzformer Qwen3-VL 8B kódolóval; generálás és szerkesztés egy checkpointban, RGBA, 2K | Nyílt, Qwen Research License |
| Qwen-Image 2.1 Turbo | 2026. október 9. | Desztillált 2.1, 8 lépés | Nyílt, Qwen Research License |
Egy letöltési oldalon tehát a szám nélküli „Qwen-Image” a 2025-ös, 20 milliárdos modell, amely a 2512 és az Edit frissítéseivel ma is elérhető. A jelenlegi nyílt modell a 2.1, a 3.0 pedig az Alibaba fizetős szolgáltatása mögötti modell. A 2.1 és a 3.0 közös leszármazású, de a súlyaik nem közösek.
A Qwen-Image licence: nyílt súlyok, csak kutatásra
Az első Qwen-Image és a szerkesztőmodelljei Apache 2.0 alatt voltak: bármire szabadon, a kereskedelmi használatot is beleértve. A Qwen-Image 2.1 és a Turbója a Qwen Research License Agreement alatt áll. A súlyok letölthetők, tanulmányozhatók, futtathatók és finomhangolhatók, de csak kutatásra és kiértékelésre. Bármilyen kereskedelmi használathoz külön licenc kell a Qwentől.
Ezzel a 2.1 máshol áll, mint a Stable Diffusion, amelynek 1.5-ös és SDXL licence tiltott felhasználások listájával engedi a kereskedelmi használatot, a 3.5-ös licence pedig évi egymillió dollár bevétel alatt, és mint a FLUX 3 Klein, amely ötmillió alatt kereskedelmi célra is ingyenes. Egy diáknak vagy egy labornak semmi sem változik. Egy stúdiónak a fizetős API vagy a Qwentől kért kereskedelmi licenc marad nyitva.
A Qwen-Image kipróbálása és a továbblépés
A leggyorsabb út az oldal ingyenes Qwen-Image 2.1 oldala: fiók nélkül, generálás és szerkesztés referenciaképekkel, a várólista élőben látszik.
Otthoni futtatáshoz a ComfyUI natívan támogatja a modellt. A Comfy-Org újracsomagolásából három fájl kerül a szokásos mappákba: a diffúziós modell, a Qwen3-VL szövegkódoló és a VAE, int8 változatban egy 16 GB-os kártyához. A beállítási útmutató végigveszi a gráfot, a promptszerkezetet, a guidance-t és a pontosan ezen a kártyán lemért méreteket, valamint a Turbót és az irányított Turbót.
Az összes ilyen modellben közös elvekhez, a zajhoz, a latens térhez, a guidance-hez és a seedhez olvasd el a Mi az a Stable Diffusion? útmutatót; a magyarázatok átvihetők, csak a számok változnak.