O que é o Qwen-Image, em resumo
O Qwen-Image é a linha de geração de imagens da Qwen, a família de modelos da divisão de nuvem da Alibaba. Chegou em agosto de 2025 como um modelo de 20 bilhões de parâmetros sob a licença Apache 2.0, com um relatório técnico. Ele se destacou pelo texto. Parágrafos, placas e etiquetas saíam legíveis, em inglês e sobretudo em chinês, onde o Stable Diffusion 1.5 e o SDXL produziam rabiscos e os modelos de 2024 acertavam, no máximo, algumas palavras em inglês.
A versão aberta atual é o Qwen-Image 2.1, publicado em 20 de setembro de 2026. É um modelo menor e mais rápido: 7 bilhões de parâmetros para o gerador de imagens, mais um codificador de visão e linguagem de 8 bilhões. Um único checkpoint faz dois trabalhos. Gera uma imagem a partir de texto, e edita uma imagem existente a partir de uma frase e de até dez imagens de referência. Produz 2K nativo e imagens transparentes de verdade. A licença não é mais Apache: só pesquisa e avaliação.
Como o Stable Diffusion e o FLUX, é um modelo de difusão que roda no ComfyUI em uma placa de vídeo doméstica, e lê o mesmo tipo de prompt. A diferença está por dentro, e é isso que a seção sobre como ele funciona explica.
O que o Qwen-Image 2.1 consegue fazer
Texto para imagem em 2K nativo. O modelo renderiza direto quadrados de 2048 × 2048, 2528 × 1696 em 3:2 e 2752 × 1536 em 16:9, sem upscaler. Ele lê o prompt como um texto, então frases, preposições e instruções de composição funcionam, e as palavras entre aspas aparecem como foram escritas: “a banner above the door reads ‘OPEN ALL NIGHT’” sai letra por letra nos prompts de teste do guia de configurações. O guia de configurações traz a estrutura de prompt que funciona melhor e as configurações medidas.
Edição com o mesmo checkpoint. Dê a ele uma imagem e uma frase e ele muda a imagem: trocar um objeto, mudar o estilo de uma cena, adicionar texto. Dê a ele até dez imagens de referência e ele as combina, mantendo um personagem ou um produto consistente entre as tomadas. As regiões podem ser apontadas com uma máscara ou um círculo desenhado. Não é preciso um checkpoint de inpainting separado para edições locais: o mesmo modelo usa a região como indicação.
Saída transparente. Peça uma imagem RGBA com fundo transparente e o modelo produz um canal alfa de verdade, não um recorte: o VAE codifica e decodifica quatro canais de pixel em vez de três. Logos, adesivos e elementos em camadas saem prontos para posicionar.
Reescrita do prompt. A Qwen distribui dois modelos auxiliares, fine-tunes do Qwen3.5-VL 9B, que expandem um prompt curto para a forma detalhada que o gerador prefere, um para geração e outro para edição. O ComfyUI os oferece como opção nos templates, desligados por padrão; eles não são obrigatórios.
Velocidade. Em uma placa doméstica de 16 GB, os pesos int8 levam cerca de 40 segundos para uma imagem de 1 megapixel e de quatro a cinco minutos para 4 megapixels, com as configurações de qualidade do guia de configurações. Um checkpoint destilado, o Turbo, lançado em 9 de outubro de 2026, renderiza em 8 passos, cerca de sete vezes mais rápido em 4 megapixels, ao custo da técnica: desenhos, bordados e papel recortado derivam para a fotografia.
Qwen-Image vs Stable Diffusion: como funciona
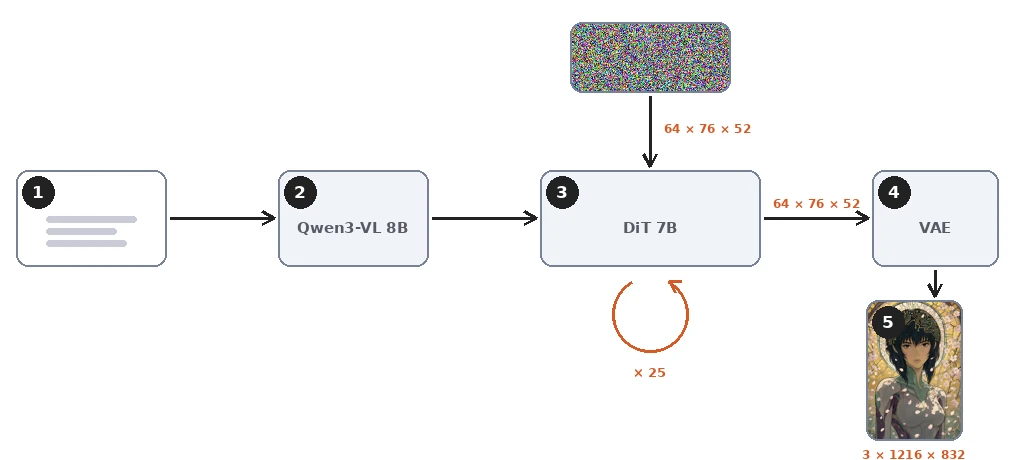
O Qwen-Image 2.1 é um modelo de difusão, então a mecânica explicada no guia do Stable Diffusion vale aqui. Um codificador de texto lê o prompt. Um removedor de ruído trabalha sobre um latente comprimido ao longo de um certo número de passos. Um decodificador transforma o latente em pixels. O que muda é a escolha feita para cada uma das três partes. O repositório do modelo fornece os fatos abaixo; a Qwen não publicou um relatório técnico para o 2.1.
Um modelo de visão e linguagem no lugar do CLIP
O Stable Diffusion 1.5 e o SDXL leem o prompt com o CLIP, uma rede treinada para casar legendas curtas com imagens. O Qwen-Image 2.1 o lê com o Qwen3-VL 8B, um modelo completo de visão e linguagem com oito bilhões de parâmetros, mais do que o próprio gerador de imagens. O mesmo codificador lê as imagens de referência na edição. É por isso que a estrutura de prompt do guia de configurações funciona. Frases, preposições, texto entre aspas e instruções de composição são exatamente o que um modelo de linguagem foi feito para interpretar. Um codificador CLIP tende a achatá-las em um saco de conceitos.
Um transformer de fluxo único no lugar de uma U-Net
O removedor de ruído é um transformer de difusão de 32 camadas e 7 bilhões de parâmetros. O SDXL usa uma U-Net, blocos de convolução com camadas de atenção entre eles. O Stable Diffusion 3 também passou para um transformer, o MMDiT, em que os tokens de texto e de imagem percorrem dois fluxos com pesos separados e só se encontram na atenção de cada camada. O Qwen-Image 2.1 vai um passo além: os tokens de texto e de imagem formam uma única sequência e passam pelos mesmos pesos, e é isso que “fluxo único” (single-stream) quer dizer. O primeiro Qwen-Image, de 2025, era um MMDiT de fluxo duplo com 20 bilhões de parâmetros; o 2.1 tem cerca de um terço desse tamanho.
Dois detalhes da atenção dele importam na prática. Os tokens de texto são lidos de forma causal, como em um modelo de linguagem, e cada imagem, de referência ou gerada, é um bloco cujos tokens se veem todos entre si. A ordem é primeiro o prompt, depois as imagens de referência, por último a imagem gerada, e um token nunca olha o que vem depois dele. Então o prompt e as imagens de referência nunca veem a imagem que está sendo gerada, e a parte do cálculo que pertence a eles, o prefixo, é idêntica em cada passo: ela é calculada uma vez e guardada em cache ao longo dos passos de remoção de ruído. O nó QwenImage21Cache do ComfyUI só escolhe onde esse cache fica, em que precisão, ou se ele é usado ou não.
Um latente de 64 canais, comprimido dezesseis vezes
O VAE do Stable Diffusion encolhe uma imagem por um fator de oito em cada lado em 4 canais, 16 na versão 3. O VAE do Qwen-Image 2.1 a encolhe dezesseis vezes em cada lado, em 64 canais. Ele também codifica e decodifica quatro canais de pixel, vermelho, verde, azul e alfa, em vez de três, e é assim que o modelo produz imagens RGBA de verdade a partir do mesmo latente de 64 canais. Para uma imagem de 832 × 1216, o latente mede 64 canais de 52 × 76: cerca de 253.000 números para 3 milhões de valores de pixel, doze vezes menos.
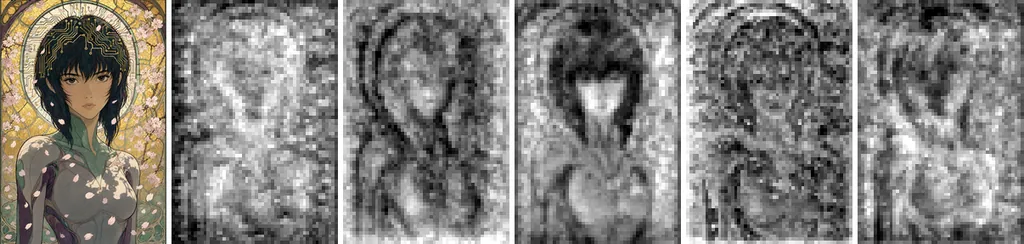
Cada posição do latente é um token para o transformer, então uma imagem de 1 megapixel são 3.952 tokens e uma de 4 megapixels, 15.808. Essa grade não é mais grosseira do que a do Stable Diffusion 3 ou a do primeiro Qwen-Image, que agrupam o latente comprimido 8 vezes em blocos de 2 × 2 antes do transformer. O que o 2.1 muda é que o VAE faz esse agrupamento sozinho, em 64 canais. O custo da atenção cresce com o quadrado do número de tokens, e é por isso que 4 megapixels custam muito mais do que quatro vezes 1 megapixel.
Flow matching no lugar da previsão de ruído
O Stable Diffusion 1.5 e o SDXL foram treinados para prever o ruído adicionado a uma imagem. O Qwen-Image, como o Stable Diffusion 3 e o FLUX, é treinado com flow matching. A rede prevê a direção que leva do latente com ruído ao latente limpo, em linha reta. O sampler então segue essa direção com passos de Euler. O repositório nomeia esse scheduler: flow matching com passos discretos de Euler e um shift dinâmico. O relatório do primeiro Qwen-Image descreve o objetivo, uma velocidade alvo ao longo de trajetórias retas, que o scheduler do 2.1 dá a entender que não mudou.
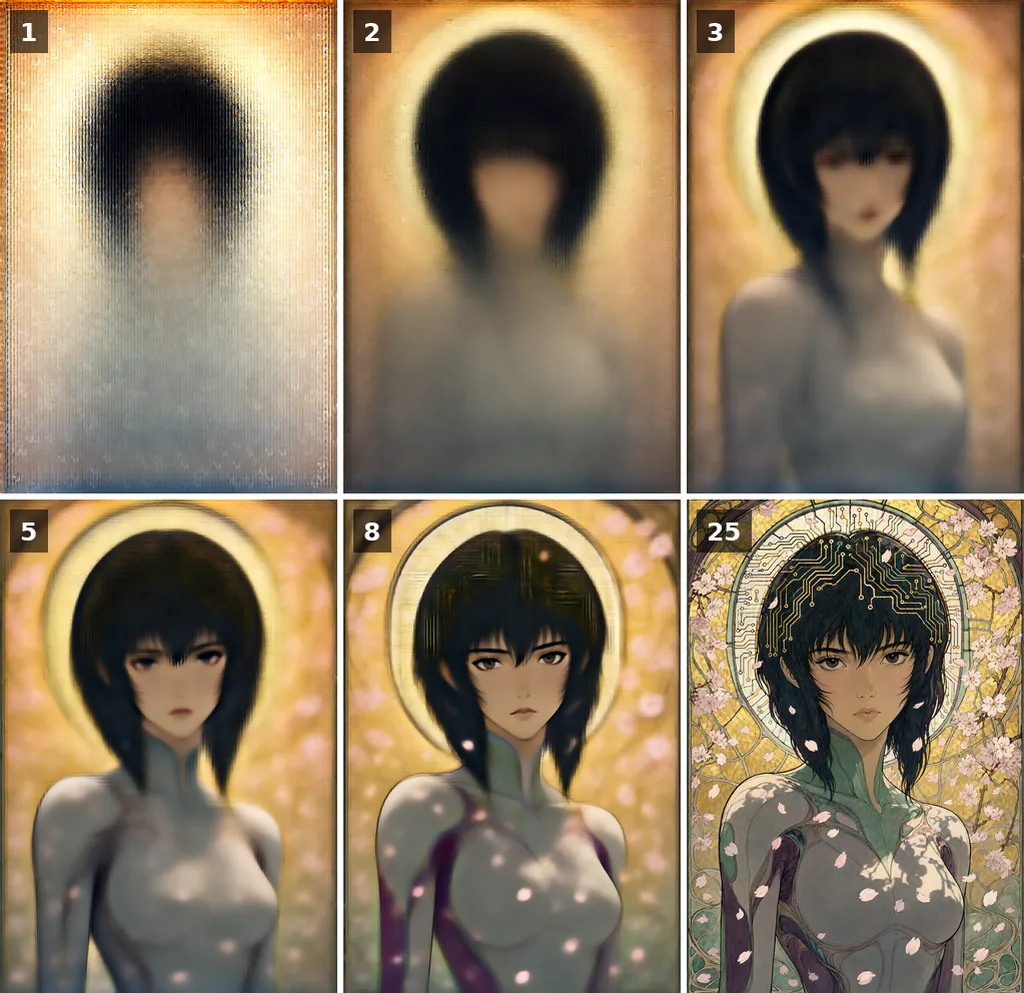
A figura abaixo mostra como evolui, ao longo dos passos, a estimativa que o modelo faz da imagem final. A composição é fixada nos primeiros passos e o detalhe chega depois. Essa ordem, do grosseiro ao fino, é comum a todos os modelos de difusão; o flow matching muda sobretudo o espaçamento dos passos, que é o que o shift dinâmico ajusta.
Lado a lado
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Codificador de texto | CLIP ViT-L e OpenCLIP bigG | Dois codificadores CLIP e T5-XXL | Qwen3-VL 8B, um modelo de visão e linguagem |
| Removedor de ruído | U-Net, 2,6 bilhões de parâmetros | MMDiT de fluxo duplo, 8 bilhões | Transformer de difusão de fluxo único, 7 bilhões, 32 camadas |
| Latente | 4 canais, compressão 8× | 16 canais, 8× | 64 canais, 16×, com alfa |
| Objetivo de treinamento | Previsão de ruído | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Tamanho nativo | 1024 px | 1024 px | 2048 px |
| Edição | Modelo de inpainting de terceiros | Sem modelo oficial de edição, só ControlNets | Mesmo checkpoint, até 10 imagens de referência |
| Licença | OpenRAIL++-M | Community License | Qwen Research License |
Nada disso muda a forma de operar o modelo. Guidance, passos, seed e tamanho se comportam como em qualquer modelo de difusão; só os números que funcionam melhor diferem, e o guia de configurações os mede.
As versões, do Qwen-Image ao 2.1
A numeração confunde porque segue a arquitetura, não o canal de lançamento. O Qwen-Image 2.0, anunciado em fevereiro de 2026 e nunca publicado como pesos, introduziu o design mais leve que o 2.1 agora distribui abertamente. O Qwen-Image 3.0, anunciado em julho de 2026, é um carro-chefe maior, servido só pela API da Alibaba. A Qwen não explicou o esquema; as datas abaixo vêm dos repositórios do projeto e, para o 3.0, do anúncio da Qwen.
| Versão | Data | O que é | Pesos |
|---|---|---|---|
| Qwen-Image | 4 de agosto de 2025 | MMDiT de fluxo duplo com 20 bilhões de parâmetros e um codificador Qwen2.5-VL 7B; texto para imagem | Abertos, Apache 2.0 |
| Qwen-Image-Edit, depois Edit-2509 e Edit-2511 | Agosto a dezembro de 2025 | Modelos de edição sobre a mesma base; várias imagens de referência a partir do 2509; um modelo RGBA em camadas, o Qwen-Image-Layered, em dezembro | Abertos, Apache 2.0 |
| Qwen-Image-2512 | 31 de dezembro de 2025 | Último lançamento texto para imagem da linha de 20 bilhões | Abertos, Apache 2.0 |
| Qwen-Image 2.0 | 10 de fevereiro de 2026 | O design que o 2.1 herda: codificador Qwen3-VL, VAE de 64 canais, 2K nativo, instruções de até 1.000 tokens; relatório técnico em maio de 2026 | Não publicados |
| Qwen-Image 3.0 | 21 de julho de 2026 | Carro-chefe por trás da API da Alibaba: prompts de até 4.500 tokens, infográficos e storyboards renderizados em uma única passada | Só API |
| Qwen-Image 2.1 | 20 de setembro de 2026 | Transformer de fluxo único com 7 bilhões de parâmetros e um codificador Qwen3-VL 8B; geração e edição em um único checkpoint, RGBA, 2K | Abertos, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 de outubro de 2026 | 2.1 destilado, 8 passos | Abertos, Qwen Research License |
Então, em uma página de download, “Qwen-Image” sem número é o modelo de 20 bilhões de 2025, ainda disponível com as atualizações 2512 e Edit. O modelo aberto atual é o 2.1, e o 3.0 é o modelo por trás do serviço pago da Alibaba. O 2.1 e o 3.0 compartilham a linhagem, mas não os pesos.
A licença do Qwen-Image: pesos abertos, só pesquisa
O primeiro Qwen-Image e seus modelos de edição eram Apache 2.0: livres para tudo, uso comercial incluído. O Qwen-Image 2.1 e seu Turbo estão sob o Qwen Research License Agreement. Os pesos podem ser baixados, estudados, executados e passar por fine-tune, mas só para pesquisa e avaliação. Qualquer uso comercial exige uma licença separada da Qwen.
Isso coloca o 2.1 em um lugar diferente do Stable Diffusion, cujas licenças 1.5 e SDXL permitem uso comercial com uma lista de usos proibidos e cuja licença 3.5 o permite abaixo de um milhão de dólares de receita anual, e do FLUX 3 Klein, livre para uso comercial abaixo de cinco milhões. Para um estudante ou um laboratório, nada muda. Para um estúdio, a API paga ou uma licença comercial pedida à Qwen são os caminhos que ficam abertos.
Testar o Qwen-Image e ir além
O caminho mais rápido é a página gratuita do Qwen-Image 2.1 deste site: sem conta, geração e edição com imagens de referência, a fila mostrada ao vivo.
Para rodar em casa, o ComfyUI suporta o modelo nativamente. Três arquivos do reempacotamento da Comfy-Org vão nas pastas de sempre: o modelo de difusão, o codificador de texto Qwen3-VL e o VAE, em versões int8 para uma placa de 16 GB. O guia de configurações cobre o grafo, a estrutura do prompt, o guidance e os tamanhos medidos exatamente nessa placa, além do Turbo e do Turbo guiado.
Para os princípios que todos esses modelos compartilham, ruído, espaço latente, guidance e seed, leia O que é Stable Diffusion?; as explicações valem aqui também, só os números mudam.