Stable Diffusion IA online
Inteligência Artificial Acessível a Todos gratuitamente
Gere imagens de IA gratuitamente, diretamente no seu navegador.
Insira um prompt. Nossas ferramentas criam imagens únicas em segundos. Nenhuma conta, GPU ou instalação necessária.
Ferramentas gratuitas de geração de imagens online
 Stable Diffusion 3
Texto para imagem com Stable Diffusion 3, sem conta
 Inpainting Popular
Repintar qualquer parte de uma imagem a partir de um texto
 Upscaling Popular
Ampliar uma imagem em até 2x com detalhes mais nítidos
 Stable Diffusion XL demo
Demo online gratuita do Stable Diffusion XL 1.0, sem conta
Ferramentas gratuitas de Inteligência Artificial e LLM:
Obras da Comunidade
 gouache painting of a fjord with a red cabin
 higly detailed, majestic royal tall ship on a calm sea,realistic painting, by Charles Gregory Artstation and Antonio Jacobsen
 pixel art of a game room
 luminist painting of a calm bay
 an ink and wash of astro boy lit by storm light from above with deep shadows in profile white space around
 a fantasy creature concept of a giant moss covered stone golem walking through a forest birds nesting on its
 anime style a bike ride on a levee at a homecoming
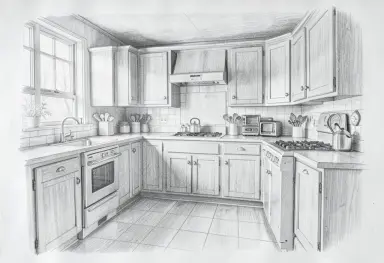 pencil drawing of a cottage kitchen
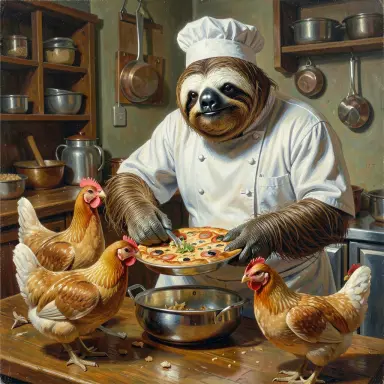 oil painting of a sloth pizzaiolo while feeding hens
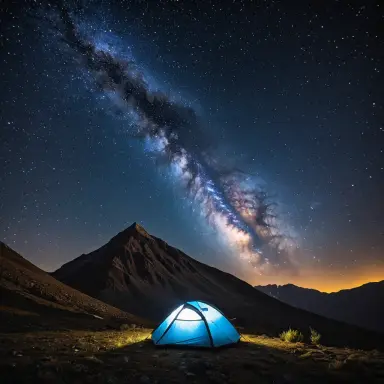 photograph of a tent glowing under the milky way with a mountain silhouette professional photography soft
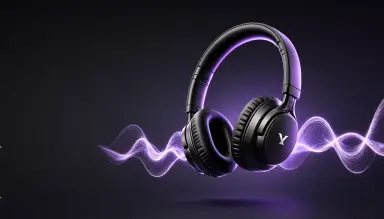 a product launch banner for headphones a pair of sleek black headphones floating with soundwave light ribbons
 anime background a library with tall windows and sunbeams
 origami crane collection in gradient colours papercraft illustration soft shadows
 anime style a torii in fog with children chalking the pavement
 a children s book illustration of a little girl in a yellow raincoat walking a giant friendly snail through a
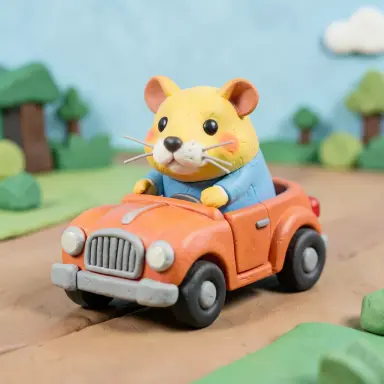 a hamster driving a toy car claymation
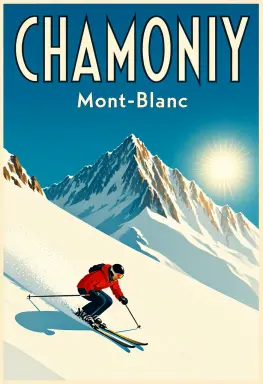 a ski resort poster in a 1930s art deco travel style the headline chamonix at the top in tall geometric
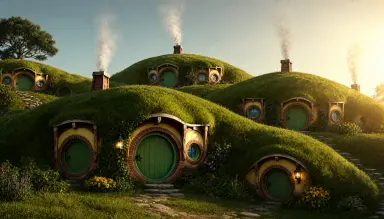 a fantasy concept art of a village of round hobbit like houses built into green hills smoke rising from
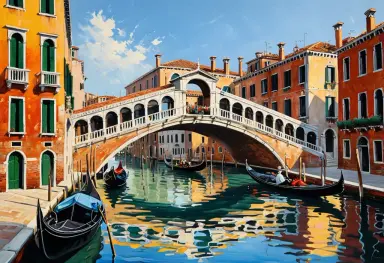 oil painting of a venetian bridge over a canal on a bright morning gondolas loose brushwork warm colours
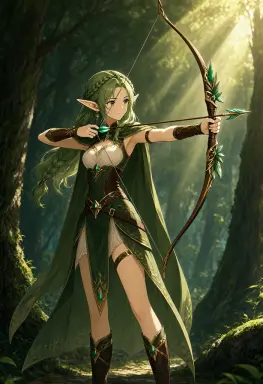 an anime illustration of an elf archer with braided green hair drawing a bow in an ancient forest lit from
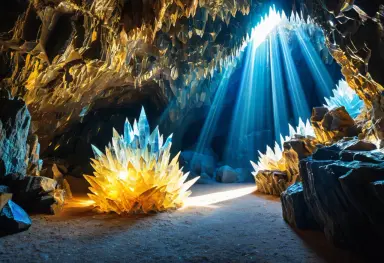 photograph style of a glowing crystal cave with sunlight pouring in blue and gold masterpiece
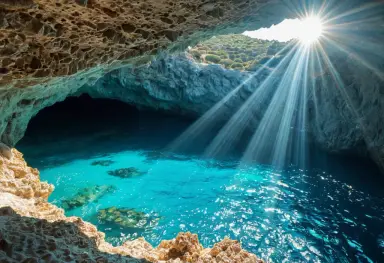 sea cave with turquoise water and sunlight shaft mediterranean coast
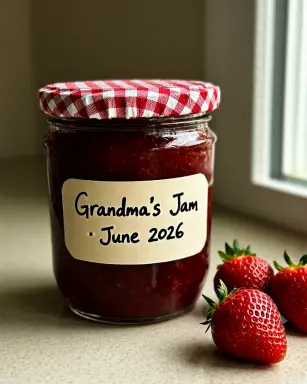 a photograph of a jar of homemade strawberry jam with a gingham cloth lid the handwritten label reads grandma
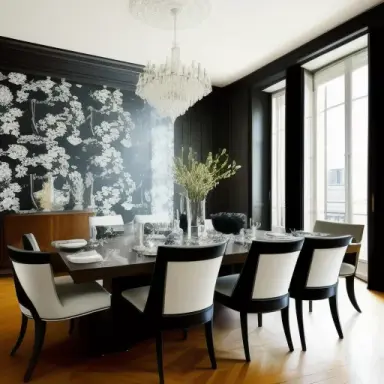 Parisian contemporary interior penthouse big dining room, floral wallpapers
O que é Stable Diffusion?
Stable Diffusion é uma IA que cria imagens a partir de texto. Digite o que quer — ela gera a imagem.
Desenvolvida por StabilityAI , é open source. Roda em uma GPU padrão — sem nuvem. A comunidade é muito ativa. Muitos modelos e add-ons são gratuitos. Você pode até treiná-la com suas próprias imagens!
Foi treinada com milhões de imagens. Use-a para arte digital, edição de fotos, animações e muito mais.
Você pode ver exemplos na nossa galeria de prompts, Galeria de Arte e navegador de imagens..Perguntas Frequentes
O Stable Diffusion é gratuito?
Sim. O Stable Diffusion é um modelo de código aberto, gratuito para baixar e executar no seu próprio computador. Todas as ferramentas deste site também são gratuitas: as demos online, o inpainting, o upscaling e o gerador de prompts funcionam sem conta, e o texto para imagem na nossa própria GPU pede apenas uma conta gratuita. Sem créditos, sem assinatura.
Preciso de uma conta para gerar imagens?
Não é necessário ter conta para as demos online, o inpainting, o upscaling de imagens e o gerador de prompts: abra a página e comece. Uma conta gratuita, criada com um endereço de e-mail, libera o texto para imagem na nossa própria GPU com Stable Diffusion 1.5 e SDXL 1.0, com controle total de passos, escala CFG, seed e tamanho da imagem.
Como usar o Stable Diffusion online?
Abra a demo gratuita, escreva uma descrição da imagem que você quer e clique em Generate. A imagem aparece em poucos segundos e você pode baixá-la. Para melhorar o resultado, acrescente detalhes de estilo e iluminação, escreva um prompt negativo ou altere a seed para explorar variações. Não é preciso instalar nada.
Este é o site oficial do Stable Diffusion?
Não. O Stable Diffusion é desenvolvido pela Stability AI, cujo site oficial é stability.ai. O stablediffusion.fr é um site independente, online desde 2022, que oferece ferramentas gratuitas para usar o Stable Diffusion e outros modelos abertos no navegador, com guias, exemplos de prompts e referências de artistas. Não é afiliado à Stability AI.
O que é um prompt?
Um prompt é uma descrição de texto que orienta a IA. Pode incluir o assunto, estilo artístico, iluminação, humor e meio — por exemplo: 'um cavaleiro medieval numa floresta escura, pintura a óleo, iluminação dramática, cinematográfico'. Quanto mais específico for o seu prompt, mais próximo o resultado estará da sua visão. Mantenha-o com menos de 350 caracteres para melhores resultados.
Um prompt negativo diz à IA o que deve ser excluído da imagem.
Leia o guia completo: Como escrever um prompt para o Stable Diffusion? →
O que é um prompt negativo?
Um prompt negativo diz à IA o que ela NÃO deve mostrar. Exemplos comuns: 'blurry, low quality, watermark, text, deformed hands'. Use-os para remover erros típicos de IA.
Prompts negativos melhoram a qualidade rápido. Adicione pesos — como '(blurry:1.4)' — para torná-los mais fortes.
O que significa seed?
A seed é um número que inicializa o processo aleatório por trás da geração de imagens. Cada imagem começa a partir de ruído, e a seed determina como esse ruído inicial se parece. Deixe-a em -1 para obter uma seed aleatória — e uma imagem diferente — cada vez.
Fixe a seed para reproduzir exatamente a mesma imagem. Isso é útil para experimentar: mantenha a seed constante enquanto muda apenas o prompt ou as configurações para comparar variações com precisão. É também como você recria um resultado favorito mais tarde.
Leia o guia completo: Para que serve a seed no Stable Diffusion? →
O que é LoRA?
LoRA significa Low-Rank Adaptation. É um pequeno arquivo adicional (tipicamente 50–150 MB) que ajusta um modelo base para um estilo, personagem ou assunto específico — sem retreinar todo o modelo.
Carregue um LoRA para gerar imagens em um estilo artístico específico, reproduzir um personagem particular ou corresponder a um conceito de referência. Você pode combinar vários LoRAs em um prompt usando pesos: <lora:my-style:0.8>. Milhares de LoRAs gratuitos estão disponíveis no Civitai e Hugging Face.
Leia o guia completo: O que é um LoRA no Stable Diffusion? →
Como instalar o Stable Diffusion localmente?
Executar o Stable Diffusion localmente requer uma GPU NVIDIA recente com pelo menos 6 GB de VRAM. As GPUs AMD funcionam com os drivers ROCm no Linux. O Apple Silicon (M1/M2/M3) também é suportado via backend MPS. Se você não tem uma GPU compatível, nossa ferramenta online gratuita funciona diretamente no seu navegador — sem instalação necessária.
Primeiro, baixe o base model e o refiner do Stability AI.Em seguida, instale Python 3.10 e Git.
Baixe o webUI em Automatic1111.
Coloque ambos os modelos na pasta models/Stable-diffusion .
Encontrewebui.bat e clique duas vezes para instalar.
Abra seu navegador em localhost:7860.
Leia o guia completo: Como instalar o Stable Diffusion no seu computador? →
Quanta VRAM preciso para o Stable Diffusion?
Você precisa de pelo menos 4 GB de VRAM para rodar o Stable Diffusion. 6 GB é o mínimo recomendado para modelos SDXL. Com 8 GB ou mais, você pode gerar imagens maiores e usar mais recursos.
Sem GPU, você ainda pode rodar o Stable Diffusion na CPU, mas é muito mais lento. Você também pode usar nossa demo online gratuita sem necessidade de GPU.
O que é img2img?
Img2img permite usar uma imagem existente como ponto de partida. Você fornece uma imagem de origem e um prompt. O Stable Diffusion então transforma a imagem com base nas suas instruções.
Use para mudar o estilo de uma foto, corrigir uma imagem gerada ou refinar um esboço. A força de denoising controla o quanto a IA altera o original — baixa mantém próximo, alta transforma completamente.
Posso usar imagens do Stable Diffusion comercialmente?
Depende do modelo. Os modelos base do Stable Diffusion usam a licença CreativeML Open RAIL-M. Isso permite uso comercial, mas com restrições — você não pode usar as imagens para prejudicar ou enganar pessoas.
Sempre verifique a licença do checkpoint que você usa. Alguns modelos da comunidade restringem o uso comercial. Se vender ou publicar imagens geradas por IA, guarde um registro do modelo e da licença.
O que é ControlNet?
ControlNet é uma extensão para Stable Diffusion que dá controle preciso sobre a composição da imagem. Você fornece uma imagem de referência — uma pose, um mapa de bordas ou um mapa de profundidade — e a IA segue essa estrutura.
Use ControlNet para manter a pose exata de uma pessoa, copiar um layout de cena ou traçar um esboço com precisão. Funciona junto ao seu prompt para controlar o conteúdo e a estrutura da imagem.
O que é um checkpoint?
Um checkpoint é um arquivo de modelo de IA salvo. Ele contém tudo que o modelo aprendeu durante o treinamento. Você carrega um checkpoint para definir o estilo e o tema das suas imagens.
Checkpoints diferentes dão resultados muito diferentes. Alguns são treinados para fotos realistas, outros para anime ou ilustração. Você pode baixar checkpoints gratuitos no Hugging Face ou Civitai.
O que é ComfyUI?
ComfyUI é uma interface gratuita baseada em nós para Stable Diffusion. Você cria fluxos de trabalho conectando blocos chamados nós. Cada nó faz um passo — carregar um modelo, adicionar um prompt ou salvar a imagem.
ComfyUI te dá controle total sobre cada passo. É mais rápido e leve que o Automatic1111. Usuários avançados o preferem para fluxos complexos. Você pode compartilhar fluxos como arquivos JSON.
O que é Flux?
Flux é uma família de modelos texto para imagem da Black Forest Labs, fundada por ex-pesquisadores da Stability AI. O lançamento de pesos abertos mais recente é o FLUX 3 Image Klein, publicado em 15 de outubro de 2026: 5,6 bilhões de parâmetros, geração 4K nativa, edição a partir de até dez imagens de referência e uma versão int8 que roda em uma placa de vídeo de 8 GB.
O FLUX 3 Image Klein é lançado sob a FLUX Kommunity License: uso comercial gratuito para pessoas físicas e empresas com menos de 5 milhões de dólares de receita anual; organizações maiores precisam de uma licença comercial da Black Forest Labs. O FLUX.2, lançado em novembro de 2025, continua atual em cinco variantes: três hospedadas, [max], [pro] e [flex], e duas de pesos abertos, [dev] e [klein]. A demo deste site roda o FLUX.2 [dev], e a página de estilos artísticos foi gerada com o FLUX.2 [klein].
O que é Qwen-Image 2.1?
Qwen-Image 2.1 é um modelo texto para imagem e de edição de imagens de pesos abertos da equipe Qwen da Alibaba, lançado em setembro de 2026. Ele segue frases inteiras em vez de listas de palavras-chave, escreve texto legível dentro da imagem e gera 2K nativo, 2048 × 2048 no quadrado, sem upscaler. Para editar, ele usa uma frase e até dez imagens de referência.
Você pode testá-lo de graça na demo do Qwen-Image 2.1 deste site, sem conta. Ele roda em casa no ComfyUI; os pesos int8 cabem em uma placa de vídeo de 16 GB. Os pesos estão sob a Qwen Research License: só pesquisa e avaliação, e qualquer uso comercial exige uma licença separada da Qwen. O primeiro Qwen-Image, lançado em agosto de 2025, era Apache 2.0.
Leia o guia completo: o que é o Qwen-Image, o que ele faz e como funciona →
Qual é a versão mais recente do Stable Diffusion?
A versão mais recente é Stable Diffusion 3.5 , lançado em outubro de 2024. Produz imagens mais nítidas com renderização de texto significativamente melhor, cores mais ricas e detalhes finos aprimorados. Vem em três tamanhos: Large (8B de parâmetros), Large Turbo para geração rápida e Medium — todos executáveis localmente com VRAM moderada.
Leia o guia completo: SDXL vs Stable Diffusion 3 vs SD 1.5: qual usar? →