Stable Diffusion онлайн ШІ
Штучний інтелект, доступний для всіх безкоштовно
Генеруйте AI-зображення безкоштовно, прямо у браузері.
Введіть prompt. Наші інструменти створюють унікальні зображення за секунди. Не потрібен акаунт, GPU чи встановлення.
Безкоштовні інструменти для генерації зображень онлайн
 Stable Diffusion 3
Текст у зображення зі Stable Diffusion 3, без облікового запису
 Inpainting Популярне
Перемалюйте будь-яку частину зображення за текстовим промптом
 Upscaling Популярне
Збільште зображення до 2x із чіткішими деталями
 Stable Diffusion XL demo
Безкоштовне онлайн-демо Stable Diffusion XL 1.0, без облікового запису
 FLUX.2 styles Нове
Порівняння художніх стилів у FLUX.2 на тих самих сценах
Qwen-Image 2.1 Нове
Відкрита модель зображень Alibaba: чіткий текст і редагування
MiniMax-H3 Нове
Відкрита відеомодель із синхронізованою звуковою доріжкою
Wan 2.2 I2V
Перетворіть фото на коротке відео з Wan 2.2
Безкоштовний набір інструментів для штучного інтелекту та LLM:
Твори від спільноти
 byzantine icon of squidward at blue hour storm light medium shot
 route 66 in the belle poque storybook illustration
 anime background a night market with lanterns
 felt craft illustration of a grey kitten in a knitted basket with yarn balls soft wool texture pastel
 anime style a torii in fog with children chalking the pavement
 a sunfish as a snow globe scene macro photograph
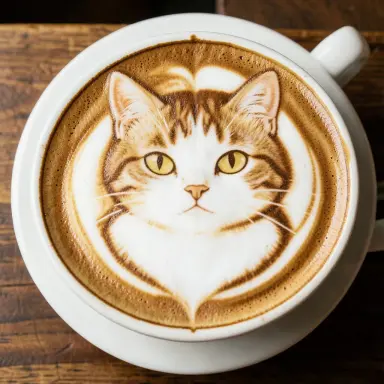 latte art of a cat
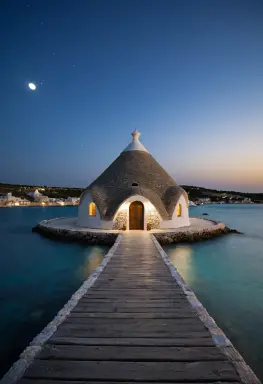 a trullo house from the pier long exposure photograph
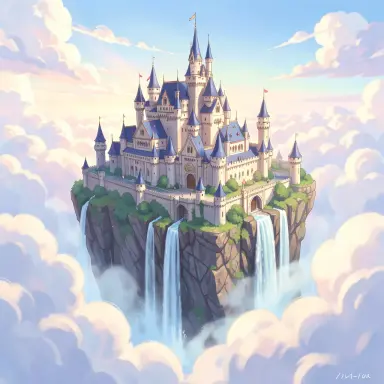 a floating castle above the clouds with waterfalls anime background painting style soft light
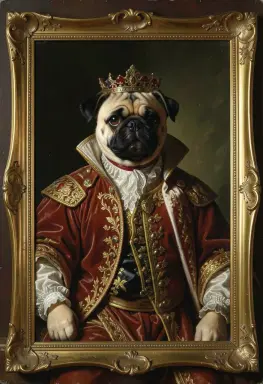 a pug dressed as a renaissance prince classical portrait oil painting style gold frame
 romantic painting of a bear who keeps a bee library on a giant leaf
 a magical greenhouse where plants glow and float children book illustration soft colours
 icon painting of an orc vegetable garden during a flood
 stained glass of a cherry tree
 naive painting of a round earthen tulou
 a passport full of stamps screen print close up
 a stone circle at high tide stained glass
 pencil drawing of a horse
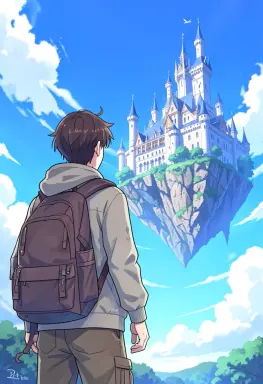 anime key visual of a traveller with a backpack looking at a floating castle in a blue sky hopeful
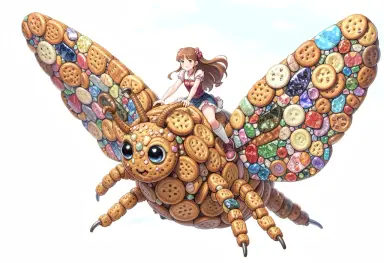 a girl riding a giant moth built from biscuits mosaic
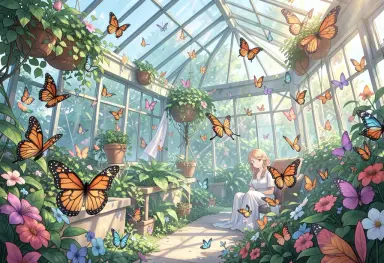 anime background a greenhouse full of butterflies
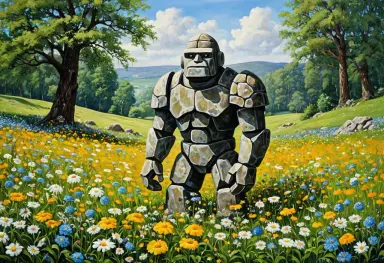 a stone golem in a flower meadow painting
 a pegasus in a meadow watercolor
 art nouveau illustration of a swan among lily pads flowing lines golden ornaments
Що таке Stable Diffusion?
Stable Diffusion — це ШІ, що створює зображення з тексту. Опишіть що хочете — вона згенерує зображення.
Розроблений StabilityAI , вона з відкритим кодом. Працює на звичайному GPU — без хмари. Спільнота дуже активна. Багато моделей і додатків — безкоштовні. Ви навіть можете навчити її на власних зображеннях!
Вона навчалась на мільйонах зображень. Використовуйте її для цифрового мистецтва, редагування фото, анімацій тощо.
Ви можете побачити приклади в нашій галереї підказок, Галерея мистецтва та браузері зображень..Часті запитання
Чи безкоштовний Stable Diffusion?
Так. Stable Diffusion — це модель з відкритим кодом, яку можна безкоштовно завантажити й запустити на власному комп’ютері. Усі інструменти цього сайту також безкоштовні: онлайн-демо, inpainting, збільшення зображень і генератор промптів працюють без облікового запису, а текст у зображення на нашому власному GPU потребує лише безкоштовного облікового запису. Без кредитів і без підписки.
Чи потрібен обліковий запис, щоб генерувати зображення?
Для онлайн-демо, inpainting, збільшення зображень і генератора промптів обліковий запис не потрібен: відкрийте сторінку й починайте. Безкоштовний обліковий запис, створений за адресою електронної пошти, відкриває текст у зображення на нашому власному GPU зі Stable Diffusion 1.5 та SDXL 1.0 з повним керуванням кроками, шкалою CFG, seed і розміром зображення.
Як користуватися Stable Diffusion онлайн?
Відкрийте безкоштовне демо, введіть опис потрібного зображення й натисніть Generate. Зображення з’явиться за кілька секунд, і його можна завантажити. Щоб покращити результат, додайте деталі про стиль і освітлення, напишіть негативний промпт або змініть seed, щоб переглянути варіанти. Нічого встановлювати не потрібно.
Чи це офіційний сайт Stable Diffusion?
Ні. Stable Diffusion розробляє компанія Stability AI, офіційний сайт якої — stability.ai. stablediffusion.fr — незалежний сайт, що працює з 2022 року й пропонує безкоштовні інструменти для використання Stable Diffusion та інших відкритих моделей у браузері, а також посібники, приклади промптів і добірки художників. Він не пов’язаний зі Stability AI.
Що таке підказка?
Prompt — це текстовий опис, який керує ШІ. Він може містити тему, художній стиль, освітлення, настрій і медіум — наприклад: 'середньовічний лицар у темному лісі, олійний живопис, драматичне освітлення, кінематографічний'. Чим точніший prompt, тим ближчий результат до вашого бачення. Тримайте його до 350 символів для найкращих результатів.
Негативний промпт каже ШІ, що не включати до зображення.
Що таке негативний промпт?
Негативний промпт каже ШІ, що НЕ показувати. Типові приклади: 'blurry, low quality, watermark, text, deformed hands'. Використовуйте їх для усунення типових помилок ШІ.
Негативні промпти швидко покращують якість зображення. Додайте ваги — наприклад '(blurry:1.4)' — щоб зробити їх сильнішими.
Що означає seed?
Seed — це число, яке ініціалізує випадковий процес генерації зображень. Кожне зображення починається з шуму, і seed визначає, як виглядає цей початковий шум. Залиште його на -1, щоб щоразу отримувати випадковий seed — і інше зображення.
Зафіксуйте seed, щоб відтворити точно те саме зображення. Це корисно для експериментів: тримайте seed постійним, змінюючи лише prompt або налаштування, щоб точно порівнювати варіації. Це також спосіб відтворити улюблений результат пізніше.
Що таке LoRA?
LoRA означає Low-Rank Adaptation. Це невеликий файл розширення (зазвичай 50–150 МБ), який налаштовує базову модель для конкретного стилю, персонажа або теми — без повторного навчання всієї моделі.
Завантажте LoRA для генерації зображень у певному художньому стилі, відтворення конкретного персонажа або відповідності референсній концепції. Ви можете поєднувати кілька LoRА в одному prompt, використовуючи ваги: <lora:my-style:0.8>. Тисячі безкоштовних LoRА доступні на Civitai та Hugging Face.
Як встановити Stable Diffusion локально?
Локальний запуск Stable Diffusion потребує сучасного GPU NVIDIA з мінімум 6 ГБ VRAM. GPU AMD працюють з драйверами ROCm на Linux. Apple Silicon (M1/M2/M3) також підтримується через бекенд MPS. Якщо у вас немає сумісного GPU, наш безкоштовний онлайн-інструмент працює прямо у браузері — без встановлення.
Спочатку завантажте base model та refiner від Stability AI.Потім встановіть Python 3.10 та Git.
Завантажте webUI з Automatic1111.
Покладіть обидві моделі в папку models/Stable-diffusion .
Знайдітьwebui.bat та двічі клацніть для встановлення.
Відкрийте браузер на localhost:7860.
Скільки VRAM потрібно для Stable Diffusion?
Для запуску Stable Diffusion потрібно щонайменше 4 ГБ VRAM. 6 ГБ — рекомендований мінімум для моделей SDXL. З 8 ГБ і більше можна генерувати більші зображення та використовувати більше функцій.
Без GPU можна запустити на CPU, але це значно повільніше. Ви також можете скористатися нашим безкоштовним онлайн-демо без GPU.
Що таке img2img?
Img2img дозволяє використовувати наявне зображення як відправну точку. Ви надаєте вихідне зображення та промпт. Stable Diffusion трансформує зображення відповідно до ваших інструкцій.
Використовуйте для зміни стилю фото, виправлення згенерованого зображення або доопрацювання ескізу. Сила denoising контролює, наскільки AI змінює оригінал.
Чи можу я використовувати зображення Stable Diffusion комерційно?
Це залежить від моделі. Базові моделі Stable Diffusion використовують ліцензію CreativeML Open RAIL-M. Вона дозволяє комерційне використання, але з обмеженнями — не можна використовувати зображення для заподіяння шкоди або введення людей в оману.
Завжди перевіряйте ліцензію checkpoint, який використовуєте. Деякі моделі спільноти обмежують комерційне використання. Якщо ви продаєте або публікуєте AI-зображення, зберігайте запис про модель та її ліцензію.
Що таке ControlNet?
ControlNet — це розширення для Stable Diffusion, яке дає точний контроль над композицією зображення. Ви надаєте референсне зображення — позу, карту країв або карту глибини — і AI дотримується цієї структури.
Використовуйте ControlNet для збереження точної пози людини, копіювання макету сцени або точного відтворення ескізу. Він працює разом із промптом, контролюючи вміст і структуру зображення.
Що таке checkpoint?
Checkpoint — це збережений файл моделі AI. Він містить усе, що модель вивчила під час навчання. Ви завантажуєте checkpoint, щоб задати стиль і тему своїх зображень.
Різні checkpoints дають дуже різні результати. Одні навчені для реалістичних фото, інші — для аніме або ілюстрацій. Безкоштовні checkpoints можна завантажити з Hugging Face або Civitai.
Що таке ComfyUI?
ComfyUI — безкоштовний інтерфейс на основі вузлів для Stable Diffusion. Ви будуєте робочі процеси зображень, з'єднуючи блоки — вузли. Кожен вузол виконує один крок — завантаження моделі, додавання промпту або збереження зображення.
ComfyUI дає повний контроль над кожним кроком. Він швидший і легший за Automatic1111. Досвідчені користувачі обирають його для складних процесів. Процесами можна ділитися як JSON-файлами.
Що таке Flux?
Flux — це AI модель перетворення тексту на зображення від Black Forest Labs, заснованої колишніми дослідниками Stability AI. Остання версія — FLUX.2, випущена у листопаді 2025 року. Вона генерує зображення до 4МП із фотореалістичною якістю та мультиреференсним контролем.
FLUX.2 має чотири варіанти: Max (найвища якість), Pro (якість на повній швидкості), Flex (точність і чіткий текст) і Dev (відкриті ваги, вільне розгортання). FLUX.2 Dev запускається локально в ComfyUI або Automatic1111 — тих самих інструментах, що й Stable Diffusion.
Яка найновіша версія Stable Diffusion?
Остання версія — це Stable Diffusion 3.5 , випущений у жовтні 2024 року. Він виробляє чіткіші зображення зі значно кращим рендерингом тексту, багатшими кольорами та покращеними дрібними деталями. Доступний у трьох розмірах: Large (8 млрд параметрів), Large Turbo для швидкої генерації та Medium — всі запускаються локально з помірною VRAM.