Stable Diffusion коротко
Stable Diffusion — це латентна дифузійна модель (LDM) із відкритим кодом: нейромережа, навчена перетворювати випадковий шум на картинку, потроху, під керуванням тексту. Її створила група CompVis з Мюнхенського університету Людвіга-Максиміліана разом із Runway, а навчили на обчислювальних потужностях Stability AI, на зображеннях, зібраних некомерційною організацією LAION. Метод походить зі статті High-Resolution Image Synthesis with Latent Diffusion Models (Rombach зі співавторами, CVPR 2022).
Ваги опублікували 22 серпня 2022 року. Саме це й змінило все. DALL-E 2 і Midjourney вже існували, але за списками очікування й кредитами, на чужих серверах. Stable Diffusion був файлом на 4 ГБ, який працював на відеокарті з 8 ГБ пам’яті, без облікового запису й із фільтром безпеки, який можна було вимкнути.
За кілька тижнів з’явилися вебінтерфейси та inpainting, потім донавчені версії, LoRA й ControlNet. Через чотири роки назва означає дві речі. У вузькому сенсі — родину моделей від 1.4 до 3.5. У широкому — всю практику запуску моделей зображень на власному комп’ютері.
Далі пояснено саму машину, з лексикою, яка трапиться вам у кожному інтерфейсі: латентний простір, VAE, U-Net, CLIP, семплер, шкала CFG, seed. Формули не знадобляться, але кілька чисел допоможуть.
Як працює Stable Diffusion? Три мережі й один цикл
Stable Diffusion — це не одна мережа, а три, які запускаються одна за одною.
- Текстовий енкодер читає промпт і перетворює його на список чисел. У Stable Diffusion 1.5 це 77 токенів, кожен описаний 768 числами; 2 048 у SDXL, який використовує два енкодери.
- Знешумлювач, U-Net у версіях від 1 до XL і трансформер (MMDiT) починаючи з версії 3, стартує з блоку випадкового шуму й очищає його за 20–30 кроків, на кожному кроці звіряючись із числами з тексту. Він працює не з пікселями, а з компактною версією зображення, латентом, що живе в так званому латентному просторі: 4 × 64 × 64 числа для зображення на 512 пікселів, 4 × 128 × 128 для 1024 пікселів у SDXL.
- Декодер перетворює цей латент на кінцеві значення пікселів, червоного, зеленого й синього: 3 × 512 × 512 або 3 × 1024 × 1024 для SDXL.
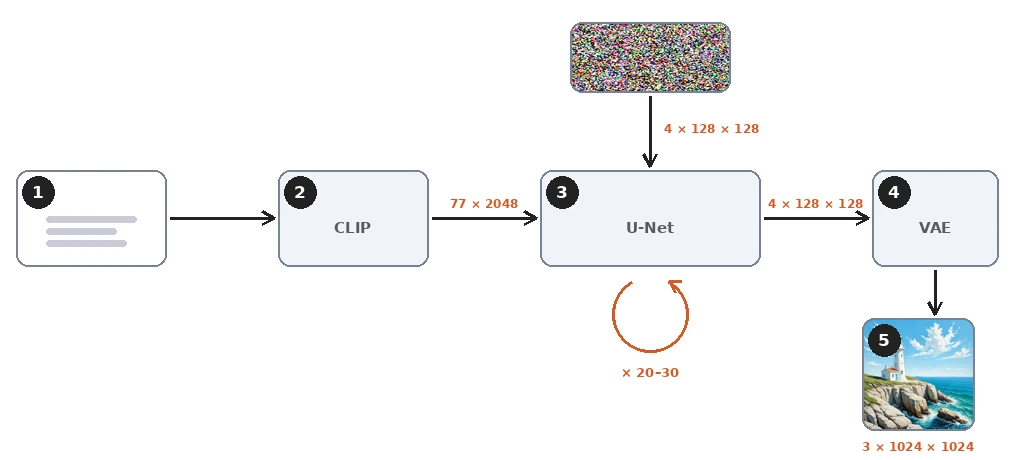
Дорогою нічого не шукається й не копіюється. Усередині файлу немає жодної бази зображень. Від 2 до 16 ГБ ваг зберігають те, чого мережа навчилася про відповідність підписів і зображень, і кожен результат обчислюється з шуму. Мережа все ж може запам’ятати зображення, які багато разів траплялися під час навчання, і дослідники витягли кілька сотень таких, але це виняток.
Що таке дифузійна модель? Навчання прибирати шум
Прямий процес: додавання шуму
Ідею дифузії легко сформулювати. Візьміть фото з підписом. Додайте до нього відміряну порцію випадкового шуму. Попросіть мережу вгадати, який шум було додано, знаючи підпис. Порівняйте її здогад із правдою і трохи підправте мережу.
Додавання шуму — це прямий процес (forward process). Він іде за фіксованим розкладом із тисячі рівнів, від ледь помітного зерна на рівні 50 до суцільного «снігу» на рівні 999. Мережа ніколи не бачить, як розклад розгортається; вона бачить лише одне зашумлене зображення на одному рівні за раз.
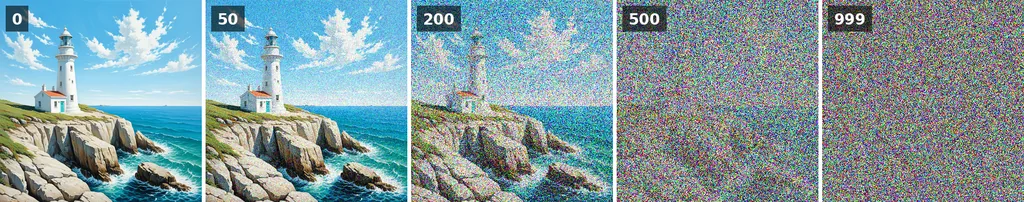
Зробіть це на мільярдах прикладів — і отримаєте передбачувач шуму: маючи зашумлену картинку, її рівень шуму й текст, він каже, яким, імовірно, є шум. Цільова функція навчання — це просто різниця між передбаченим шумом і справжнім. Навчання Stable Diffusion 1 зайняло близько 150 000 годин на серверних GPU A100, згідно з картою моделі.
Зворотний процес: передбачувач шуму за роботою
Генерація прокручує цей урок у зворотному порядку. Це зворотний процес (reverse process). Почніть із чистого шуму, який задає seed. Запитайте передбачувач, який саме шум додано, приберіть його частину, запитайте знову. DDPM, стаття 2020 року, яка зробила дифузію практичною, робила це за тисячу маленьких кроків.
Семплер, у деяких інтерфейсах він зветься scheduler, — це правило, яке вирішує, наскільки великим буде кожен крок і чи додавати назад трохи свіжого шуму. Кращі семплери, DDIM, Euler і родина DPM++, роблять більші кроки тим самим шляхом, і саме тому сьогодні достатньо 20–30 кроків.
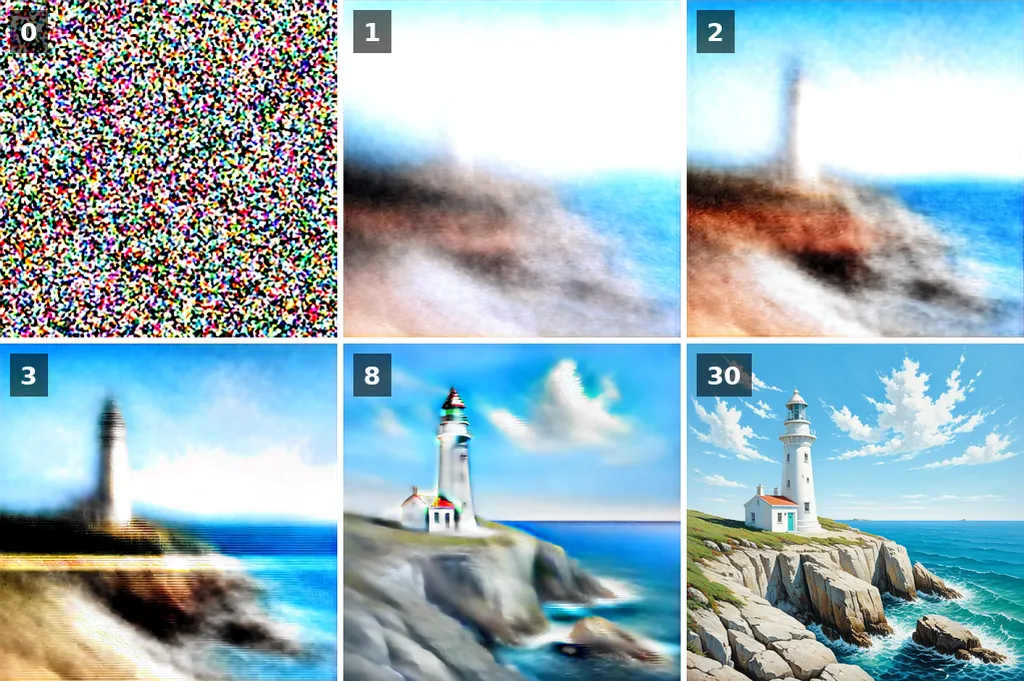
Рисунок показує те, що варто запам’ятати. На кожному кроці модель має здогад про готову картинку, і цей здогад усталюється рано. Перші два-три кроки, поки шум іще щільний, фіксують композицію: де горизонт, де стоїть маяк, скільки неба. Пізніші кроки шліфують фактуру й дрібні деталі.
Повзунок нижче проходить усі тридцять здогадів того самого рендеру.
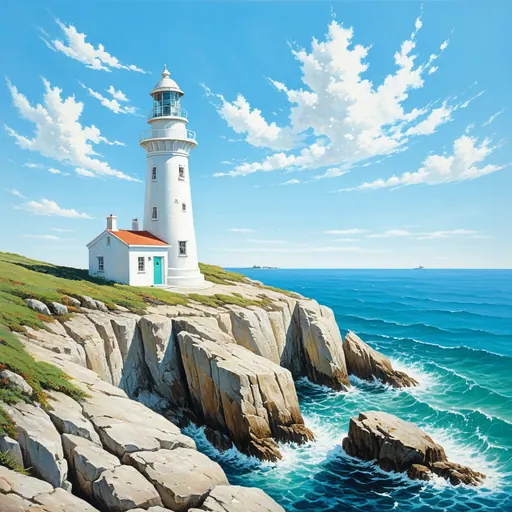
Звідси два практичні наслідки. Зміна кількості кроків змінює деталі, а іноді й композицію, бо ранні кроки потрапляють на інші значення; вона не просто робить ту саму картинку чіткішою. А той самий seed за іншого розміру зображення починає з іншого блоку шуму, тож теж дає іншу картинку. Спершу виберіть розмір, а вже потім шукайте seed.
Латентна дифузія: трюк із VAE, завдяки якому все вміщується на ігровій відеокарті
Ранні дифузійні моделі працювали з пікселями. Зображення 512 × 512 — це 786 432 числа, і передбачувач мусив читати й записувати їх усі на кожному зі своїх кроків. Піксельні моделі на кшталт DALL-E 2 та Imagen обходили це, виконуючи дифузію на 64 пікселях і додаючи мережі для збільшення, та й опубліковані вони так і не були.
Stable Diffusion додає варіаційний автоенкодер, VAE. Його енкодер стискає зображення у вісім разів по кожній стороні в чотири канали: 4 × 64 × 64, тобто 16 384 числа, у 48 разів менше. Дифузія повністю відбувається в цьому стисненому просторі, латентному просторі. Лише наприкінці декодер VAE розгортає результат у пікселі.

Латент — це не маленька картинка. Його чотири канали — це код, який декодер уміє читати, і жоден окремий канал не схожий на зображення повністю. Але компонування переживає стискання, і саме це дозволяє знешумлювачу вирішувати композицію в такому малому просторі.
Саме тому вибір VAE впливає на колір і дрібні деталі: кожне число латенту відповідає ділянці 8 × 8 пікселів, а декодер вигадує, що всередині цієї ділянки. Stable Diffusion 3 перейшов на латент із 16 каналами саме з цієї причини, і дрібні деталі та малий текст від цього покращилися.
CLIP і cross-attention: як текст керує зображенням
Три складники перетворюють слова на напрямок для знешумлювача.
Токенізатор і текстовий енкодер: як CLIP читає промпт
Токенізатор ріже промпт на токени, цілі поширені слова або фрагменти рідкісніших. Stable Diffusion 1.5 і SDXL читають щонайбільше 77 токенів, два з яких — маркери початку й кінця, приблизно 50–60 англійських слів. Далі текст обрізається, якщо інтерфейс не розбиває його на кілька проходів. Ставте найважливіше на початок.
Текстовий енкодер у 1.5 — це CLIP, мережа, яку OpenAI навчила на 400 мільйонах пар зображення–підпис з одним завданням: наблизити числа, що описують підпис, до чисел, що описують його зображення. Після такого навчання числа для «lighthouse» вже несуть у собі те, як виглядають маяки. SDXL запускає два такі енкодери поруч, другий — відкрите перенавчання від LAION на двох мільярдах пар. Stable Diffusion 3 додає третій, T5, який читає цілі речення.
Перехресна увага всередині U-Net
Перехресна увага (cross-attention) — це місце, де текст зустрічається з картинкою. U-Net — це стос згорткових блоків, які зменшують латент, а потім знову його збільшують, зі skip-з’єднаннями між однаковими розмірами. Між цими блоками розташовані шари уваги. На кожному кроці кожна ділянка латенту дивиться на 77 векторів токенів і зважує, які з них її стосуються. Ділянка неба звертає увагу на «sunset» і «clouds», скеля — на «cliff». Ось чому порядок слів, повтори й синтаксис ваг в інтерфейсах мають значення і чому слово про стиль на початку забарвлює все зображення.
У цьому ж і обмеження перших версій. CLIP навчався на коротких alt-текстах, тому добре розуміє переліки об’єктів і стилів і погано — зв’язки між ними. «A red cube on a blue sphere» у 1.5 часто виходить навпаки. Посібник із промптів показує, що працює надійно.
Шкала CFG, негативний промпт і seed: три налаштування
Три налаштування є в кожному інтерфейсі Stable Diffusion. Вони прямо відповідають механізмам, описаним вище.
Шкала CFG, або guidance scale, скорочено від classifier-free guidance, вирішує, наскільки сильно текст тисне на результат. На кожному кроці знешумлювач насправді робить два передбачення: одне з промптом і одне з порожнім промптом. Різниця між ними — це напрямок, який задає промпт. Остаточне передбачення — це порожнє плюс ця різниця, помножена на шкалу CFG. При значенні 1 передбачення з промптом береться як є, без тиску: зображення слідує тексту лише приблизно, з приглушеними кольорами й сірим небом там, де промпт просив блакитне. При 5–8 воно точно слідує промпту з природними кольорами. Понад 12 контраст стає жорсткішим, кольори перенасичуються, а мазки стають різкими.
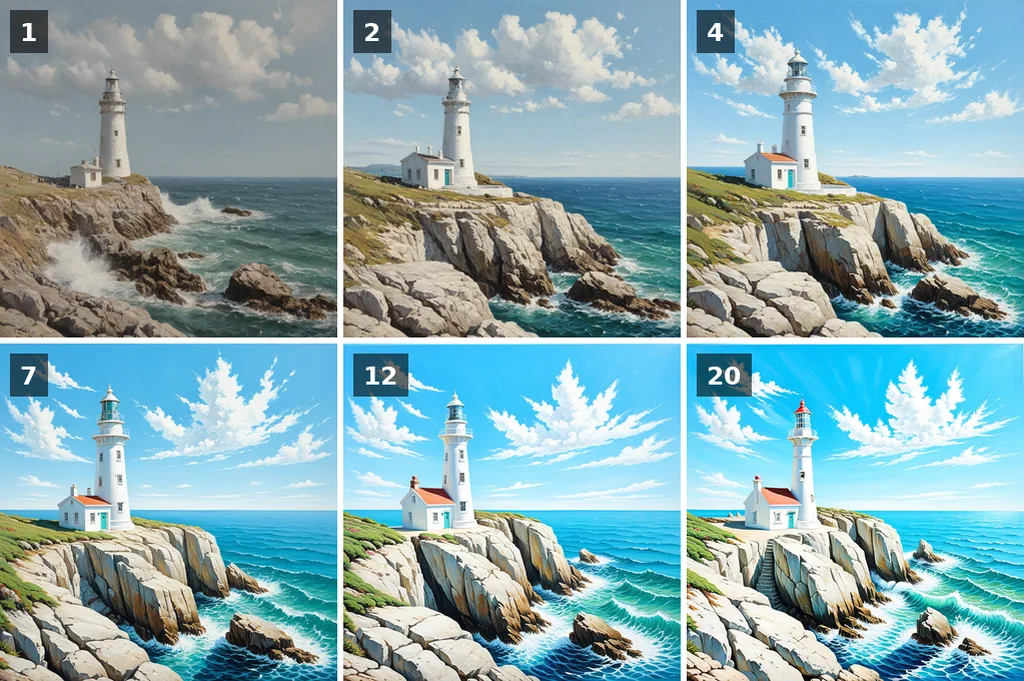
Негативний промпт замінює порожній промпт у тому другому передбаченні. Замість порожнього промпту другий прохід читає «blurry, text, watermark», і guidance відштовхує від цього. Це нічого додатково не коштує, бо другий прохід і так виконується, і працює лише тоді, коли guidance вищий за 1. Посібник із негативного промпту дає робочі списки.
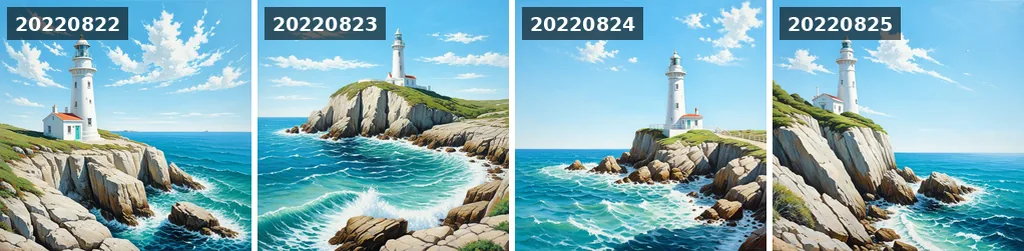
Seed — це число, яке породжує початковий шум. Той самий seed, той самий промпт, ті самі налаштування й та сама модель дають те саме зображення, до пікселя, на тому самому програмному забезпеченні й обладнанні; інший інтерфейс або інша відеокарта генерує шум інакше. Змініть seed — зміниться композиція, бо перші кроки читають інший блок шуму. Змініть одне слово промпту й залиште seed — більша частина картинки зазвичай збережеться. Саме так промпт і доводять до ладу.
Від U-Net до трансформера: версії від 1.5 до 3.5
За два роки з’явилося шість головних поколінь, перші два від CompVis і Runway, решта від Stability AI. Кожне змінювало щонайменше одну з трьох мереж.
| Версія | Дата | Знешумлювач | Текстові енкодери | Нативний розмір |
|---|---|---|---|---|
| 1.4 і 1.5 | серпень і жовтень 2022 | U-Net, 860 мільйонів параметрів | CLIP ViT-L | 512 px |
| 2.0 і 2.1 | листопад і грудень 2022 | U-Net тієї самої конструкції, перенавчений з нуля | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | липень 2023 | U-Net, 2,6 мільярда, плюс refiner | CLIP ViT-L і OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | листопад 2023 | SDXL, дистильований до 1–4 кроків | Як у SDXL | 512 px |
| 3 Medium | червень 2024 | Дифузійний трансформер (MMDiT), 2 мільярди | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | жовтень 2024 | MMDiT, 8 мільярдів; Medium 2,5 мільярда | Ті самі три | 1024 px |
1.5 лишається однією з найбільш донавчуваних моделей в історії, з десятками тисяч спільнотних чекпойнтів і LoRA, і досі працює на 4 ГБ відеопам’яті. SDXL — робоча конячка: кращі руки, обличчя й композиція, нативний вивід на 1024 пікселі. 3 і 3.5 замінили U-Net трансформером, який обробляє текстові й графічні токени разом, і саме це нарешті зробило можливим розбірливий текст на зображеннях: беріть слова в лапки в промпті. Порівняння SDXL і Stable Diffusion 3 показує ті самі промпти на обох.
Ліцензії теж змінилися. 1.5 поширюється за ліцензією CreativeML OpenRAIL-M, SDXL — за OpenRAIL++-M, обидві безкоштовні для комерційного використання з переліком заборонених застосувань. Моделі 3.x — за Stability AI Community License, безкоштовною до мільйона доларів річного доходу.
Що з ним можна робити: image-to-image, inpainting, ControlNet, LoRA
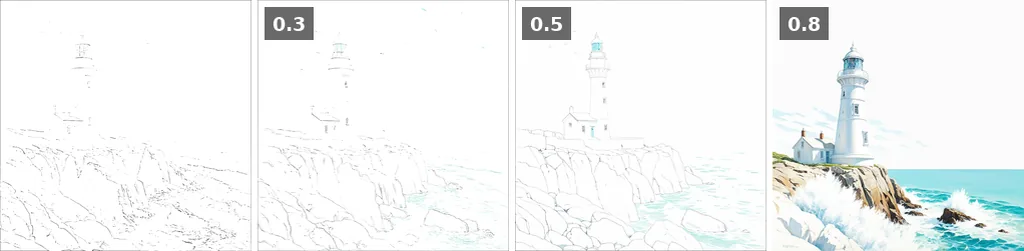
Генерація з тексту — лише початок, бо кожну частину конвеєра можна використати повторно. Закодуйте ескіз у латент, додайте лише частину шуму й знешумлюйте звідти — і це image-to-image, img2img в інтерфейсах: налаштування strength, або denoise, — це те, скільки шуму ви додаєте. Ідея походить із SDEdit. Замаскуйте одну ділянку латенту — і це inpainting, або outpainting, коли маска поза кадром. Додайте невелику бічну мережу, яка читає позу, карту глибини чи контури, — і це ControlNet. Навчіть кілька мільйонів додаткових ваг на двадцяти фото — і це LoRA, яка вчить модель обличчя чи стилю. Окремі моделі підвищення роздільної здатності займаються збільшенням зображень.
Щоб запустити його самостійно, вистачить сучасної відеокарти NVIDIA з 6 ГБ відеопам’яті (VRAM) для 1.5 і 8 ГБ для SDXL. Карти AMD працюють через ROCm, Apple Silicon — через бекенд MPS. Посібник зі встановлення охоплює три головні інтерфейси. Без відеокарти інструменти цього сайту не потребують обладнання: Stable Diffusion XL і Stable Diffusion 1.5 працюють на GPU самого сайту, з чергою, яку видно наживо, задокументовані промпти показують, що робить кожне налаштування, а 1 731 стиль художників показує, чого модель навчилася про живописців.
Stable Diffusion vs Midjourney vs DALL-E
Порівняно з Midjourney і моделями зображень OpenAI різниця не в якості, а в контролі. Ваги відкриті, модель працює локально: ваші зображення лишаються на вашому диску, ви обираєте модель, ви задаєте seed і можете замінити будь-який компонент. Натомість вона вимагає від вас більше. Midjourney просить одне речення й видає відшліфовану картинку; Stable Diffusion просить модель, промпт, негативний промпт і шкалу CFG — і дає саме те, що ви задали.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Ваги | Відкриті, можна завантажити | Закриті | Закриті |
| Працює на вашому комп’ютері | Так, 6–8 ГБ VRAM | Ні | Ні |
| Ціна | Безкоштовно локально; безкоштовні інструменти онлайн | Підписка | Підписка або оплата за зображення |
| Контроль | Seed, модель, LoRA, ControlNet, inpainting, кожне налаштування | Параметри та референси стилю | Розмова |
| Донавчання | Так, будь-ким | Ні | Ні |
| Текст на зображеннях | Слабкий до 3, добрий від 3.5 | Добрий з v6 | Дуже добрий |
Той самий принцип дифузії тепер лежить в основі моделей інших лабораторій, з іншими енкодерами й іншими ліцензіями: FLUX від Black Forest Labs, заснованої авторами оригінального Stable Diffusion, і Qwen-Image від Alibaba. Вони працюють у тих самих інтерфейсах, з тими самими seed, кроками й семплерами, тож більша частина цієї сторінки стосується і їх. Їхній guidance працює інакше, FLUX dev не має негативного промпту, і вони віддають перевагу повним реченням, а не спискам ключових слів.
Джерела і як використати ілюстрації
Першоджерела, у порядку, в якому вони трапляються на сторінці:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: стаття про Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: прямий і зворотний процеси та розклад на тисячу кроків.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho і Salimans, 2022: шкала CFG.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, і Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL і Stable Diffusion 3.
Використання ілюстрацій. Рендери й схеми на цій сторінці опубліковано за ліцензією CC BY 4.0: використовуйте їх у курсі, доповіді чи статті з посиланням на цю сторінку. Кожен рендер використовує Stable Diffusion XL, euler, 30 кроків, CFG 6, seed 20220822, промпт нижче й негативний промпт «text, watermark, signature, blurry, low quality, storm, dark clouds, sunset».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesЯк цитувати цю сторінку.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion