Stable Diffusion 简介
Stable Diffusion 是一个开源的潜在扩散模型(LDM):一个经过训练的神经网络,在文字的引导下,把随机噪声一点一点变成一幅图像。它由慕尼黑大学(LMU)的 CompVis 小组与 Runway 共同开发,使用 Stability AI 提供的算力,在非营利组织 LAION 收集的图片上训练而成。方法来自论文 High-Resolution Image Synthesis with Latent Diffusion Models(Rombach 等,CVPR 2022)。
权重于 2022 年 8 月 22 日公开。正是这一点改变了一切。DALL-E 2 和 Midjourney 当时已经存在,但都藏在等候名单和积分制之后,跑在别人的服务器上。Stable Diffusion 则是一个 4 GB 的文件,能在 8 GB 显存的显卡上运行,不需要账号,安全过滤器也可以自行关闭。
几周之内,网页界面和局部重绘出现了,随后是微调模型、LoRA 和 ControlNet。四年后的今天,这个名字有两层含义。狭义上,指从 1.4 到 3.5 的模型家族。广义上,指在自己的机器上运行图像模型的整套做法。
下面解释这台机器本身,用的是你在每个界面里都会遇到的词汇:潜在空间、VAE、U-Net、CLIP、采样器、引导系数、种子。不需要公式,但有几个数字会有帮助。
Stable Diffusion 如何工作?三个网络和一个循环
Stable Diffusion 不是一个网络,而是三个,依次运行。
- 文本编码器读取提示词,把它变成一串数字。在 Stable Diffusion 1.5 中是 77 个 token,每个由 768 个数字描述;SDXL 运行两个编码器,是 2,048 个。
- 去噪器,在 1 到 XL 各版本中是 U-Net,从第 3 版起是 Transformer(MMDiT),从一块随机噪声出发,用 20 到 30 步把它逐渐清理干净,每一步都参考文本的数字。它处理的不是像素,而是图像的紧凑版本,即潜在表示(latent),存在于所谓的潜在空间中:512 像素的图像对应 4 × 64 × 64 个数字,SDXL 的 1024 像素对应 4 × 128 × 128 个。
- 解码器把这个潜在表示变成最终的像素值,即红、绿、蓝:3 × 512 × 512,SDXL 则是 3 × 1024 × 1024。
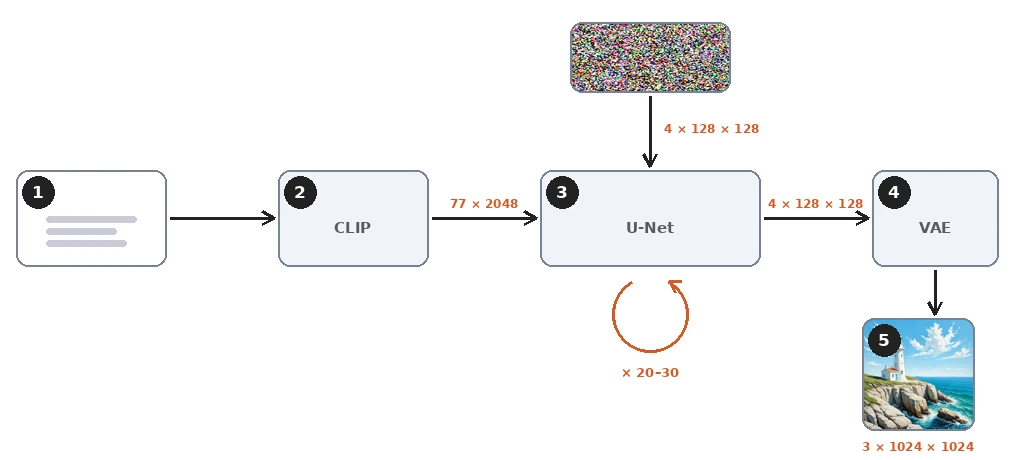
整个过程中没有任何搜索或复制。文件里没有图片数据库。2 到 16 GB 的权重保存的是网络学到的关于文字说明和图像如何对应的知识,每一张输出都是从噪声计算出来的。网络仍然可能记住训练中多次出现的图像,研究人员已经提取出了几百张,但那是例外。
什么是扩散模型?学会去除噪声
前向过程:加入噪声
扩散的思路说起来很简单。取一张带文字说明的照片。往里加入一定量的随机噪声。让一个网络在知道文字说明的前提下,猜测加入的是什么噪声。把它的猜测与真实噪声比较,然后稍微修正网络。
加入噪声这一步就是前向过程(forward process)。它遵循一个固定的一千级噪声调度,从第 50 级的轻微颗粒到第 999 级的纯粹雪花噪点。网络从来不会看到整个调度完整运行;它每次只看到某一级的一张带噪图像。
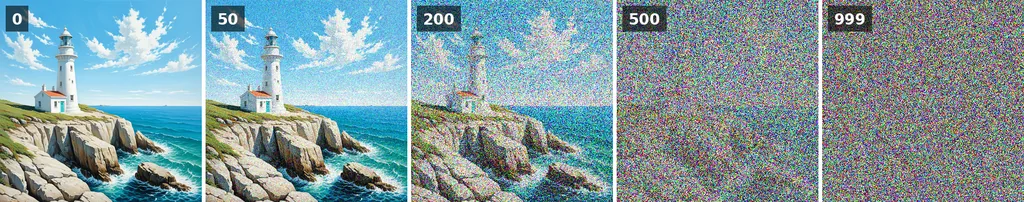
在数十亿个样本上重复这一过程,得到的就是一个噪声预测器:给它一张带噪图像、它的噪声等级和一段文字,它就能说出噪声大概是什么。训练目标只是预测噪声与真实噪声之间的差距。根据模型卡,训练 Stable Diffusion 1 在数据中心的 A100 GPU 上花了大约 150,000 小时。
反向过程:噪声预测器开始工作
生成就是把这个学习过程反过来运行。这就是反向过程(reverse process)。从种子选出的纯噪声出发。问预测器噪声是什么,去掉其中一部分,再问一次。DDPM,这篇 2020 年让扩散变得实用的论文,用一千个小步完成这件事。
采样器,在某些界面里也叫调度器,是决定每一步走多大、以及是否加回一点新噪声的规则。更好的采样器,如 DDIM、Euler 和 DPM++ 家族,沿着同一条路径迈更大的步子,这就是今天 20 到 30 步就够用的原因。
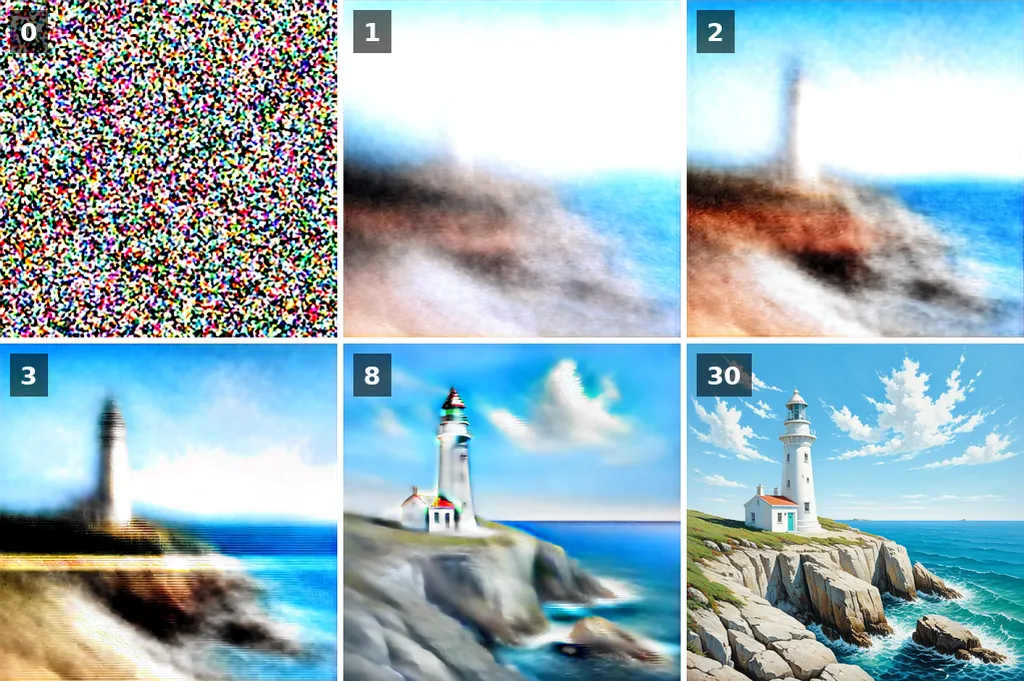
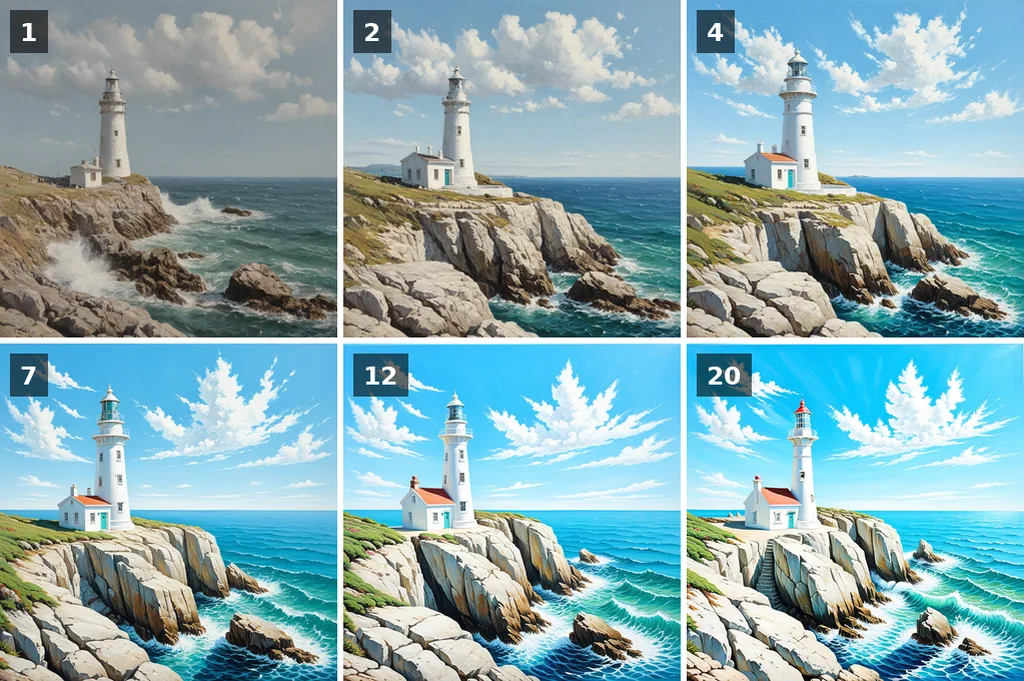
这张图展示的正是值得记住的要点。模型在每一步都保有一个对完成图的猜测,而这个猜测很早就稳定下来。最初两三步,噪声还很重的时候,就定下了构图:地平线在哪里,灯塔立在哪里,天空占多少。后面的步骤细化质感和小细节。
下面的滑块可以依次查看同一次生成的全部三十个猜测。
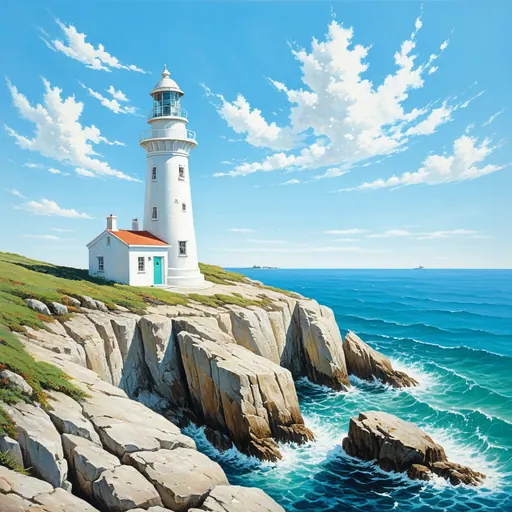
由此得出两个实际结论。改变步数会改变细节,有时也会改变构图,因为前几步会落在不同的值上;它并不是单纯让同一幅画更清晰。另外,同一个种子在另一种图像尺寸下会从另一块噪声出发,所以也会给出不同的画。先选定尺寸,再去找种子。
潜在扩散:让它装进游戏显卡的 VAE 技巧
早期的扩散模型直接在像素上工作。一张 512 × 512 的图像是 786,432 个数字,预测器在每一步都必须读写所有这些数字。DALL-E 2 和 Imagen 这类像素模型的办法是在 64 像素上做扩散再加上放大网络,而且它们从未公开发布。
Stable Diffusion 加入了一个变分自编码器,即 VAE。它的编码器把图像在每一边压缩八倍,变成四个通道:4 × 64 × 64,即 16,384 个数字,只有原来的 1/48。扩散完全在这个压缩后的空间,也就是潜在空间中进行。直到最后一步,VAE 的解码器才把结果展开成像素。

潜在表示不是一张小图。它的四个通道是解码器懂得如何读取的编码,没有哪个通道单独看起来很像那张图像。但布局在压缩中保留了下来,这正是去噪器能在这么小的空间里决定构图的原因。
这也是 VAE 的选择会影响色彩和细节的原因:潜在表示中的每个数字代表一块 8 × 8 像素的区域,区域内部是什么由解码器凭空生成。Stable Diffusion 3 正是出于这个原因改用了 16 通道的潜在表示,细节和小字也随之改善。
CLIP 与交叉注意力:文字如何引导图像
三个部件把文字变成去噪器的方向。
分词器和文本编码器:CLIP 如何读取提示词
分词器把提示词切成 token,常见词是整词,罕见词则拆成片段。Stable Diffusion 1.5 和 SDXL 最多读取 77 个 token,其中两个是起始和结束标记,大约相当于 50 到 60 个英文单词。超出的部分会被截断,除非界面把它拆成多段处理。把最重要的内容放在开头。
1.5 的文本编码器是 CLIP,OpenAI 在 4 亿(400M)对图像和文字说明上训练的网络,任务只有一个:让描述一段文字的数字靠近描述对应图像的数字。经过这样的训练,「lighthouse」的数字已经带有灯塔的样子。SDXL 并排运行两个这样的编码器,第二个是 LAION 在 20 亿对数据上开放重训的版本。Stable Diffusion 3 又加了第三个,T5,它能读完整的句子。
U-Net 内部的交叉注意力
交叉注意力是文字与图像相遇的地方。U-Net 是一叠卷积块,先把潜在表示缩小再放大回来,相同尺寸之间有跳跃连接。在这些块之间放着注意力层。每一步,潜在表示的每个区域都会查看那 77 个 token 向量,权衡其中哪些与自己有关。天空区域关注「sunset」和「clouds」,岩石关注「cliff」。这就是为什么词序、重复和各界面的权重语法会起作用,也是为什么放在开头的风格词会影响整幅图。
这也是早期版本的局限所在。CLIP 是从简短的 alt 文本中学来的,所以它很擅长理解主体和风格的罗列,却不擅长它们之间的关系。「A red cube on a blue sphere」(蓝球上的红方块)在 1.5 里经常被调换。提示词指南展示了哪些写法可靠。
引导系数、负面提示词和种子:三个设置
每个 Stable Diffusion 界面都有三个设置。它们直接对应上面的机制。
引导系数,即无分类器引导(classifier-free guidance,CFG)的简称,决定提示词被强调到什么程度。每一步,去噪器实际上做两次预测:一次带提示词,一次用空提示词。两者之差就是提示词给出的方向。最终预测是空提示词的预测加上这个差乘以引导系数。取 1 时直接使用带提示词的预测,没有任何推力:图像只是松散地跟随文字,色彩暗淡,提示词要蓝天而天空是灰的。在 5 到 8 左右它紧跟提示词,色彩自然。超过 12 以后对比变硬,色彩过饱和,笔触变得生硬。
负面提示词取代了第二次预测中的空提示词。第二遍不再读空白,而是读「blurry, text, watermark」,引导则把结果推离它。这不需要额外的代价,因为第二遍本来就要运行;它只在引导系数高于 1 时起作用。负面提示词指南给出了可用的列表。
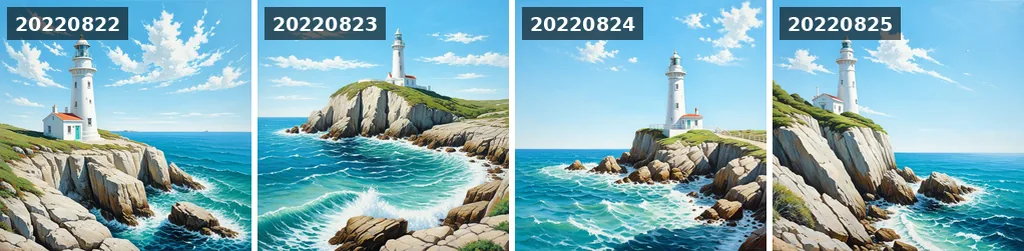
种子是生成起始噪声的数字。相同的种子、提示词、设置和模型,在相同的软件和硬件上会给出逐像素相同的图像;换一个界面或换一张显卡,噪声的抽取方式就不同了。改变种子,构图就会改变,因为前几步读到的是另一块噪声。改动提示词中的一个词而保持种子不变,画面的大部分通常会保留。提示词就是这样打磨出来的。
从 U-Net 到 Transformer:1.5 到 3.5 各个版本
两年内出现了六代主要版本,前两代来自 CompVis 和 Runway,其余来自 Stability AI。每一代都至少更换了三个网络中的一个。
| 版本 | 日期 | 去噪器 | 文本编码器 | 原生尺寸 |
|---|---|---|---|---|
| 1.4 和 1.5 | 2022 年 8 月和 10 月 | U-Net,860M 参数 | CLIP ViT-L | 512 px |
| 2.0 和 2.1 | 2022 年 11 月和 12 月 | 同样设计的 U-Net,从零重新训练 | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | 2023 年 7 月 | U-Net,2.6B,外加一个 refiner | CLIP ViT-L 和 OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | 2023 年 11 月 | 蒸馏到 1 到 4 步的 SDXL | 与 SDXL 相同 | 512 px |
| 3 Medium | 2024 年 6 月 | 扩散 Transformer(MMDiT),2B | CLIP ViT-L、OpenCLIP bigG、T5-XXL | 1024 px |
| 3.5 Large、Large Turbo、Medium | 2024 年 10 月 | MMDiT,8B;Medium 为 2.5B | 同样三个 | 1024 px |
1.5 至今仍是被微调最多的模型之一,社区 checkpoint 和 LoRA 数以万计,而且 4 GB 显存就能运行。SDXL 是主力:手、脸和构图更好,原生输出 1024 像素。3 和 3.5 用 Transformer 取代了 U-Net,把文本和图像 token 放在一起处理,这才终于让图中出现可读的文字成为可能:在提示词里把要写的字放进引号。SDXL 与 Stable Diffusion 3 对比展示了同样的提示词在两者上的效果。
许可证也变了。1.5 采用 CreativeML OpenRAIL-M 许可证,SDXL 采用 OpenRAIL++-M,两者都可免费商用,附带一份禁止用途清单。3.x 系列采用 Stability AI Community License,年收入低于一百万美元可免费使用。
能用它做什么:图生图、局部重绘、ControlNet、LoRA
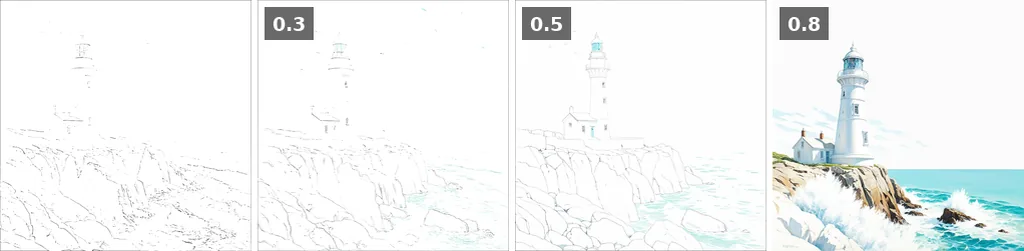
文生图只是开始,因为流程中的每个部件都可以复用。把一张草图编码成潜在表示,只加入部分噪声,再从那里开始去噪,就得到了图生图,界面里的 img2img:强度(strength 或 denoise)设置就是你加入多少噪声。这个想法来自 SDEdit。给潜在表示的一个区域加上蒙版,就是局部重绘,蒙版在画面之外时则是扩图。加上一个读取姿势、深度图或边缘的小型旁路网络,就是 ControlNet。用二十张照片训练几百万个额外权重,就得到一个能教模型认识一张脸或一种风格的 LoRA。专门的超分辨率模型负责放大。
要自己运行,1.5 有一张 6 GB 显存(VRAM)的较新 NVIDIA 显卡就够,SDXL 需要 8 GB。AMD 显卡通过 ROCm 运行,Apple Silicon 通过 MPS 后端运行。安装指南涵盖三个主要界面。没有显卡的话,本站的工具不需要任何硬件:Stable Diffusion XL 和 Stable Diffusion 1.5 在本站自己的 GPU 上运行,排队情况实时显示;带参数的提示词展示每个设置的作用;1,731 位画家风格展示模型对画家学到了什么。
Stable Diffusion vs Midjourney vs DALL-E
与 Midjourney 和 OpenAI 的图像模型相比,差别不在质量,而在控制。权重是公开的,模型在本地运行:你的图片留在你的硬盘上,你选择模型,你设定种子,你可以更换任何一个部件。作为交换,它对你的要求更多。Midjourney 要一句话,给你一张精修好的图;Stable Diffusion 要一个模型、一条提示词、一条负面提示词和一个引导系数,然后给你的正是你所设定的。
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| 权重 | 公开,可下载 | 封闭 | 封闭 |
| 在自己电脑上运行 | 可以,6 到 8 GB 显存 | 不行 | 不行 |
| 价格 | 本地免费;在线有免费工具 | 订阅 | 订阅或按张付费 |
| 控制 | 种子、模型、LoRA、ControlNet、局部重绘、所有设置 | 参数和风格参考 | 对话 |
| 微调 | 可以,任何人都行 | 不行 | 不行 |
| 图中文字 | 3 之前较弱,3.5 起良好 | v6 起良好 | 非常好 |
同样的扩散原理如今也驱动着其他实验室的模型,它们有各自的编码器和许可证:Black Forest Labs 的 FLUX,该公司由 Stable Diffusion 的原作者创立;以及 Alibaba 的 Qwen-Image。它们在同样的界面里运行,用同样的种子、步数和采样器,所以本页的大部分内容同样适用。它们的引导机制不同,FLUX dev 没有负面提示词,而且它们更喜欢完整的句子而不是关键词列表。
参考来源,以及如何复用图片
主要来源,按本页提到的顺序:
- High-Resolution Image Synthesis with Latent Diffusion Models,Rombach 等,2022:Stable Diffusion 的论文。
- Denoising Diffusion Probabilistic Models,Ho 等,2020:前向和反向过程,以及一千步的噪声调度。
- Learning Transferable Visual Models From Natural Language Supervision,Radford 等,2021:CLIP。
- Classifier-Free Diffusion Guidance,Ho 和 Salimans,2022:引导系数。
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis,2023,以及 Scaling Rectified Flow Transformers for High-Resolution Image Synthesis,2024:SDXL 和 Stable Diffusion 3。
复用图片。本页的生成图和示意图以 CC BY 4.0 发布:可以在课程、演讲或文章中复用,附上本页链接即可。所有生成图都使用 Stable Diffusion XL,euler,30 步,CFG 6,种子 20220822,下面的提示词,以及负面提示词「text, watermark, signature, blurry, low quality, storm, dark clouds, sunset」。
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokes引用本页。
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion