Stable Diffusion w skrócie
Stable Diffusion to otwartoźródłowy latentny model dyfuzyjny (LDM): sieć neuronowa wytrenowana tak, by zamieniać losowy szum w obraz, po trochu, pod kontrolą tekstu. Zbudowała go grupa CompVis z Uniwersytetu Ludwika i Maksymiliana w Monachium wspólnie z Runway, a wytrenowano go z użyciem mocy obliczeniowej Stability AI, na obrazach zebranych przez organizację non-profit LAION. Metoda pochodzi z artykułu High-Resolution Image Synthesis with Latent Diffusion Models (Rombach i współautorzy, CVPR 2022).
Wagi opublikowano 22 sierpnia 2022 roku. I to właśnie zmieniło wszystko. DALL-E 2 i Midjourney już istniały, ale za listami oczekujących i kredytami, na cudzych serwerach. Stable Diffusion był plikiem o rozmiarze 4 GB, który działał na karcie graficznej z 8 GB pamięci, bez konta i z filtrem bezpieczeństwa, który dało się wyłączyć.
W ciągu tygodni pojawiły się interfejsy webowe i inpainting, potem fine-tune'y, LoRA i ControlNet. Cztery lata później nazwa znaczy dwie rzeczy. W ścisłym sensie: rodzinę modeli od 1.4 do 3.5. W luźnym: całą praktykę uruchamiania modeli generujących obrazy na własnym komputerze.
Poniżej opisano samą maszynę, ze słownictwem, które spotkasz w każdym interfejsie: przestrzeń latentna, VAE, U-Net, CLIP, sampler, skala CFG, seed. Żaden wzór nie jest potrzebny, ale kilka liczb pomaga.
Jak działa Stable Diffusion? Trzy sieci i jedna pętla
Stable Diffusion to nie jedna sieć, lecz trzy, uruchamiane jedna po drugiej.
- Enkoder tekstu czyta prompt i zamienia go w listę liczb. W Stable Diffusion 1.5 to 77 tokenów, każdy opisany 768 liczbami; 2 048 w SDXL, który używa dwóch enkoderów.
- Odszumiacz, U-Net w wersjach od 1 do XL i transformer (MMDiT) od wersji 3, zaczyna od bloku losowego szumu i oczyszcza go przez 20 do 30 kroków, na każdym kroku zaglądając do liczb z tekstu. Nie pracuje na pikselach, lecz na skompresowanej wersji obrazu, latencie, która żyje w tak zwanej przestrzeni latentnej: 4 × 64 × 64 liczb dla obrazu 512 pikseli, 4 × 128 × 128 dla 1024 pikseli w SDXL.
- Dekoder zamienia ten latent w końcowe wartości pikseli, czerwoną, zieloną i niebieską: 3 × 512 × 512 albo 3 × 1024 × 1024 dla SDXL.
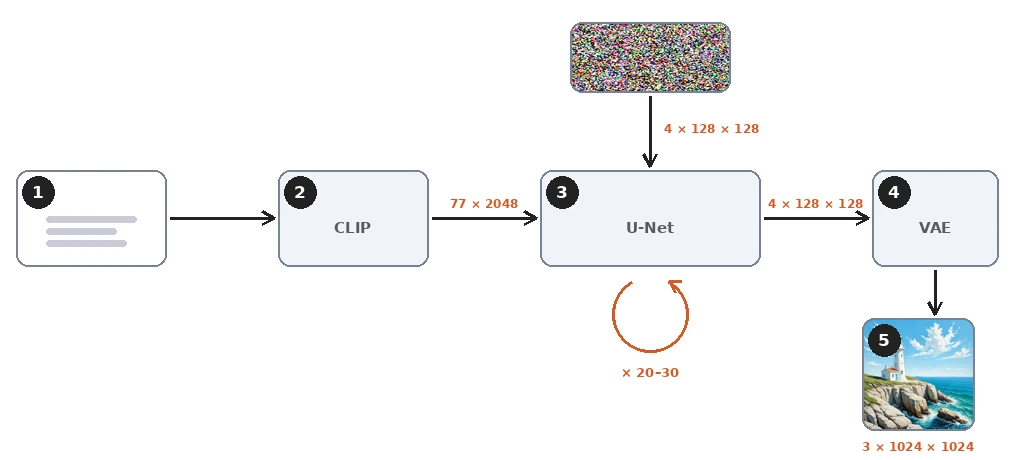
Po drodze nic nie jest wyszukiwane ani kopiowane. W pliku nie ma żadnej bazy obrazów. Od 2 do 16 GB wag przechowuje to, czego sieć nauczyła się o tym, jak podpisy i obrazy pasują do siebie, a każdy wynik jest obliczany z szumu. Sieć może jednak zapamiętać obrazy, które wiele razy pojawiły się w treningu, i badacze wydobyli kilkaset z nich, ale to wyjątek.
Co to jest model dyfuzyjny? Nauka usuwania szumu
Proces w przód: dodawanie szumu
Ideę dyfuzji łatwo sformułować. Weź zdjęcie z jego podpisem. Dodaj do niego odmierzoną porcję losowego szumu. Poproś sieć, by zgadła, jaki szum dodano, znając podpis. Porównaj jej odpowiedź z prawdą i odrobinę popraw sieć.
Dodawanie szumu to proces w przód (forward process). Przebiega według stałego harmonogramu tysiąca poziomów, od lekkiego ziarna na poziomie 50 do czystego śnieżenia na poziomie 999. Sieć nigdy nie widzi całego harmonogramu; widzi tylko jeden zaszumiony obraz na jednym poziomie naraz.
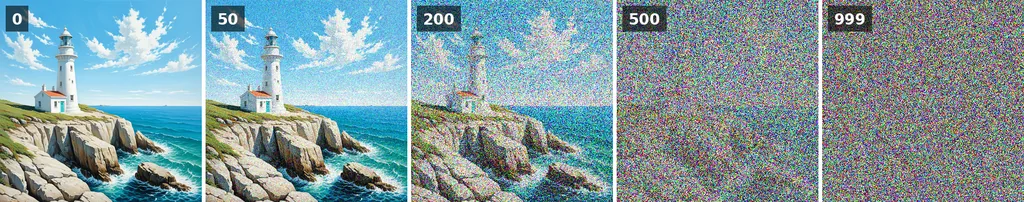
Zrób to na miliardach przykładów, a wynikiem będzie predyktor szumu: mając zaszumiony obraz, jego poziom szumu i tekst, mówi, jaki prawdopodobnie jest ten szum. Funkcją celu treningu jest po prostu różnica między przewidzianym szumem a prawdziwym. Trening Stable Diffusion 1 zajął około 150 000 godzin na serwerowych GPU A100, według karty modelu.
Proces odwrotny: predyktor szumu w akcji
Generowanie odtwarza tę lekcję od tyłu. To proces odwrotny (reverse process). Zacznij od czystego szumu, który wybiera seed. Zapytaj predyktor, jaki jest szum, usuń jego część, zapytaj ponownie. DDPM, artykuł z 2020 roku, który uczynił dyfuzję praktyczną, robił to w tysiącu małych kroków.
Sampler, w niektórych interfejsach nazywany schedulerem, to reguła, która decyduje, jak duży jest każdy krok i czy dodaje się z powrotem odrobinę świeżego szumu. Lepsze samplery, DDIM, Euler i rodzina DPM++, stawiają większe kroki po tej samej ścieżce i dlatego dziś wystarcza 20 do 30 kroków.
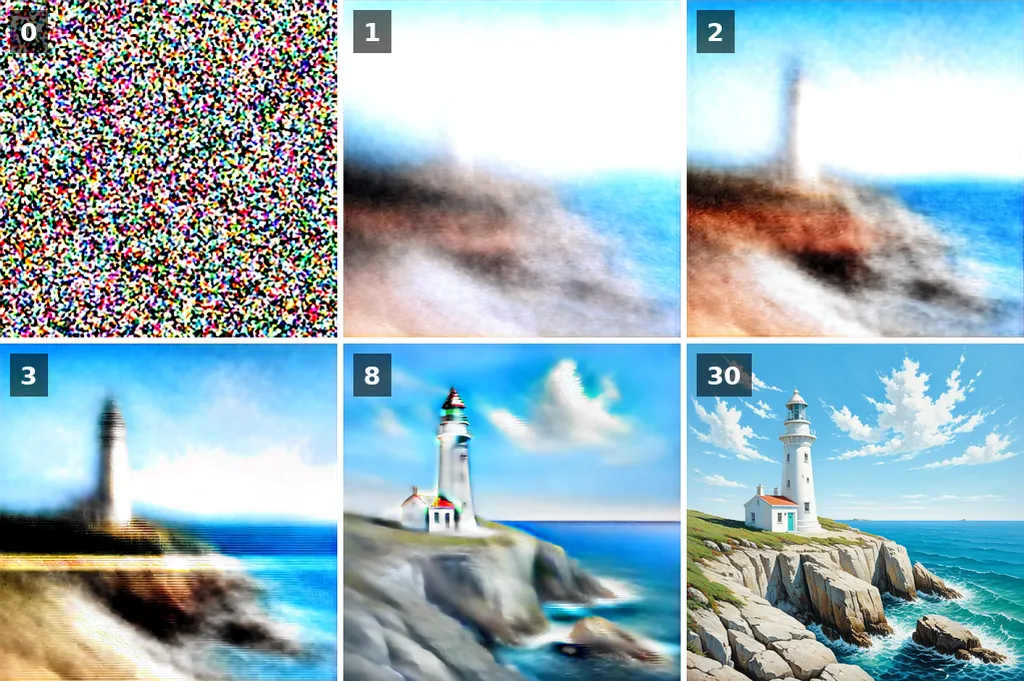
Rysunek pokazuje to, co warto zapamiętać. Na każdym kroku model ma oszacowanie gotowego obrazu i to oszacowanie ustala się wcześnie. Pierwsze dwa lub trzy kroki, gdy szum jest jeszcze gęsty, ustalają kompozycję: gdzie jest horyzont, gdzie stoi latarnia, ile jest nieba. Późniejsze kroki dopracowują fakturę i drobne detale.
Suwak poniżej przechodzi przez wszystkie trzydzieści oszacowań tego samego renderu.
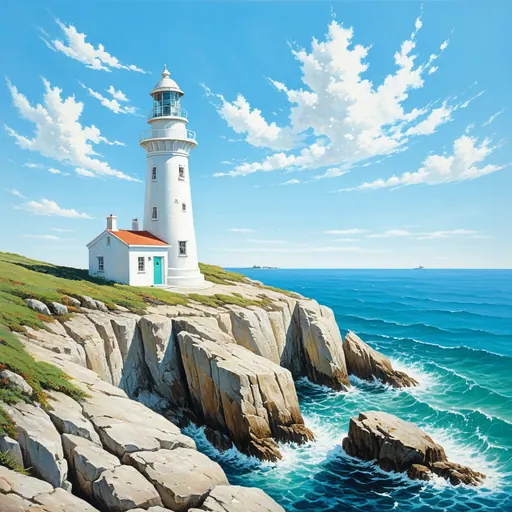
Wynikają z tego dwie praktyczne konsekwencje. Zmiana liczby kroków zmienia detale, a czasem kompozycję, bo wczesne kroki trafiają na inne wartości; nie wyostrza po prostu tego samego obrazu. A ten sam seed przy innym rozmiarze obrazu zaczyna od innego bloku szumu, więc też daje inny obraz. Najpierw wybierz rozmiar, potem szukaj seeda.
Dyfuzja latentna: sztuczka z VAE, dzięki której mieści się na karcie do gier
Wcześniejsze modele dyfuzyjne pracowały na pikselach. Obraz 512 × 512 to 786 432 liczb, a predyktor musiał je wszystkie czytać i zapisywać na każdym ze swoich kroków. Modele pikselowe, takie jak DALL-E 2 i Imagen, obchodziły to, prowadząc dyfuzję w 64 pikselach i dodając sieci powiększające, i tak zresztą nigdy ich nie udostępniono.
Stable Diffusion dodaje autoenkoder wariacyjny, VAE. Jego enkoder ściska obraz ośmiokrotnie na każdym boku do czterech kanałów: 4 × 64 × 64, czyli 16 384 liczb, 48 razy mniej. Dyfuzja przebiega w całości w tej skompresowanej przestrzeni, przestrzeni latentnej. Dopiero na samym końcu dekoder VAE rozwija wynik w piksele.

Latent nie jest małym obrazkiem. Jego cztery kanały to kod, który dekoder umie odczytać, i żaden pojedynczy kanał nie wygląda do końca jak obraz. Ale układ przetrwał kompresję i właśnie to pozwala odszumiaczowi decydować o kompozycji w tak małej przestrzeni.
Dlatego też wybór VAE ma znaczenie dla koloru i drobnych detali: każda liczba latentu odpowiada łatce 8 × 8 pikseli, a dekoder wymyśla, co jest wewnątrz łatki. Stable Diffusion 3 przeszedł na latent o 16 kanałach dokładnie z tego powodu i drobne detale oraz mały tekst poprawiły się wraz z nim.
CLIP i cross-attention: jak tekst steruje obrazem
Trzy elementy zamieniają słowa w kierunek dla odszumiacza.
Tokenizer i enkoder tekstu: jak CLIP czyta prompt
Tokenizer tnie prompt na tokeny, całe częste słowa albo fragmenty rzadszych. Stable Diffusion 1.5 i SDXL czytają najwyżej 77 tokenów, z czego dwa to znaczniki początku i końca, około 50 do 60 angielskich słów. Dalej tekst jest ucinany, chyba że interfejs dzieli go na kilka przebiegów. Umieszczaj to, co najważniejsze, na początku.
Enkoder tekstu w 1.5 to CLIP, sieć, którą OpenAI wytrenowało na 400 milionach par obraz–podpis, z jednym zadaniem: zbliżyć liczby opisujące podpis do liczb opisujących jego obraz. Po takim treningu liczby dla „lighthouse” niosą już to, jak wyglądają latarnie morskie. SDXL używa dwóch takich enkoderów obok siebie, drugi to otwarte ponowne wytrenowanie przez LAION na dwóch miliardach par. Stable Diffusion 3 dodaje trzeci, T5, który czyta całe zdania.
Cross-attention wewnątrz U-Netu
Cross-attention to miejsce, w którym tekst spotyka obraz. U-Net to stos bloków konwolucyjnych, które zmniejszają latent, a potem z powrotem go powiększają, ze skip connections między pasującymi rozmiarami. Między tymi blokami siedzą warstwy atencji. Na każdym kroku każdy obszar latentu patrzy na 77 wektorów tokenów i waży, które z nich go dotyczą. Obszar nieba zwraca uwagę na „sunset” i „clouds”, skała na „cliff”. Dlatego kolejność słów, powtórzenia i składnia wag w interfejsach mają znaczenie i dlatego słowo określające styl na początku barwi cały obraz.
To też ograniczenie pierwszych wersji. CLIP uczył się z krótkich tekstów alt, więc dobrze rozumie listy tematów i stylów, a słabo relacje między nimi. „A red cube on a blue sphere” w 1.5 często wychodzi na odwrót. Poradnik o promptach pokazuje, co działa niezawodnie.
Skala CFG, negatywny prompt i seed: trzy ustawienia
Trzy ustawienia pojawiają się w każdym interfejsie Stable Diffusion. Odpowiadają wprost mechanizmom opisanym wyżej.
Skala CFG, czyli guidance scale, skrót od classifier-free guidance, decyduje, jak mocno obraz jest dociskany do tekstu. Na każdym kroku odszumiacz robi w rzeczywistości dwie predykcje: jedną z promptem i jedną z pustym promptem. Różnica między nimi to kierunek, który nadaje prompt. Końcowa predykcja to ta pusta plus ta różnica pomnożona przez skalę CFG. Przy 1 predykcja z promptem jest używana taka, jaka jest, bez docisku: obraz luźno trzyma się tekstu, z przygaszonymi kolorami i szarym niebem tam, gdzie prompt prosił o błękitne. Przy 5 do 8 trzyma się promptu ściśle, z naturalnymi kolorami. Powyżej 12 kontrast twardnieje, kolory się nasycają, a pociągnięcia pędzla robią się ostre.
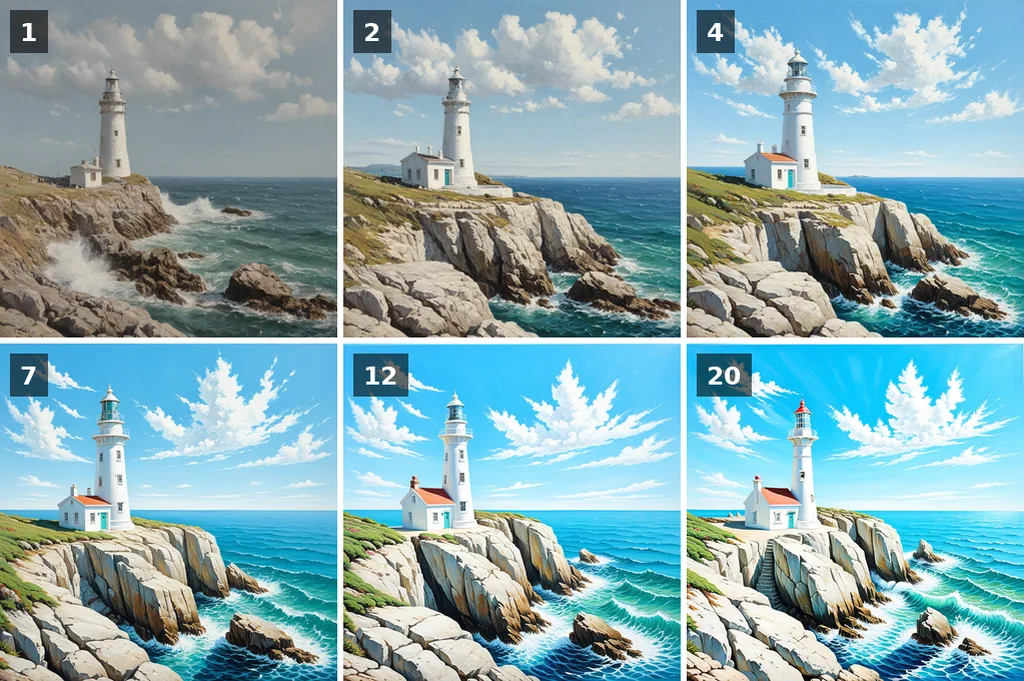
Negatywny prompt zastępuje pusty prompt w tej drugiej predykcji. Zamiast nie czytać nic, drugi przebieg czyta „blurry, text, watermark”, a guidance odpycha od tego. Nie kosztuje to nic dodatkowego, bo drugi przebieg i tak się wykonuje, i działa tylko wtedy, gdy guidance jest powyżej 1. Poradnik o negatywnym prompcie podaje działające listy.
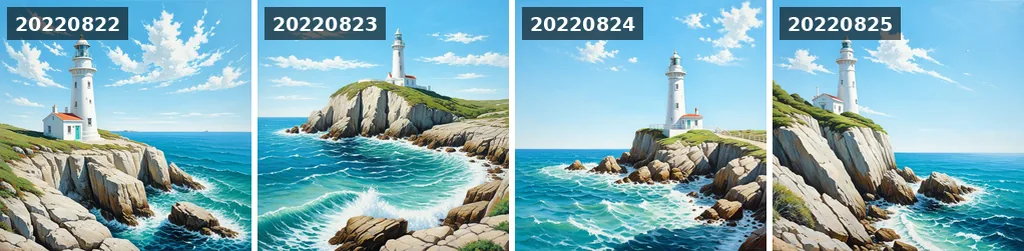
Seed to liczba, która generuje początkowy szum. Ten sam seed, ten sam prompt, te same ustawienia i ten sam model dają ten sam obraz, co do piksela, na tym samym oprogramowaniu i sprzęcie; inny interfejs lub inna karta losuje szum inaczej. Zmień seed, a zmieni się kompozycja, bo pierwsze kroki czytają inny blok szumu. Zmień jedno słowo promptu i zachowaj seed, a większość obrazu zwykle zostaje. Tak właśnie dopracowuje się prompt.
Od U-Netu do transformera: wersje od 1.5 do 3.5
W ciągu dwóch lat pojawiło się sześć głównych generacji, pierwsze dwie od CompVis i Runway, reszta od Stability AI. Każda zmieniała co najmniej jedną z trzech sieci.
| Wersja | Data | Odszumiacz | Enkodery tekstu | Rozmiar natywny |
|---|---|---|---|---|
| 1.4 i 1.5 | sierpień i październik 2022 | U-Net, 860 milionów parametrów | CLIP ViT-L | 512 px |
| 2.0 i 2.1 | listopad i grudzień 2022 | U-Net o tej samej budowie, wytrenowany od zera | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | lipiec 2023 | U-Net, 2,6 miliarda, plus refiner | CLIP ViT-L i OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | listopad 2023 | SDXL zdestylowany do 1–4 kroków | Jak w SDXL | 512 px |
| 3 Medium | czerwiec 2024 | Transformer dyfuzyjny (MMDiT), 2 miliardy | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | październik 2024 | MMDiT, 8 miliardów; Medium 2,5 miliarda | Te same trzy | 1024 px |
1.5 pozostaje jednym z najczęściej dotrenowywanych modeli w historii, z dziesiątkami tysięcy społecznościowych checkpointów i LoRA, i wciąż działa na 4 GB pamięci wideo. SDXL to koń roboczy: lepsze dłonie, twarze i kompozycja oraz natywne 1024 piksele. 3 i 3.5 zastąpiły U-Net transformerem, który przetwarza tokeny tekstu i obrazu razem, i to właśnie w końcu umożliwiło czytelny tekst na obrazach: wpisz słowa w cudzysłowie w prompcie. Porównanie SDXL ze Stable Diffusion 3 pokazuje te same prompty na obu.
Zmieniły się też licencje. 1.5 jest na licencji CreativeML OpenRAIL-M, a SDXL na OpenRAIL++-M, obie darmowe do użytku komercyjnego z listą zabronionych zastosowań. Modele 3.x są na Stability AI Community License, darmowej poniżej miliona dolarów rocznego przychodu.
Co można z nim zrobić: image-to-image, inpainting, ControlNet, LoRA
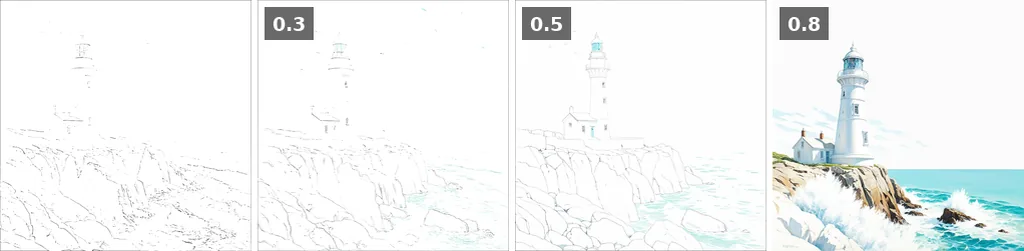
Tekst na obraz to dopiero początek, bo każdy element potoku można wykorzystać ponownie. Zakoduj szkic w latent, dodaj tylko część szumu i odszumiaj od tego miejsca, a masz image-to-image, w interfejsach img2img: ustawienie strength, czyli denoise, mówi, ile szumu dodajesz. Pomysł pochodzi z SDEdit. Zamaskuj jeden obszar latentu, a masz inpainting, albo outpainting, gdy maska leży poza kadrem. Dodaj małą sieć boczną, która czyta pozę, mapę głębi lub krawędzie, a masz ControlNet. Wytrenuj kilka milionów dodatkowych wag na dwudziestu zdjęciach, a masz LoRA, która uczy model twarzy lub stylu. Dedykowane modele superrozdzielczości zajmują się powiększaniem obrazów.
Żeby uruchomić go samodzielnie, wystarczy nowsza karta NVIDIA z 6 GB pamięci wideo (VRAM) dla 1.5 i 8 GB dla SDXL. Karty AMD działają przez ROCm, Apple Silicon przez backend MPS. Poradnik instalacji opisuje trzy główne interfejsy. Bez karty narzędzia na tej stronie nie wymagają sprzętu: Stable Diffusion XL i Stable Diffusion 1.5 działają na GPU strony, z kolejką pokazywaną na żywo, udokumentowane prompty pokazują, co robi każde ustawienie, a 1 731 stylów artystów pokazuje, czego model nauczył się o malarzach.
Stable Diffusion vs Midjourney vs DALL-E
W porównaniu z Midjourney i modelami obrazów OpenAI różnica nie leży w jakości, lecz w kontroli. Wagi są publiczne, a model działa lokalnie: twoje obrazy zostają na twoim dysku, ty wybierasz model, ty ustawiasz seed i możesz zmienić każdy komponent. W zamian wymaga od ciebie więcej. Midjourney prosi o zdanie i oddaje dopracowany obraz; Stable Diffusion prosi o model, prompt, negatywny prompt i skalę CFG, i daje dokładnie to, co ustawisz.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Wagi | Publiczne, do pobrania | Zamknięte | Zamknięte |
| Działa na twoim komputerze | Tak, 6 do 8 GB VRAM | Nie | Nie |
| Cena | Darmowy lokalnie; darmowe narzędzia online | Abonament | Abonament lub opłata za obraz |
| Kontrola | Seed, model, LoRA, ControlNet, inpainting, każde ustawienie | Parametry i referencje stylu | Rozmowa |
| Dotrenowanie | Tak, przez każdego | Nie | Nie |
| Tekst na obrazach | Słaby przed 3, dobry od 3.5 | Dobry od v6 | Bardzo dobry |
Ta sama zasada dyfuzji napędza dziś modele z innych laboratoriów, z innymi enkoderami i innymi licencjami: FLUX od Black Forest Labs, założonego przez pierwotnych autorów Stable Diffusion, oraz Qwen-Image od Alibaby. Działają w tych samych interfejsach, z tymi samymi seedami, krokami i samplerami, więc większość tej strony odnosi się także do nich. Ich guidance działa inaczej, FLUX dev nie ma negatywnego promptu, a od list słów kluczowych wolą pełne zdania.
Źródła i jak wykorzystać ilustracje
Źródła pierwotne, w kolejności, w jakiej pojawiają się na stronie:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach i in., 2022: artykuł o Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho i in., 2020: proces w przód i odwrotny oraz harmonogram tysiąca kroków.
- Learning Transferable Visual Models From Natural Language Supervision, Radford i in., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho i Salimans, 2022: skala CFG.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, oraz Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL i Stable Diffusion 3.
Wykorzystanie ilustracji. Rendery i schematy na tej stronie są udostępnione na licencji CC BY 4.0: możesz użyć ich w kursie, prezentacji lub artykule z linkiem do tej strony. Każdy render używa Stable Diffusion XL, euler, 30 kroków, CFG 6, seed 20220822, poniższego promptu i negatywnego promptu „text, watermark, signature, blurry, low quality, storm, dark clouds, sunset”.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesJak cytować tę stronę.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion