Kısaca Stable Diffusion
Stable Diffusion, açık kaynaklı bir latent difüzyon modelidir (LDM): rastgele gürültüyü, bir metnin yönlendirmesiyle, azar azar bir görsele dönüştürmek üzere eğitilmiş bir sinir ağı. Münih Ludwig Maximilian Üniversitesi’ndeki CompVis grubu tarafından Runway ile birlikte geliştirilmiş, Stability AI’ın sağladığı hesaplama gücüyle, kâr amacı gütmeyen LAION kuruluşunun topladığı görseller üzerinde eğitilmiştir. Yöntem, High-Resolution Image Synthesis with Latent Diffusion Models makalesinden gelir (Rombach ve arkadaşları, CVPR 2022).
Ağırlıklar 22 Ağustos 2022’de yayımlandı. Her şeyi değiştiren de bu oldu. DALL-E 2 ve Midjourney zaten vardı, ama bekleme listelerinin ve kredilerin ardında, başkasının sunucularında. Stable Diffusion ise 8 GB bellekli bir ekran kartında çalışan 4 GB’lık bir dosyaydı; hesap gerektirmiyordu ve güvenlik filtresi kapatılabiliyordu.
Birkaç hafta içinde web arayüzleri ve inpainting, ardından ince ayarlı sürümler, LoRA’lar ve ControlNet geldi. Dört yıl sonra bu ad iki şey ifade ediyor. Dar anlamıyla, 1.4’ten 3.5’e uzanan model ailesi. Geniş anlamıyla, görsel modellerini kendi bilgisayarında çalıştırma pratiğinin tamamı.
Aşağıda makinenin kendisi, her arayüzde karşınıza çıkacak sözcüklerle anlatılıyor: latent uzay, VAE, U-Net, CLIP, örnekleyici (sampler), guidance scale, seed. Hiçbir formül gerekmez, ama birkaç sayı işe yarar.
Stable Diffusion nasıl çalışır? Üç ağ ve bir döngü
Stable Diffusion tek bir ağ değil, art arda çalışan üç ağdır.
- Bir metin kodlayıcı promptu okur ve bir sayı listesine çevirir. Stable Diffusion 1.5’te bu, her biri 768 sayıyla tanımlanan 77 token’dır; iki kodlayıcı çalıştıran SDXL’de ise 2.048.
- Bir gürültü giderici, 1’den XL’e kadar olan sürümlerde bir U-Net, 3. sürümden itibaren bir transformer (MMDiT), rastgele bir gürültü bloğundan yola çıkar ve her adımda metnin sayılarına bakarak onu 20 ila 30 adımda temizler. Pikseller üzerinde değil, görselin sıkıştırılmış bir sürümü olan ve latent uzay denen yerde yaşayan latent üzerinde çalışır: 512 piksellik bir görsel için 4 × 64 × 64 sayı, SDXL’in 1024 pikseli için 4 × 128 × 128.
- Bir kod çözücü bu latent’i nihai piksel değerlerine, kırmızı, yeşil ve maviye çevirir: 3 × 512 × 512, SDXL’de ise 3 × 1024 × 1024.
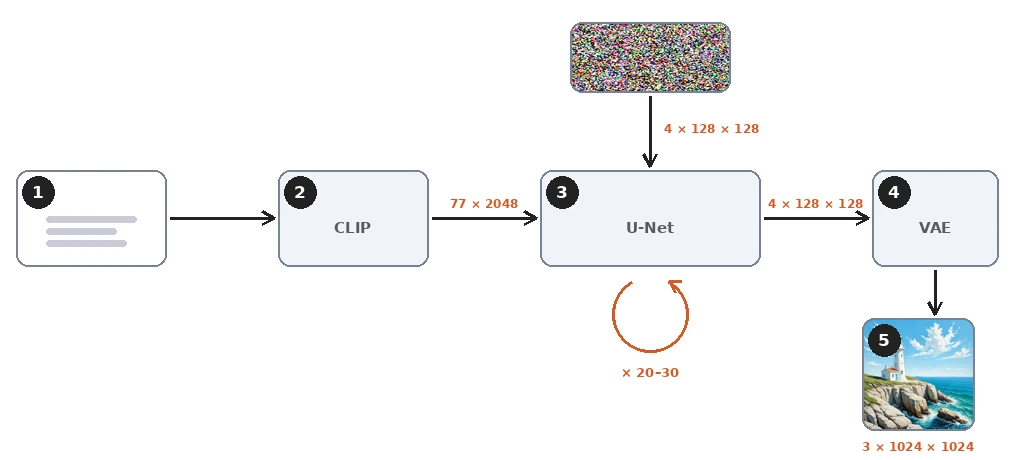
Bu yol boyunca hiçbir şey aranmaz ya da kopyalanmaz. Dosyanın içinde bir görsel veritabanı yoktur. 2 ila 16 GB’lık ağırlıklar, ağın açıklamalarla görsellerin birbirine nasıl uyduğuna dair öğrendiklerini tutar ve her çıktı gürültüden hesaplanır. Ağ yine de eğitimde çok sık görünen görselleri ezberleyebilir ve araştırmacılar bunlardan birkaç yüz tanesini çıkarmayı başarmıştır, ama bu bir istisnadır.
Difüzyon modeli nedir? Gürültü gidermeyi öğrenmek
İleri süreç: gürültü ekleme
Difüzyonun ardındaki fikri söylemesi kolaydır. Açıklamasıyla birlikte bir fotoğraf alın. Üzerine ölçülü miktarda rastgele gürültü ekleyin. Bir ağdan, açıklamayı bilerek, hangi gürültünün eklendiğini tahmin etmesini isteyin. Tahminini gerçekle karşılaştırın ve ağı biraz düzeltin.
Gürültü eklemek ileri süreçtir. Bin seviyelik sabit bir plana göre ilerler: seviye 50’de belli belirsiz bir grenden seviye 999’da saf parazite. Ağ bu planın işleyişini hiç görmez; her seferinde yalnızca tek bir seviyede tek bir gürültülü görsel görür.
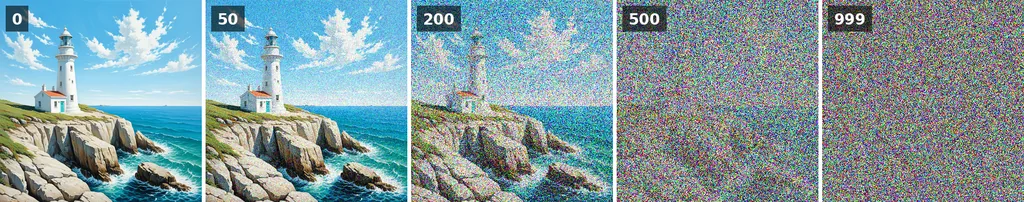
Bunu milyarlarca örnek üzerinde yaptığınızda ortaya bir gürültü tahmincisi çıkar: gürültülü bir görsel, gürültü seviyesi ve bir metin verildiğinde gürültünün muhtemelen ne olduğunu söyler. Eğitimin hedefi, tahmin edilen gürültü ile gerçek gürültü arasındaki farktan ibarettir. Model kartına göre Stable Diffusion 1’in eğitimi, veri merkezi A100 GPU’larında yaklaşık 150.000 saat sürmüştür.
Ters süreç: gürültü tahmincisi iş başında
Üretim, öğrenilen dersi tersten işletir. Bu da ters süreçtir. Seed’in belirlediği saf gürültüden başlayın. Tahminciye gürültünün ne olduğunu sorun, bir kısmını çıkarın, yeniden sorun. Difüzyonu kullanılabilir hale getiren 2020 tarihli makale DDPM, bunu bin küçük adımda yapıyordu.
Bazı arayüzlerde zamanlayıcı (scheduler) olarak da adlandırılan örnekleyici (sampler), her adımın ne kadar büyük olacağına ve geriye biraz taze gürültü eklenip eklenmeyeceğine karar veren kuraldır. DDIM, Euler ve DPM++ ailesi gibi daha iyi örnekleyiciler aynı yol üzerinde daha büyük adımlar atar; bugün 20 ila 30 adımın yetmesinin nedeni budur.
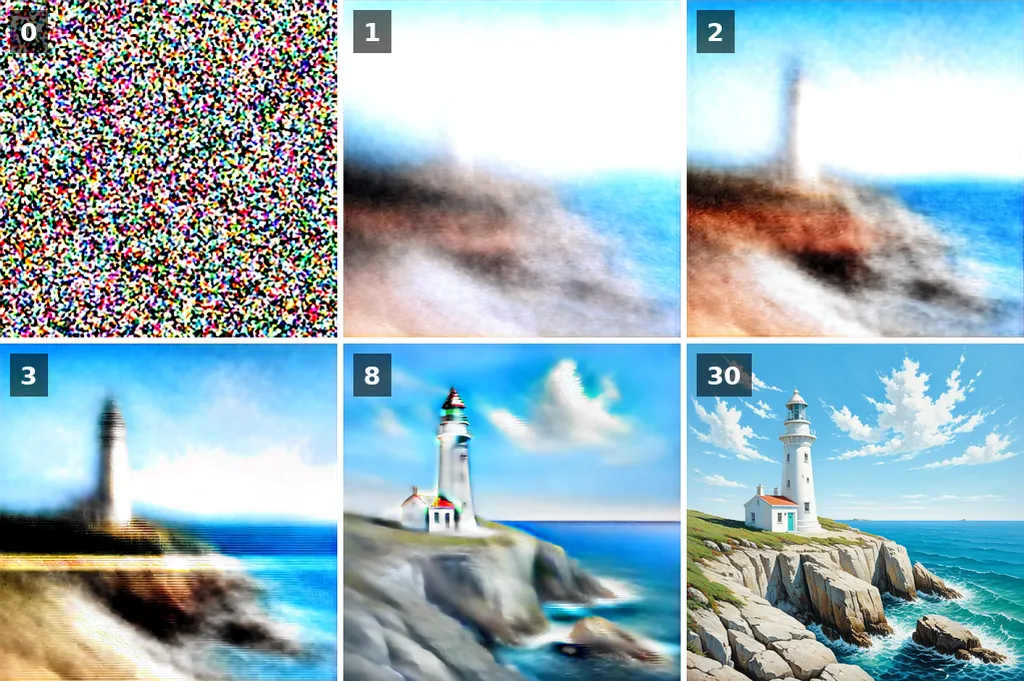
Görsel, akılda tutulması gereken kısmı gösteriyor. Model her adımda bitmiş görsele dair bir tahmin taşır ve bu tahmin erken oturur. Gürültünün hâlâ yoğun olduğu ilk iki üç adım kompozisyonu sabitler: ufuk nerede, deniz feneri nerede duruyor, ne kadar gökyüzü var. Sonraki adımlar dokuyu ve küçük ayrıntıları inceltir.
Aşağıdaki kaydırıcı, aynı üretimin otuz tahmininin tamamını gösterir.
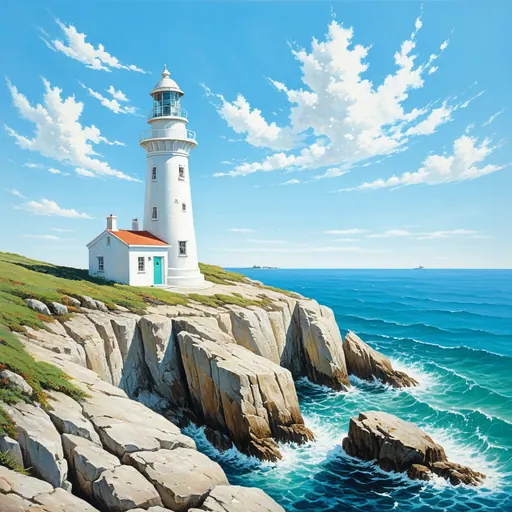
Bundan iki pratik sonuç çıkar. Adım sayısını değiştirmek ayrıntıları, bazen de kompozisyonu değiştirir, çünkü ilk adımlar başka değerlere oturur; aynı görseli yalnızca keskinleştirmez. Aynı seed, başka bir görsel boyutunda farklı bir gürültü bloğundan başlar, dolayısıyla o da farklı bir görsel verir. Önce boyutu seçin, seed’i sonra arayın.
Latent difüzyon: modeli oyuncu ekran kartına sığdıran VAE hilesi
Daha önceki difüzyon modelleri pikseller üzerinde çalışıyordu. 512 × 512’lik bir görsel 786.432 sayıdır ve tahmincinin her adımda bunların hepsini okuyup yazması gerekiyordu. DALL-E 2 ve Imagen gibi piksel modelleri bu sorunu 64 pikselde difüzyon yapıp büyütme ağları ekleyerek aşıyordu; zaten hiçbir zaman yayımlanmadılar.
Stable Diffusion bir varyasyonel otokodlayıcı, yani VAE ekler. Kodlayıcısı görseli her kenarda sekiz kat sıkıştırarak dört kanala indirir: 4 × 64 × 64, yani 16.384 sayı, 48 kat daha az. Difüzyonun tamamı bu sıkıştırılmış uzayda, latent uzayda gerçekleşir. VAE’nin kod çözücüsü sonucu ancak en sonda piksellere açar.

Latent, küçük bir görsel değildir. Dört kanalı, kod çözücünün okumayı bildiği bir koddur ve hiçbir kanal tek başına görsele tam olarak benzemez. Ama yerleşim sıkıştırmadan sağ çıkar; gürültü gidericinin bu kadar küçük bir uzayda kompozisyona karar verebilmesini sağlayan da budur.
VAE seçiminin renk ve ince ayrıntı açısından önemli olmasının nedeni de budur: her latent sayısı 8 × 8 piksellik bir yamayı temsil eder ve yamanın içindekini kod çözücü uydurur. Stable Diffusion 3 tam da bu nedenle 16 kanallı latent’e geçti; ince ayrıntılar ve küçük yazılar bununla birlikte iyileşti.
CLIP ve cross-attention: metin görseli nasıl yönlendirir
Üç parça, kelimeleri gürültü giderici için bir yöne dönüştürür.
Tokenizer ve metin kodlayıcı: CLIP bir promptu nasıl okur
Tokenizer promptu token’lara böler: yaygın kelimelerin tamamı, daha nadir kelimelerin parçaları. Stable Diffusion 1.5 ve SDXL en fazla 77 token okur; bunların ikisi başlangıç ve bitiş işaretidir, yani yaklaşık 50 ila 60 İngilizce kelime. Bunun ötesi, arayüz metni birkaç bloğa bölmedikçe kesilir. En önemli şeyi başa koyun.
1.5’in metin kodlayıcısı, OpenAI’ın 400 milyon görsel-açıklama çifti üzerinde tek bir görevle eğittiği CLIP ağıdır: bir açıklamayı tanımlayan sayıları, görselini tanımlayan sayılara yaklaştırmak. Bu eğitimden sonra “lighthouse” kelimesinin sayıları, deniz fenerlerinin neye benzediğini zaten taşır. SDXL böyle iki kodlayıcıyı yan yana çalıştırır; ikincisi LAION’un iki milyar çift üzerinde yaptığı açık bir yeniden eğitimdir. Stable Diffusion 3 ise tam cümleleri okuyan üçüncü bir kodlayıcı, T5, ekler.
U-Net içindeki cross-attention
Cross-attention, metnin görselle buluştuğu yerdir. U-Net, latent’i küçültüp sonra yeniden büyüten, eşleşen boyutlar arasında atlama bağlantıları (skip connection) bulunan bir evrişim blokları yığınıdır. Bu blokların arasında attention katmanları yer alır. Her adımda latent’in her bölgesi 77 token vektörüne bakar ve hangilerinin kendisini ilgilendirdiğini tartar. Gökyüzü bölgesi “sunset” ve “clouds”a, kaya ise “cliff”e dikkat eder. Kelime sırasının, tekrarın ve arayüzlerdeki ağırlık sözdiziminin etkili olmasının, başa yazılan bir stil kelimesinin bütün görseli boyamasının nedeni budur.
İlk sürümlerin sınırı da burasıdır. CLIP kısa alternatif metinlerden öğrendiği için konu ve stil listelerini iyi, aralarındaki ilişkileri kötü anlar. “A red cube on a blue sphere” 1.5’te çoğu zaman yer değiştirmiş çıkar. Prompt rehberi güvenilir biçimde işe yarayanları gösterir.
Guidance scale, negatif prompt ve seed: üç ayar
Her Stable Diffusion arayüzünde üç ayar bulunur. Bunlar doğrudan yukarıdaki mekanizmaya karşılık gelir.
Guidance scale, sınıflandırıcısız yönlendirmenin (classifier-free guidance, CFG) kısaltmasıdır ve metnin ne kadar ağır basacağına karar verir. Gürültü giderici her adımda aslında iki tahmin yapar: biri promptla, diğeri boş bir promptla. İkisi arasındaki fark, promptun verdiği yöndür. Nihai tahmin, boş tahmin artı bu farkın guidance scale ile çarpımıdır. 1’de promptlu tahmin olduğu gibi kullanılır, hiçbir itme yoktur: görsel metni gevşek biçimde izler, renkler soluk, prompt mavi istediği halde gökyüzü gridir. 5 ila 8 civarında promptu doğal renklerle yakından izler. 12’nin ötesinde kontrast sertleşir, renkler doygunlaşır ve fırça darbeleri haşinleşir.
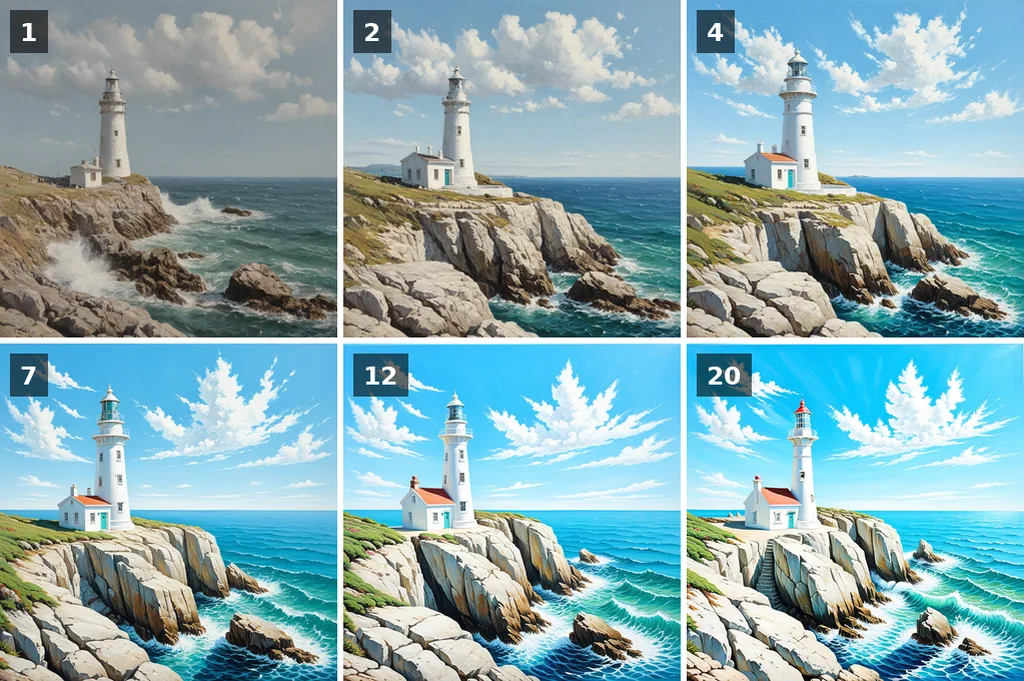
Negatif prompt, bu ikinci tahmindeki boş promptun yerini alır. İkinci geçiş hiçbir şey okumak yerine “blurry, text, watermark” okur ve yönlendirme görseli bundan uzaklaştırır. Ek bir maliyeti yoktur, çünkü ikinci geçiş zaten çalışır; ve yalnızca yönlendirme 1’in üzerindeyken işe yarar. Negatif prompt rehberi işe yarayan listeler verir.
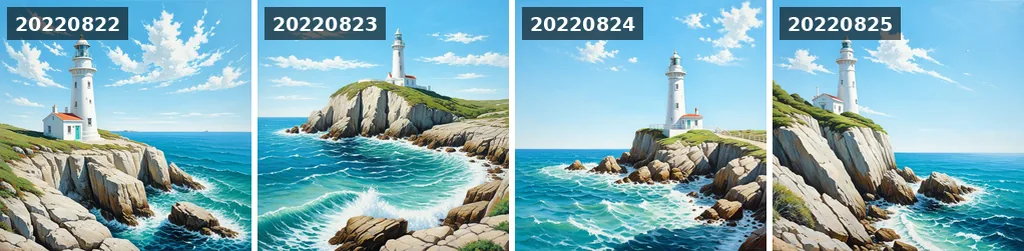
Seed, başlangıç gürültüsünü üreten sayıdır. Aynı seed, aynı prompt, aynı ayarlar ve aynı model, aynı yazılım ve donanımda piksel piksel aynı görseli verir; başka bir arayüz ya da başka bir ekran kartı gürültüyü farklı üretir. Seed’i değiştirin, kompozisyon değişir, çünkü ilk adımlar başka bir gürültü bloğunu okur. Promptun tek bir kelimesini değiştirip seed’i sabit tutun, görselin büyük kısmı genellikle yerinde kalır. Bir prompt böyle iyileştirilir.
U-Net’ten transformer’a: 1.5’ten 3.5’e sürümler
İki yılda altı ana nesil çıktı; ilk ikisi CompVis ve Runway’den, kalanı Stability AI’dan. Her biri üç ağdan en az birini değiştirdi.
| Sürüm | Tarih | Gürültü giderici | Metin kodlayıcılar | Doğal boyut |
|---|---|---|---|---|
| 1.4 ve 1.5 | Ağustos ve Ekim 2022 | U-Net, 860 milyon parametre | CLIP ViT-L | 512 px |
| 2.0 ve 2.1 | Kasım ve Aralık 2022 | Aynı tasarımda U-Net, sıfırdan yeniden eğitilmiş | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Temmuz 2023 | U-Net, 2,6 milyar, artı bir refiner | CLIP ViT-L ve OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Kasım 2023 | 1 ila 4 adıma damıtılmış SDXL | SDXL ile aynı | 512 px |
| 3 Medium | Haziran 2024 | Diffusion transformer (MMDiT), 2 milyar | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Ekim 2024 | MMDiT, 8 milyar; Medium 2,5 milyar | Aynı üçü | 1024 px |
1.5, on binlerce topluluk checkpoint’i ve LoRA’sıyla en çok ince ayar yapılmış modellerden biri olmayı sürdürüyor ve hâlâ 4 GB video belleğiyle çalışıyor. SDXL ise her işe koşulan emektardır: daha iyi eller, yüzler ve kompozisyon, doğal 1024 piksel çıktı. 3 ve 3.5, U-Net’in yerine metin ve görsel token’larını birlikte işleyen bir transformer koydu; görsellerde okunaklı yazıyı nihayet mümkün kılan da budur: kelimeleri promptta tırnak içine yazın. SDXL ile Stable Diffusion 3 karşılaştırması aynı promptları iki modelde de gösterir.
Lisanslar da değişti. 1.5, CreativeML OpenRAIL-M lisansı, SDXL ise OpenRAIL++-M altındadır; ikisi de yasak kullanımlar listesiyle birlikte ticari kullanıma ücretsizdir. 3.x modelleri ise yıllık bir milyon doların altındaki gelirler için ücretsiz olan Stability AI Community License altındadır.
Neler yapılabilir: image-to-image, inpainting, ControlNet, LoRA
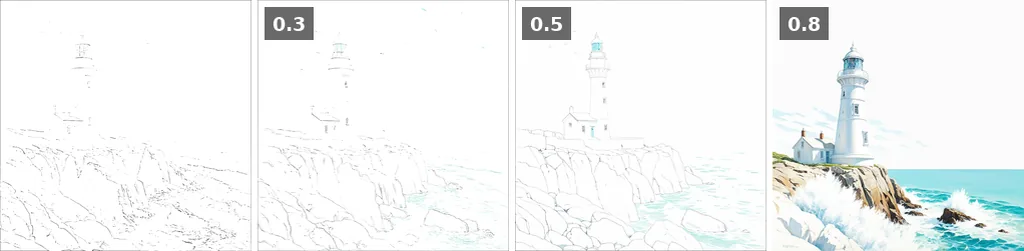
Metinden görsel yalnızca başlangıçtır, çünkü işlem hattının her parçası yeniden kullanılabilir. Bir eskizi latent’e kodlayın, gürültünün yalnızca bir kısmını ekleyin ve oradan gürültü gidermeye başlayın: arayüzlerde img2img denen image-to-image budur; strength ya da denoise ayarı, ne kadar gürültü eklediğinizdir. Fikir SDEdit’ten gelir. Latent’in bir bölgesini maskeleyin, inpainting elde edersiniz; maske çerçevenin dışındaysa buna outpainting denir. Bir pozu, bir derinlik haritasını ya da kenarları okuyan küçük bir yan ağ ekleyin, ControlNet elde edersiniz. Yirmi fotoğraf üzerinde birkaç milyon ek ağırlık eğitin, modele bir yüz ya da bir stil öğreten bir LoRA elde edersiniz. Görsel büyütmeyi ise özel süper çözünürlük modelleri üstlenir.
Kendiniz çalıştırmak için 1.5’te 6 GB, SDXL’de 8 GB video belleği (VRAM) olan güncel bir NVIDIA ekran kartı yeterlidir. AMD kartlar ROCm, Apple Silicon ise MPS arka ucu üzerinden çalışır. Kurulum rehberi üç ana arayüzü kapsar. Ekran kartınız yoksa bu sitedeki araçlar donanım gerektirmez: Stable Diffusion XL ve Stable Diffusion 1.5 sitenin kendi GPU’sunda, kuyruk canlı gösterilerek çalışır; belgelenmiş promptlar her ayarın ne yaptığını, 1.731 sanatçı stili ise modelin ressamlar hakkında ne öğrendiğini gösterir.
Stable Diffusion vs Midjourney vs DALL-E
Midjourney ve OpenAI’ın görsel modelleri karşısında fark kalitede değil, kontroldedir. Ağırlıklar herkese açıktır ve model yerel olarak çalışır: görselleriniz kendi diskinizde kalır, modeli siz seçersiniz, seed’i siz belirlersiniz ve her bileşeni değiştirebilirsiniz. Karşılığında sizden daha fazlasını ister. Midjourney bir cümle ister ve cilalı bir görsel verir; Stable Diffusion bir model, bir prompt, bir negatif prompt ve bir guidance scale ister ve size tam olarak ayarladığınız şeyi verir.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Ağırlıklar | Açık, indirilebilir | Kapalı | Kapalı |
| Kendi bilgisayarınızda çalışır | Evet, 6 ila 8 GB VRAM | Hayır | Hayır |
| Fiyat | Yerelde ücretsiz; çevrimiçi ücretsiz araçlar | Abonelik | Abonelik ya da görsel başına |
| Kontrol | Seed, model, LoRA, ControlNet, inpainting, her ayar | Parametreler ve stil referansları | Sohbet |
| İnce ayar | Evet, isteyen herkes | Hayır | Hayır |
| Görselde yazı | 3’ten önce zayıf, 3.5’ten itibaren iyi | v6’dan beri iyi | Çok iyi |
Aynı difüzyon ilkesi bugün başka laboratuvarların modellerini de çalıştırıyor; başka kodlayıcılar ve başka lisanslarla: Stable Diffusion’ın özgün yazarlarının kurduğu Black Forest Labs’in FLUX’u ve Alibaba’nın Qwen-Image’ı. Aynı arayüzlerde, aynı seed’ler, adımlar ve örnekleyicilerle çalışırlar; bu yüzden bu sayfanın büyük kısmı onlar için de geçerlidir. Yönlendirmeleri farklı çalışır, FLUX dev’de negatif prompt yoktur ve anahtar kelime listeleri yerine tam cümleleri tercih ederler.
Kaynaklar ve görsellerin yeniden kullanımı
Birincil kaynaklar, sayfada geçtikleri sırayla:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach vd., 2022: Stable Diffusion makalesi.
- Denoising Diffusion Probabilistic Models, Ho vd., 2020: ileri ve ters süreçler ile bin adımlık plan.
- Learning Transferable Visual Models From Natural Language Supervision, Radford vd., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho ve Salimans, 2022: guidance scale.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, ve Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL ve Stable Diffusion 3.
Görsellerin yeniden kullanımı. Bu sayfadaki üretimler ve şemalar CC BY 4.0 lisansıyla yayımlanmıştır: bu sayfaya bağlantı vererek bir derste, bir sunumda ya da bir makalede kullanabilirsiniz. Her üretimde Stable Diffusion XL, euler, 30 adım, CFG 6, seed 20220822, aşağıdaki prompt ve şu negatif prompt kullanılmıştır: “text, watermark, signature, blurry, low quality, storm, dark clouds, sunset”.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesBu sayfaya atıf vermek için.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion