Qwen-Image 2.1 nedir?
Qwen-Image 2.1, iki iş için tek bir checkpoint: metinden görsel üretmek ve mevcut bir görseli bir cümle ile en fazla on referans görselden yola çıkarak düzenlemek. Üretim tarafı, 7 milyar parametreli bir diffusion transformer ile bir Qwen3-VL 8B metin kodlayıcıdan oluşur; ComfyUI’ın model için yüklediği dosya budur. Kodlayıcının bir dil modeli olması sayesinde model anahtar kelime listeleri yerine cümlelerin tamamını, yerleşim talimatlarını ve tırnak içindeki kelimeleri okur; testlerimiz de bunu doğruluyor. Prompt şeffaf arka plan istediğinde gerçek bir alfa kanalına sahip görseller de üretir.
Qwen, 2.1’i dokular, tipografi ve portre ışığı açısından geliştirilmiş bir sürüm olarak sunuyor ve model doğal 2K’da çalışıyor: kare için 2048 × 2048, 3:2 için 2528 × 1696, 16:9 için 2752 × 1536, upscaler olmadan. Bedeli zaman. 16 GB video belleğine sahip tüketici sınıfı bir kartta int8 ağırlıklar, aşağıdaki ayarlarla 1 megapiksellik bir görseli yaklaşık 40 saniyede, 4 megapiksellik bir görseli ise yaklaşık dört buçuk dakikada üretiyor.
Her şeyden önce: ağırlıklar Qwen Research License kapsamında, yalnızca araştırma ve değerlendirme amaçlı; her türlü ticari kullanım Qwen’den alınacak ayrı bir lisans gerektiriyor. Ağustos 2025’te yayımlanan ilk Qwen-Image Apache 2.0 lisanslıydı; 2.1 değil.
Qwen-Image 2.1 için prompt nasıl yazılır?
Etiket değil, cümle yazın. Metin kodlayıcı bir dil modelidir: kelime sırasını, edatları ve tırnak işaretlerini okur ve her şeyi kelimesi kelimesine alır. Örneğin “lighthouse cat” yazarsanız bir deniz fenerinin üzerine çizilmiş bir kedi çıkar. Yaklaşık bin görsel boyunca bize en iyi sonuçları veren yapı aşağıdaki gibidir, bu sırayla.
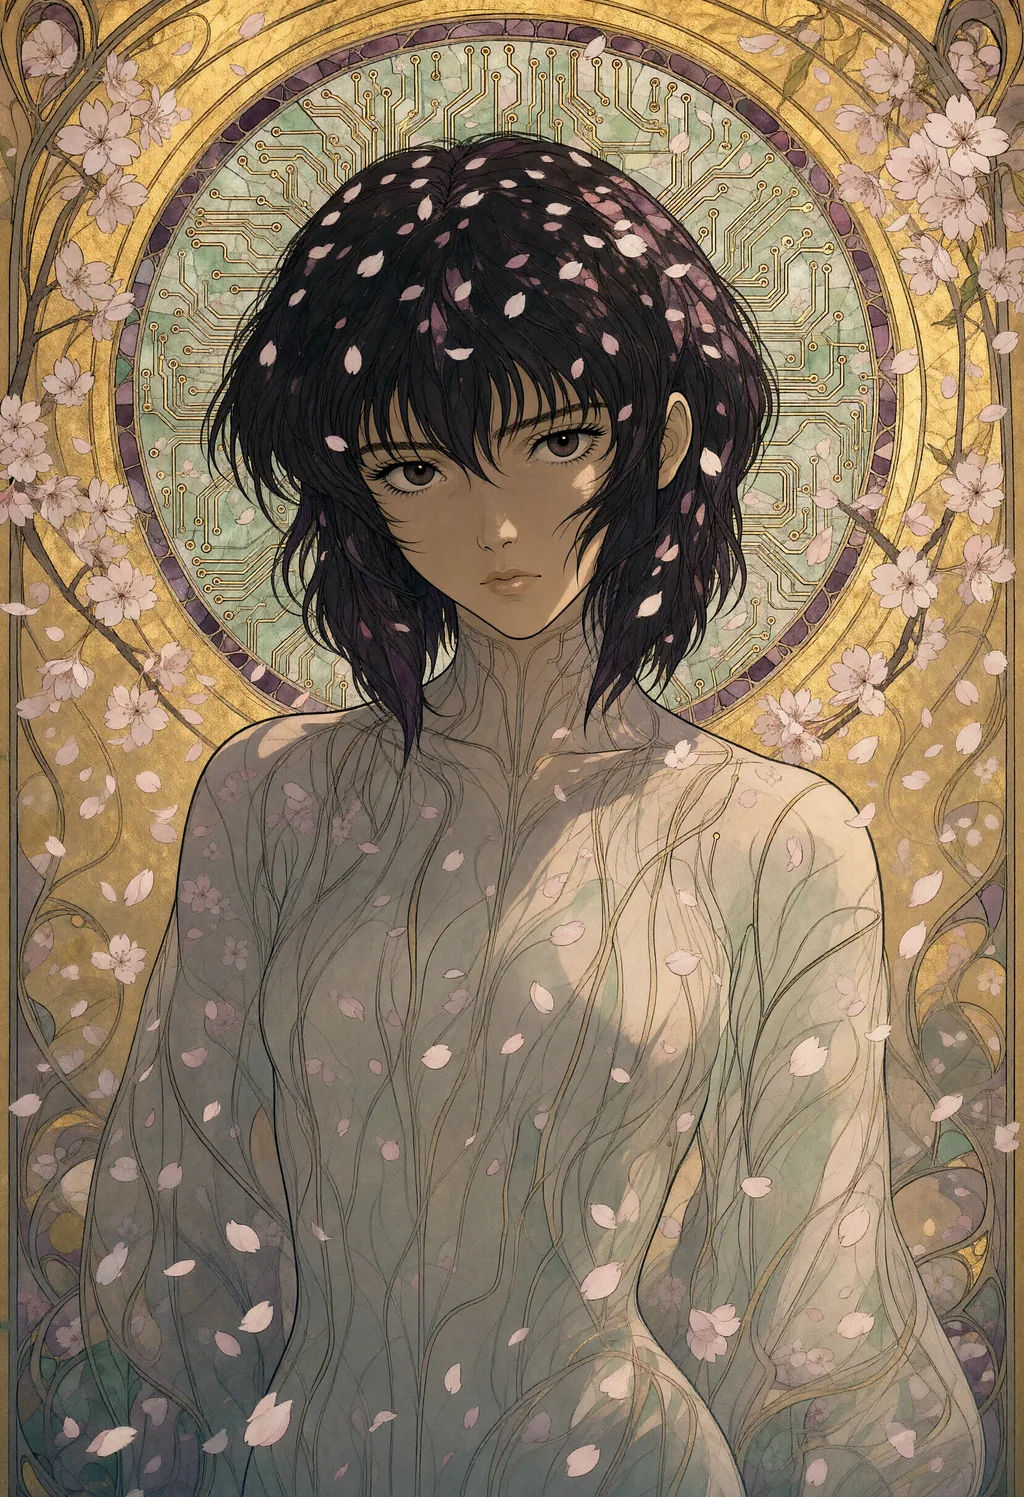
- Önce teknik ve konu: “An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. Başta belirtilen teknik, ondan sonra gelen her şeye rengini verir.
- Mekan: yer, dönem, hava ya da havayı dolduran şey. “in falling cherry blossoms”, “in the 1980s”, “during a blizzard”.
- Yönüyle birlikte ışık: “lit from the front by soft diffuse light, with gentle shadows”. Yöne uyulur; tek başına “dramatic light” ise dikkate alınmaz.
- Kadraj: “close-up of the subject, looking at the viewer”, orta plan, yukarıdan görünüm, uçsuz bucaksız bir manzarada minicik bir konu.
- Malzemeler ve palet: “flowing ink lines, flat gold leaf background, muted jade and plum”. Modelin 2K’da en iyi işlediği şey budur.
- Prompta yazılmış kısıtlamalar: “no lettering, no watermark”, “five fingers on each hand”. Guidance 1’de negatif prompt yok sayılır, dolayısıyla bunları promptun kendisi taşımak zorundadır.
Yukarıdaki illüstrasyonun promptunun tamamı, bu sırayla: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Yazı, tırnak içine alındığında ve yeri belirtildiğinde işe yarar: “a banner above the door reads 'OPEN ALL NIGHT'” büyük harfle olsun olmasın hemen her seferinde doğru çıkar. Tersi de geçerlidir: yazı istenmemiş bir dükkan vitrini, bir lokanta ya da bir oyun salonu kendiliğinden uydurma bir tabela edinir; bu yüzden sahnede bir cephe varsa mutlaka “no lettering” yazın. Modelin tanımadığı karakterler uyarı vermeden bir benzeriyle değiştirilir: Marsupilami bir maymuna dönüştü, Mothra ve Marvin the Martian ise doğru çıktı. Prompt örnekleri sayfamızdaki her Qwen kartı seed değeri, boyutu ve ayarlarıyla birlikte bu yapıyı izler.
İşe yarayan ayarlar, ölçülmüş haliyle
Resmi ComfyUI şablonu guidance (CFG) 1 ve 25 adımla çalışır, model kartı ise 40 adım kullanır. Biz daha yüksek bir guidance seçtik. En son 16 Ekim 2026’da, aynı seed değerleriyle yaptığımız testte en ayrıntılı ve prompta en sadık görselleri şu ayarlar verdi:
| Ayar | Değer |
|---|---|
| Guidance (CFG) | 3, negatif promptla |
| Negatif prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Model yamaları | APG (eta 1, norm threshold 10, momentum 0.3), ardından FreSca (low 1, high 2, cutoff 8), örnekleyiciden önce |
| Örnekleyici (sampler) | euler, simple zamanlayıcı (scheduler) |
| Adım | 1 megapikselde 25, 4 megapikselde 20 |
| LoRA | yok |
Guidance, sahneyi değiştirmeyen tek ayardır: aynı seed ve boyutta CFG 1 ile CFG 3 neredeyse aynı kompozisyonu verir; fark işlemede ortaya çıkar. CFG 1’de görsel daha düz kalır ve ince dokuyu kaybeder: nakış ilmekleri kumaşa dönüşür, bir çizgi film yüzü göz bebeklerini ve ağzını kaybeder, metalin perçinleri silinir. CFG 1’i 30 adıma çıkarmak keskinliği geri getirir ama malzemeleri ve kontrastı getirmez; 2 megapikselde 40 adım temiz ama yine daha düz bir görsel verdi ve promptu daha az güvenilir biçimde okudu. APG, CFG 3’ün renkleri aşırı doyurmasını engeller; FreSca ise yüksek frekansları keskinleştirir. İkisi de yalnızca guidance 1’in üzerindeyken devreye girer.
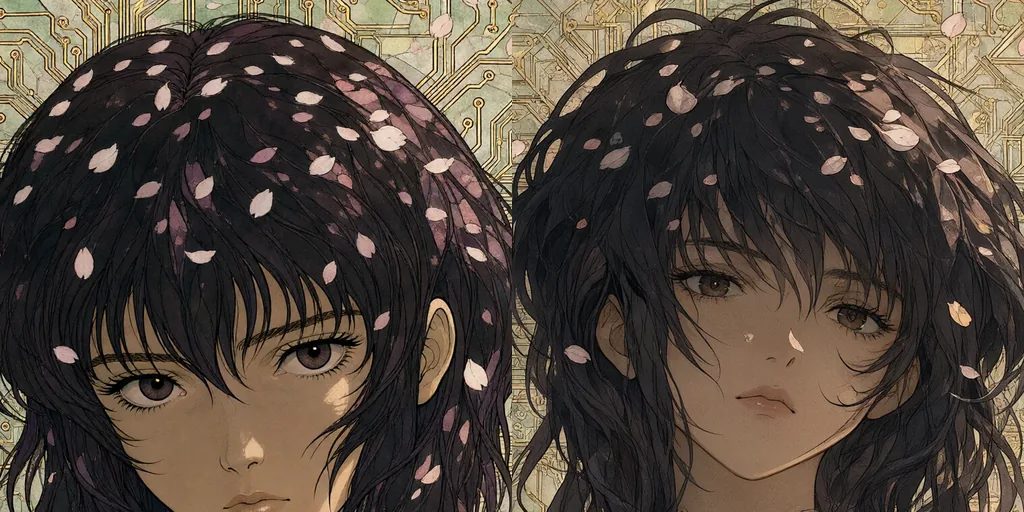
1’in üzerindeki guidance’ın bedeli her adımda ikinci bir geçiştir: CFG 1 iki kat hızlıdır. Bizim kartımızda bu, 4 megapiksellik bir görsel için 255 ila 275 saniyeye karşılık 120 ila 135 saniye demek; on test çiftinin her birinde yavaş olanın bu bedele değdiğini gördük.
Çözünürlük ve adım sayısı: görseli ne değiştirir?
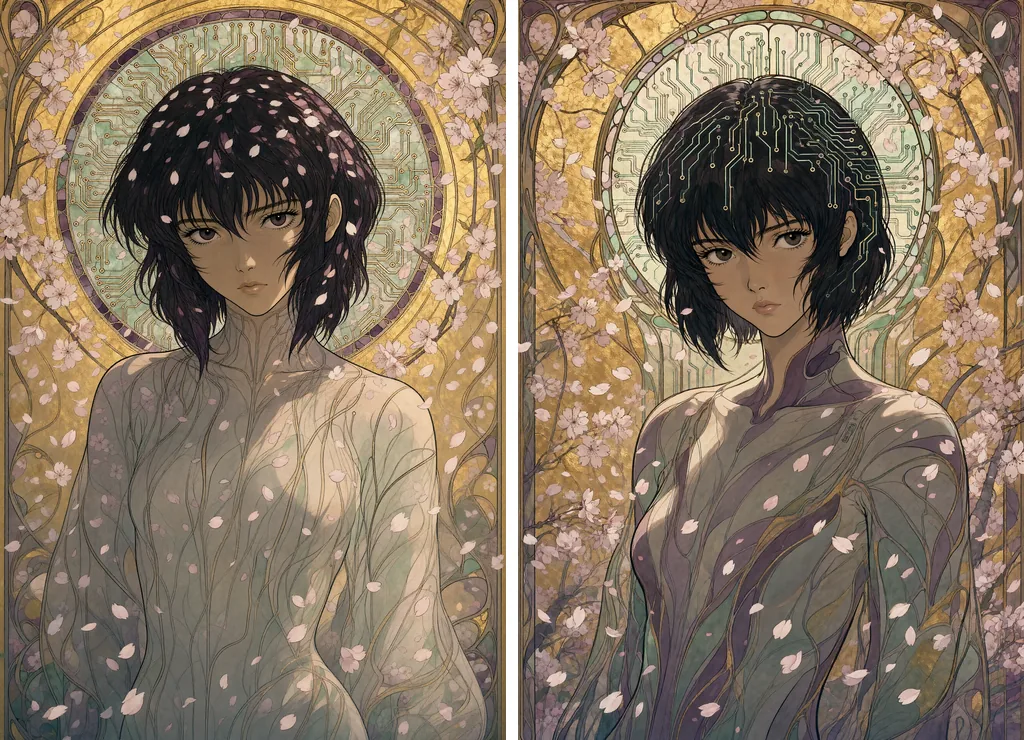
İki şey bizi şaşırttı. Boyutu değiştirmek görseli yeniden boyutlandırmaz, aynı seed’in başka bir yorumunu üretir. 1 megapikselden 2.5’e ya da 4’e geçmek bize her seferinde farklı bir görsel verdi; 2.5 ile 4 megapiksel arasında kompozisyon on çiftin sekizinde korundu, aşağıdaki illüstrasyonda olduğu gibi; orada yalnızca ayrıntılar yer değiştirdi: 2.5 megapikselde devre yolları haleden saçlara geçti. Adım sayısını değiştirmek de fark büyüdüğünde görseli değiştirir: 20 ile 25 adım neredeyse aynı görseli verir, 16 adımda görsel kayar. Dolayısıyla 1 megapikselde ön izleme yapıp aynı görseli daha büyük üretmenin bir yolu yoktur. Önce boyutu seçin, sonra seed’i.
CFG 3, APG ve FreSca ile, int8 ağırlıklarla, tek bir 16 GB’lık tüketici kartında ölçülen süreler:
| Boyut | Adım | Görsel başına süre |
|---|---|---|
| 1 megapiksel (1216 × 832) | 25 | yaklaşık 40 s |
| 2.5 megapiksel (1920 × 1312) | 20 | 120 ila 135 s |
| 4 megapiksel (2432 × 1664) | 20 | 255 ila 275 s |
| 4 megapiksel | 25 | 315 ila 335 s |
Aynı bölgeyi %100’de karşılaştırdığınızda 2.5 megapikselde ayrıntı 4’e göre biraz daha yumuşaktır, ama model promptun stilini en az onun kadar iyi izler; on test çiftimizde bazen daha da iyi: bir nakış 2.5 megapikselde görünür ilmeklerini korurken 4’te fotoğrafa dönüştü. 1024 piksel olarak sunulan bir galeri için ideal nokta 20 adımda 2.5 megapikseldir. Baskı için 20 adımda 4 megapiksel.
Hızlandırmalar: resmi Turbo, ölçülmüş haliyle
İlk Lightning LoRA. 2025’in 8 adımlı Qwen-Image-Lightning LoRA’sı, dikkat katmanları 3072 genişliğinde olan ilk Qwen-Image üzerinde eğitilmişti. Qwen-Image 2.1 ise 4096 kullanır. ComfyUI her dikkat ağırlığı için bir hata yazar, bunları atlar ve çıplak modeli 8 adımda işler: ilk bakışta yeterince keskin görünür, ama LoRA’yı almıyorsunuzdur ve damıtılmamış bir modelden 8 adımda çıkan görsel istediğiniz şey değildir.
Resmi Turbo. Qwen, 9 Ekim 2026’da Qwen-Image-2.1-Turbo’yu yayımladı: CFG 1’de, sabit bir sigma takvimiyle 8 adımda çalışan damıtılmış bir checkpoint. Comfy-Org bunu hem int8 dosyası hem de temel model için LoRA olarak, ComfyUI’da kendi şablonlarıyla sunuyor. 17 Ekim’de, CFG 3 üretimlerimizle aynı on seed ve boyutta, şablonun düğüm grafını birebir kullanarak ölçtük.
| Ayar | Görsel başına süre |
|---|---|
| Turbo checkpoint, 8 adım, 1 megapiksel | 9 ila 10 s |
| Turbo checkpoint, 8 adım, 4 megapiksel | 38 ila 39 s |
| Temel checkpoint artı Turbo LoRA, 8 adım, 4 megapiksel | 52 ila 55 s |
| Bizim ayarımız, CFG 3, 20 adım, 4 megapiksel | 255 ila 275 s |
4 megapikselde yedi kat, 1 megapikselde dört kat daha hızlı; görseller de temiz: keskin, iyi aydınlatılmış, on seed’imizde anatomi hatası yok, yazı temel modelin doğru yaptığı yerlerde doğru. Prompttaki nesneler yerli yerinde, bazen temel modelden bile iyi: temel modelin üretimlerimizin hepsinde atladığı yarış arabasındaki kaplumbağa, Turbo ile ortaya çıktı. Kaybettiği şey teknik. Damıtılmış model, prompt ne isterse istesin fotoğrafik gerçekçiliğe kayıyor: bir timsah nakışı timsah fotoğrafına dönüştü, bir karakalem çizimi grenini kaybetti, kağıt kesme tekniğiyle yapılmış bir Marvin the Martian vinil oyuncağa döndü. Cephelerdeki uydurma yazılar temel modeldekiyle aynı. Temel checkpoint üzerindeki LoRA, Turbo checkpoint ile aynı görselleri yalnızca daha yavaş veriyor; dolayısıyla indirilecek olan checkpoint. Bir seed, her boyut değişikliğinde olduğu gibi temel modelden farklı bir görsel verir; lisans da aynı: yalnızca araştırma ve değerlendirme.
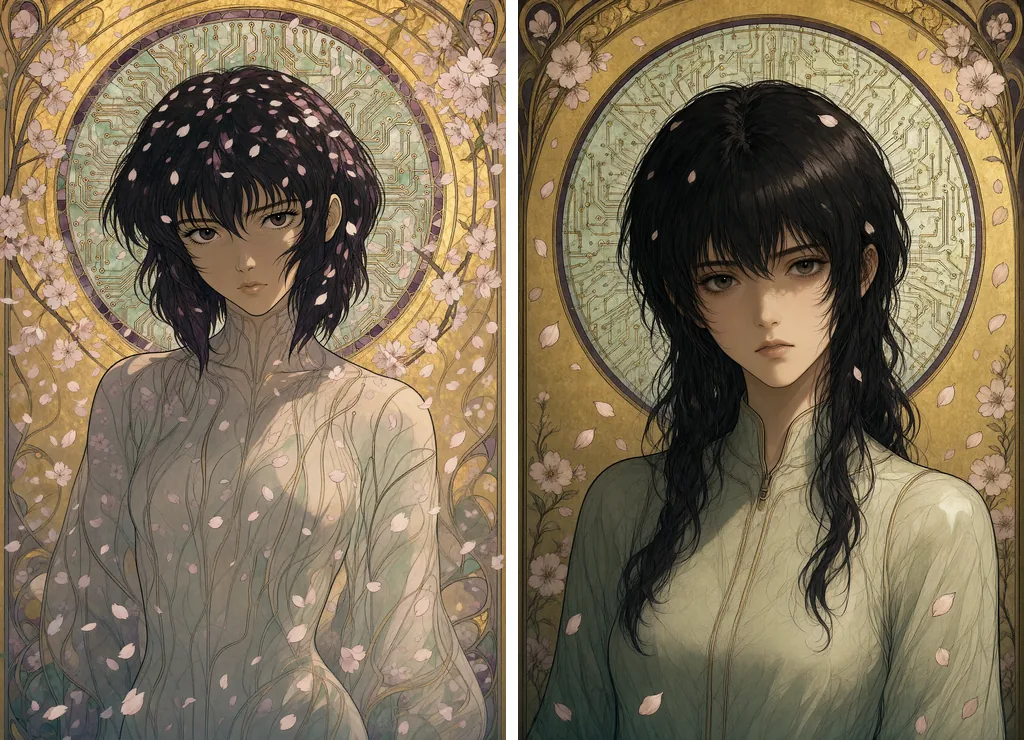
Bizim kullanımımız: taslak modu. Eleme için saatte yedi kat daha fazla aday; boyanmış, çizilmiş ya da el işi her şey için ise CFG 3 ile son üretim. Fotoğrafik promptlarda Turbo sonucu çoğu zaman olduğu haliyle yeterince iyi.
Diğer damıtmalar. LightX2V, 13 Ekim 2026’da 2.1 için 4 adımlı bir Lightning LoRA yayımladı; topluluktan çıkan 8 adımlı bir LoRA, Turbo8, da var. İkisi de resmi Turbo gibi CFG 1’de çalışır. Bunları ölçmedik.
Önek önbelleği düğümü. ComfyUI’ın QwenImage21Cache düğümü yalnızca modelin zaten tuttuğu önbelleğin aygıtını ve hassasiyetini ayarlar; varsayılan değerlerinde hiçbir şeyi değiştirmez. int8 modu önbelleği yarıya indirir ve 2K’da ya da birkaç referans görselle düzenleme yaparken bellek yetmediğinde yardımcı olur. Bununla gözle görülür bir kayıp görmedik.
Daha az adım. 16 adım sürenin yaklaşık beşte birini kazandırır ama kompozisyonu değiştirir ve 20’ye göre keskinlik kazandırmaz. Kısıt zamansa adımdan önce boyutu düşürün.
Qwen-Image 2.1’i yerel olarak çalıştırmak
ComfyUI modeli yerleşik olarak destekler. Üç dosya her zamanki klasörlere gider: diffusion modeli diffusion_models, Qwen3-VL metin kodlayıcı text_encoders, VAE ise vae klasörüne. 16 GB’lık bir kartta tercih edilmesi gerekenler Comfy-Org’un yayımladığı int8 sürümleridir: bf16 ağırlıklar da çalışır ama sistem belleğine taşar ve aynı görseller için iki ila altı kat daha uzun sürer.
Düğüm grafı kısadır: UNETLoader, qwen_image tipiyle CLIPLoader, VAELoader, promptu ve negatif promptu birlikte alıp iki koşullandırmayı da veren TextEncodeQwenImage21 düğümü, seçilen boyutta boş bir latent, ardından model yolunda APG ve FreSca, euler ve simple zamanlayıcıyla CFG 3’te bir KSampler ve VAEDecode. Şeffaf bir görsel için konuyu model kartının önerdiği kalıba sarın: “This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.” ve PNG olarak kaydedin.
Bellek: int8 model, kodlayıcı ve VAE 1 megapikselde 16 GB’a rahatça sığar; 4 megapikseli önek önbelleği int8’e ayarlı olarak çalıştırdık ve bellek hiç tükenmedi. Oturumun ilk görseli, dosyalar yüklenirken daha uzun sürer.