Wat Qwen-Image 2.1 is
Qwen-Image 2.1 is één checkpoint voor twee taken. Het genereert een afbeelding uit tekst, en het bewerkt een bestaande afbeelding op basis van een zin en maximaal tien referentieafbeeldingen. Het generatiedeel is een diffusion transformer met 7 miljard parameters. Het is gekoppeld aan een Qwen3-VL 8B-tekstencoder, die in ComfyUI als apart bestand wordt geladen.
Een taalmodel als encoder is wat het in staat stelt hele zinnen, lay-outinstructies en woorden tussen aanhalingstekens te lezen in plaats van lijstjes trefwoorden.
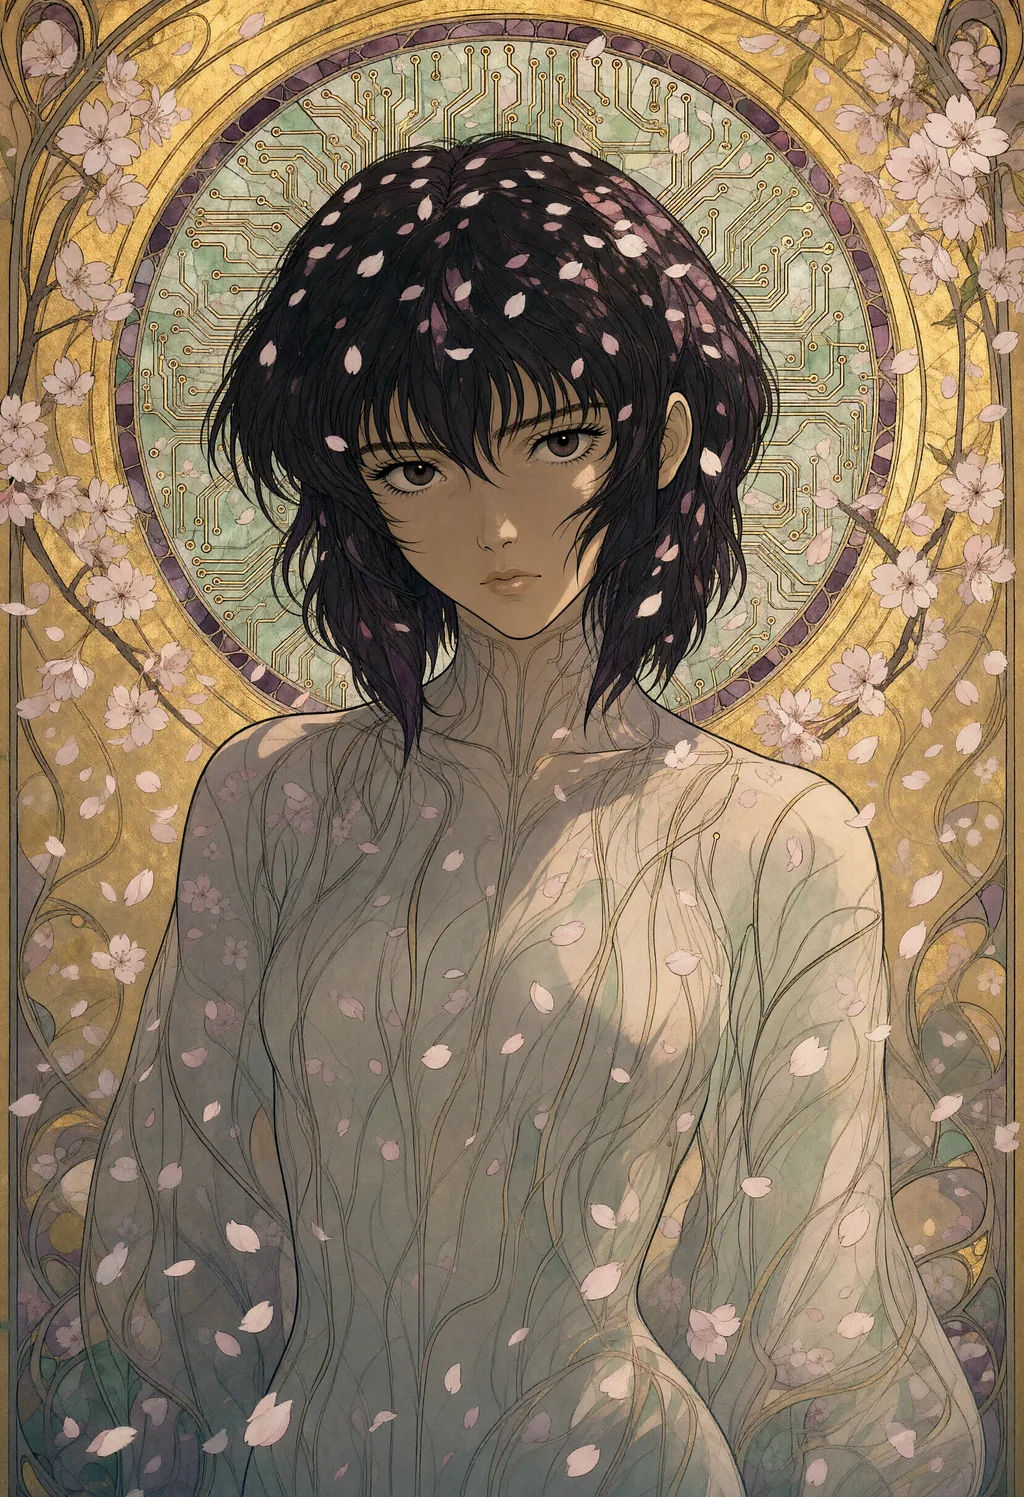
Qwen presenteert 2.1 als beter in texturen, typografie en portretbelichting. Het werkt in native 2K zonder upscaler: 2048 × 2048 voor een vierkant, 2528 × 1696 voor 3:2, 2752 × 1536 voor 16:9. Het kan ook een echt alfakanaal leveren als de prompt om een transparante achtergrond vraagt.
De prijs is tijd. Op een consumentenkaart met 16 GB videogeheugen doen de int8-gewichten ongeveer 40 seconden over een afbeelding van 1 megapixel. Een afbeelding van 4 megapixel duurt met de instellingen hieronder ongeveer vier en een halve minuut.
Eén ding om te weten voor je downloadt. De gewichten vallen onder de Qwen Research License: alleen onderzoek en evaluatie. Elk commercieel gebruik vereist een aparte licentie van Qwen. De eerste Qwen-Image, uitgebracht in augustus 2025, was Apache 2.0. Versie 2.1 is dat niet.
Hoe schrijf je een prompt voor Qwen-Image 2.1?
Schrijf zinnen, geen tags. De tekstencoder is een taalmodel. Hij leest woordvolgorde, voorzetsels en aanhalingstekens, en hij neemt alles letterlijk. Een "lighthouse cat" wordt een kat die op een vuurtoren is getekend.
De opbouw hieronder gaf over ongeveer duizend afbeeldingen de beste resultaten. Houd deze volgorde aan.
- Medium en onderwerp eerst: "An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms". Het medium dat vooraan staat, kleurt alles wat erna komt.
- Omgeving: plaats, tijdperk, weer, of wat de lucht vult. "in falling cherry blossoms", "in the 1980s", "during a blizzard".
- Licht met richting: "lit from the front by soft diffuse light, with gentle shadows". De richting wordt gevolgd. Een kaal "dramatic light" niet.
- Kader: "close-up of the subject, looking at the viewer", medium shot, van bovenaf gezien, het onderwerp piepklein in een weids landschap.
- Materialen en palet: "flowing ink lines, flat gold leaf background, muted jade and plum". Dit is wat het model in 2K het best rendert.
- Beperkingen, in de prompt zelf: "no lettering, no watermark", "five fingers on each hand". Op guidance 1 wordt de negatieve prompt genegeerd, dus de prompt zelf moet ze dragen.
De volledige prompt van de illustratie hierboven, in die volgorde: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Tekst werkt als hij tussen aanhalingstekens staat en een plek krijgt. "A banner above the door reads 'OPEN ALL NIGHT'" komt er bijna elke keer goed uit, in hoofdletters of niet.
Het omgekeerde geldt ook. Een winkelpui, een diner of een speelhal zonder gevraagde tekst krijgt een verzonnen uithangbord. Zeg dus "no lettering" zodra de scène een gevel bevat.
Personages die het model niet kent, worden zonder waarschuwing vervangen door een dubbelganger. De Marsupilami werd een aap. Mothra en Marvin the Martian kwamen er goed uit.
Elke Qwen-kaart op de pagina met promptvoorbeelden volgt deze opbouw, met seed, formaat en instellingen.
Instellingen die werken, gemeten
Het officiële ComfyUI-template draait op een guidance (CFG) van 1 met 25 steps. De model card gebruikt 40 steps. De instellingen hieronder zijn uitgekomen op CFG 3.
Voor het laatst getest op 16 oktober 2026, op dezelfde seeds, gaven deze instellingen de meest gedetailleerde en meest getrouwe afbeeldingen:
| Instelling | Waarde |
|---|---|
| Guidance (CFG) | 3, met een negatieve prompt |
| Negatieve prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Modelpatches | APG (eta 1, norm threshold 10, momentum 0,3) en daarna FreSca (low 1, high 2, cutoff 8), vóór de sampler |
| Sampler | euler, scheduler simple |
| Steps | 25 op 1 megapixel, 20 op 2,5 en 4 megapixel |
| LoRA | geen |
Guidance is de enige instelling die de scène niet verandert. Bij dezelfde seed en hetzelfde formaat geven CFG 1 en CFG 3 vrijwel dezelfde compositie. Wat verschilt, is de weergave.
Op CFG 1 is het beeld vlakker en verliest het fijne textuur. Borduursteken worden stof. Een cartoongezicht verliest zijn pupillen en mond. Metaal verliest zijn klinknagels.
CFG 1 opvoeren naar 30 steps brengt de scherpte terug, maar niet de materialen en het contrast. Op 2 megapixel, een formaat dat één keer is geprobeerd, geven 40 steps een schoon beeld dat nog steeds vlakker is, en de prompt wordt minder betrouwbaar gelezen.
APG voorkomt dat CFG 3 oververzadigt. FreSca verscherpt de hoge frequenties. Beide doen alleen iets als de guidance boven 1 staat.
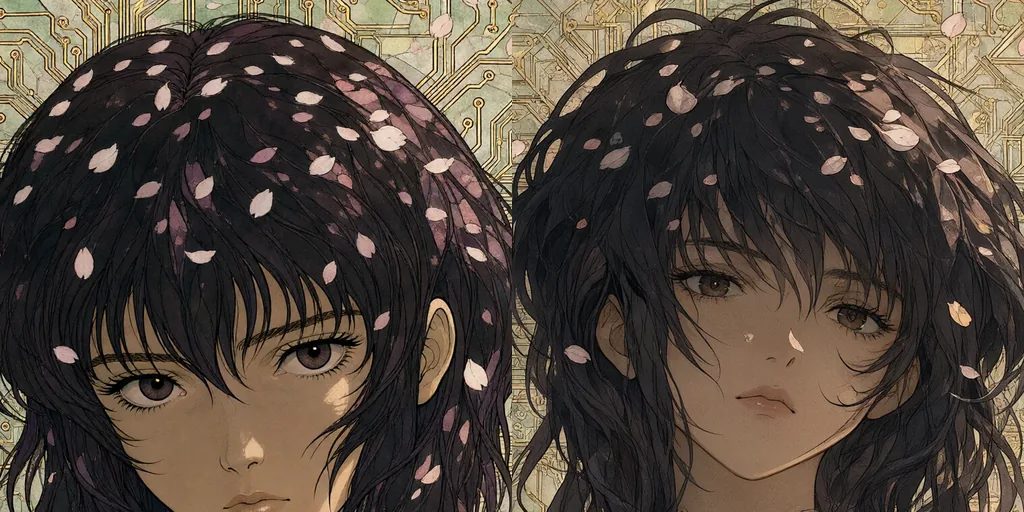
Een guidance boven 1 kost een tweede pass per step, dus CFG 1 is twee keer zo snel. Op de testkaart is dat 120 tot 135 seconden tegenover 255 tot 275 voor een afbeelding van 4 megapixel. De langzamere was bij elk van de tien testparen de moeite waard.
Resolutie en steps: wat het beeld verandert
Zoals elk diffusiemodel schaalt Qwen-Image 2.1 de afbeelding niet als het formaat verandert. Het levert een andere take van dezelfde seed op, dus een seed die op 1 megapixel is gevonden, gaat niet mee naar 2K.
Van 1 megapixel naar 2,5 of 4 gaan gaf in elk getest paar een ander beeld. Tussen 2,5 en 4 megapixel hield de compositie stand in acht van de tien paren.
In de illustratie hieronder verschoven alleen de details. Op 2,5 megapixel verhuisden de printbanen van de aureool naar het haar.
Het aantal steps veranderen verandert het beeld ook zodra het verschil groot is. 20 en 25 steps geven vrijwel hetzelfde beeld. 16 steps drijft af. Er is dus geen manier om op 1 megapixel een preview te maken en hetzelfde beeld groter te renderen. Kies eerst het formaat, dan de seed.
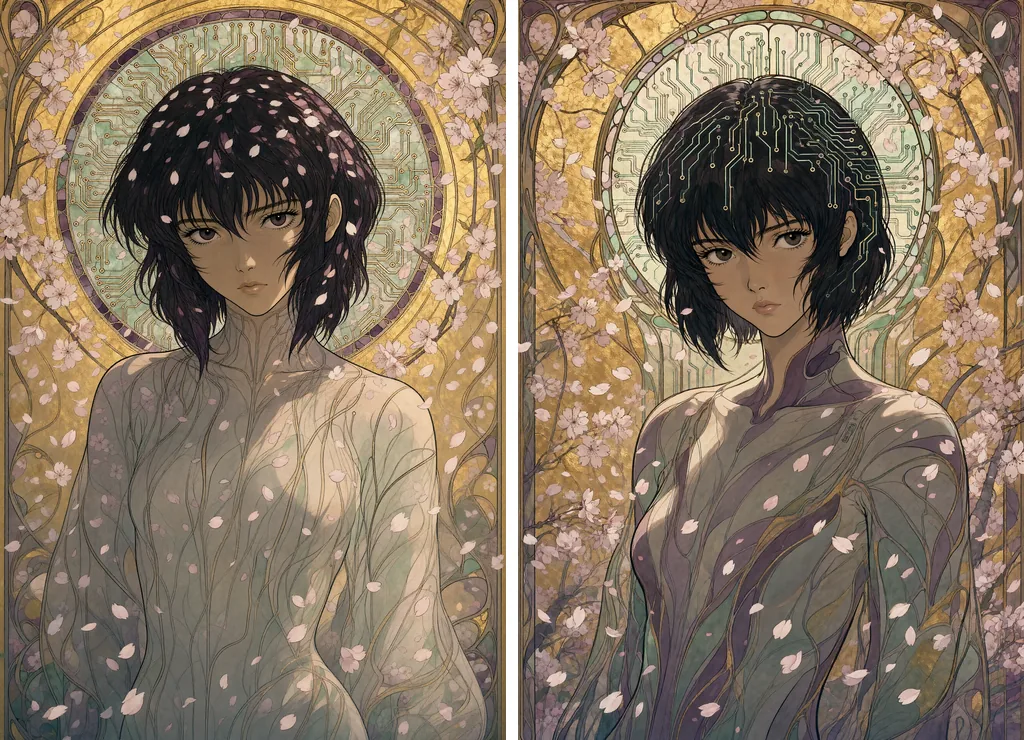
Tijden gemeten met CFG 3, APG en FreSca, int8-gewichten, op één consumentenkaart van 16 GB, in liggend formaat of het staande equivalent:
| Formaat | Steps | Tijd per afbeelding |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | ongeveer 40 s |
| 2,5 megapixel (1920 × 1312) | 20 | 120 tot 135 s |
| 4 megapixel (2432 × 1664) | 20 | 255 tot 275 s |
| 4 megapixel | 25 | 315 tot 335 s |
Op 2,5 megapixel is het detail iets zachter dan op 4 als je hetzelfde gebied op 100% vergelijkt. Maar het model volgt de stijl van de prompt minstens even goed, en op de tien testparen soms beter. Een borduurwerk liet zijn steken op 2,5 megapixel duidelijker zien dan op 4.
Voor een galerij die op 1024 pixels wordt getoond, is 2,5 megapixel op 20 steps de beste keuze. Voor een afdruk, 4 megapixel op 20 steps.
Versnellingen: Turbo, Turbo met guidance en de rest
De Turbo. Qwen bracht Qwen-Image-2.1-Turbo uit op 9 oktober 2026. Het is een gedistilleerd checkpoint dat in 8 steps op CFG 1 draait met een vast sigmaschema. Comfy-Org levert het als int8-bestand en als LoRA voor het basismodel, met eigen templates in ComfyUI. Het is op 17 oktober gemeten op dezelfde tien seeds en formaten als de CFG 3-renders van deze gids, met de exacte graph van het template.
| Instelling | Tijd per afbeelding |
|---|---|
| Turbo-checkpoint, 8 steps, CFG 1, 1 megapixel | 9 tot 10 s |
| Turbo-checkpoint, 8 steps, CFG 1, 4 megapixel | 38 tot 39 s |
| Turbo met guidance, hieronder beschreven: Turbo-checkpoint, 8 steps, CFG 3 met APG en FreSca, 4 megapixel | 66 tot 71 s |
| Basischeckpoint plus Turbo LoRA, 8 steps, CFG 1, 4 megapixel | 52 tot 55 s |
| Basischeckpoint, CFG 3, 20 steps, 4 megapixel | 255 tot 275 s |
Zeven keer sneller op 4 megapixel, vier keer op 1. De afbeeldingen zijn schoon: scherp, goed belicht, geen anatomiefouten op de tien seeds, tekst goed bij dezelfde prompts als het basismodel. De objecten uit de prompt zijn er, soms beter dan bij het basismodel. De schildpad in haar raceauto, die het basismodel in elke render had weggelaten, verscheen met Turbo.
Wat verloren gaat, is het medium. Bij elke niet-fotografische prompt van de tien seeds dreef het gedistilleerde model af naar fotografisch realisme. Een borduurwerk van een krokodil werd een foto van een krokodil. Een houtskooltekening verloor haar korrel. Een Marvin the Martian in papierknipwerk werd een vinyl speelgoedfiguur. Verzonnen letters op gevels zijn dezelfde als bij het basismodel.
Op de tien seeds gaf de LoRA op het basischeckpoint dezelfde afbeeldingen als het Turbo-checkpoint, alleen langzamer. Het checkpoint is dus wat je moet downloaden. Een seed geeft een ander beeld dan bij het basismodel, zoals bij elke verandering van formaat. De licentie is dezelfde: alleen onderzoek en evaluatie.
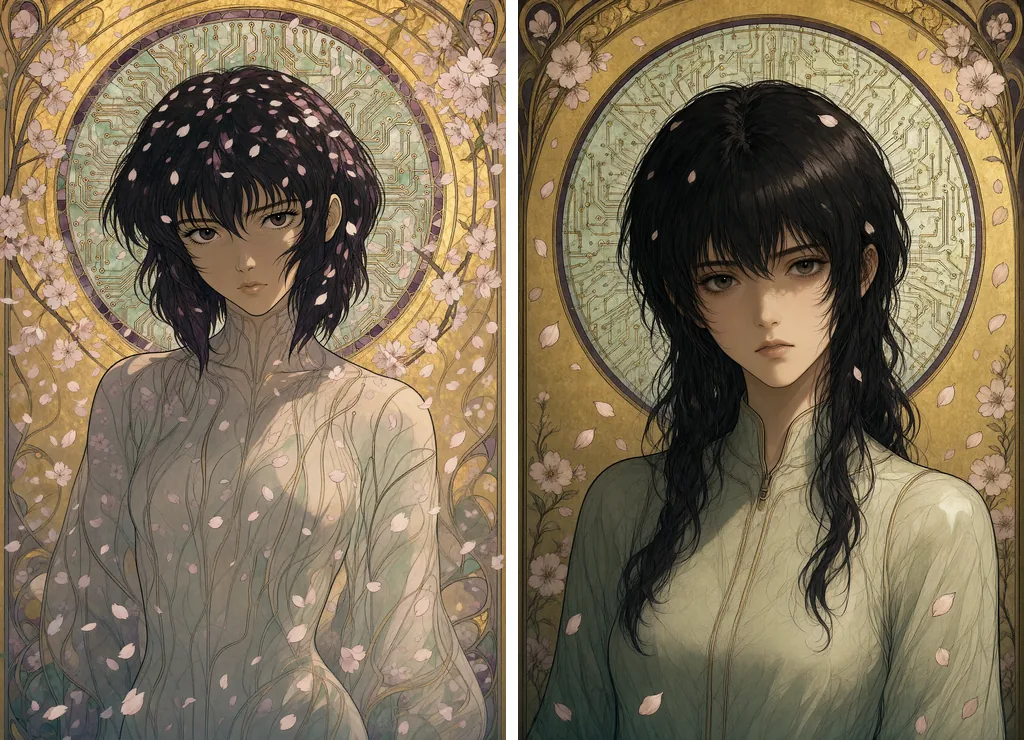
De Turbo met guidance. De Turbo zit niet vast op CFG 1. Getest op 17 oktober 2026 op dezelfde tien seeds plus de illustratie van deze gids. Houd zijn checkpoint en zijn 8 vaste sigma's, en neem alleen het guidance-blok van de basisinstelling over: CFG 3, de negatieve prompt, APG en daarna FreSca.
De graph is het Turbo-template zelf. Zet zijn CFGGuider op 3 in plaats van 1, vul de negatieve prompt in, en voeg APG en daarna FreSca in op het modelpad tussen de loader en de guider. De ManualSigmas-node en de sampler blijven zoals ze zijn.
Het resultaat houdt de compositie van de Turbo en haalt terug wat CFG 1 had afgevlakt: contrast, verzadiging en fijn detail. Op de illustratie van deze gids komen de printbanen van de aureool scherp en verguld terug, en de bloesemblaadjes keren terug. Op de tien testseeds worden de schubben, de vacht en het geborduurde vest op dezelfde manier scherper. Wat het niet terughaalt, is het medium. Het borduurwerk blijft een foto van een krokodil.
De prijs is de tweede pass per step: 66 tot 71 seconden voor een afbeelding van 4 megapixel tegenover 38 tot 39. Dat is nog steeds bijna vier keer sneller dan het basismodel.
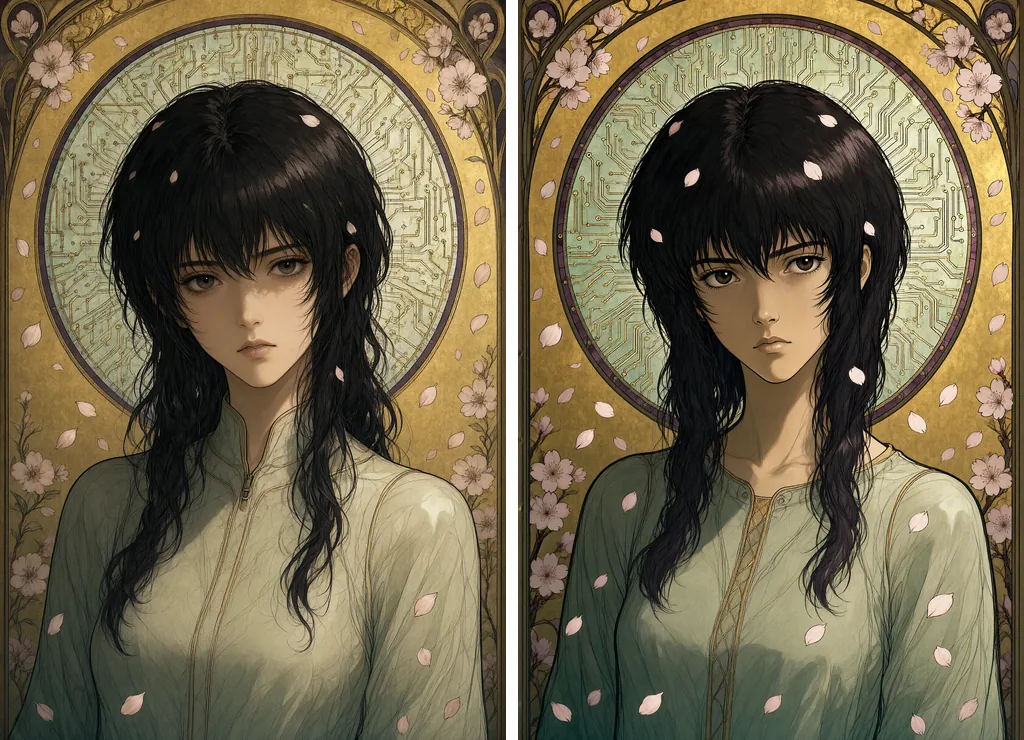
Download de workflow. De ComfyUI-workflow van de Turbo met guidance (JSON) rendert deze illustratie precies zo: 1664 × 2432, seed 57658043, CFG 3 met APG en FreSca, de negatieve prompt van deze gids. Sleep het bestand in ComfyUI; het verwacht de drie modelbestanden die in de laatste sectie staan. Vrij te hergebruiken onder CC BY 4.0, met een link naar deze pagina.
Probeer de Turbo niet te helpen met meer steps. Met 20 steps en de scheduler simple op 4 megapixel en CFG 3, alsof het het basismodel was, slaat hij door: harde haarlokken, een korrelige aureool, opgevoerd contrast. En het duurt 169 seconden. Het gedistilleerde checkpoint wil zijn 8 sigma's.
Een verstandige verdeling. De gewone Turbo als kladmodus, met zeven keer meer kandidaten per uur om uit te kiezen. De Turbo met guidance als een fotografische of strak getekende prompt snel detail nodig heeft. Het basismodel op CFG 3 voor alles wat geschilderd, getekend of met de hand gemaakt is, waar het medium zelf de kern is.
Andere distillaties. LightX2V publiceerde op 13 oktober 2026 een 4-step Lightning LoRA voor 2.1. Er bestaat ook een 8-step LoRA uit de community, Turbo8. Beide draaien op CFG 1, net als de Turbo. Geen van beide is hier gemeten.
De prefix-cache-node. De QwenImage21Cache-node van ComfyUI stelt alleen het apparaat en de precisie in van de cache die het model toch al bijhoudt. Met zijn standaardwaarden verandert hij niets. Zijn int8-modus halveert de cache, wat helpt als het geheugen krap wordt in 2K of bij het bewerken met meerdere referentieafbeeldingen. In deze tests gaf dat geen zichtbaar verlies.
Minder steps. 16 steps bespaart ongeveer een vijfde van de tijd, maar verandert de compositie en wint geen scherpte ten opzichte van 20. Als tijd de beperking is, verlaag dan eerst het formaat en dan pas de steps.
Qwen-Image 2.1 lokaal draaien
ComfyUI ondersteunt het model native. Drie bestanden gaan in de gebruikelijke mappen: het diffusiemodel in diffusion_models, de Qwen3-VL-tekstencoder in text_encoders, de VAE in vae.
Neem op een kaart van 16 GB de int8-versies die Comfy-Org publiceert. De bf16-gewichten werken ook, maar lopen over in het systeemgeheugen en doen er twee tot zes keer langer over zonder zichtbare winst.
De graph is kort:
- UNETLoader, CLIPLoader met het type
qwen_image, VAELoader; - TextEncodeQwenImage21, die de prompt en de negatieve prompt samen aanneemt en beide conditionings uitgeeft;
- een lege latent op het gekozen formaat;
- APG en daarna FreSca op het modelpad;
- een KSampler op CFG 3 met euler en de scheduler simple, dan VAEDecode.
Voor een transparante afbeelding verpak je het onderwerp in de vorm die de model card aanbeveelt: "This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent." Sla daarna op als PNG.
Geheugen: op 1 megapixel draaien het int8-model, de encoder en de VAE in 16 GB zonder het systeemgeheugen aan te spreken. ComfyUI haalt de encoder uit het videogeheugen zodra de prompt is gecodeerd. Op 4 megapixel stond de prefix-cache op int8, en het geheugen raakte nooit op. De eerste afbeelding van een sessie duurt langer terwijl de bestanden laden.