Qwen-Image 2.1 คืออะไร
Qwen-Image 2.1 เป็น checkpoint เดียวสำหรับสองงาน มันสร้างภาพจากข้อความ และแก้ไขภาพที่มีอยู่จากประโยคเดียวบวกภาพอ้างอิงได้ถึงสิบภาพ ส่วนที่ใช้สร้างภาพคือ diffusion transformer ขนาด 7 พันล้านพารามิเตอร์ จับคู่กับ text encoder Qwen3-VL 8B ซึ่งโหลดใน ComfyUI เป็นไฟล์แยกต่างหาก
การใช้โมเดลภาษาเป็น encoder คือสิ่งที่ทำให้มันอ่านทั้งประโยค คำสั่งจัดวาง และคำในเครื่องหมายคำพูดได้ แทนที่จะเป็นรายการคีย์เวิร์ด
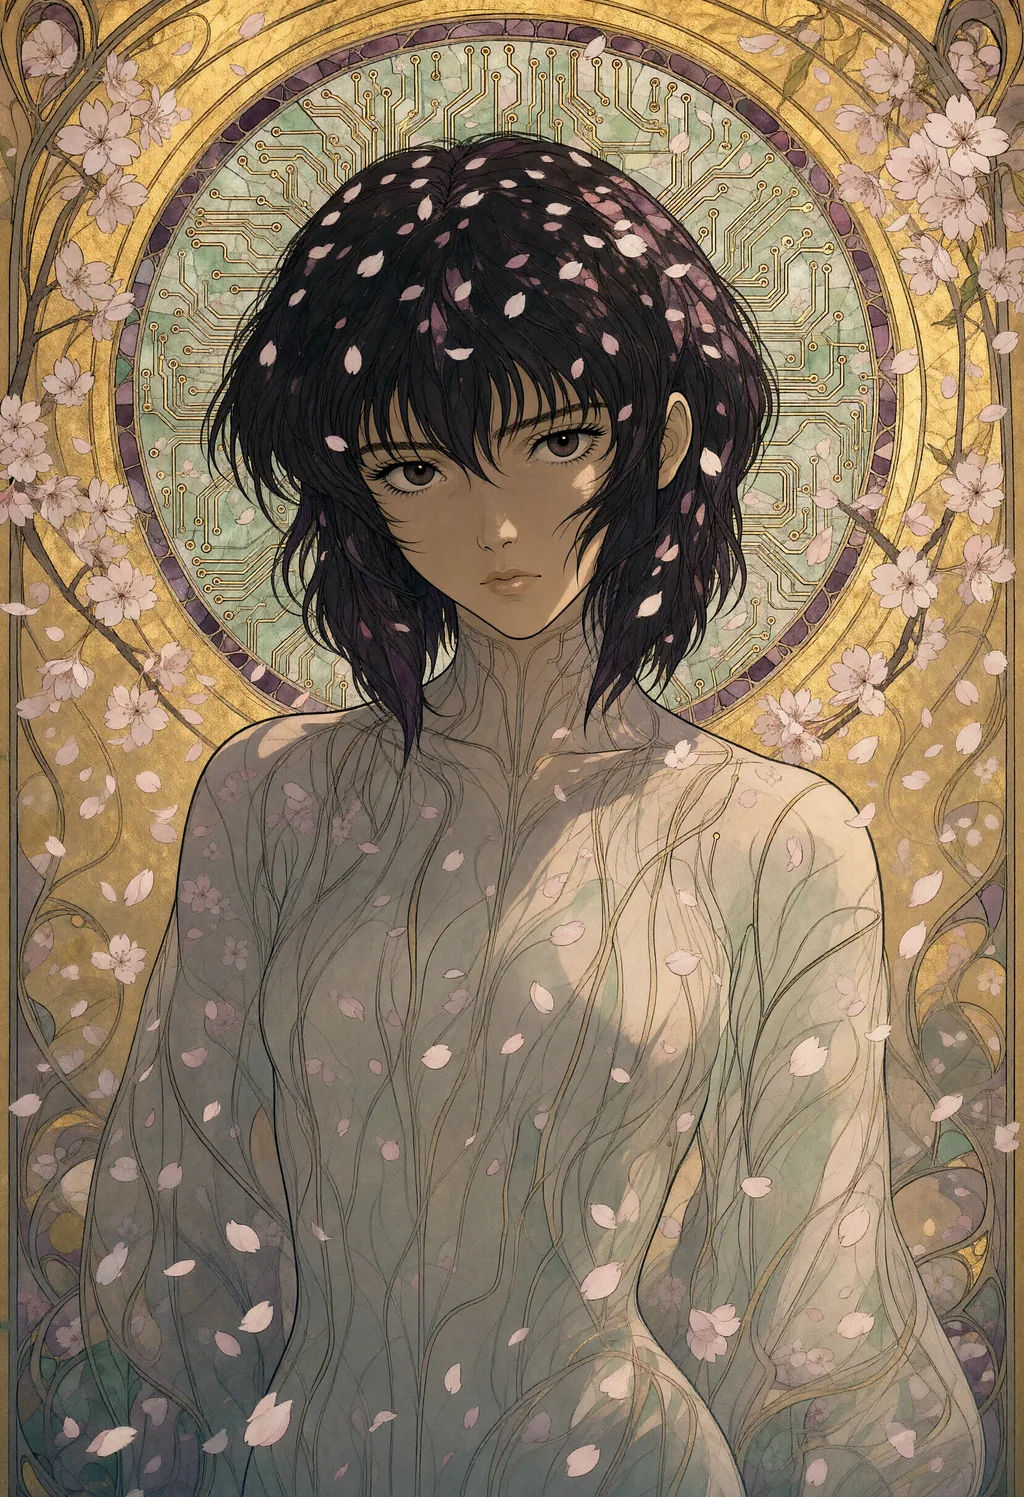
Qwen นำเสนอ 2.1 ว่าดีขึ้นเรื่องพื้นผิว ตัวอักษร และแสงในภาพบุคคล มันทำงานที่ 2K แบบ native โดยไม่ต้องอัปสเกล: 2048 × 2048 สำหรับจัตุรัส, 2528 × 1696 สำหรับ 3:2, 2752 × 1536 สำหรับ 16:9 นอกจากนี้ยังส่งออก alpha channel จริงได้เมื่อ prompt ขอพื้นหลังโปร่งใส
ราคาที่ต้องจ่ายคือเวลา บนการ์ดจอทั่วไปที่มีหน่วยความจำ 16 GB weights แบบ int8 ใช้เวลาราว 40 วินาทีสำหรับภาพ 1 ล้านพิกเซล ภาพ 4 ล้านพิกเซลใช้เวลาราวสี่นาทีครึ่งด้วยการตั้งค่าด้านล่าง
เรื่องหนึ่งที่ควรรู้ก่อนดาวน์โหลด weights อยู่ภายใต้ Qwen Research License: ใช้เพื่อการวิจัยและประเมินผลเท่านั้น การใช้เชิงพาณิชย์ใด ๆ ต้องขอใบอนุญาตแยกจาก Qwen ส่วน Qwen-Image รุ่นแรกที่ออกเมื่อสิงหาคม 2025 ใช้ Apache 2.0 แต่เวอร์ชัน 2.1 ไม่ใช่
วิธีเขียน prompt ให้ Qwen-Image 2.1
เขียนเป็นประโยค ไม่ใช่แท็ก text encoder เป็นโมเดลภาษา มันอ่านลำดับคำ คำบุพบท และเครื่องหมายคำพูด และตีความทุกอย่างตามตัวอักษร "lighthouse cat" จะกลายเป็นแมวที่วาดอยู่บนประภาคาร
โครงสร้างด้านล่างให้ผลดีที่สุดจากภาพราวหนึ่งพันภาพ รักษาลำดับนี้ไว้
- สื่อและตัวแบบมาก่อน: "An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms" สื่อที่กำหนดไว้ตอนต้นจะย้อมทุกอย่างที่ตามมา
- ฉาก: สถานที่ ยุคสมัย สภาพอากาศ หรือสิ่งที่ลอยอยู่ในอากาศ "in falling cherry blossoms", "in the 1980s", "during a blizzard"
- แสงพร้อมทิศทาง: "lit from the front by soft diffuse light, with gentle shadows" ทิศทางจะถูกทำตาม แต่ "dramatic light" ลอย ๆ จะไม่
- การจัดเฟรม: "close-up of the subject, looking at the viewer", medium shot, มองจากด้านบน, ตัวแบบเล็กจิ๋วในทิวทัศน์กว้างใหญ่
- วัสดุและโทนสี: "flowing ink lines, flat gold leaf background, muted jade and plum" นี่คือสิ่งที่โมเดลเรนเดอร์ได้ดีที่สุดที่ 2K
- ข้อห้าม เขียนไว้ใน prompt: "no lettering, no watermark", "five fingers on each hand" ที่ guidance 1 negative prompt จะถูกมองข้าม prompt จึงต้องแบกข้อห้ามเหล่านี้เอง
prompt ทั้งหมดของภาพประกอบด้านบน ตามลำดับนี้: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
ตัวอักษรจะได้ผลเมื่อใส่เครื่องหมายคำพูดและระบุตำแหน่ง "A banner above the door reads 'OPEN ALL NIGHT'" ออกมาถูกต้องเกือบทุกครั้ง จะเป็นตัวพิมพ์ใหญ่หรือไม่ก็ตาม
ในทางกลับกันก็จริงเช่นกัน หน้าร้าน ร้านอาหาร หรือร้านเกมที่ไม่ได้ขอตัวอักษรจะงอกป้ายที่แต่งขึ้นเอง ดังนั้นให้ใส่ "no lettering" ทุกครั้งที่ฉากมีด้านหน้าอาคาร
ตัวละครที่โมเดลไม่รู้จักจะถูกแทนด้วยตัวที่หน้าตาคล้ายกัน โดยไม่เตือน Marsupilami กลายเป็นลิง ส่วน Mothra และ Marvin the Martian ออกมาถูกต้อง
การ์ด Qwen ทุกใบในหน้าตัวอย่าง prompt ใช้โครงสร้างนี้ พร้อม seed ขนาด และการตั้งค่า
การตั้งค่าที่ได้ผล วัดจริง
เทมเพลตทางการของ ComfyUI รันที่ guidance (CFG) 1 กับ 25 step ส่วน model card ใช้ 40 step การตั้งค่าด้านล่างลงตัวที่ CFG 3
ทดสอบล่าสุดเมื่อ 16 ตุลาคม 2026 บน seed ชุดเดิม การตั้งค่าเหล่านี้ให้ภาพที่ละเอียดที่สุดและตรงกับ prompt ที่สุด:
| การตั้งค่า | ค่า |
|---|---|
| Guidance (CFG) | 3 พร้อม negative prompt |
| Negative prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Model patch | APG (eta 1, norm threshold 10, momentum 0.3) ตามด้วย FreSca (low 1, high 2, cutoff 8) ก่อนถึง sampler |
| Sampler | euler, scheduler แบบ simple |
| Step | 25 ที่ 1 ล้านพิกเซล, 20 ที่ 2.5 และ 4 ล้านพิกเซล |
| LoRA | ไม่ใช้ |
guidance เป็นค่าเดียวที่ไม่เปลี่ยนฉาก ที่ seed และขนาดเดียวกัน CFG 1 กับ CFG 3 ให้องค์ประกอบแทบเหมือนกัน สิ่งที่ต่างคือการเรนเดอร์
ที่ CFG 1 ภาพแบนกว่าและเสียพื้นผิวละเอียด ฝีเข็มของงานปักกลายเป็นผ้า หน้าการ์ตูนเสียรูม่านตาและปาก โลหะเสียหมุดย้ำ
ดัน CFG 1 ไป 30 step ได้ความคมกลับมา แต่ไม่ได้วัสดุและคอนทราสต์ ที่ 2 ล้านพิกเซล ซึ่งเป็นขนาดที่ลองครั้งเดียว 40 step ให้ภาพสะอาดแต่ยังแบนกว่า และอ่าน prompt ได้แม่นยำน้อยลง
APG กัน CFG 3 ไม่ให้สีจัดเกิน FreSca เพิ่มความคมของความถี่สูง ทั้งคู่ทำงานเฉพาะเมื่อ guidance สูงกว่า 1
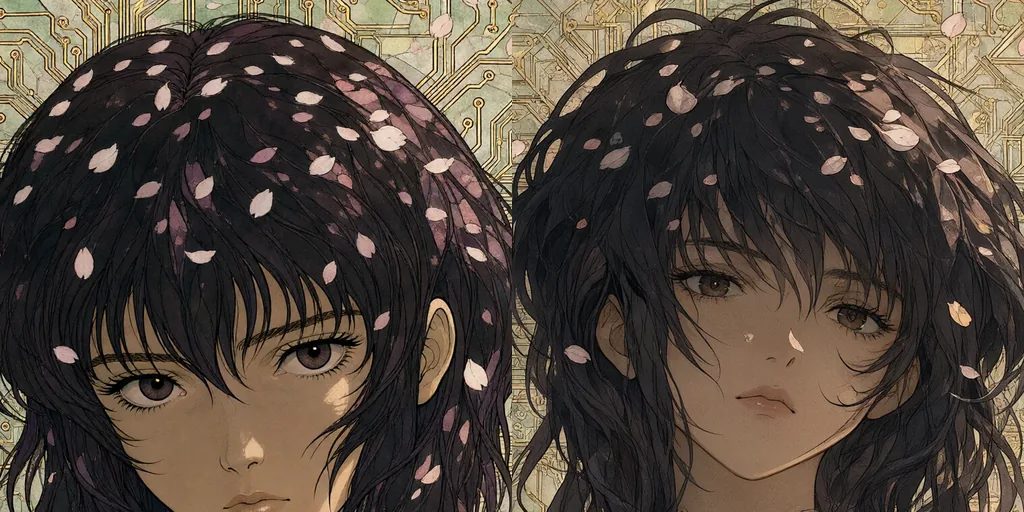
guidance ที่สูงกว่า 1 ต้องจ่ายด้วยการคำนวณรอบที่สองในทุก step CFG 1 จึงเร็วกว่าสองเท่า บนการ์ดที่ใช้ทดสอบคือ 120 ถึง 135 วินาที เทียบกับ 255 ถึง 275 สำหรับภาพ 4 ล้านพิกเซล แบบช้ากว่าคุ้มค่าในทุกคู่จากสิบคู่ทดสอบ
ความละเอียดและ step: อะไรเปลี่ยนภาพ
เช่นเดียวกับโมเดล diffusion ทุกตัว Qwen-Image 2.1 ไม่ได้ย่อขยายภาพเมื่อเปลี่ยนขนาด แต่ให้เทคใหม่ของ seed เดิม ดังนั้น seed ที่หาได้ที่ 1 ล้านพิกเซลจึงใช้ต่อที่ 2K ไม่ได้
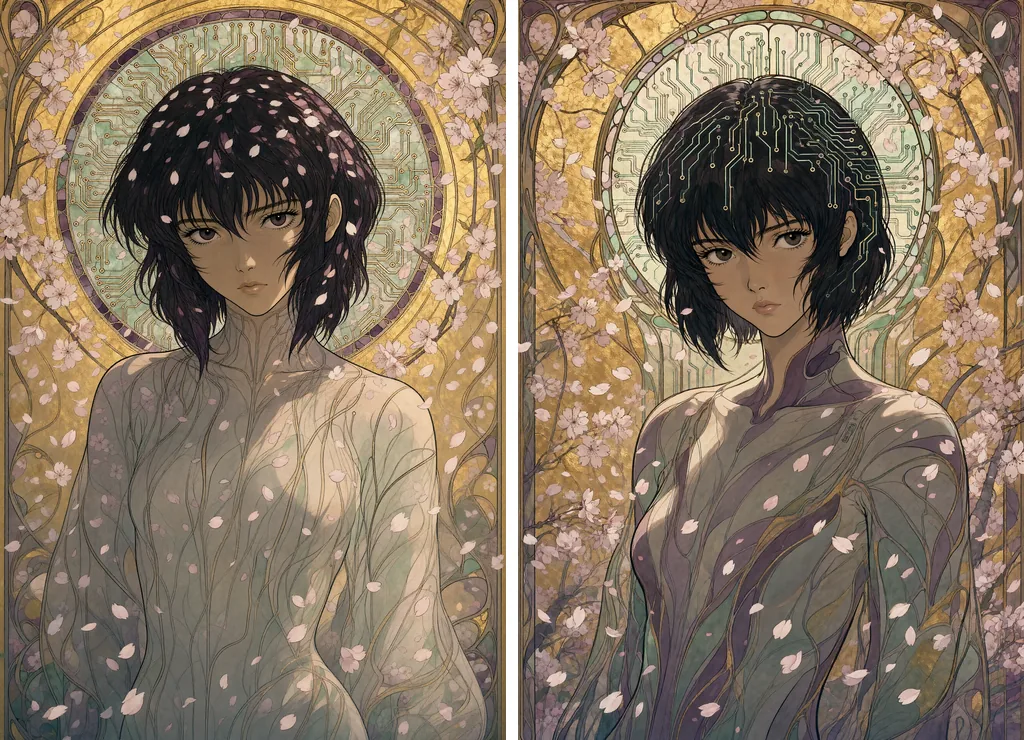
การไปจาก 1 ล้านพิกเซลเป็น 2.5 หรือ 4 ให้ภาพคนละภาพในทุกคู่ที่ทดสอบ ระหว่าง 2.5 กับ 4 ล้านพิกเซล องค์ประกอบคงอยู่แปดคู่จากสิบ
ในภาพประกอบด้านล่าง มีเพียงรายละเอียดที่ขยับ ที่ 2.5 ล้านพิกเซล ลายเส้นวงจรย้ายจากรัศมีไปอยู่ที่เส้นผม
การเปลี่ยนจำนวน step ก็เปลี่ยนภาพเช่นกันเมื่อช่วงห่างมากพอ 20 กับ 25 step ให้ภาพแทบเหมือนกัน 16 step เพี้ยนไป จึงไม่มีทางพรีวิวที่ 1 ล้านพิกเซลแล้วเรนเดอร์ภาพเดิมให้ใหญ่ขึ้น เลือกขนาดก่อน แล้วค่อยเลือก seed
เวลาที่วัดด้วย CFG 3, APG และ FreSca, weights แบบ int8 บนการ์ดจอทั่วไป 16 GB หนึ่งใบ ในแนวนอนหรือแนวตั้งที่เทียบเท่ากัน:
| ขนาด | Step | เวลาต่อภาพ |
|---|---|---|
| 1 ล้านพิกเซล (1216 × 832) | 25 | ราว 40 วินาที |
| 2.5 ล้านพิกเซล (1920 × 1312) | 20 | 120 ถึง 135 วินาที |
| 4 ล้านพิกเซล (2432 × 1664) | 20 | 255 ถึง 275 วินาที |
| 4 ล้านพิกเซล | 25 | 315 ถึง 335 วินาที |
ที่ 2.5 ล้านพิกเซล รายละเอียดนุ่มกว่าที่ 4 เล็กน้อยเมื่อเทียบบริเวณเดียวกันที่ 100 % แต่โมเดลทำตามสไตล์ของ prompt ได้ดีอย่างน้อยเท่ากัน และในสิบคู่ทดสอบบางครั้งดีกว่า งานปักชิ้นหนึ่งแสดงฝีเข็มชัดกว่าที่ 2.5 ล้านพิกเซลเมื่อเทียบกับที่ 4
สำหรับแกลเลอรีที่แสดงผลที่ 1024 พิกเซล 2.5 ล้านพิกเซลที่ 20 step คือจุดที่ลงตัวที่สุด สำหรับงานพิมพ์ 4 ล้านพิกเซลที่ 20 step
ตัวเร่งความเร็ว: Turbo, Turbo แบบมี guidance และอื่น ๆ
Turbo Qwen ปล่อย Qwen-Image-2.1-Turbo เมื่อ 9 ตุลาคม 2026 เป็น checkpoint ที่ distill แล้ว รันใน 8 step ที่ CFG 1 ด้วย sigma schedule คงที่ Comfy-Org เผยแพร่เป็นไฟล์ int8 และเป็น LoRA สำหรับโมเดลฐาน พร้อมเทมเพลตของตัวเองใน ComfyUI วัดเมื่อ 17 ตุลาคม บน seed และขนาดสิบชุดเดียวกับการเรนเดอร์ CFG 3 ของคู่มือนี้ ด้วยกราฟตามเทมเพลตเป๊ะ
| การตั้งค่า | เวลาต่อภาพ |
|---|---|
| checkpoint Turbo, 8 step, CFG 1, 1 ล้านพิกเซล | 9 ถึง 10 วินาที |
| checkpoint Turbo, 8 step, CFG 1, 4 ล้านพิกเซล | 38 ถึง 39 วินาที |
| Turbo แบบมี guidance ตามที่อธิบายด้านล่าง: checkpoint Turbo, 8 step, CFG 3 พร้อม APG และ FreSca, 4 ล้านพิกเซล | 66 ถึง 71 วินาที |
| checkpoint ฐานบวก Turbo LoRA, 8 step, CFG 1, 4 ล้านพิกเซล | 52 ถึง 55 วินาที |
| checkpoint ฐาน, CFG 3, 20 step, 4 ล้านพิกเซล | 255 ถึง 275 วินาที |
เร็วขึ้นเจ็ดเท่าที่ 4 ล้านพิกเซล สี่เท่าที่ 1 ภาพสะอาด: คม แสงดี ไม่มีกายวิภาคพลาดบนสิบ seed ตัวอักษรถูกต้องบน prompt ชุดเดียวกับโมเดลฐาน วัตถุใน prompt อยู่ครบ บางครั้งดีกว่าโมเดลฐานด้วยซ้ำ เต่าในรถแข่งของมัน ซึ่งโมเดลฐานทำหล่นหายในทุกการเรนเดอร์ ปรากฏขึ้นมากับ Turbo
สิ่งที่เสียไปคือสื่อ ในทุก prompt ที่ไม่ใช่แนวภาพถ่ายจากสิบ seed โมเดลที่ distill แล้วเอนไปทางภาพถ่ายสมจริง งานปักรูปจระเข้กลายเป็นภาพถ่ายจระเข้ ภาพวาดถ่านเสียเกรน Marvin the Martian แบบกระดาษตัดกลายเป็นของเล่นไวนิล ตัวอักษรที่แต่งขึ้นบนด้านหน้าอาคารเหมือนกับโมเดลฐาน
บนสิบ seed LoRA บน checkpoint ฐานให้ภาพเดียวกับ checkpoint Turbo เพียงแต่ช้ากว่า checkpoint จึงเป็นตัวที่ควรดาวน์โหลด seed เดิมให้ภาพต่างจากโมเดลฐาน เหมือนทุกครั้งที่เปลี่ยนขนาด ใบอนุญาตเหมือนเดิม: วิจัยและประเมินผลเท่านั้น
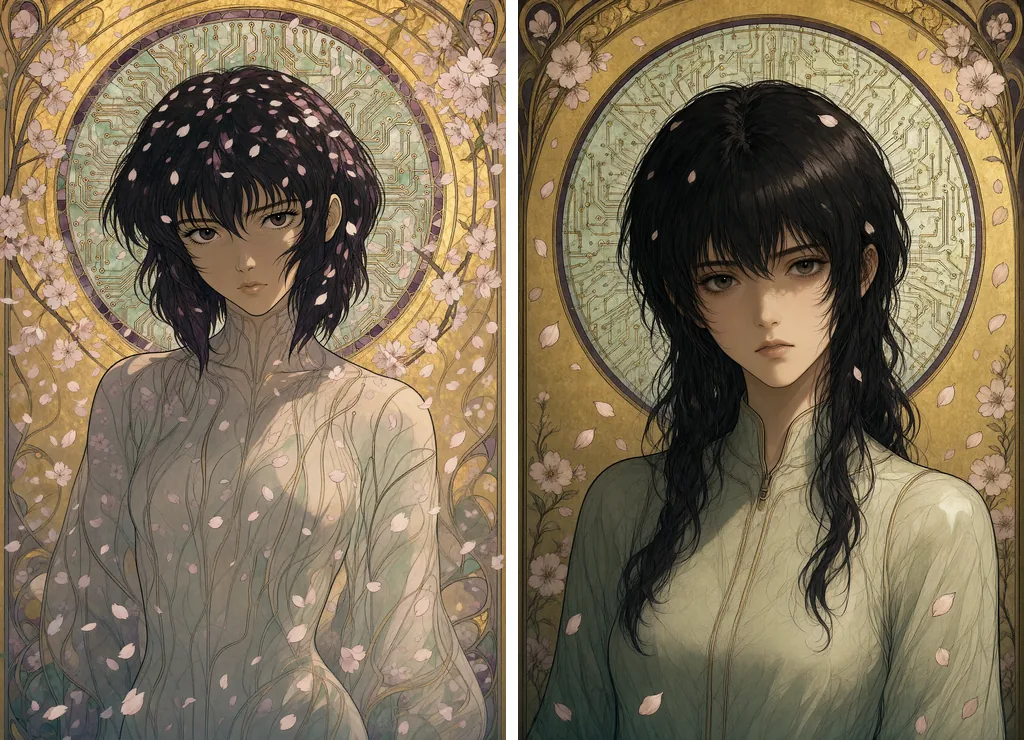
Turbo แบบมี guidance Turbo ไม่ได้ถูกล็อกไว้ที่ CFG 1 ทดสอบเมื่อ 17 ตุลาคม 2026 บนสิบ seed ชุดเดิมบวกภาพประกอบของคู่มือนี้ คง checkpoint และ sigma คงที่ 8 ค่าของมันไว้ แล้วหยิบเฉพาะบล็อก guidance จากค่าพื้นฐาน: CFG 3, negative prompt, APG ตามด้วย FreSca
กราฟคือเทมเพลต Turbo นั่นเอง ตั้ง CFGGuider ของมันเป็น 3 แทน 1 ใส่ negative prompt และแทรก APG ตามด้วย FreSca บนเส้นทางของโมเดลระหว่าง loader กับ guider โหนด ManualSigmas และ sampler คงไว้ตามเดิม
ผลลัพธ์คงองค์ประกอบของ Turbo และได้สิ่งที่ CFG 1 ทำให้แบนกลับคืนมา: คอนทราสต์ ความอิ่มสี และรายละเอียดเล็ก ๆ ในภาพประกอบของคู่มือนี้ ลายเส้นวงจรของรัศมีกลับมาคมและเป็นสีทอง และกลีบดอกกลับมา บนสิบ seed ทดสอบ เกล็ด ขน และเสื้อกั๊กปักคมขึ้นในแบบเดียวกัน สิ่งที่ไม่ได้กลับคืนมาคือสื่อ งานปักยังคงเป็นภาพถ่ายจระเข้
ราคาคือการคำนวณรอบที่สองในทุก step: 66 ถึง 71 วินาทีสำหรับภาพ 4 ล้านพิกเซล เทียบกับ 38 ถึง 39 ซึ่งยังเร็วกว่าโมเดลฐานเกือบสี่เท่า
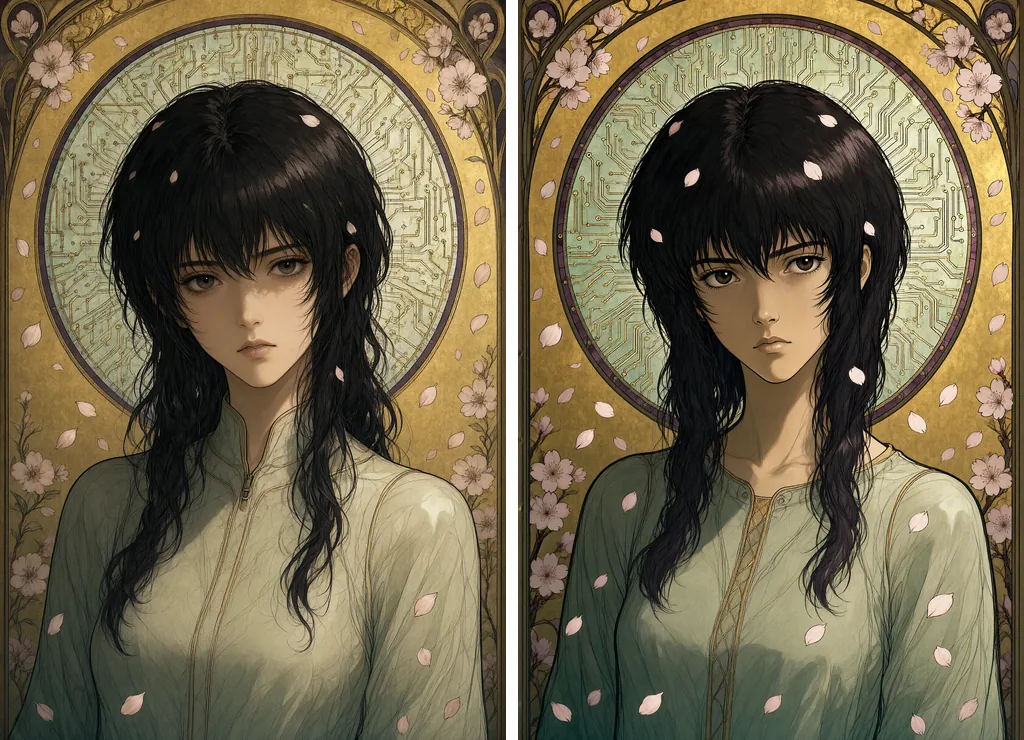
ดาวน์โหลด workflow workflow ComfyUI ของ Turbo แบบมี guidance (JSON) เรนเดอร์ภาพประกอบนี้ออกมาตามเดิมทุกประการ: 1664 × 2432, seed 57658043, CFG 3 พร้อม APG และ FreSca, negative prompt ของคู่มือนี้ ลากไฟล์วางใน ComfyUI ได้เลย มันต้องการไฟล์โมเดลสามไฟล์ที่ระบุไว้ในส่วนสุดท้าย นำไปใช้ซ้ำได้โดยเสรีภายใต้ CC BY 4.0 โดยใส่ลิงก์มายังหน้านี้
อย่าพยายามช่วย Turbo ด้วย step ที่มากขึ้น เมื่อให้ 20 step กับ scheduler แบบ simple ที่ 4 ล้านพิกเซลและ CFG 3 ราวกับเป็นโมเดลฐาน มันจะสุกเกิน: เส้นผมแข็ง รัศมีเป็นเกรน คอนทราสต์จัดเกิน และใช้เวลา 169 วินาที checkpoint ที่ distill แล้วต้องการ sigma 8 ค่าของมัน
การแบ่งงานที่สมเหตุสมผล Turbo ธรรมดาเป็นโหมดร่าง ได้ตัวเลือกต่อชั่วโมงมากขึ้นเจ็ดเท่าไว้คัด Turbo แบบมี guidance เมื่อ prompt แนวภาพถ่ายหรือลายเส้นสะอาดต้องการรายละเอียดอย่างรวดเร็ว โมเดลฐานที่ CFG 3 สำหรับทุกอย่างที่เป็นภาพวาด ภาพสเก็ตช์ หรืองานฝีมือ ที่ตัวสื่อเองคือหัวใจ
การ distill อื่น ๆ LightX2V เผยแพร่ Lightning LoRA แบบ 4 step สำหรับ 2.1 เมื่อ 13 ตุลาคม 2026 ยังมี LoRA แบบ 8 step จากชุมชนชื่อ Turbo8 ด้วย ทั้งคู่รันที่ CFG 1 เหมือน Turbo ทั้งคู่ยังไม่ได้วัดที่นี่
โหนด prefix cache โหนด QwenImage21Cache ของ ComfyUI แค่กำหนดอุปกรณ์และความละเอียดเชิงตัวเลขของ cache ที่โมเดลเก็บอยู่แล้ว ที่ค่าเริ่มต้นมันไม่เปลี่ยนอะไรเลย โหมด int8 ของมันลด cache ลงครึ่งหนึ่ง ซึ่งช่วยได้เมื่อหน่วยความจำไม่พอที่ 2K หรือตอนแก้ไขภาพด้วยภาพอ้างอิงหลายภาพ ไม่พบความสูญเสียที่มองเห็นได้ในการทดสอบเหล่านี้
step น้อยลง 16 step ประหยัดเวลาราวหนึ่งในห้า แต่เปลี่ยนองค์ประกอบและไม่ได้คมขึ้นกว่า 20 ถ้าเวลาคือข้อจำกัด ลดขนาดก่อนลด step
รัน Qwen-Image 2.1 ในเครื่อง
ComfyUI รองรับโมเดลนี้แบบ native ไฟล์สามไฟล์ไปอยู่ในโฟลเดอร์ตามปกติ: โมเดล diffusion ใน diffusion_models, text encoder Qwen3-VL ใน text_encoders, VAE ใน vae
บนการ์ด 16 GB ให้ใช้เวอร์ชัน int8 ที่ Comfy-Org เผยแพร่ weights แบบ bf16 ก็ใช้ได้ แต่ล้นไปใช้หน่วยความจำระบบ และใช้เวลานานกว่าสองถึงหกเท่าโดยไม่ได้อะไรที่มองเห็นได้เพิ่ม
กราฟสั้น:
- UNETLoader, CLIPLoader ชนิด
qwen_image, VAELoader - TextEncodeQwenImage21 ซึ่งรับ prompt และ negative prompt พร้อมกันและส่งออก conditioning ทั้งสอง
- latent ว่างขนาดที่เลือก
- APG ตามด้วย FreSca บนเส้นทางของโมเดล
- KSampler ที่ CFG 3 กับ euler และ scheduler แบบ simple จากนั้น VAEDecode
สำหรับภาพโปร่งใส ให้ครอบตัวแบบด้วยรูปแบบที่ model card แนะนำ: "This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent." แล้วบันทึกเป็น PNG
หน่วยความจำ: ที่ 1 ล้านพิกเซล โมเดล int8, encoder และ VAE รันใน 16 GB โดยไม่แตะหน่วยความจำระบบ ComfyUI สลับ encoder ออกจากหน่วยความจำวิดีโอทันทีที่เข้ารหัส prompt เสร็จ ที่ 4 ล้านพิกเซล prefix cache ถูกตั้งเป็น int8 และหน่วยความจำไม่เคยหมด ภาพแรกของแต่ละเซสชันใช้เวลานานกว่าระหว่างโหลดไฟล์