O que é o Qwen-Image 2.1
O Qwen-Image 2.1 é um único checkpoint para duas tarefas. Ele gera uma imagem a partir de texto, e edita uma imagem existente a partir de uma frase e de até dez imagens de referência. A parte de geração é um transformer de difusão de 7 bilhões de parâmetros. Ela vem combinada com um codificador de texto Qwen3-VL 8B, carregado no ComfyUI como um arquivo separado.
Um modelo de linguagem como codificador é o que permite ler frases inteiras, instruções de composição e palavras entre aspas, em vez de listas de palavras-chave.
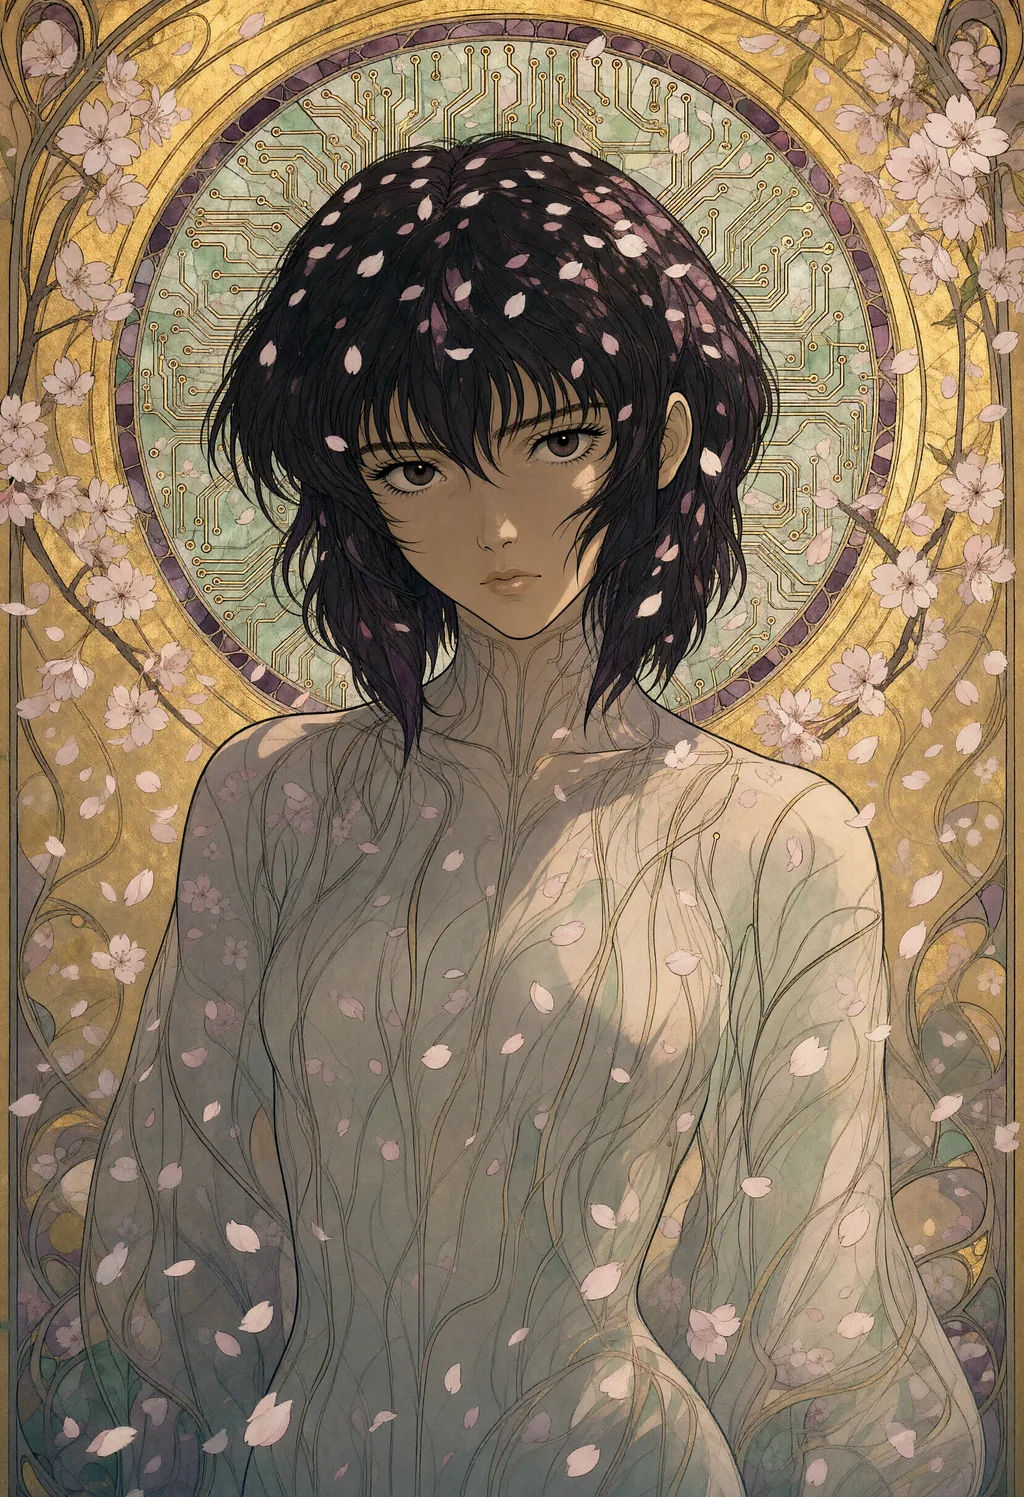
A Qwen apresenta o 2.1 como melhor em texturas, tipografia e iluminação de retratos. Ele trabalha em 2K nativo sem upscaler: 2048 × 2048 no quadrado, 2528 × 1696 em 3:2, 2752 × 1536 em 16:9. Também pode gerar um canal alfa de verdade quando o prompt pede um fundo transparente.
O preço é o tempo. Em uma placa doméstica com 16 GB de memória de vídeo, os pesos int8 levam cerca de 40 segundos para uma imagem de 1 megapixel. Uma imagem de 4 megapixels leva cerca de quatro minutos e meio com as configurações abaixo.
Uma coisa para saber antes de baixar. Os pesos estão sob a Qwen Research License: só pesquisa e avaliação. Qualquer uso comercial exige uma licença separada da Qwen. O primeiro Qwen-Image, lançado em agosto de 2025, era Apache 2.0. A versão 2.1 não é.
Como escrever um prompt para o Qwen-Image 2.1
Escreva frases, não tags. O codificador de texto é um modelo de linguagem. Ele lê a ordem das palavras, as preposições e as aspas, e leva tudo ao pé da letra. Um “lighthouse cat” vira um gato desenhado em um farol.
A estrutura abaixo deu os melhores resultados ao longo de cerca de mil imagens. Mantenha esta ordem.
- Técnica e assunto primeiro: “An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. A técnica definida no início colore tudo o que vem depois.
- Cenário: lugar, época, clima, ou o que enche o ar. “in falling cherry blossoms”, “in the 1980s”, “during a blizzard”.
- Luz com a direção: “lit from the front by soft diffuse light, with gentle shadows”. A direção é respeitada. Um simples “dramatic light” não é.
- Enquadramento: “close-up of the subject, looking at the viewer”, plano médio, visto de cima, o assunto minúsculo em uma paisagem imensa.
- Materiais e paleta: “flowing ink lines, flat gold leaf background, muted jade and plum”. É o que o modelo renderiza melhor em 2K.
- Restrições, escritas no prompt: “no lettering, no watermark”, “five fingers on each hand”. Com guidance 1 o prompt negativo é ignorado. Então o próprio prompt precisa carregá-las.
O prompt inteiro da ilustração acima, nessa ordem: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Texto funciona quando vem entre aspas e com lugar definido. “A banner above the door reads 'OPEN ALL NIGHT'” sai certo quase sempre, em maiúsculas ou não.
O inverso também vale. Uma fachada de loja, um diner ou um fliperama sem texto pedido ganham um letreiro inventado. Então escreva “no lettering” sempre que a cena tiver uma fachada.
Personagens que o modelo não conhece são trocados por um sósia sem aviso. O Marsupilami virou um macaco. Mothra e Marvin the Martian saíram certos.
Todo card Qwen da página de exemplos de prompts segue essa estrutura, com seed, tamanho e configurações.
Configurações que funcionam, medidas
O template oficial do ComfyUI roda com guidance (CFG) 1 e 25 passos. O model card usa 40 passos. As configurações abaixo ficaram em CFG 3.
No último teste, em 16 de outubro de 2026, com as mesmas seeds, estas configurações deram as imagens mais detalhadas e mais fiéis:
| Configuração | Valor |
|---|---|
| Guidance (CFG) | 3, com prompt negativo |
| Prompt negativo | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Patches do modelo | APG (eta 1, norm threshold 10, momentum 0,3) e depois FreSca (low 1, high 2, cutoff 8), antes do sampler |
| Sampler | euler, scheduler simple |
| Passos | 25 em 1 megapixel, 20 em 2,5 e 4 megapixels |
| LoRA | nenhum |
O guidance é a única configuração que não muda a cena. Com a mesma seed e o mesmo tamanho, CFG 1 e CFG 3 dão quase a mesma composição. O que difere é o acabamento.
Em CFG 1 a imagem é mais chapada e perde a textura fina. Os pontos de um bordado viram tecido. Um rosto de desenho animado perde as pupilas e a boca. O metal perde os rebites.
Levar o CFG 1 a 30 passos devolve a nitidez, mas não os materiais nem o contraste. Em 2 megapixels, um tamanho testado uma vez, 40 passos dão uma imagem limpa, mas ainda assim mais chapada, e ele lê o prompt com menos confiabilidade.
O APG impede o CFG 3 de saturar demais. O FreSca realça as altas frequências. Os dois só agem quando o guidance está acima de 1.
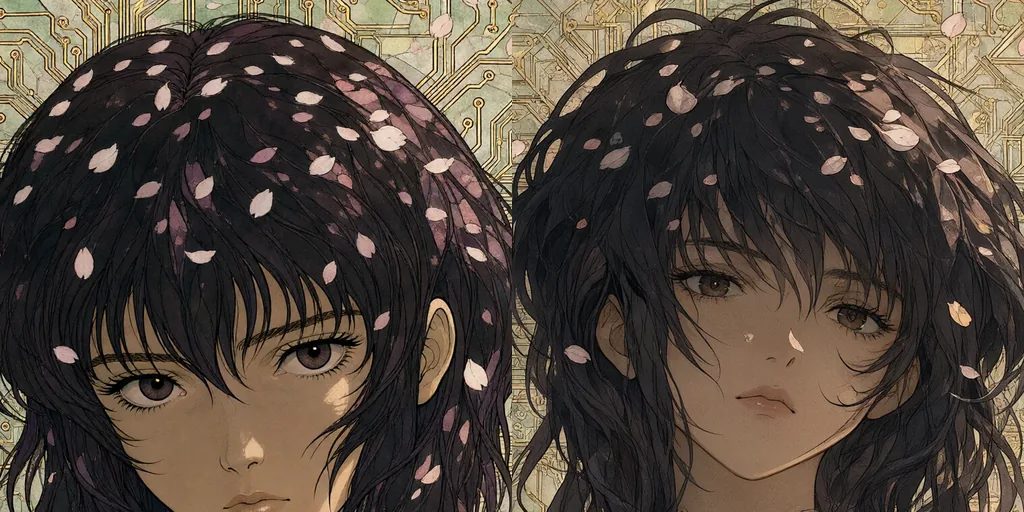
Um guidance acima de 1 custa uma segunda passada por passo, então o CFG 1 é duas vezes mais rápido. Na placa de teste, são de 120 a 135 segundos contra 255 a 275 para uma imagem de 4 megapixels. A versão lenta valeu a pena em cada um dos dez pares de teste.
Resolução e passos: o que muda a imagem
Como qualquer modelo de difusão, o Qwen-Image 2.1 não redimensiona a imagem quando o tamanho muda. Produz outra versão da mesma seed, então uma seed encontrada em 1 megapixel não se transfere para 2K.
Passar de 1 megapixel para 2,5 ou 4 deu uma imagem diferente em todos os pares testados. Entre 2,5 e 4 megapixels a composição se manteve em oito pares de dez.
Na ilustração abaixo só os detalhes mudaram. Em 2,5 megapixels as trilhas de circuito saíram do halo e foram para o cabelo.
Mudar o número de passos também muda a imagem quando a diferença é grande. 20 e 25 passos dão quase a mesma imagem. Com 16 passos, a imagem se afasta. Então não há como pré-visualizar em 1 megapixel e renderizar a mesma imagem maior. Escolha o tamanho primeiro, depois a seed.
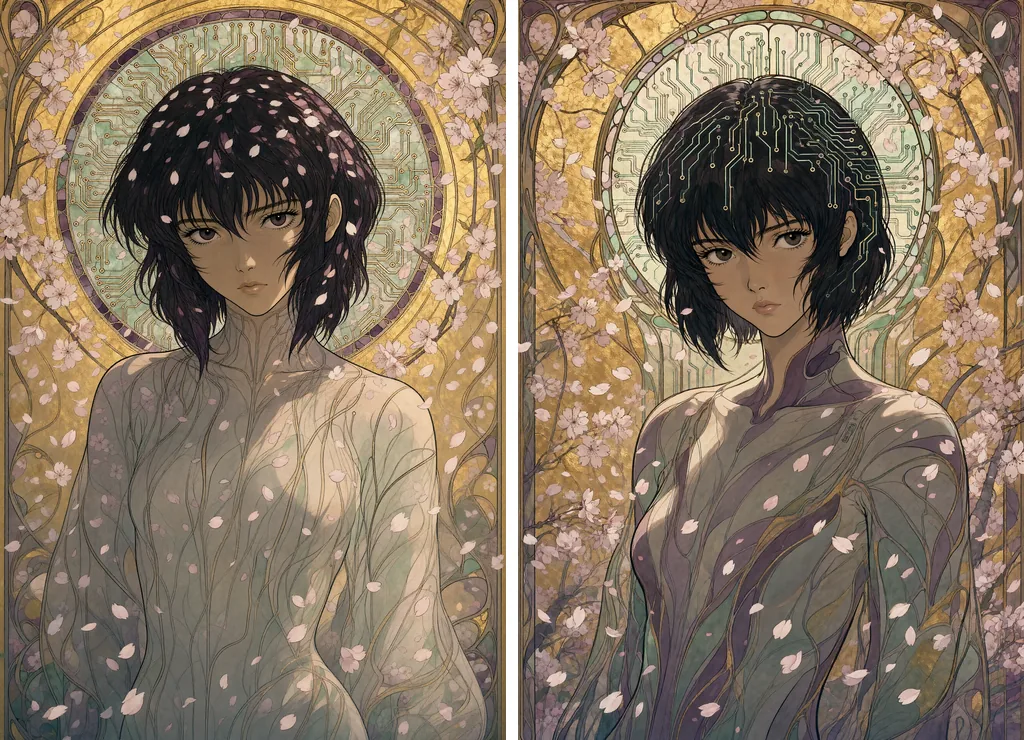
Tempos medidos com CFG 3, APG e FreSca, pesos int8, em uma única placa doméstica de 16 GB, em paisagem ou no equivalente em retrato:
| Tamanho | Passos | Tempo por imagem |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | cerca de 40 s |
| 2,5 megapixels (1920 × 1312) | 20 | 120 a 135 s |
| 4 megapixels (2432 × 1664) | 20 | 255 a 275 s |
| 4 megapixels | 25 | 315 a 335 s |
Em 2,5 megapixels o detalhe é um pouco mais suave do que em 4 quando se compara a mesma área a 100%. Mas o modelo segue o estilo do prompt pelo menos tão bem, e nos dez pares de teste às vezes melhor. Um bordado mostrou os pontos com mais clareza em 2,5 megapixels do que em 4.
Para uma galeria servida em 1024 pixels, 2,5 megapixels a 20 passos é o ponto ideal. Para impressão, 4 megapixels a 20 passos.
Acelerar: Turbo, Turbo guiado e o resto
O Turbo. A Qwen lançou o Qwen-Image-2.1-Turbo em 9 de outubro de 2026. É um checkpoint destilado que roda em 8 passos com CFG 1 e uma sequência fixa de sigmas. A Comfy-Org o distribui como arquivo int8 e como LoRA para o modelo base, com templates próprios no ComfyUI. Ele foi medido em 17 de outubro nas mesmas dez seeds e tamanhos dos renders em CFG 3 deste guia, com o grafo exato do template.
| Configuração | Tempo por imagem |
|---|---|
| Checkpoint Turbo, 8 passos, CFG 1, 1 megapixel | 9 a 10 s |
| Checkpoint Turbo, 8 passos, CFG 1, 4 megapixels | 38 a 39 s |
| Turbo guiado, descrito abaixo: checkpoint Turbo, 8 passos, CFG 3 com APG e FreSca, 4 megapixels | 66 a 71 s |
| Checkpoint base mais LoRA Turbo, 8 passos, CFG 1, 4 megapixels | 52 a 55 s |
| Checkpoint base, CFG 3, 20 passos, 4 megapixels | 255 a 275 s |
Sete vezes mais rápido em 4 megapixels, quatro vezes em 1. As imagens são limpas: nítidas, bem iluminadas, sem escorregões de anatomia nas dez seeds, texto certo nos mesmos prompts que o modelo base. Os objetos do prompt estão lá, às vezes melhor do que com o modelo base. A tartaruga no carro de corrida, que o modelo base tinha deixado de fora em todos os renders, apareceu com o Turbo.
O que ele perde é a técnica. Em todos os prompts não fotográficos das dez seeds, o modelo destilado escorregou para o realismo fotográfico. Um bordado de crocodilo virou uma fotografia de crocodilo. Um desenho a carvão perdeu o grão. Um Marvin the Martian em papel recortado virou um boneco de vinil. Os letreiros inventados nas fachadas são os mesmos do modelo base.
Nas dez seeds, o LoRA sobre o checkpoint base deu as mesmas imagens que o checkpoint Turbo, só que mais devagar. Então o checkpoint é o que vale baixar. Uma seed dá uma imagem diferente da do modelo base, como em qualquer mudança de tamanho. A licença é a mesma: só pesquisa e avaliação.
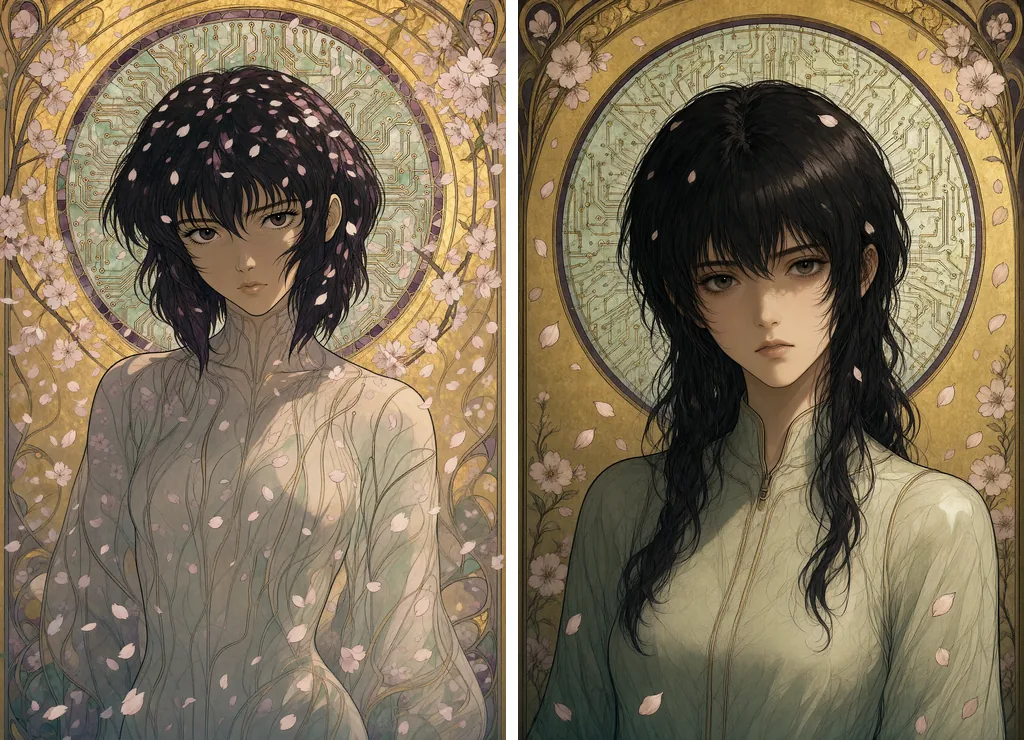
O Turbo guiado. O Turbo não está preso ao CFG 1. Testado em 17 de outubro de 2026 nas mesmas dez seeds mais a ilustração deste guia. Mantenha o checkpoint dele e seus 8 sigmas fixos, e pegue só o bloco de guidance do preset base: CFG 3, o prompt negativo, APG e depois FreSca.
O grafo é o próprio template Turbo. Ajuste o CFGGuider dele para 3 em vez de 1, preencha o prompt negativo e insira APG e depois FreSca no caminho do modelo entre o loader e o guider. O nó ManualSigmas e o sampler ficam como estão.
O resultado mantém a composição do Turbo e recupera o que o CFG 1 tinha achatado: contraste, saturação e detalhe fino. Na ilustração deste guia, as trilhas de circuito do halo voltam nítidas e douradas, e as pétalas reaparecem. Nas dez seeds de teste, as escamas, o pelo e o colete bordado ganham nitidez do mesmo jeito. O que ele não recupera é a técnica. O bordado continua uma fotografia de crocodilo.
O custo é a segunda passada por passo: 66 a 71 segundos para uma imagem de 4 megapixels contra 38 a 39. Ainda é quase quatro vezes mais rápido que o modelo base.
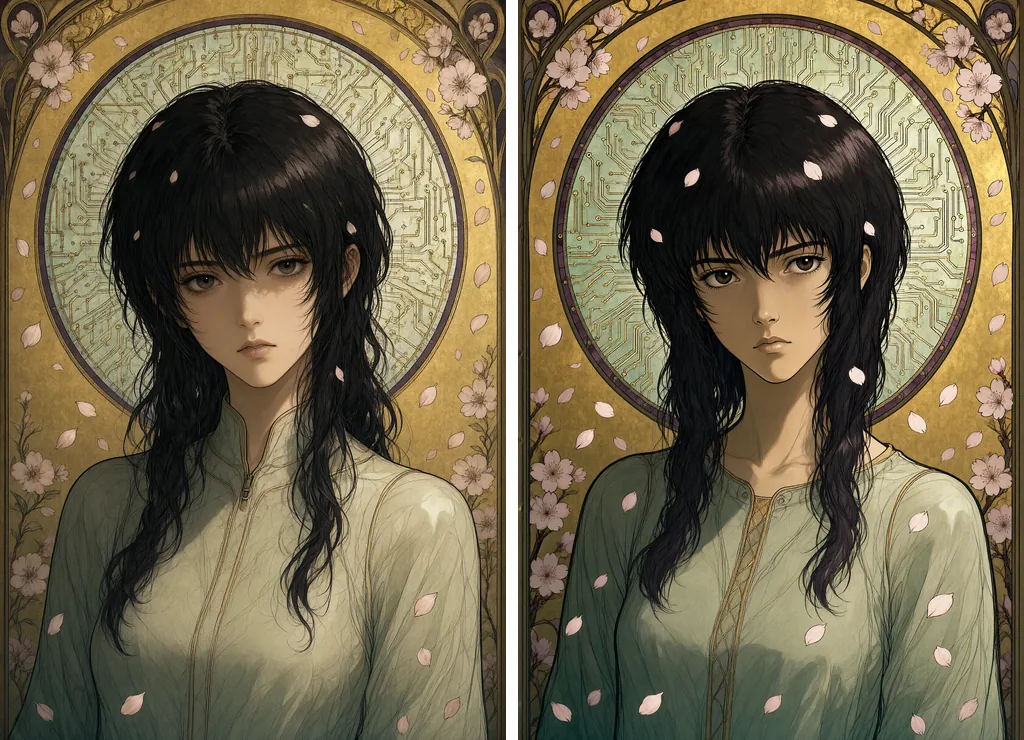
Baixe o workflow. O workflow do ComfyUI do Turbo guiado (JSON) renderiza esta ilustração exatamente assim: 1664 × 2432, seed 57658043, CFG 3 com APG e FreSca, o prompt negativo deste guia. Solte o arquivo no ComfyUI; ele espera os três arquivos de modelo citados na última seção. Livre para reutilizar sob CC BY 4.0, com um link para esta página.
Não tente ajudar o Turbo com mais passos. Com 20 passos e o scheduler simple em 4 megapixels e CFG 3, como se fosse o modelo base, ele passa do ponto: fios de cabelo duros, um halo granulado, contraste forçado. E leva 169 segundos. O checkpoint destilado quer seus 8 sigmas.
Uma divisão sensata. O Turbo puro como modo rascunho, com sete vezes mais candidatas por hora para a triagem. O Turbo guiado quando um prompt fotográfico ou de linhas limpas precisa de detalhe rápido. O modelo base com CFG 3 para tudo o que é pintado, desenhado ou artesanal, onde a própria técnica é o que importa.
Outras destilações. A LightX2V publicou um LoRA Lightning de 4 passos para o 2.1 em 13 de outubro de 2026. Existe também um LoRA da comunidade de 8 passos, o Turbo8. Os dois rodam com CFG 1 como o Turbo. Nenhum dos dois foi medido aqui.
O nó de cache de prefixo. O nó QwenImage21Cache do ComfyUI só define o dispositivo e a precisão do cache que o modelo já mantém. Nos valores padrão, não muda nada. O modo int8 dele reduz o cache pela metade, o que ajuda quando a memória aperta em 2K ou na edição com várias imagens de referência. Nestes testes ele não trouxe nenhuma perda visível.
Menos passos. 16 passos economizam cerca de um quinto do tempo, mas mudam a composição e não ganham nitidez em relação a 20. Se o tempo é a restrição, reduza o tamanho antes dos passos.
Como rodar o Qwen-Image 2.1 localmente
O ComfyUI suporta o modelo nativamente. Três arquivos vão nas pastas de sempre: o modelo de difusão em diffusion_models, o codificador de texto Qwen3-VL em text_encoders, o VAE em vae.
Em uma placa de 16 GB, use as versões int8 publicadas pela Comfy-Org. Os pesos bf16 também funcionam, mas transbordam para a memória do sistema e levam de duas a seis vezes mais tempo sem ganho visível.
O grafo é curto:
- UNETLoader, CLIPLoader com o tipo
qwen_image, VAELoader; - TextEncodeQwenImage21, que recebe o prompt e o prompt negativo juntos e devolve os dois conditionings;
- um latente vazio no tamanho escolhido;
- APG e depois FreSca no caminho do modelo;
- um KSampler com CFG 3, euler e o scheduler simple, depois VAEDecode.
Para uma imagem transparente, envolva o assunto na forma recomendada pelo model card: “This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.” Depois salve em PNG.
Memória: em 1 megapixel, o modelo int8, o codificador e o VAE rodam em 16 GB sem tocar na memória do sistema. O ComfyUI tira o codificador da memória de vídeo assim que o prompt é codificado. Em 4 megapixels o cache de prefixo foi colocado em int8, e a memória nunca acabou. A primeira imagem de uma sessão demora mais enquanto os arquivos carregam.