Stable Diffusion em resumo
O Stable Diffusion é um modelo de difusão latente (LDM) de código aberto: uma rede neural treinada para transformar ruído aleatório em uma imagem, aos poucos, guiada por um texto. Foi criado pelo grupo CompVis da Universidade Ludwig Maximilian de Munique com a Runway, e treinado com o poder de computação da Stability AI sobre imagens coletadas pela organização sem fins lucrativos LAION. O método vem do artigo High-Resolution Image Synthesis with Latent Diffusion Models (Rombach e colegas, CVPR 2022).
Os pesos foram publicados em 22 de agosto de 2022. Foi isso que mudou tudo. O DALL-E 2 e o Midjourney já existiam, mas atrás de listas de espera e créditos, nos servidores de outra pessoa. O Stable Diffusion era um arquivo de 4 GB que rodava em uma placa de vídeo com 8 GB de memória, sem conta e com um filtro de segurança que podia ser desligado.
Em poucas semanas vieram as interfaces web e o inpainting, depois os fine-tunes, os LoRAs e o ControlNet. Quatro anos depois, o nome significa duas coisas. No sentido estrito, a família de modelos da 1.4 à 3.5. No sentido amplo, toda a prática de rodar modelos de imagem na própria máquina.
O que segue explica a máquina em si, com o vocabulário que você vai encontrar em todas as interfaces: espaço latente, VAE, U-Net, CLIP, sampler, guidance scale, seed. Nenhuma fórmula é necessária, mas alguns números ajudam.
Como o Stable Diffusion funciona? Três redes e um loop
O Stable Diffusion não é uma rede, mas três, executadas uma depois da outra.
- Um codificador de texto lê o prompt e o transforma em uma lista de números. No Stable Diffusion 1.5, são 77 tokens, cada um descrito por 768 números; 2.048 no SDXL, que roda dois codificadores.
- Um removedor de ruído, uma U-Net nas versões 1 a XL e um transformer (MMDiT) a partir da versão 3, parte de um bloco de ruído aleatório e o limpa ao longo de 20 a 30 passos, consultando os números do texto a cada passo. Ele não trabalha com pixels, mas com uma versão compacta da imagem, o latente, que vive no que se chama espaço latente: 4 × 64 × 64 números para uma imagem de 512 pixels, 4 × 128 × 128 para os 1024 pixels do SDXL.
- Um decodificador transforma esse latente nos valores finais dos pixels, vermelho, verde e azul: 3 × 512 × 512, ou 3 × 1024 × 1024 no SDXL.
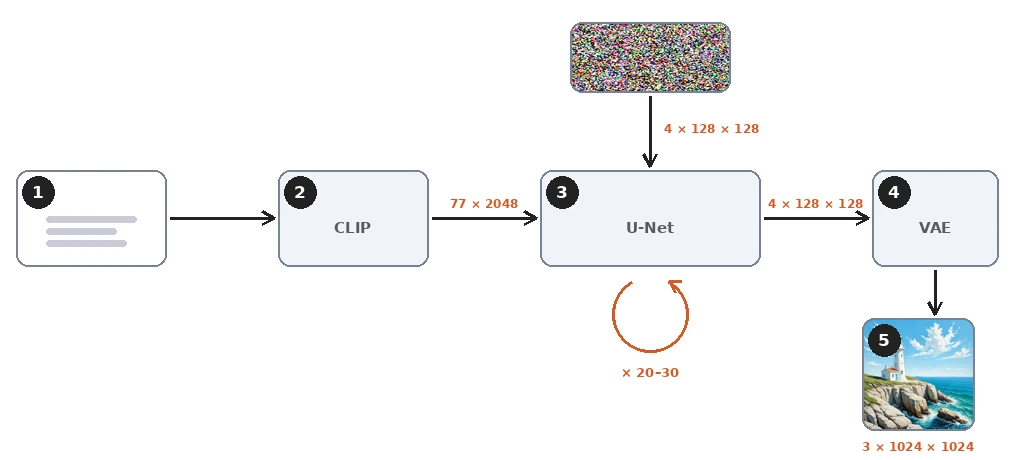
Nada é pesquisado nem copiado no caminho. Não existe banco de dados de imagens dentro do arquivo. Os 2 a 16 GB de pesos guardam o que a rede aprendeu sobre como legendas e imagens se combinam, e cada resultado é calculado a partir do ruído. A rede ainda pode memorizar imagens que apareceram muitas vezes no treinamento, e pesquisadores extraíram algumas centenas delas, mas isso é a exceção.
O que é um modelo de difusão? Aprender a remover ruído
O processo direto: adicionar ruído
A ideia por trás da difusão é simples de enunciar. Pegue uma foto com sua legenda. Adicione a ela uma quantidade medida de ruído aleatório. Peça a uma rede que adivinhe qual ruído foi adicionado, conhecendo a legenda. Compare o palpite com a verdade e corrija a rede um pouco.
Adicionar o ruído é o processo direto. Ele segue um cronograma fixo de mil níveis, de um grão leve no nível 50 até chuvisco puro no nível 999. A rede nunca vê o cronograma inteiro; ela só vê uma imagem com ruído em um nível, uma de cada vez.
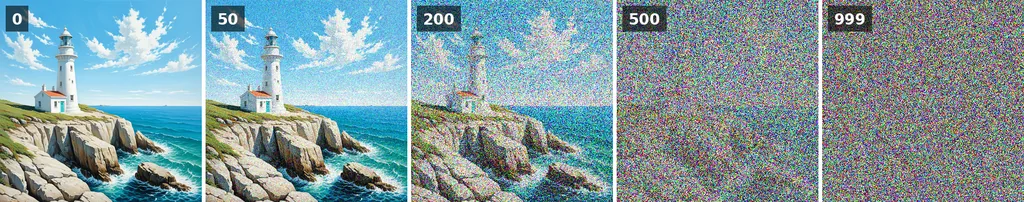
Faça isso com bilhões de exemplos e o resultado é um preditor de ruído: dada uma imagem com ruído, seu nível de ruído e um texto, ele diz qual é provavelmente o ruído. O objetivo do treinamento é só a diferença entre o ruído previsto e o real. Treinar o Stable Diffusion 1 levou cerca de 150.000 horas em GPUs A100 de data center, segundo o model card.
O processo inverso: o preditor de ruído em ação
A geração repete a lição ao contrário. Esse é o processo inverso. Comece de ruído puro, escolhido pela seed. Pergunte ao preditor qual é o ruído, remova uma fração dele, pergunte de novo. O DDPM, o artigo de 2020 que tornou a difusão viável, fazia isso em mil passos pequenos.
O sampler, também chamado de scheduler em algumas interfaces, é a regra que decide o tamanho de cada passo e se um pouco de ruído novo é acrescentado de volta. Samplers melhores, DDIM, Euler e a família DPM++, dão passos maiores pelo mesmo caminho, e é por isso que hoje 20 a 30 passos bastam.
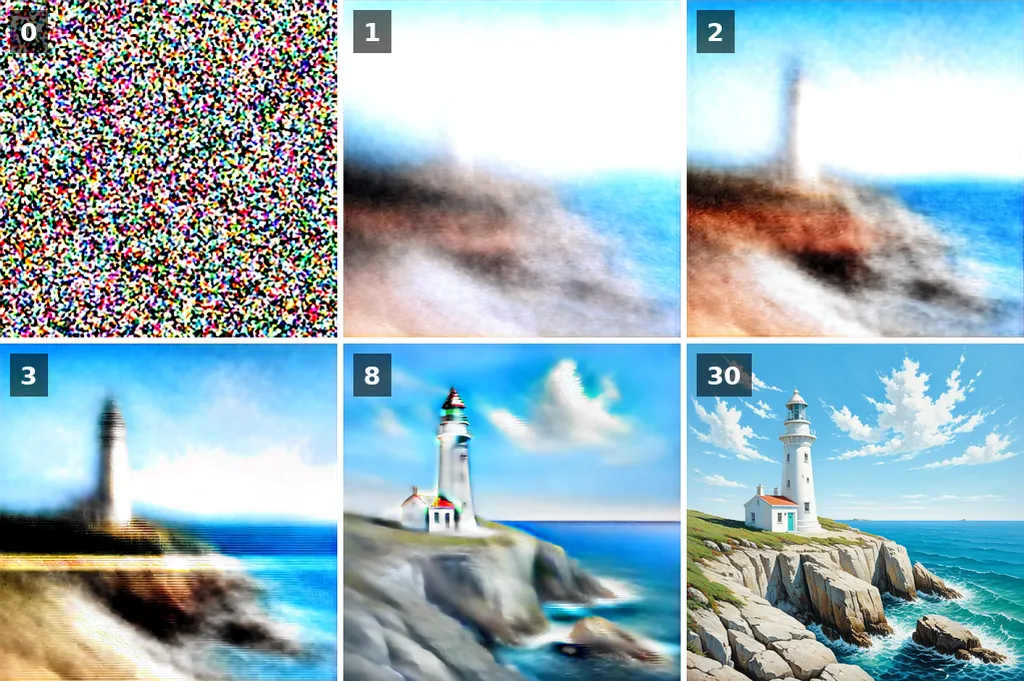
A figura mostra a parte que vale lembrar. A cada passo, o modelo tem uma estimativa da imagem final, e essa estimativa se define cedo. Os dois ou três primeiros passos, enquanto o ruído ainda é pesado, fixam a composição: onde fica o horizonte, onde está o farol, quanto céu há. Os passos seguintes refinam a textura e os detalhes pequenos.
O controle deslizante abaixo percorre todas as trinta estimativas do mesmo render.
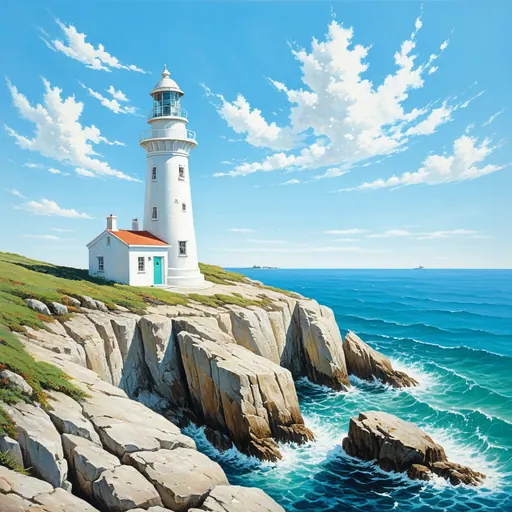
Duas consequências práticas decorrem disso. Mudar o número de passos muda os detalhes e às vezes a composição, porque os primeiros passos caem em outros valores; não se trata apenas de deixar a mesma imagem mais nítida. E a mesma seed em outro tamanho de imagem parte de outro bloco de ruído, então também dá outra imagem. Escolha o tamanho primeiro, depois procure uma seed.
Difusão latente: o truque do VAE que o faz caber em uma placa de vídeo gamer
Os primeiros modelos de difusão trabalhavam com pixels. Uma imagem de 512 × 512 são 786.432 números, e o preditor precisava ler e escrever todos eles em cada um de seus passos. Modelos de pixels como o DALL-E 2 e o Imagen contornaram isso difundindo em 64 pixels e acrescentando redes de upscaling, e de qualquer forma nunca foram lançados.
O Stable Diffusion acrescenta um autoencoder variacional, o VAE. Seu codificador comprime a imagem por um fator de oito em cada lado em quatro canais: 4 × 64 × 64, ou 16.384 números, 48 vezes menos. A difusão roda inteiramente nesse espaço comprimido, o espaço latente. Só no final o decodificador do VAE expande o resultado em pixels.

O latente não é uma imagem pequena. Seus quatro canais são um código que o decodificador sabe ler, e nenhum canal sozinho se parece muito com a imagem. Mas a disposição sobrevive à compressão, e é isso que permite ao removedor de ruído decidir a composição em um espaço tão pequeno.
É também por isso que a escolha do VAE importa para a cor e os detalhes finos: cada número do latente representa um bloco de 8 × 8 pixels, e o decodificador inventa o que há dentro do bloco. O Stable Diffusion 3 passou para um latente de 16 canais exatamente por essa razão, e os detalhes finos e os textos pequenos melhoraram com isso.
CLIP e cross-attention: como o texto guia a imagem
Três peças transformam palavras em uma direção para o removedor de ruído.
Tokenizer e codificador de texto: como o CLIP lê um prompt
O tokenizer corta o prompt em tokens, palavras comuns inteiras ou fragmentos das mais raras. O Stable Diffusion 1.5 e o SDXL leem no máximo 77 tokens, dois deles marcadores de início e fim, cerca de 50 a 60 palavras em inglês. Acima desse limite, o texto é cortado, a menos que a interface o divida em várias passagens. Coloque o que mais importa no começo.
O codificador de texto do 1.5 é o CLIP, uma rede que a OpenAI treinou com 400 milhões de pares de imagens e legendas, com uma única tarefa: aproximar os números que descrevem uma legenda dos números que descrevem sua imagem. Depois desse treinamento, os números de “lighthouse” já carregam a aparência de um farol. O SDXL roda dois codificadores desse tipo lado a lado, o segundo um retreinamento aberto feito pela LAION com dois bilhões de pares. O Stable Diffusion 3 acrescenta um terceiro, o T5, que lê frases inteiras.
Cross-attention dentro da U-Net
A cross-attention, ou atenção cruzada, é onde o texto encontra a imagem. A U-Net é uma pilha de blocos de convolução que encolhem o latente e depois o expandem de volta, com conexões de atalho entre os tamanhos correspondentes. Entre esses blocos ficam camadas de atenção. A cada passo, cada região do latente olha para os 77 vetores de tokens e pesa quais dizem respeito a ela. A região do céu presta atenção em “sunset” e “clouds”, a rocha em “cliff”. É por isso que a ordem das palavras, a repetição e a sintaxe de pesos das interfaces têm efeito, e por isso uma palavra de estilo no começo colore a imagem inteira.
É também o limite das primeiras versões. O CLIP aprendeu com textos alternativos curtos, então entende bem listas de assuntos e estilos e mal as relações entre eles. “A red cube on a blue sphere” muitas vezes sai trocado no 1.5. O guia de prompt mostra o que funciona de forma confiável.
Guidance scale (CFG), prompt negativo e seed: os três ajustes
Três ajustes aparecem em toda interface do Stable Diffusion. Eles correspondem diretamente ao mecanismo descrito acima.
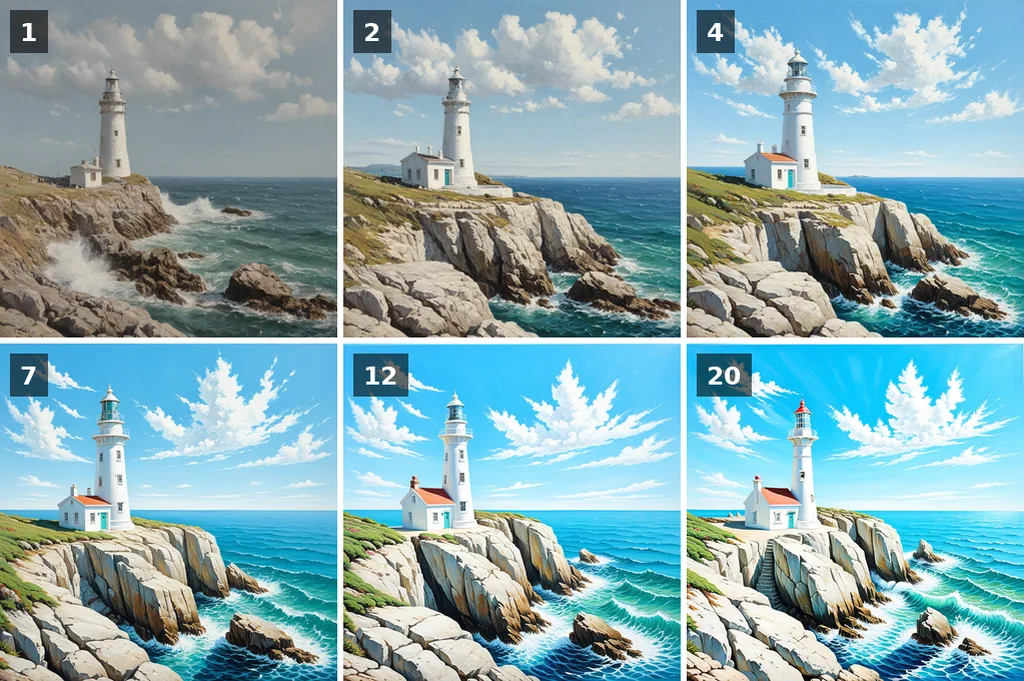
O guidance scale, ou CFG, abrevia a orientação sem classificador (classifier-free guidance): é ele que decide com que força o texto é imposto. A cada passo, o removedor de ruído na verdade faz duas previsões: uma com o prompt e uma com um prompt vazio. A diferença entre as duas é a direção que o prompt dá. A previsão final é a vazia mais essa diferença multiplicada pelo guidance scale. Em 1, a previsão com prompt é usada como está, sem empurrão: a imagem segue o texto de longe, com cores apagadas e um céu cinza onde o prompt pedia um azul. Por volta de 5 a 8, ela segue o prompt de perto, com cores naturais. Acima de 12, o contraste endurece, as cores saturam e as pinceladas ficam ásperas.
O prompt negativo substitui o prompt vazio dessa segunda previsão. Em vez de não ler nada, a segunda passagem lê “blurry, text, watermark”, e a guidance empurra para longe disso. Não custa nada a mais, já que a segunda passagem roda de qualquer forma, e só funciona quando a guidance está acima de 1. O guia de prompt negativo traz listas que funcionam.
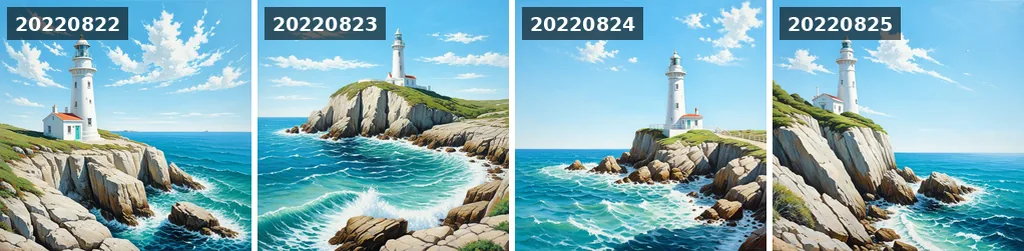
A seed é o número que gera o ruído inicial. Mesma seed, mesmo prompt, mesmos ajustes e mesmo modelo dão a mesma imagem, pixel por pixel, no mesmo software e hardware; outra interface ou outra placa sorteia o ruído de forma diferente. Mude a seed e a composição muda, já que os primeiros passos leem outro bloco de ruído. Mude uma palavra do prompt e mantenha a seed, e a maior parte da imagem em geral se mantém. É assim que se refina um prompt.
Da U-Net ao transformer: as versões de 1.5 a 3.5
Seis gerações principais surgiram em dois anos, as duas primeiras da CompVis e da Runway, as demais da Stability AI. Cada uma mudou pelo menos uma das três redes.
| Versão | Data | Removedor de ruído | Codificadores de texto | Tamanho nativo |
|---|---|---|---|---|
| 1.4 e 1.5 | Agosto e outubro de 2022 | U-Net, 860 milhões de parâmetros | CLIP ViT-L | 512 px |
| 2.0 e 2.1 | Novembro e dezembro de 2022 | U-Net da mesma arquitetura, retreinada do zero | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Julho de 2023 | U-Net, 2,6 bilhões, mais um refiner | CLIP ViT-L e OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Novembro de 2023 | SDXL destilado para 1 a 4 passos | Os mesmos do SDXL | 512 px |
| 3 Medium | Junho de 2024 | Transformer de difusão (MMDiT), 2 bilhões | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Outubro de 2024 | MMDiT, 8 bilhões; Medium 2,5 bilhões | Os mesmos três | 1024 px |
O 1.5 continua sendo um dos modelos com mais fine-tunes que existem, com dezenas de milhares de checkpoints e LoRAs da comunidade, e ainda roda com 4 GB de memória de vídeo. O SDXL é o burro de carga: mãos, rostos e composição melhores, e saída nativa em 1024 pixels. O 3 e o 3.5 substituíram a U-Net por um transformer que trata os tokens de texto e de imagem juntos, e foi isso que finalmente tornou possível texto legível nas imagens: coloque as palavras entre aspas no prompt. A comparação entre SDXL e Stable Diffusion 3 mostra os mesmos prompts nos dois.
As licenças também mudaram. O 1.5 está sob a licença CreativeML OpenRAIL-M e o SDXL sob a OpenRAIL++-M, ambas livres para uso comercial com uma lista de usos proibidos. Os modelos 3.x estão sob a Stability AI Community License, gratuita abaixo de um milhão de dólares de receita anual.
O que dá para fazer com ele: image-to-image, inpainting, ControlNet, LoRA
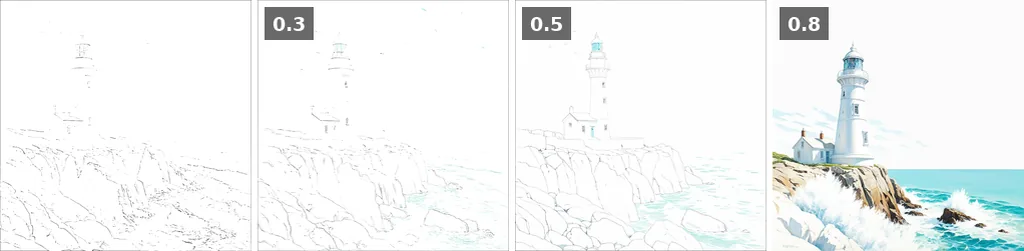
Texto para imagem é só o começo, porque cada peça do pipeline pode ser reaproveitada. Codifique um esboço em um latente, adicione só parte do ruído e remova o ruído a partir dali, e você tem o image-to-image, img2img nas interfaces: o ajuste de força (strength), ou denoise, é quanto ruído você adiciona. A ideia vem do SDEdit. Mascare uma região do latente e você tem o inpainting, ou o outpainting quando a máscara fica fora do quadro. Adicione uma pequena rede auxiliar que lê uma pose, um mapa de profundidade ou bordas, e você tem o ControlNet. Treine alguns milhões de pesos extras com vinte fotos e você tem um LoRA que ensina ao modelo um rosto ou um estilo. Modelos dedicados de super-resolução cuidam do upscaling.
Para rodar por conta própria, uma placa NVIDIA recente com 6 GB de memória de vídeo (VRAM) basta para o 1.5, e 8 GB para o SDXL. Placas AMD funcionam via ROCm, Apple Silicon via o backend MPS. O guia de instalação cobre as três interfaces principais. Sem placa, as ferramentas deste site não exigem hardware nenhum: o Stable Diffusion XL e o Stable Diffusion 1.5 rodam na GPU do próprio site com a fila exibida ao vivo, os prompts documentados mostram o que cada ajuste faz, e 1.731 estilos de artistas mostram o que o modelo aprendeu sobre pintores.
Stable Diffusion vs Midjourney vs DALL-E
Diante do Midjourney e dos modelos de imagem da OpenAI, a diferença não está na qualidade, mas no controle. Os pesos são públicos e o modelo roda localmente: suas imagens ficam no seu disco, você escolhe o modelo, define a seed e pode trocar qualquer componente. Em troca, ele exige mais de você. O Midjourney pede uma frase e entrega uma imagem polida; o Stable Diffusion pede um modelo, um prompt, um prompt negativo e um guidance scale, e entrega exatamente o que você configurou.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Pesos | Públicos, para download | Fechados | Fechados |
| Roda no seu computador | Sim, 6 a 8 GB de VRAM | Não | Não |
| Preço | Grátis localmente; ferramentas gratuitas online | Assinatura | Assinatura ou por imagem |
| Controle | Seed, modelo, LoRA, ControlNet, inpainting, todos os ajustes | Parâmetros e referências de estilo | Conversa |
| Fine-tuning | Sim, por qualquer pessoa | Não | Não |
| Texto nas imagens | Fraco antes do 3, bom a partir do 3.5 | Bom desde a v6 | Muito bom |
O mesmo princípio de difusão hoje move modelos de outros laboratórios, com outros codificadores e outras licenças: o FLUX, da Black Forest Labs, fundada pelos autores originais do Stable Diffusion, e o Qwen-Image, da Alibaba. Eles rodam nas mesmas interfaces, com as mesmas seeds, passos e samplers, então a maior parte desta página vale para eles. A guidance deles funciona de outro jeito, o FLUX dev não tem prompt negativo, e eles preferem frases completas a listas de palavras-chave.
Fontes, e como reutilizar as figuras
As fontes primárias, na ordem em que a página as encontra:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: o artigo do Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: os processos direto e inverso e o cronograma de mil passos.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: o CLIP.
- Classifier-Free Diffusion Guidance, Ho e Salimans, 2022: o guidance scale.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, e Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL e Stable Diffusion 3.
Reutilizar as figuras. Os renders e diagramas desta página são publicados sob CC BY 4.0: reutilize-os em um curso, uma palestra ou um artigo com um link para esta página. Todos os renders usam Stable Diffusion XL, euler, 30 passos, CFG 6, seed 20220822, o prompt abaixo e o prompt negativo “text, watermark, signature, blurry, low quality, storm, dark clouds, sunset”.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesPara citar esta página.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion