A Stable Diffusion röviden
A Stable Diffusion egy nyílt forráskódú latens diffúziós modell (LDM): egy neurális háló, amelyet arra tanítottak, hogy véletlen zajból apránként képet csináljon, egy szöveg irányításával. A müncheni Ludwig Maximilian Egyetem CompVis csoportja építette a Runwayjel közösen, a Stability AI számítási kapacitásán tanították, a LAION nonprofit szervezet által gyűjtött képeken. A módszer a High-Resolution Image Synthesis with Latent Diffusion Models cikkből származik (Rombach és munkatársai, CVPR 2022).
A súlyokat 2022. augusztus 22-én tették közzé. Ez az, ami mindent megváltoztatott. A DALL-E 2 és a Midjourney már létezett, de várólisták és kreditek mögött, valaki más szerverein. A Stable Diffusion egy 4 GB-os fájl volt, amely 8 GB memóriájú videokártyán futott, fiók nélkül, és a biztonsági szűrőjét ki lehetett kapcsolni.
Heteken belül jöttek a webes felületek és az inpainting, aztán a finomhangolt modellek, a LoRA-k és a ControlNet. Négy évvel később a név két dolgot jelent. Szigorúan véve az 1.4-től 3.5-ig terjedő modellcsaládot. Lazábban az egész gyakorlatot, hogy képmodelleket a saját gépeden futtatsz.
Ami következik, magát a gépezetet magyarázza el, azzal a szókinccsel, amellyel minden felületen találkozol: latens tér, VAE, U-Net, CLIP, sampler, CFG-skála, seed. Képletre nincs szükség, de néhány szám segít.
Hogyan működik a Stable Diffusion? Három háló és egy ciklus
A Stable Diffusion nem egy háló, hanem három, egymás után futtatva.
- Egy szövegkódoló beolvassa a promptot, és számok listájává alakítja. A Stable Diffusion 1.5-ben ez 77 token, mindegyiket 768 szám írja le; az SDXL-ben 2 048, mert az két kódolót futtat.
- Egy zajtalanító, az 1-től az XL-ig U-Net, a 3-as verziótól transzformer (MMDiT), egy véletlen zajblokkból indul, és 20–30 lépésben tisztítja meg, minden lépésben a szöveg számaihoz igazodva. Nem pixeleken dolgozik, hanem a kép tömörített változatán, a latensen, amely az úgynevezett latens térben él: 4 × 64 × 64 szám egy 512 pixeles képhez, 4 × 128 × 128 az SDXL 1024 pixeléhez.
- Egy dekóder ezt a latenst alakítja a végső pixelértékekké, vörös, zöld és kék: 3 × 512 × 512, vagy 3 × 1024 × 1024 az SDXL-nél.
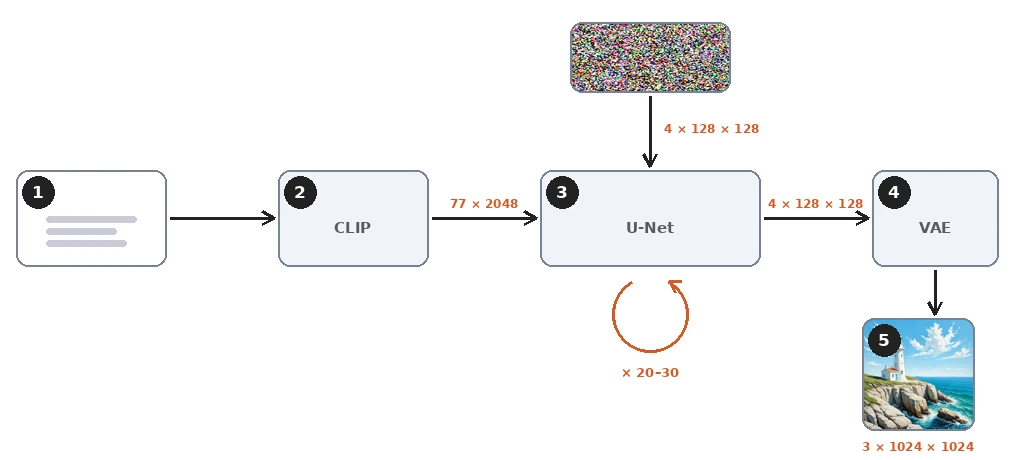
Közben semmit nem keres ki és nem másol. A fájlban nincs képadatbázis. A 2–16 GB súly azt tárolja, amit a háló a feliratok és a képek összetartozásáról tanult, és minden kimenet zajból számolódik ki. A háló ettől még megjegyezhet olyan képeket, amelyek sokszor szerepeltek a tanításban, és kutatók néhány százat ki is nyertek belőle, de ez a kivétel.
Mi az a diffúziós modell? A zaj eltávolításának megtanulása
Az előre irányuló folyamat: zaj hozzáadása
A diffúzió ötlete egyszerűen kimondható. Végy egy fotót a feliratával. Adj hozzá kimért mennyiségű véletlen zajt. Kérj meg egy hálót, hogy találja ki, melyik zajt adtad hozzá, a felirat ismeretében. Hasonlítsd össze a tippjét az igazsággal, és igazíts egy kicsit a hálón.
A zaj hozzáadása az előre irányuló folyamat (forward process). Egy rögzített, ezer szintű ütemterv szerint halad, az 50-es szint halvány szemcséjétől a 999-es szint tiszta hangyás képéig. A háló sosem látja lefutni az ütemtervet; egyszerre csak egy zajos képet lát, egyetlen szinten.
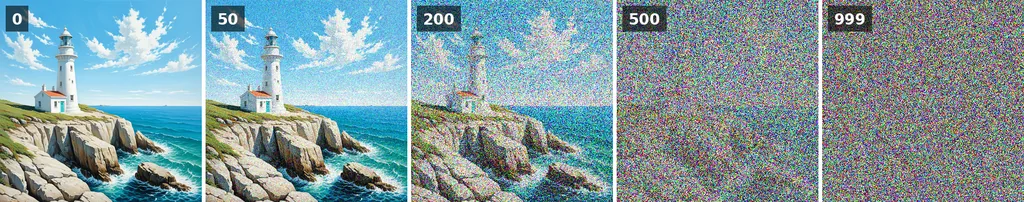
Tedd ezt több milliárd példán, és az eredmény egy zajbecslő: egy zajos kép, a zajszintje és egy szöveg alapján megmondja, mi lehet a zaj. A tanítás célfüggvénye egyszerűen a becsült és a valódi zaj különbsége. A Stable Diffusion 1 tanítása körülbelül 150 000 órát vett igénybe adatközponti A100 GPU-kon, a modellkártyája szerint.
A fordított folyamat: a zajbecslő munka közben
A generálás a leckét visszafelé játssza le. Ez a fordított folyamat (reverse process). Indulj tiszta zajból, amelyet a seed választ ki. Kérdezd meg a becslőt, mi a zaj, vedd el egy részét, kérdezd meg újra. A DDPM, a 2020-as cikk, amely a diffúziót használhatóvá tette, ezt ezer apró lépésben csinálta.
A sampler, egyes felületeken scheduler, az a szabály, amely eldönti, mekkora legyen egy-egy lépés, és kerül-e vissza egy kevés friss zaj. A jobb samplerek, a DDIM, az Euler és a DPM++ család nagyobb lépésekkel haladnak ugyanazon az úton, ezért elég ma 20–30 lépés.
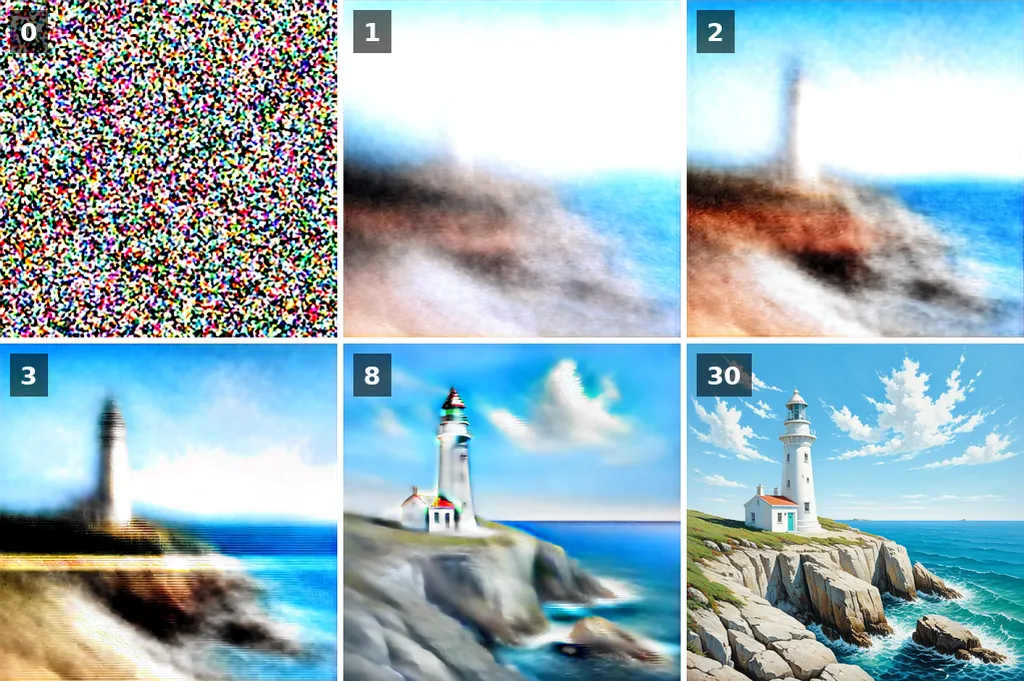
Az ábra mutatja azt, amit érdemes megjegyezni. A modellnek minden lépésben van egy tippje a kész képről, és ez a tipp korán megállapodik. Az első két-három lépés, amíg a zaj még sűrű, rögzíti a kompozíciót: hol a horizont, hol áll a világítótorony, mennyi az ég. A későbbi lépések a textúrát és az apró részleteket finomítják.
Az alábbi csúszka ugyanennek a rendernek mind a harminc tippjén végigmegy.
Két gyakorlati következmény adódik. A lépésszám változtatása megváltoztatja a részleteket, néha a kompozíciót is, mert a korai lépések más értékekre érkeznek; nem egyszerűen ugyanazt a képet élesíti. És ugyanaz a seed más képméretnél más zajblokkból indul, tehát más képet is ad. Előbb válaszd ki a méretet, utána keress seedet.
Latens diffúzió: a VAE-trükk, amitől elfér egy gamer kártyán
A korábbi diffúziós modellek pixeleken dolgoztak. Egy 512 × 512-es kép 786 432 szám, és a becslőnek minden egyes lépésében az összeset be kellett olvasnia és ki kellett írnia. A pixelmodellek, mint a DALL-E 2 és az Imagen, úgy kerülték meg ezt, hogy 64 pixelen diffundáltak, és nagyító hálókat tettek utána, és amúgy sem adták ki őket soha.
A Stable Diffusion egy variációs autoenkódert, a VAE-t teszi hozzá. Ennek a kódolója a képet oldalanként nyolcadára nyomja össze négy csatornába: 4 × 64 × 64, azaz 16 384 szám, 48-szor kevesebb. A diffúzió teljes egészében ebben a tömörített térben, a latens térben fut. A VAE dekódere csak a legvégén bontja ki az eredményt pixelekké.

A latens nem egy kis kép. A négy csatornája egy kód, amelyet a dekóder tud olvasni, és egyetlen csatorna sem hasonlít egészen a képre. Az elrendezés viszont túléli a tömörítést, és ettől tud a zajtalanító ilyen kis térben dönteni a kompozícióról.
Ezért számít a VAE megválasztása a színeknél és a finom részleteknél: minden latens szám egy 8 × 8 pixeles foltot képvisel, és a dekóder találja ki, mi van a folton belül. A Stable Diffusion 3 pontosan ezért tért át 16 csatornás latensre, és vele a finom részletek és az apró szövegek is javultak.
CLIP és cross-attention: hogyan irányítja a szöveg a képet
Három elem alakítja a szavakat iránnyá a zajtalanító számára.
Tokenizáló és szövegkódoló: hogyan olvassa a CLIP a promptot
A tokenizáló tokenekre vágja a promptot: gyakori szavak egészben, ritkábbak darabokban. A Stable Diffusion 1.5 és az SDXL legfeljebb 77 tokent olvas, ebből kettő a kezdő- és a záró jelölő, ez körülbelül 50–60 angol szó. Ami ezen túl van, azt levágja, hacsak a felület nem osztja több menetre. Ami a legfontosabb, kerüljön az elejére.
A szövegkódoló az 1.5-ben a CLIP, egy háló, amelyet az OpenAI 400 millió kép–felirat páron tanított, egyetlen feladattal: hozza közel a feliratot leíró számokat a képét leíró számokhoz. E tanítás után a „lighthouse” számai már hordozzák, hogyan néz ki egy világítótorony. Az SDXL két ilyen kódolót futtat egymás mellett, a második a LAION nyílt újratanítása kétmilliárd páron. A Stable Diffusion 3 egy harmadikat is hozzátesz, a T5-öt, amely egész mondatokat olvas.
Cross-attention a U-Netben
A cross-attention (keresztfigyelem) az, ahol a szöveg találkozik a képpel. A U-Net konvolúciós blokkok sora, amelyek a latenst összezsugorítják, majd visszanövesztik, az egyforma méretek között átugró kapcsolatokkal. A blokkok között figyelmi rétegek ülnek. A latens minden tartománya minden lépésben ránéz a 77 tokenvektorra, és mérlegeli, melyik vonatkozik rá. Az ég tartománya a „sunset” és a „clouds” szóra figyel, a szikla a „cliff” szóra. Ezért van hatása a szórendnek, az ismétlésnek és a felületek súlyozó szintaxisának, és ezért színezi át az egész képet egy stílusszó az elején.
Ugyanez az első verziók korlátja is. A CLIP rövid alt szövegekből tanult, ezért a témák és stílusok listáit jól érti, a köztük lévő viszonyokat rosszul. Az „a red cube on a blue sphere” az 1.5-ben gyakran felcserélve jön ki. A prompt útmutató megmutatja, mi az, ami megbízhatóan működik.
CFG-skála, negatív prompt és seed: a három beállítás
Három beállítás minden Stable Diffusion felületen megjelenik. Közvetlenül a fenti gépezetre képeződnek le.
A CFG-skála, vagyis a guidance scale, a classifier-free guidance rövidítése, az, amelyik eldönti, mennyire erősen nyomja a szöveg a képet. A zajtalanító minden lépésben valójában két becslést készít: egyet a prompttal és egyet üres prompttal. A kettő különbsége az az irány, amelyet a prompt ad. A végső becslés az üres plusz ez a különbség, megszorozva a CFG-skálával. 1-nél a promptos becslés változatlanul megy tovább, nyomás nélkül: a kép lazán követi a szöveget, tompa színekkel és szürke éggel ott, ahol a prompt kéket kért. 5–8 körül szorosan követi a promptot, természetes színekkel. 12 fölött a kontraszt megkeményedik, a színek telítődnek, az ecsetvonások durvák lesznek.
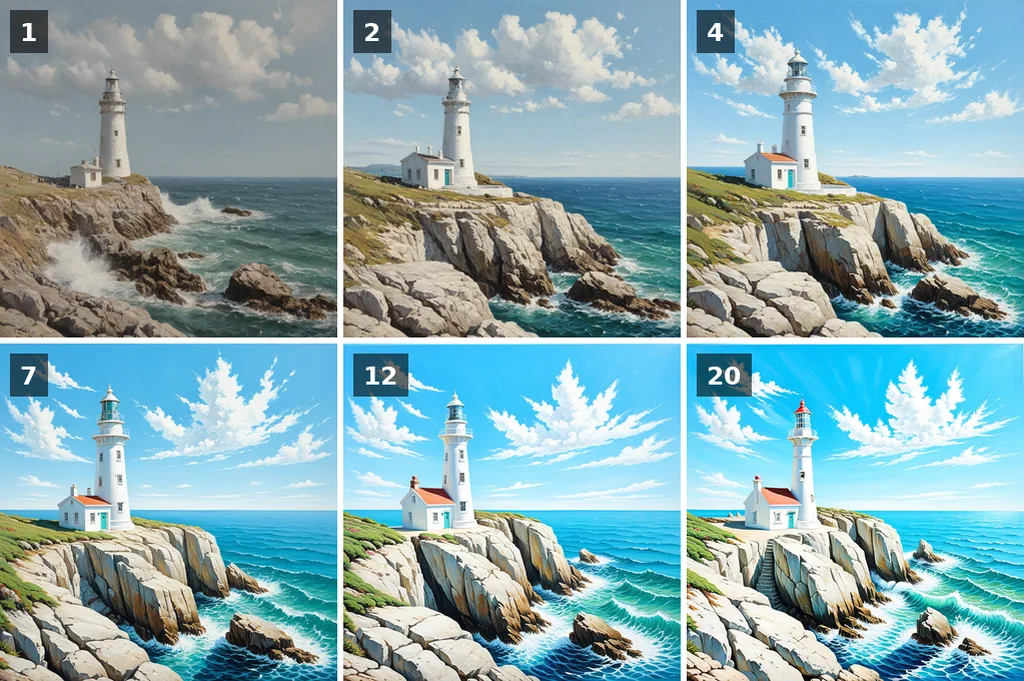
A negatív prompt a második becslés üres promptjának helyére lép. A második menet nem semmit olvas, hanem azt, hogy „blurry, text, watermark”, és a guidance ettől tol el. Nem kerül semmi többe, mert a második menet úgyis lefut, és csak akkor működik, ha a guidance 1 fölött van. A negatív prompt útmutató működő listákat ad.
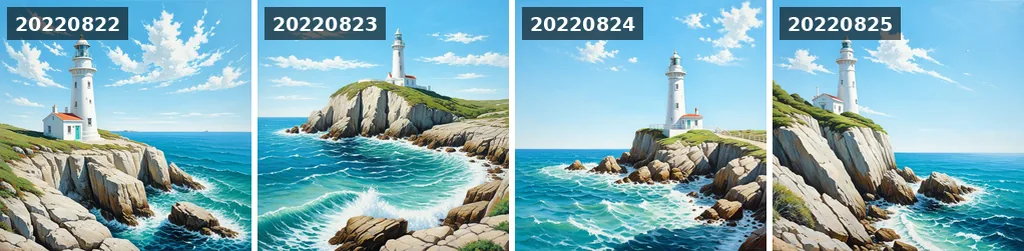
A seed az a szám, amely a kiinduló zajt generálja. Ugyanaz a seed, prompt, beállítás és modell ugyanazt a képet adja, pixelre pontosan, ugyanazon a szoftveren és hardveren; másik felület vagy másik kártya másképp sorsolja a zajt. Változtasd meg a seedet, és a kompozíció megváltozik, mert az első lépések más zajblokkot olvasnak. Változtass egy szót a promptban a seed megtartásával, és a kép nagy része általában megmarad. Így lehet egy promptot finomítani.
A U-Nettől a transzformerig: a verziók 1.5-től 3.5-ig
Két év alatt hat fő generáció jelent meg, az első kettő a CompVis és a Runway, a többi a Stability AI műhelyéből. Mindegyik a három háló közül legalább egyet lecserélt.
| Verzió | Dátum | Zajtalanító | Szövegkódolók | Natív méret |
|---|---|---|---|---|
| 1.4 és 1.5 | 2022 augusztusa és októbere | U-Net, 860 millió paraméter | CLIP ViT-L | 512 px |
| 2.0 és 2.1 | 2022 novembere és decembere | Azonos felépítésű U-Net, nulláról újratanítva | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | 2023 júliusa | U-Net, 2,6 milliárd, plusz egy refiner | CLIP ViT-L és OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | 2023 novembere | SDXL 1–4 lépésre desztillálva | Mint az SDXL | 512 px |
| 3 Medium | 2024 júniusa | Diffúziós transzformer (MMDiT), 2 milliárd | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | 2024 októbere | MMDiT, 8 milliárd; a Medium 2,5 milliárd | Ugyanaz a három | 1024 px |
Az 1.5 máig az egyik legtöbbet finomhangolt modell, több tízezer közösségi checkpointtal és LoRA-val, és még mindig elfut 4 GB videomemórián. Az SDXL az igásló: jobb kezek, arcok és kompozíció, natív 1024 pixeles kimenet. A 3 és a 3.5 a U-Netet transzformerre cserélte, amely a szöveg- és a képtokeneket együtt kezeli, és végre ez tette lehetővé az olvasható szöveget a képeken: tedd idézőjelbe a szavakat a promptban. Az SDXL és Stable Diffusion 3 összehasonlítás ugyanazokat a promptokat mutatja mindkettőn.
A licencek is változtak. Az 1.5 a CreativeML OpenRAIL-M licenc, az SDXL az OpenRAIL++-M alatt áll, mindkettő ingyenes kereskedelmi célra is, tiltott felhasználások listájával. A 3.x modellek a Stability AI Community License alatt állnak, amely egymillió dollár éves bevétel alatt ingyenes.
Mire használhatod: image-to-image, inpainting, ControlNet, LoRA
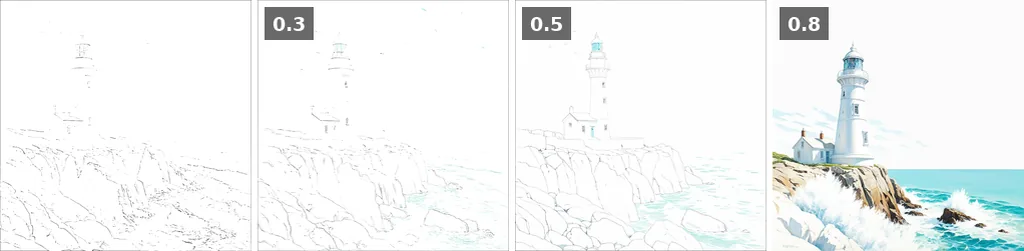
A szövegből kép csak a kezdet, mert a folyamat minden darabja újra felhasználható. Kódolj egy vázlatot latenssé, add hozzá a zajnak csak egy részét, és onnan zajtalaníts: ez az image-to-image, a felületeken img2img; a strength, vagyis a denoise beállítás az, hogy mennyi zajt adsz hozzá. Az ötlet az SDEdit-ből jön. Maszkold ki a latens egy tartományát, és ez az inpainting, vagy outpainting, ha a maszk a képkereten kívül esik. Tegyél mellé egy kis oldalhálót, amely pózt, mélységtérképet vagy éleket olvas, és ez a ControlNet. Taníts néhány millió plusz súlyt húsz fotón, és ez egy LoRA, amely egy arcot vagy stílust tanít a modellnek. A képnagyítást erre szánt szuperfelbontású modellek végzik.
Ha magad futtatod, egy újabb NVIDIA kártya 6 GB videomemóriával (VRAM) elég az 1.5-höz, 8 GB az SDXL-hez. Az AMD kártyák ROCm-mel működnek, az Apple Silicon az MPS backenddel. A telepítési útmutató a három fő felületet mutatja be. Kártya nélkül az oldal eszközeihez nem kell hardver: a Stable Diffusion XL és a Stable Diffusion 1.5 az oldal saját GPU-ján fut, élőben mutatott sorral, a dokumentált promptok megmutatják, mit csinál egy-egy beállítás, az 1 731 művészi stílus pedig azt, mit tanult a modell a festőkről.
Stable Diffusion vs Midjourney vs DALL-E
A Midjourney-vel és az OpenAI képmodelljeivel szemben a különbség nem a minőség, hanem a kontroll. A súlyok nyilvánosak, és a modell helyben fut: a képeid a saját lemezeden maradnak, te választod a modellt, te adod meg a seedet, és bármelyik összetevőt lecserélheted. Cserébe többet kér tőled. A Midjourney egy mondatot kér, és csiszolt képet ad; a Stable Diffusion modellt, promptot, negatív promptot és CFG-skálát kér, és pontosan azt adja, amit beállítottál.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Súlyok | Nyilvánosak, letölthetők | Zártak | Zártak |
| Fut a saját gépeden | Igen, 6–8 GB VRAM | Nem | Nem |
| Ár | Helyben ingyenes; ingyenes online eszközök | Előfizetés | Előfizetés vagy képenkénti díj |
| Kontroll | Seed, modell, LoRA, ControlNet, inpainting, minden beállítás | Paraméterek és stílusreferenciák | Beszélgetés |
| Finomhangolás | Igen, bárki által | Nem | Nem |
| Szöveg a képeken | Gyenge a 3 előtt, jó a 3.5-től | Jó a v6 óta | Nagyon jó |
Ugyanez a diffúziós elv hajtja ma más laborok modelljeit is, más kódolókkal és más licencekkel: a FLUX-ot a Black Forest Labstől, amelyet az eredeti Stable Diffusion szerzői alapítottak, és a Qwen-Image-et az Alibabától. Ugyanazokon a felületeken futnak, ugyanazokkal a seedekkel, lépésekkel és samplerekkel, így ennek az oldalnak a nagy része rájuk is érvényes. A guidance-ük másképp működik, a FLUX devnek nincs negatív promptja, és a kulcsszólisták helyett a teljes mondatokat kedvelik.
Források, és hogyan használd fel az ábrákat
Az elsődleges források, abban a sorrendben, ahogy az oldal eléri őket:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: a Stable Diffusion cikke.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: az előre irányuló és a fordított folyamat, valamint az ezer lépéses ütemterv.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: a CLIP.
- Classifier-Free Diffusion Guidance, Ho és Salimans, 2022: a CFG-skála.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, és Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: az SDXL és a Stable Diffusion 3.
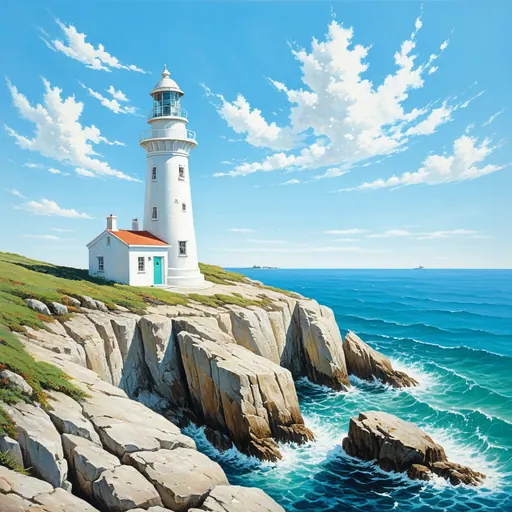
Az ábrák felhasználása. Az oldal renderei és ábrái CC BY 4.0 licenc alatt jelennek meg: használd fel őket kurzusban, előadásban vagy cikkben, az oldalra mutató linkkel. Minden render Stable Diffusion XL-lel készült, euler, 30 lépés, CFG 6, seed 20220822, az alábbi prompttal és a „text, watermark, signature, blurry, low quality, storm, dark clouds, sunset” negatív prompttal.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesAz oldal hivatkozása.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion