Το Stable Diffusion με λίγα λόγια
Το Stable Diffusion είναι ένα μοντέλο λανθάνουσας διάχυσης (latent diffusion model, LDM) ανοιχτού κώδικα: ένα νευρωνικό δίκτυο εκπαιδευμένο να μετατρέπει τυχαίο θόρυβο σε εικόνα, λίγο λίγο, με οδηγό ένα κείμενο. Το έφτιαξε η ομάδα CompVis του Πανεπιστημίου Ludwig Maximilian του Μονάχου μαζί με τη Runway, και εκπαιδεύτηκε με υπολογιστική ισχύ από τη Stability AI σε εικόνες που συγκέντρωσε ο μη κερδοσκοπικός οργανισμός LAION. Η μέθοδος προέρχεται από την εργασία High-Resolution Image Synthesis with Latent Diffusion Models (Rombach και συνεργάτες, CVPR 2022).
Τα βάρη δημοσιεύτηκαν στις 22 Αυγούστου 2022. Αυτό είναι που άλλαξε τα πάντα. Το DALL-E 2 και το Midjourney υπήρχαν ήδη, αλλά πίσω από λίστες αναμονής και credits, σε ξένους διακομιστές. Το Stable Diffusion ήταν ένα αρχείο 4 GB που έτρεχε σε κάρτα γραφικών με 8 GB μνήμης, χωρίς λογαριασμό και με ένα φίλτρο ασφαλείας που μπορούσατε να απενεργοποιήσετε.
Μέσα σε εβδομάδες ήρθαν οι διεπαφές ιστού και το inpainting, μετά τα fine-tune, τα LoRA και το ControlNet. Τέσσερα χρόνια αργότερα το όνομα σημαίνει δύο πράγματα. Με την αυστηρή έννοια, την οικογένεια μοντέλων από το 1.4 έως το 3.5. Με τη χαλαρή, ολόκληρη την πρακτική του να τρέχετε μοντέλα εικόνας στο δικό σας μηχάνημα.
Όσα ακολουθούν εξηγούν την ίδια τη μηχανή, με το λεξιλόγιο που θα συναντήσετε σε κάθε διεπαφή: λανθάνων χώρος, VAE, U-Net, CLIP, δειγματολήπτης, κλίμακα CFG, seed. Δεν χρειάζεται κανένας τύπος, αλλά λίγοι αριθμοί βοηθούν.
Πώς λειτουργεί το Stable Diffusion; Τρία δίκτυα και ένας βρόχος
Το Stable Diffusion δεν είναι ένα δίκτυο αλλά τρία, που τρέχουν το ένα μετά το άλλο.
- Ένας κωδικοποιητής κειμένου διαβάζει το prompt και το μετατρέπει σε μια λίστα αριθμών. Στο Stable Diffusion 1.5 αυτό είναι 77 token, το καθένα περιγραμμένο από 768 αριθμούς· 2.048 στο SDXL, που τρέχει δύο κωδικοποιητές.
- Ένας αποθορυβοποιητής, U-Net στις εκδόσεις 1 έως XL και transformer (MMDiT) από την έκδοση 3 και μετά, ξεκινά από ένα μπλοκ τυχαίου θορύβου και το καθαρίζει σε 20 έως 30 βήματα, συμβουλευόμενος τους αριθμούς του κειμένου σε κάθε βήμα. Δεν δουλεύει σε pixel αλλά σε μια συμπαγή εκδοχή της εικόνας, το latent, που ζει στον λεγόμενο λανθάνοντα χώρο (latent space): 4 × 64 × 64 αριθμοί για εικόνα 512 pixel, 4 × 128 × 128 για τα 1024 pixel του SDXL.
- Ένας αποκωδικοποιητής μετατρέπει αυτό το latent στις τελικές τιμές των pixel, κόκκινο, πράσινο και μπλε: 3 × 512 × 512, ή 3 × 1024 × 1024 για το SDXL.
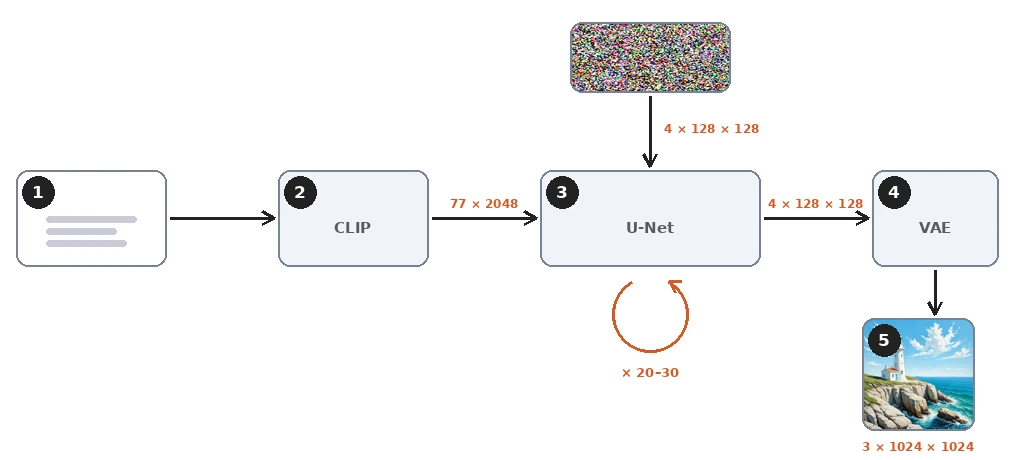
Τίποτα δεν αναζητείται ούτε αντιγράφεται στη διαδρομή. Δεν υπάρχει βάση δεδομένων με εικόνες μέσα στο αρχείο. Τα 2 έως 16 GB βαρών κρατούν όσα έμαθε το δίκτυο για το πώς ταιριάζουν λεζάντες και εικόνες, και κάθε αποτέλεσμα υπολογίζεται από θόρυβο. Το δίκτυο μπορεί πάντως να απομνημονεύσει εικόνες που εμφανίστηκαν πολλές φορές στην εκπαίδευση, και ερευνητές έχουν εξαγάγει μερικές εκατοντάδες από αυτές, αλλά αυτό είναι η εξαίρεση.
Τι είναι ένα μοντέλο διάχυσης; Μαθαίνοντας να αφαιρεί θόρυβο
Η ευθεία διαδικασία: προσθήκη θορύβου
Η ιδέα πίσω από τη διάχυση διατυπώνεται απλά. Πάρτε μια φωτογραφία με τη λεζάντα της. Προσθέστε της μια μετρημένη ποσότητα τυχαίου θορύβου. Ζητήστε από ένα δίκτυο να μαντέψει ποιος θόρυβος προστέθηκε, γνωρίζοντας τη λεζάντα. Συγκρίνετε την εκτίμησή του με την αλήθεια και διορθώστε λίγο το δίκτυο.
Η προσθήκη του θορύβου είναι η ευθεία διαδικασία (forward process). Ακολουθεί ένα σταθερό χρονοδιάγραμμα χιλίων επιπέδων, από έναν αχνό κόκκο στο επίπεδο 50 έως καθαρό «χιόνι» στο επίπεδο 999. Το δίκτυο δεν βλέπει ποτέ το χρονοδιάγραμμα να εκτυλίσσεται· βλέπει μόνο μία θορυβώδη εικόνα σε ένα επίπεδο κάθε φορά.
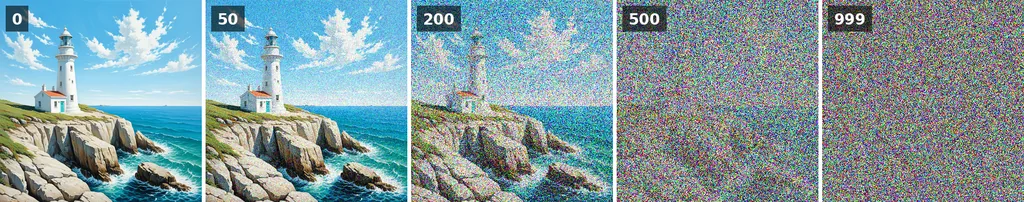
Κάντε το αυτό σε δισεκατομμύρια παραδείγματα και το αποτέλεσμα είναι ένας εκτιμητής θορύβου: με δεδομένη μια θορυβώδη εικόνα, το επίπεδο θορύβου της και ένα κείμενο, λέει ποιος είναι πιθανότατα ο θόρυβος. Ο στόχος της εκπαίδευσης είναι απλώς η απόσταση ανάμεσα στον προβλεπόμενο θόρυβο και τον πραγματικό. Η εκπαίδευση του Stable Diffusion 1 πήρε περίπου 150.000 ώρες σε GPU A100 κέντρων δεδομένων, σύμφωνα με την κάρτα του μοντέλου.
Η αντίστροφη διαδικασία: ο εκτιμητής θορύβου επί το έργον
Η δημιουργία τρέχει το μάθημα ανάποδα. Αυτή είναι η αντίστροφη διαδικασία (reverse process). Ξεκινήστε από καθαρό θόρυβο, τον οποίο διαλέγει το seed. Ρωτήστε τον εκτιμητή ποιος είναι ο θόρυβος, αφαιρέστε ένα κλάσμα του, ρωτήστε ξανά. Το DDPM, η εργασία του 2020 που έκανε τη διάχυση πρακτική, το έκανε αυτό σε χίλια μικρά βήματα.
Ο δειγματολήπτης (sampler), που σε ορισμένες διεπαφές λέγεται και scheduler, είναι ο κανόνας που αποφασίζει πόσο μεγάλο είναι κάθε βήμα και αν προστίθεται ξανά λίγος φρέσκος θόρυβος. Οι καλύτεροι δειγματολήπτες, DDIM, Euler και η οικογένεια DPM++, κάνουν μεγαλύτερα βήματα στην ίδια διαδρομή, γι' αυτό και σήμερα αρκούν 20 έως 30 βήματα.
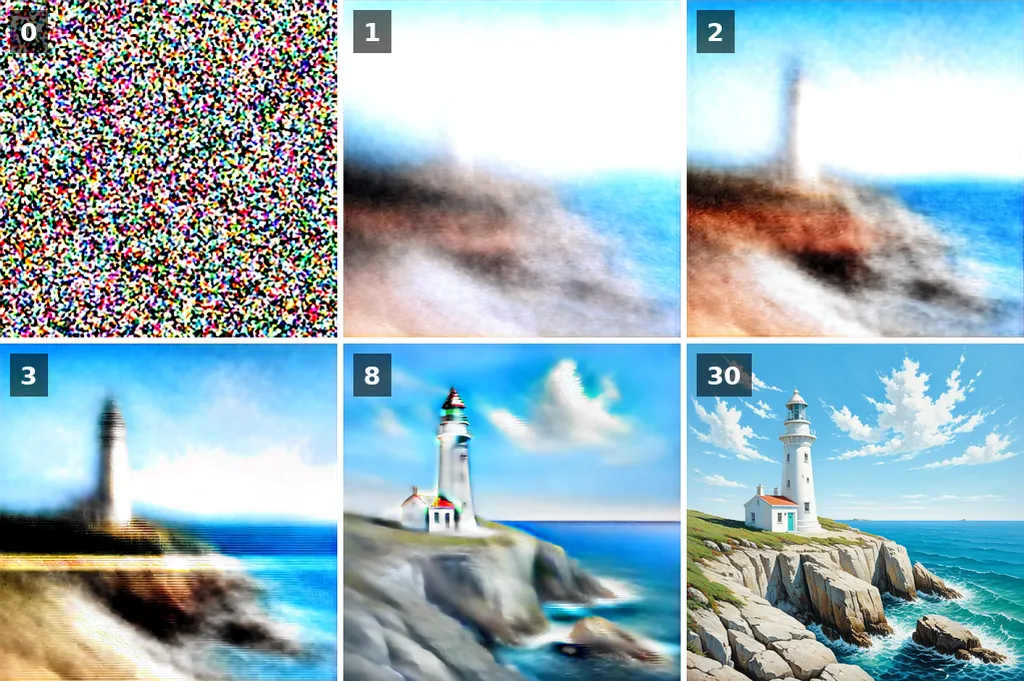
Η εικόνα δείχνει το σημείο που αξίζει να θυμάστε. Σε κάθε βήμα το μοντέλο κρατά μια εκτίμηση της τελικής εικόνας, και η εκτίμηση σταθεροποιείται νωρίς. Τα πρώτα δύο ή τρία βήματα, όσο ο θόρυβος είναι βαρύς, καθορίζουν τη σύνθεση: πού είναι ο ορίζοντας, πού στέκεται ο φάρος, πόσος ουρανός υπάρχει. Τα επόμενα βήματα βελτιώνουν την υφή και τις μικρές λεπτομέρειες.
Το ρυθμιστικό παρακάτω περνά από όλες τις τριάντα εκτιμήσεις του ίδιου render.
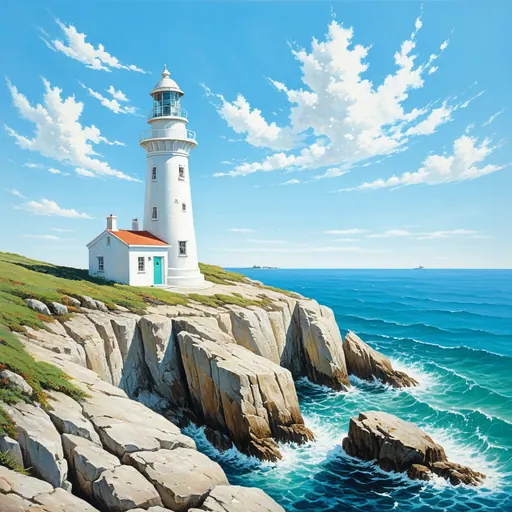
Προκύπτουν δύο πρακτικές συνέπειες. Η αλλαγή του αριθμού των βημάτων αλλάζει τις λεπτομέρειες και μερικές φορές τη σύνθεση, επειδή τα πρώτα βήματα πέφτουν σε άλλες τιμές· δεν κάνει απλώς πιο ευκρινή την ίδια εικόνα. Και το ίδιο seed σε άλλο μέγεθος εικόνας ξεκινά από διαφορετικό μπλοκ θορύβου, οπότε δίνει κι αυτό διαφορετική εικόνα. Διαλέξτε πρώτα το μέγεθος και μετά ψάξτε για seed.
Λανθάνουσα διάχυση: το κόλπο του VAE που το χωράει σε κάρτα για παιχνίδια
Τα παλαιότερα μοντέλα διάχυσης δούλευαν σε pixel. Μια εικόνα 512 × 512 είναι 786.432 αριθμοί, και ο εκτιμητής έπρεπε να τους διαβάζει και να τους γράφει όλους σε καθένα από τα βήματά του. Τα μοντέλα pixel όπως το DALL-E 2 και το Imagen το παρέκαμπταν κάνοντας διάχυση στα 64 pixel και προσθέτοντας δίκτυα μεγέθυνσης, και ούτως ή άλλως δεν κυκλοφόρησαν ποτέ.
Το Stable Diffusion προσθέτει έναν μεταβλητικό αυτοκωδικοποιητή (variational autoencoder), το VAE. Ο κωδικοποιητής του συμπιέζει μια εικόνα κατά οκτώ φορές σε κάθε πλευρά σε τέσσερα κανάλια: 4 × 64 × 64, δηλαδή 16.384 αριθμοί, 48 φορές λιγότεροι. Η διάχυση τρέχει εξ ολοκλήρου σε αυτόν τον συμπιεσμένο χώρο, τον λανθάνοντα χώρο. Μόνο στο τέλος ο αποκωδικοποιητής του VAE ξεδιπλώνει το αποτέλεσμα σε pixel.

Το latent δεν είναι μια μικρή εικόνα. Τα τέσσερα κανάλια του είναι ένας κώδικας που ο αποκωδικοποιητής ξέρει να διαβάζει, και κανένα κανάλι από μόνο του δεν μοιάζει ακριβώς με την εικόνα. Η διάταξη όμως επιβιώνει της συμπίεσης, και αυτό είναι που επιτρέπει στον αποθορυβοποιητή να αποφασίζει τη σύνθεση σε τόσο μικρό χώρο.
Γι' αυτό και η επιλογή του VAE έχει σημασία για το χρώμα και τις λεπτές λεπτομέρειες: κάθε αριθμός του latent αντιστοιχεί σε ένα τμήμα 8 × 8 pixel, και ο αποκωδικοποιητής επινοεί τι βρίσκεται μέσα στο τμήμα. Το Stable Diffusion 3 πέρασε σε latent 16 καναλιών ακριβώς γι' αυτόν τον λόγο, και οι λεπτές λεπτομέρειες και το μικρό κείμενο βελτιώθηκαν μαζί του.
CLIP και cross-attention: πώς το κείμενο καθοδηγεί την εικόνα
Τρία κομμάτια μετατρέπουν τις λέξεις σε κατεύθυνση για τον αποθορυβοποιητή.
Tokenizer και κωδικοποιητής κειμένου: πώς το CLIP διαβάζει ένα prompt
Ο tokenizer κόβει το prompt σε token, ολόκληρες συνηθισμένες λέξεις ή τμήματα σπανιότερων. Το Stable Diffusion 1.5 και το SDXL διαβάζουν το πολύ 77 token, δύο από τα οποία είναι δείκτες αρχής και τέλους, περίπου 50 έως 60 αγγλικές λέξεις. Πέρα από αυτό, το κείμενο κόβεται, εκτός αν η διεπαφή το χωρίσει σε περισσότερα περάσματα. Βάλτε ό,τι μετράει περισσότερο στην αρχή.
Ο κωδικοποιητής κειμένου του 1.5 είναι το CLIP, ένα δίκτυο που η OpenAI εκπαίδευσε σε 400 εκατομμύρια ζεύγη εικόνων και λεζαντών, με μία αποστολή: να φέρει τους αριθμούς που περιγράφουν μια λεζάντα κοντά στους αριθμούς που περιγράφουν την εικόνα της. Μετά από αυτή την εκπαίδευση, οι αριθμοί για το «lighthouse» κουβαλούν ήδη το πώς μοιάζουν οι φάροι. Το SDXL τρέχει δύο τέτοιους κωδικοποιητές παράλληλα, ο δεύτερος μια ανοιχτή επανεκπαίδευση από τη LAION σε δύο δισεκατομμύρια ζεύγη. Το Stable Diffusion 3 προσθέτει έναν τρίτο, το T5, που διαβάζει ολόκληρες προτάσεις.
Το cross-attention μέσα στο U-Net
Το cross-attention (διασταυρούμενη προσοχή) είναι εκεί όπου το κείμενο συναντά την εικόνα. Το U-Net είναι μια στοίβα συνελικτικών μπλοκ που συρρικνώνουν το latent και μετά το μεγαλώνουν ξανά, με συνδέσεις παράκαμψης ανάμεσα στα αντίστοιχα μεγέθη. Ανάμεσα σε αυτά τα μπλοκ κάθονται στρώματα προσοχής. Σε κάθε βήμα, κάθε περιοχή του latent κοιτάζει τα 77 διανύσματα των token και ζυγίζει ποια από αυτά την αφορούν. Η περιοχή του ουρανού προσέχει το «sunset» και το «clouds», ο βράχος το «cliff». Γι' αυτό η σειρά των λέξεων, η επανάληψη και η σύνταξη βαρών των διεπαφών έχουν επίδραση, και γι' αυτό μια λέξη στυλ στην αρχή χρωματίζει ολόκληρη την εικόνα.
Είναι επίσης το όριο των πρώτων εκδόσεων. Το CLIP έμαθε από σύντομα κείμενα alt, οπότε καταλαβαίνει καλά λίστες θεμάτων και στυλ και άσχημα τις σχέσεις ανάμεσά τους. Το «a red cube on a blue sphere» συχνά βγαίνει ανάποδα στο 1.5. Ο οδηγός prompt δείχνει τι δουλεύει αξιόπιστα.
Κλίμακα CFG, αρνητικό prompt και seed: οι τρεις ρυθμίσεις
Τρεις ρυθμίσεις εμφανίζονται σε κάθε διεπαφή του Stable Diffusion. Αντιστοιχούν άμεσα στον μηχανισμό που περιγράφηκε παραπάνω.
Η κλίμακα CFG, ή guidance scale, συντομογραφία του classifier-free guidance, είναι αυτή που αποφασίζει πόσο δυνατά σπρώχνεται το κείμενο. Σε κάθε βήμα ο αποθορυβοποιητής κάνει στην πραγματικότητα δύο προβλέψεις: μία με το prompt και μία με κενό prompt. Η διαφορά των δύο είναι η κατεύθυνση που δίνει το prompt. Η τελική πρόβλεψη είναι η κενή συν αυτή τη διαφορά πολλαπλασιασμένη με την κλίμακα CFG. Στο 1 η πρόβλεψη με το prompt χρησιμοποιείται ως έχει, χωρίς σπρώξιμο: η εικόνα ακολουθεί το κείμενο χαλαρά, με μουντά χρώματα και γκρίζο ουρανό εκεί που το prompt ζήτησε γαλάζιο. Γύρω στο 5 έως 8 ακολουθεί το prompt πιστά με φυσικά χρώματα. Πάνω από 12 η αντίθεση σκληραίνει, τα χρώματα κορέννυνται και οι πινελιές γίνονται τραχιές.
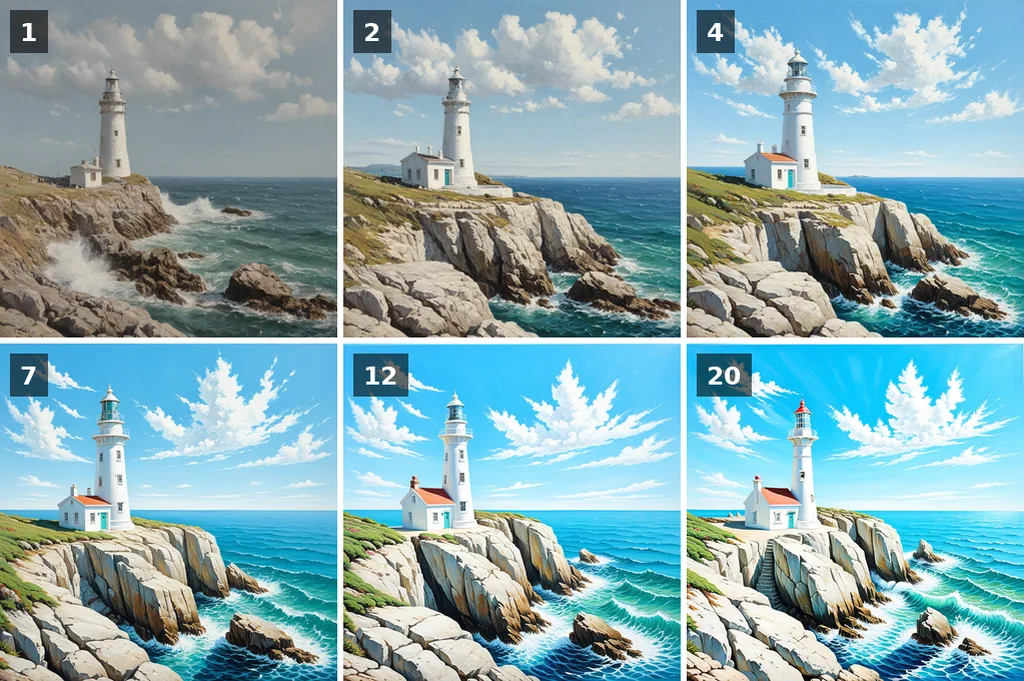
Το αρνητικό prompt αντικαθιστά το κενό prompt εκείνης της δεύτερης πρόβλεψης. Αντί να μη διαβάζει τίποτα, το δεύτερο πέρασμα διαβάζει «blurry, text, watermark», και η καθοδήγηση σπρώχνει μακριά από αυτό. Δεν κοστίζει τίποτα επιπλέον, αφού το δεύτερο πέρασμα τρέχει ούτως ή άλλως, και δουλεύει μόνο όταν η καθοδήγηση είναι πάνω από 1. Ο οδηγός για το αρνητικό prompt δίνει λίστες που δουλεύουν.
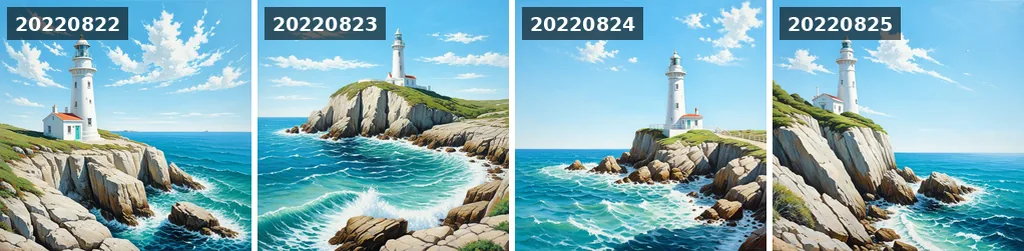
Το seed είναι ο αριθμός που παράγει τον αρχικό θόρυβο. Ίδιο seed, ίδιο prompt, ίδιες ρυθμίσεις και ίδιο μοντέλο δίνουν την ίδια εικόνα, μέχρι το pixel, στο ίδιο λογισμικό και υλικό· άλλη διεπαφή ή άλλη κάρτα παράγει τον θόρυβο διαφορετικά. Αλλάξτε το seed και η σύνθεση αλλάζει, αφού τα πρώτα βήματα διαβάζουν άλλο μπλοκ θορύβου. Αλλάξτε μία λέξη του prompt κρατώντας το seed, και το μεγαλύτερο μέρος της εικόνας συνήθως μένει. Έτσι βελτιώνεται ένα prompt.
Από το U-Net στον transformer: οι εκδόσεις από το 1.5 έως το 3.5
Έξι κύριες γενιές εμφανίστηκαν σε δύο χρόνια, οι δύο πρώτες από τους CompVis και Runway, οι υπόλοιπες από τη Stability AI. Καθεμία άλλαξε τουλάχιστον ένα από τα τρία δίκτυα.
| Έκδοση | Ημερομηνία | Αποθορυβοποιητής | Κωδικοποιητές κειμένου | Εγγενές μέγεθος |
|---|---|---|---|---|
| 1.4 και 1.5 | Αύγουστος και Οκτώβριος 2022 | U-Net, 860 εκατομμύρια παράμετροι | CLIP ViT-L | 512 px |
| 2.0 και 2.1 | Νοέμβριος και Δεκέμβριος 2022 | U-Net ίδιας σχεδίασης, επανεκπαιδευμένο από το μηδέν | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Ιούλιος 2023 | U-Net, 2,6 δισεκατομμύρια, συν ένα refiner | CLIP ViT-L και OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Νοέμβριος 2023 | SDXL αποσταγμένο σε 1 έως 4 βήματα | Ίδιοι με το SDXL | 512 px |
| 3 Medium | Ιούνιος 2024 | Diffusion transformer (MMDiT), 2 δισεκατομμύρια | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Οκτώβριος 2024 | MMDiT, 8 δισεκατομμύρια· Medium 2,5 δισεκατομμύρια | Οι ίδιοι τρεις | 1024 px |
Το 1.5 παραμένει ένα από τα μοντέλα με τα περισσότερα fine-tune που υπάρχουν, με δεκάδες χιλιάδες checkpoint και LoRA από την κοινότητα, και εξακολουθεί να τρέχει με 4 GB μνήμης βίντεο. Το SDXL είναι το μοντέλο της καθημερινής δουλειάς: καλύτερα χέρια, πρόσωπα και σύνθεση, και εγγενής έξοδος 1024 pixel. Τα 3 και 3.5 αντικατέστησαν το U-Net με έναν transformer που χειρίζεται τα token κειμένου και εικόνας μαζί, κάτι που επιτέλους έκανε εφικτό το ευανάγνωστο κείμενο μέσα στις εικόνες: βάλτε τις λέξεις σε εισαγωγικά στο prompt. Η σύγκριση SDXL και Stable Diffusion 3 δείχνει τα ίδια prompt και στα δύο.
Άλλαξαν και οι άδειες. Το 1.5 είναι υπό την άδεια CreativeML OpenRAIL-M και το SDXL υπό την OpenRAIL++-M, και οι δύο δωρεάν για εμπορική χρήση με μια λίστα απαγορευμένων χρήσεων. Τα μοντέλα 3.x είναι υπό τη Stability AI Community License, δωρεάν κάτω από ένα εκατομμύριο δολάρια ετήσιων εσόδων.
Τι μπορείτε να κάνετε με αυτό: image-to-image, inpainting, ControlNet, LoRA
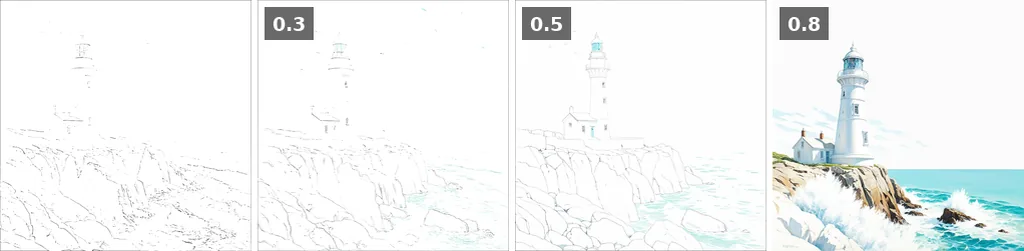
Η δημιουργία εικόνας από κείμενο είναι μόνο η αρχή, επειδή κάθε κομμάτι του pipeline μπορεί να επαναχρησιμοποιηθεί. Κωδικοποιήστε ένα σκίτσο σε latent, προσθέστε μόνο μέρος του θορύβου και αποθορυβοποιήστε από εκεί, και έχετε το image-to-image, img2img στις διεπαφές: η ρύθμιση strength, ή denoise, είναι το πόσο θόρυβο προσθέτετε. Η ιδέα προέρχεται από το SDEdit. Μασκάρετε μια περιοχή του latent και έχετε το inpainting, ή το outpainting όταν η μάσκα είναι έξω από το κάδρο. Προσθέστε ένα μικρό πλευρικό δίκτυο που διαβάζει μια στάση σώματος, έναν χάρτη βάθους ή ακμές, και έχετε το ControlNet. Εκπαιδεύστε μερικά εκατομμύρια επιπλέον βάρη σε είκοσι φωτογραφίες και έχετε ένα LoRA που μαθαίνει στο μοντέλο ένα πρόσωπο ή ένα στυλ. Ειδικά μοντέλα υπερ-ανάλυσης αναλαμβάνουν τη μεγέθυνση.
Για να το τρέξετε μόνοι σας, μια πρόσφατη κάρτα NVIDIA με 6 GB μνήμης βίντεο (VRAM) αρκεί για το 1.5 και 8 GB για το SDXL. Οι κάρτες AMD δουλεύουν μέσω ROCm, το Apple Silicon μέσω του backend MPS. Ο οδηγός εγκατάστασης καλύπτει τις τρεις κύριες διεπαφές. Χωρίς κάρτα, τα εργαλεία αυτού του ιστότοπου δεν χρειάζονται υλικό: το Stable Diffusion XL και το Stable Diffusion 1.5 τρέχουν στη GPU του ίδιου του ιστότοπου με την ουρά να εμφανίζεται ζωντανά, τα τεκμηριωμένα prompt δείχνουν τι κάνει κάθε ρύθμιση, και τα 1.731 στυλ καλλιτεχνών δείχνουν τι έμαθε το μοντέλο για τους ζωγράφους.
Stable Diffusion vs Midjourney vs DALL-E
Απέναντι στο Midjourney και στα μοντέλα εικόνας της OpenAI, η διαφορά δεν είναι η ποιότητα αλλά ο έλεγχος. Τα βάρη είναι δημόσια και το μοντέλο τρέχει τοπικά: οι εικόνες σας μένουν στον δίσκο σας, εσείς διαλέγετε το μοντέλο, εσείς ορίζετε το seed και μπορείτε να αλλάξετε οποιοδήποτε στοιχείο. Σε αντάλλαγμα ζητά περισσότερα από εσάς. Το Midjourney ζητά μια πρόταση και δίνει μια καλοδουλεμένη εικόνα· το Stable Diffusion ζητά μοντέλο, prompt, αρνητικό prompt και κλίμακα CFG, και σας δίνει ακριβώς αυτό που ορίσατε.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Βάρη | Δημόσια, με δυνατότητα λήψης | Κλειστά | Κλειστά |
| Τρέχει στον υπολογιστή σας | Ναι, 6 έως 8 GB VRAM | Όχι | Όχι |
| Τιμή | Δωρεάν τοπικά· δωρεάν εργαλεία online | Συνδρομή | Συνδρομή ή χρέωση ανά εικόνα |
| Έλεγχος | Seed, μοντέλο, LoRA, ControlNet, inpainting, κάθε ρύθμιση | Παράμετροι και αναφορές στυλ | Συνομιλία |
| Fine-tuning | Ναι, από οποιονδήποτε | Όχι | Όχι |
| Κείμενο στις εικόνες | Αδύναμο πριν από το 3, καλό από το 3.5 | Καλό από την v6 | Πολύ καλό |
Η ίδια αρχή της διάχυσης τροφοδοτεί σήμερα μοντέλα από άλλα εργαστήρια, με άλλους κωδικοποιητές και άλλες άδειες: το FLUX της Black Forest Labs, που ιδρύθηκε από τους αρχικούς δημιουργούς του Stable Diffusion, και το Qwen-Image της Alibaba. Τρέχουν στις ίδιες διεπαφές, με τα ίδια seed, βήματα και δειγματολήπτες, οπότε το μεγαλύτερο μέρος αυτής της σελίδας ισχύει και για αυτά. Η καθοδήγησή τους λειτουργεί διαφορετικά, το FLUX dev δεν έχει αρνητικό prompt, και προτιμούν πλήρεις προτάσεις από λίστες λέξεων-κλειδιών.
Πηγές, και πώς να επαναχρησιμοποιήσετε τις εικόνες
Οι πρωτογενείς πηγές, με τη σειρά που τις συναντά η σελίδα:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: η εργασία του Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: η ευθεία και η αντίστροφη διαδικασία και το χρονοδιάγραμμα των χιλίων βημάτων.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: το CLIP.
- Classifier-Free Diffusion Guidance, Ho και Salimans, 2022: η κλίμακα CFG.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, και Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: το SDXL και το Stable Diffusion 3.
Επαναχρησιμοποίηση των εικόνων. Τα render και τα διαγράμματα αυτής της σελίδας διατίθενται υπό CC BY 4.0: χρησιμοποιήστε τα σε ένα μάθημα, μια ομιλία ή ένα άρθρο με σύνδεσμο προς αυτή τη σελίδα. Κάθε render χρησιμοποιεί Stable Diffusion XL, euler, 30 βήματα, CFG 6, seed 20220822, το παρακάτω prompt και το αρνητικό prompt «text, watermark, signature, blurry, low quality, storm, dark clouds, sunset».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesΓια να παραπέμψετε σε αυτή τη σελίδα.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion