Τι είναι το Qwen-Image 2.1
Το Qwen-Image 2.1 είναι ένα checkpoint για δύο δουλειές. Δημιουργεί εικόνα από κείμενο, και επεξεργάζεται μια υπάρχουσα εικόνα από μια πρόταση και έως δέκα εικόνες αναφοράς. Το κομμάτι της δημιουργίας είναι ένας diffusion transformer 7 δισεκατομμυρίων παραμέτρων. Συνδυάζεται με έναν κωδικοποιητή κειμένου Qwen3-VL 8B, που φορτώνεται στο ComfyUI ως ξεχωριστό αρχείο.
Ένα γλωσσικό μοντέλο ως κωδικοποιητής είναι αυτό που του επιτρέπει να διαβάζει ολόκληρες προτάσεις, οδηγίες διάταξης και λέξεις σε εισαγωγικά, αντί για λίστες λέξεων-κλειδιών.
Η Qwen παρουσιάζει το 2.1 ως καλύτερο στις υφές, στην τυπογραφία και στον φωτισμό πορτρέτων. Δουλεύει σε εγγενές 2K χωρίς upscaler: 2048 × 2048 για τετράγωνο, 2528 × 1696 για 3:2, 2752 × 1536 για 16:9. Μπορεί επίσης να βγάλει πραγματικό κανάλι άλφα όταν το prompt ζητά διαφανές φόντο.
Το τίμημα είναι ο χρόνος. Σε κάρτα καταναλωτικής κατηγορίας με 16 GB μνήμης βίντεο, τα βάρη int8 χρειάζονται περίπου 40 δευτερόλεπτα για εικόνα 1 megapixel. Μια εικόνα 4 megapixel χρειάζεται περίπου τεσσεράμισι λεπτά με τις παρακάτω ρυθμίσεις.
Κάτι που πρέπει να ξέρετε πριν κατεβάσετε. Τα βάρη διατίθενται με την Qwen Research License: μόνο για έρευνα και αξιολόγηση. Κάθε εμπορική χρήση χρειάζεται ξεχωριστή άδεια από την Qwen. Το πρώτο Qwen-Image, που κυκλοφόρησε τον Αύγουστο του 2025, ήταν Apache 2.0. Η έκδοση 2.1 όχι.
Πώς να γράψετε prompt για το Qwen-Image 2.1
Γράψτε προτάσεις, όχι ετικέτες. Ο κωδικοποιητής κειμένου είναι γλωσσικό μοντέλο. Διαβάζει τη σειρά των λέξεων, τις προθέσεις και τα εισαγωγικά, και παίρνει τα πάντα κυριολεκτικά. Ένα «lighthouse cat» γίνεται μια γάτα ζωγραφισμένη πάνω σε φάρο.
Η παρακάτω δομή έδωσε τα καλύτερα αποτελέσματα σε περίπου χίλιες εικόνες. Κρατήστε αυτή τη σειρά.
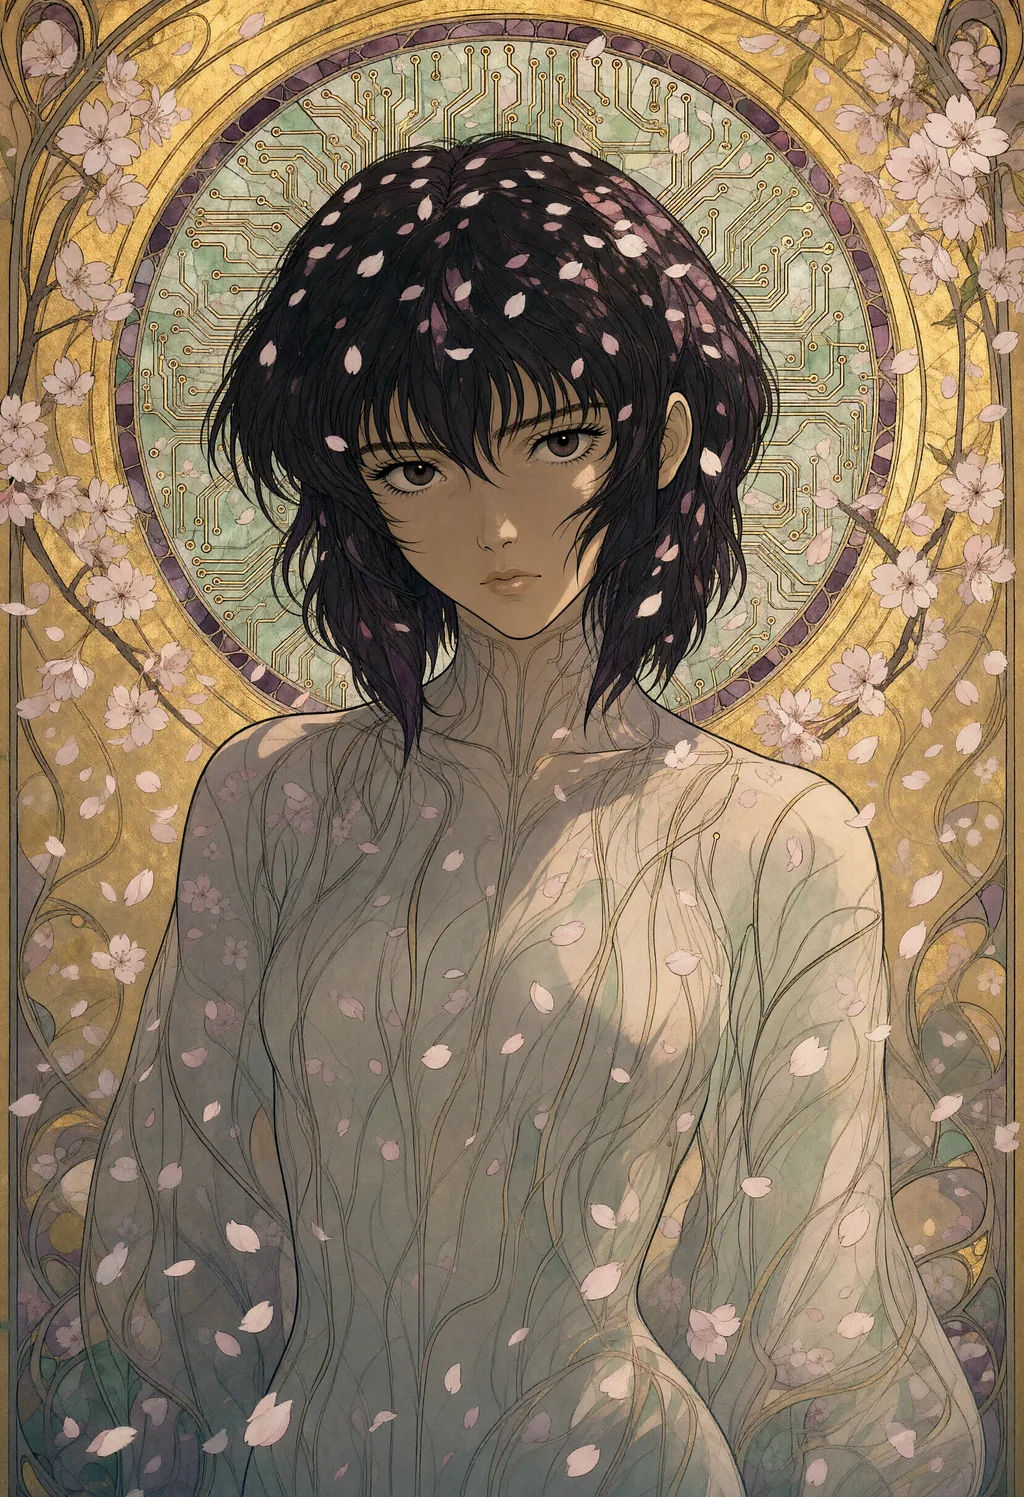
- Μέσο και θέμα πρώτα: «An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms». Το μέσο που ορίζεται στην αρχή χρωματίζει ό,τι ακολουθεί.
- Σκηνικό: τόπος, εποχή, καιρός, ή ό,τι γεμίζει τον αέρα. «in falling cherry blossoms», «in the 1980s», «during a blizzard».
- Φως με την κατεύθυνσή του: «lit from the front by soft diffuse light, with gentle shadows». Η κατεύθυνση ακολουθείται. Ένα σκέτο «dramatic light» όχι.
- Κάδρο: «close-up of the subject, looking at the viewer», medium shot, από ψηλά, το θέμα μικροσκοπικό μέσα σε απέραντο τοπίο.
- Υλικά και παλέτα: «flowing ink lines, flat gold leaf background, muted jade and plum». Αυτό είναι που αποδίδει καλύτερα το μοντέλο στα 2K.
- Περιορισμοί, γραμμένοι μέσα στο prompt: «no lettering, no watermark», «five fingers on each hand». Με καθοδήγηση 1 το αρνητικό prompt αγνοείται, οπότε πρέπει να τους κουβαλά το ίδιο το prompt.
Ολόκληρο το prompt της παραπάνω εικονογράφησης, με αυτή τη σειρά: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Το κείμενο δουλεύει όταν είναι σε εισαγωγικά και τοποθετημένο. Το «A banner above the door reads 'OPEN ALL NIGHT'» βγαίνει σωστό σχεδόν κάθε φορά, με κεφαλαία ή όχι.
Ισχύει και το αντίστροφο. Μια βιτρίνα, ένα diner ή μια αίθουσα ηλεκτρονικών χωρίς ζητούμενο κείμενο θα βγάλει μια επινοημένη επιγραφή. Οπότε πείτε «no lettering» όποτε η σκηνή περιέχει πρόσοψη.
Οι χαρακτήρες που το μοντέλο δεν γνωρίζει αντικαθίστανται από έναν σωσία, χωρίς προειδοποίηση. Ο Marsupilami έγινε μαϊμού. Η Mothra και ο Marvin the Martian βγήκαν σωστά.
Κάθε κάρτα Qwen στη σελίδα με τα παραδείγματα prompt ακολουθεί αυτή τη δομή, με το seed, το μέγεθος και τις ρυθμίσεις της.
Ρυθμίσεις που δουλεύουν, μετρημένες
Το επίσημο πρότυπο του ComfyUI τρέχει με καθοδήγηση (CFG) 1 και 25 βήματα. Η κάρτα του μοντέλου χρησιμοποιεί 40 βήματα. Οι παρακάτω ρυθμίσεις κατέληξαν σε CFG 3.
Στην τελευταία δοκιμή, στις 16 Οκτωβρίου 2026, με τα ίδια seed, αυτές οι ρυθμίσεις έδωσαν τις πιο λεπτομερείς και τις πιο πιστές εικόνες:
| Ρύθμιση | Τιμή |
|---|---|
| Καθοδήγηση (CFG) | 3, με αρνητικό prompt |
| Αρνητικό prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Patches μοντέλου | APG (eta 1, norm threshold 10, momentum 0.3) και μετά FreSca (low 1, high 2, cutoff 8), πριν από τον δειγματολήπτη |
| Δειγματολήπτης | euler, scheduler simple |
| Βήματα | 25 στο 1 megapixel, 20 στα 2.5 και στα 4 megapixel |
| LoRA | κανένα |
Η καθοδήγηση είναι η μόνη ρύθμιση που δεν αλλάζει τη σκηνή. Με το ίδιο seed και μέγεθος, CFG 1 και CFG 3 δίνουν σχεδόν την ίδια σύνθεση. Αυτό που διαφέρει είναι η απόδοση.
Στο CFG 1 η εικόνα είναι πιο επίπεδη και χάνει τη λεπτή υφή. Οι βελονιές του κεντήματος γίνονται ύφασμα. Ένα πρόσωπο καρτούν χάνει τις κόρες και το στόμα του. Το μέταλλο χάνει τα πριτσίνια του.
Το ανέβασμα του CFG 1 στα 30 βήματα φέρνει πίσω την ευκρίνεια, αλλά όχι τα υλικά ούτε την αντίθεση. Στα 2 megapixel, μέγεθος που δοκιμάστηκε μία φορά, τα 40 βήματα δίνουν καθαρή εικόνα που παραμένει πιο επίπεδη, και το μοντέλο διαβάζει το prompt λιγότερο αξιόπιστα.
Το APG εμποδίζει το CFG 3 να υπερκορεστεί. Το FreSca οξύνει τις υψηλές συχνότητες. Και τα δύο δρουν μόνο όταν η καθοδήγηση είναι πάνω από 1.
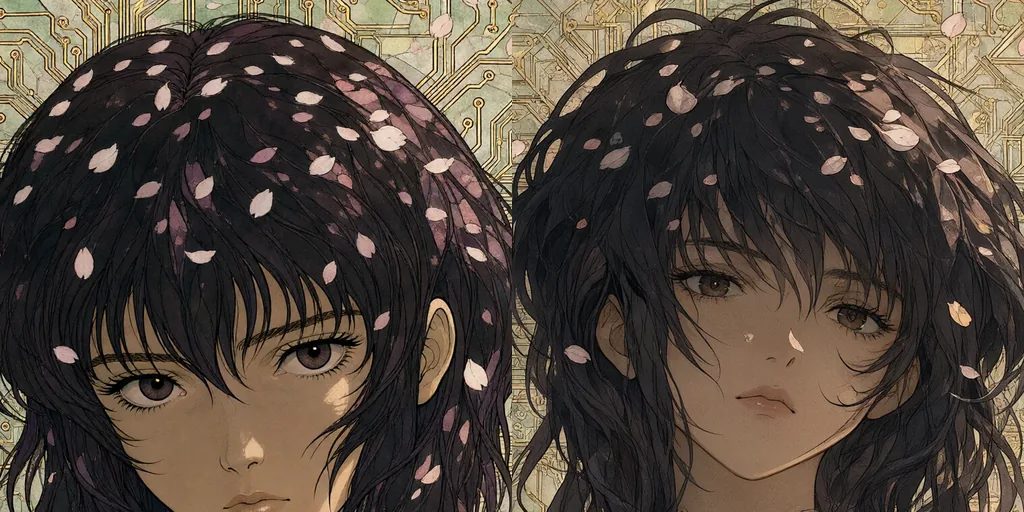
Η καθοδήγηση πάνω από 1 κοστίζει ένα δεύτερο πέρασμα ανά βήμα, οπότε το CFG 1 είναι δύο φορές πιο γρήγορο. Στην κάρτα της δοκιμής αυτό σημαίνει 120 έως 135 δευτερόλεπτα έναντι 255 έως 275 για εικόνα 4 megapixel. Το πιο αργό άξιζε τον κόπο σε καθένα από τα δέκα ζεύγη δοκιμής.
Ανάλυση και βήματα: τι αλλάζει την εικόνα
Όπως κάθε μοντέλο διάχυσης, το Qwen-Image 2.1 δεν αλλάζει τις διαστάσεις μιας εικόνας όταν αλλάζει το μέγεθος. Παράγει μια άλλη λήψη του ίδιου seed, οπότε ένα seed που βρέθηκε στο 1 megapixel δεν μεταφέρεται στα 2K.
Το πέρασμα από το 1 megapixel στα 2.5 ή στα 4 έδωσε διαφορετική εικόνα σε κάθε ζεύγος που δοκιμάστηκε. Ανάμεσα στα 2.5 και στα 4 megapixel η σύνθεση κράτησε σε οκτώ ζεύγη στα δέκα.
Στην παρακάτω εικονογράφηση μετακινήθηκαν μόνο οι λεπτομέρειες. Στα 2.5 megapixel οι διαδρομές κυκλωμάτων άφησαν το φωτοστέφανο για τα μαλλιά.
Η αλλαγή του αριθμού βημάτων αλλάζει επίσης την εικόνα μόλις η διαφορά μεγαλώσει. 20 και 25 βήματα δίνουν σχεδόν την ίδια εικόνα. Τα 16 βήματα ξεφεύγουν. Δεν υπάρχει λοιπόν τρόπος να κάνετε προεπισκόπηση στο 1 megapixel και να αποδώσετε την ίδια εικόνα μεγαλύτερη. Διαλέξτε πρώτα το μέγεθος, μετά το seed.
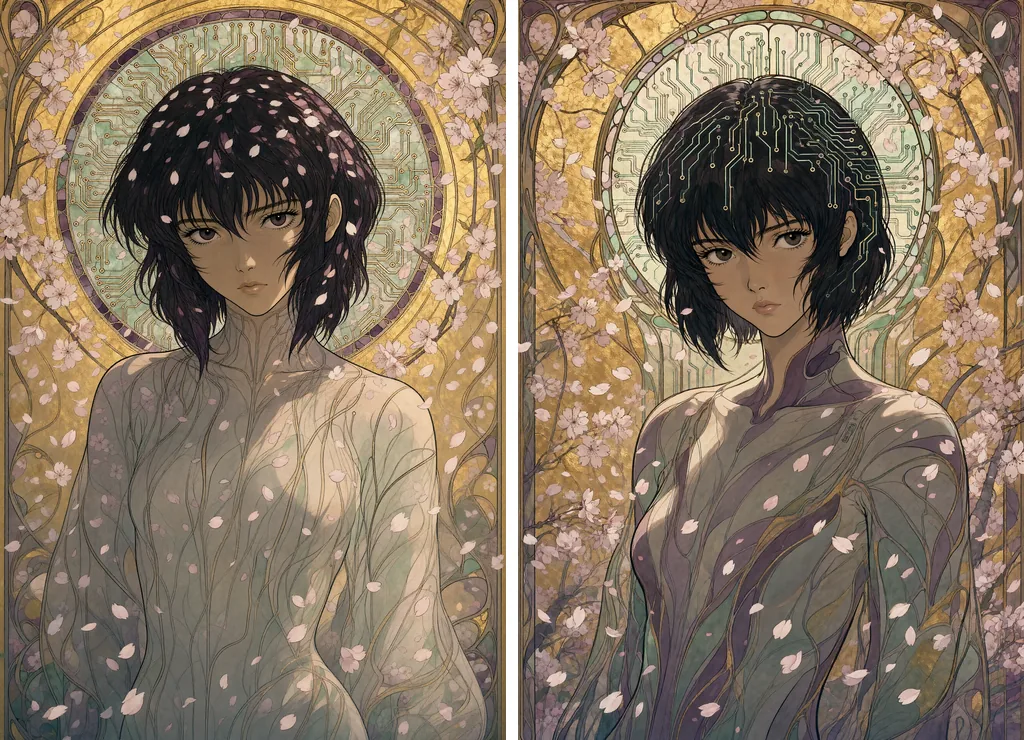
Χρόνοι μετρημένοι με CFG 3, APG και FreSca, βάρη int8, σε μία κάρτα καταναλωτικής κατηγορίας 16 GB, σε οριζόντιο προσανατολισμό ή στο κατακόρυφο αντίστοιχό του:
| Μέγεθος | Βήματα | Χρόνος ανά εικόνα |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | περίπου 40 δευτ. |
| 2.5 megapixel (1920 × 1312) | 20 | 120 έως 135 δευτ. |
| 4 megapixel (2432 × 1664) | 20 | 255 έως 275 δευτ. |
| 4 megapixel | 25 | 315 έως 335 δευτ. |
Στα 2.5 megapixel η λεπτομέρεια είναι λίγο πιο μαλακή απ' ό,τι στα 4 όταν συγκρίνεται η ίδια περιοχή στο 100 %. Αλλά το μοντέλο ακολουθεί το στυλ του prompt τουλάχιστον εξίσου καλά, και στα δέκα ζεύγη δοκιμής μερικές φορές καλύτερα. Ένα κέντημα έδειξε τις βελονιές του πιο καθαρά στα 2.5 megapixel απ' ό,τι στα 4.
Για γκαλερί που σερβίρεται στα 1024 pixel, τα 2.5 megapixel με 20 βήματα είναι το ιδανικό σημείο. Για εκτύπωση, 4 megapixel με 20 βήματα.
Επιταχύνσεις: Turbo, καθοδηγούμενο Turbo και τα υπόλοιπα
Το Turbo. Η Qwen κυκλοφόρησε το Qwen-Image-2.1-Turbo στις 9 Οκτωβρίου 2026. Είναι ένα αποσταγμένο checkpoint που τρέχει σε 8 βήματα με CFG 1 και σταθερό πρόγραμμα sigma. Η Comfy-Org το διαθέτει ως αρχείο int8 και ως LoRA για το βασικό μοντέλο, με δικά του πρότυπα στο ComfyUI. Μετρήθηκε στις 17 Οκτωβρίου με τα ίδια δέκα seed και μεγέθη με τις αποδόσεις CFG 3 αυτού του οδηγού, με το ακριβές γράφημα του προτύπου.
| Ρύθμιση | Χρόνος ανά εικόνα |
|---|---|
| Checkpoint Turbo, 8 βήματα, CFG 1, 1 megapixel | 9 έως 10 δευτ. |
| Checkpoint Turbo, 8 βήματα, CFG 1, 4 megapixel | 38 έως 39 δευτ. |
| Καθοδηγούμενο Turbo, όπως περιγράφεται παρακάτω: checkpoint Turbo, 8 βήματα, CFG 3 με APG και FreSca, 4 megapixel | 66 έως 71 δευτ. |
| Βασικό checkpoint με το Turbo LoRA, 8 βήματα, CFG 1, 4 megapixel | 52 έως 55 δευτ. |
| Βασικό checkpoint, CFG 3, 20 βήματα, 4 megapixel | 255 έως 275 δευτ. |
Επτά φορές πιο γρήγορο στα 4 megapixel, τέσσερις στο 1. Οι εικόνες είναι καθαρές: ευκρινείς, καλοφωτισμένες, χωρίς ολισθήματα ανατομίας στα δέκα seed, με σωστές επιγραφές στα ίδια prompt με το βασικό μοντέλο. Τα αντικείμενα του prompt είναι εκεί, μερικές φορές καλύτερα απ' ό,τι με το βασικό μοντέλο. Η χελώνα στο αγωνιστικό της αυτοκίνητο, που το βασικό μοντέλο είχε παραλείψει σε κάθε απόδοση, εμφανίστηκε με το Turbo.
Αυτό που χάνει είναι το μέσο. Σε κάθε μη φωτογραφικό prompt των δέκα seed, το αποσταγμένο μοντέλο γλίστρησε προς τον φωτογραφικό ρεαλισμό. Ένα κέντημα κροκόδειλου έγινε φωτογραφία κροκόδειλου. Ένα σχέδιο με κάρβουνο έχασε τον κόκκο του. Ένας Marvin the Martian από κομμένο χαρτί έγινε βινυλικό παιχνίδι. Οι επινοημένες επιγραφές στις προσόψεις είναι ίδιες με του βασικού μοντέλου.
Στα δέκα seed το LoRA πάνω στο βασικό checkpoint έδωσε τις ίδιες εικόνες με το checkpoint Turbo, απλώς πιο αργά. Οπότε το checkpoint είναι αυτό που πρέπει να κατεβάσετε. Ένα seed δίνει διαφορετική εικόνα από το βασικό μοντέλο, όπως με κάθε αλλαγή μεγέθους. Η άδεια είναι η ίδια: μόνο για έρευνα και αξιολόγηση.
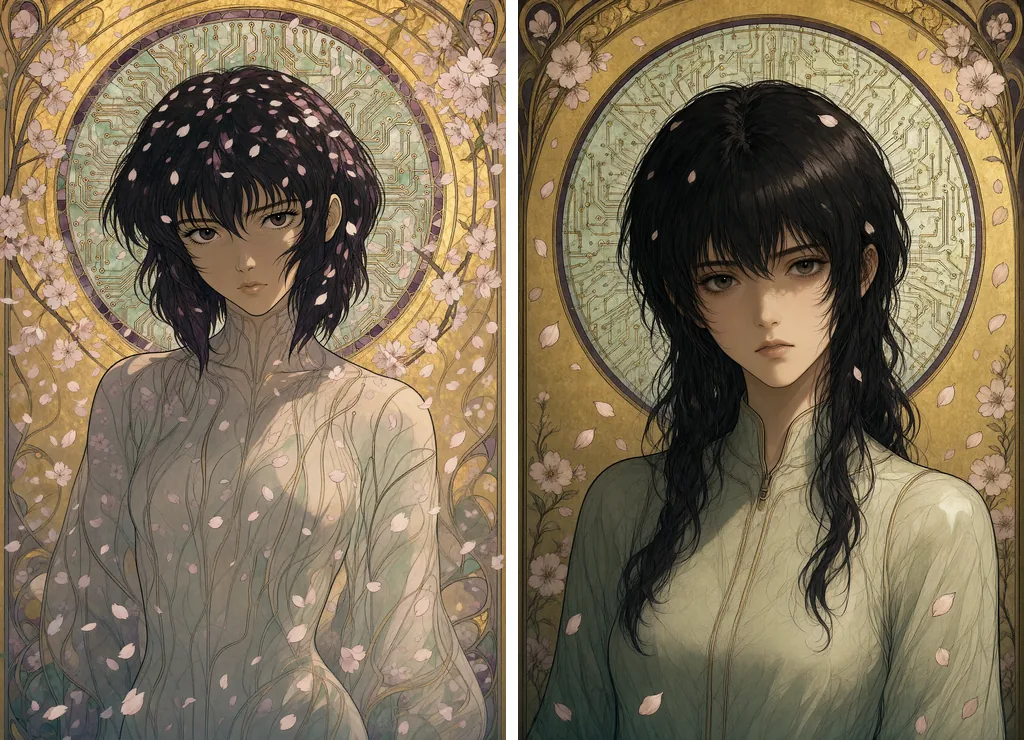
Το καθοδηγούμενο Turbo. Το Turbo δεν είναι κλειδωμένο στο CFG 1. Δοκιμάστηκε στις 17 Οκτωβρίου 2026 στα ίδια δέκα seed συν την εικονογράφηση αυτού του οδηγού. Κρατήστε το checkpoint του και τα 8 σταθερά sigma του, και πάρτε μόνο το μπλοκ καθοδήγησης της βασικής ρύθμισης: CFG 3, το αρνητικό prompt, APG και μετά FreSca.
Το γράφημα είναι το ίδιο το πρότυπο Turbo. Ορίστε τον CFGGuider του σε 3 αντί για 1, συμπληρώστε το αρνητικό prompt, και παρεμβάλετε APG και μετά FreSca στη διαδρομή του μοντέλου ανάμεσα στον loader και στον guider. Ο κόμβος ManualSigmas και ο δειγματολήπτης μένουν όπως είναι.
Το αποτέλεσμα κρατά τη σύνθεση του Turbo και ανακτά ό,τι είχε ισοπεδώσει το CFG 1: αντίθεση, κορεσμό και λεπτή λεπτομέρεια. Στην εικονογράφηση αυτού του οδηγού, οι διαδρομές κυκλωμάτων του φωτοστέφανου επιστρέφουν ευκρινείς και επίχρυσες, και τα πέταλα επιστρέφουν. Στα δέκα seed δοκιμής, τα λέπια, η γούνα και το κεντημένο γιλέκο οξύνονται με τον ίδιο τρόπο. Αυτό που δεν ανακτά είναι το μέσο. Το κέντημα παραμένει φωτογραφία κροκόδειλου.
Το κόστος είναι το δεύτερο πέρασμα ανά βήμα: 66 έως 71 δευτερόλεπτα για εικόνα 4 megapixel έναντι 38 έως 39. Αυτό παραμένει σχεδόν τέσσερις φορές πιο γρήγορο από το βασικό μοντέλο.
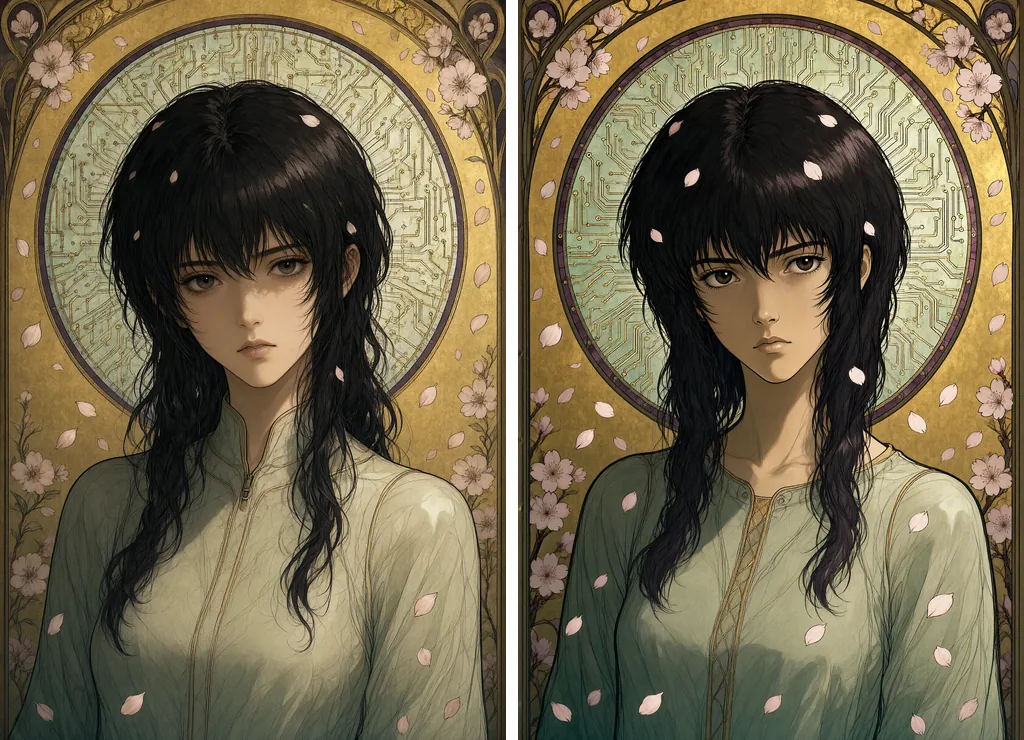
Κατεβάστε το workflow. Το workflow ComfyUI του καθοδηγούμενου Turbo (JSON) αποδίδει αυτή την εικονογράφηση όπως ακριβώς είναι: 1664 × 2432, seed 57658043, CFG 3 με APG και FreSca, το αρνητικό prompt αυτού του οδηγού. Σύρετε το αρχείο μέσα στο ComfyUI· περιμένει τα τρία αρχεία μοντέλου που αναφέρονται στην τελευταία ενότητα. Ελεύθερο για επαναχρησιμοποίηση με άδεια CC BY 4.0, με σύνδεσμο προς αυτή τη σελίδα.
Μην προσπαθήσετε να βοηθήσετε το Turbo με περισσότερα βήματα. Με 20 βήματα και scheduler simple στα 4 megapixel και CFG 3, σαν να ήταν το βασικό μοντέλο, παραψήνεται: σκληρές τούφες μαλλιών, κοκκώδες φωτοστέφανο, τραβηγμένη αντίθεση. Και χρειάζεται 169 δευτερόλεπτα. Το αποσταγμένο checkpoint θέλει τα 8 sigma του.
Ένας λογικός καταμερισμός. Το σκέτο Turbo ως λειτουργία προσχεδίου, με επτά φορές περισσότερους υποψήφιους την ώρα για να διαλέξετε. Το καθοδηγούμενο Turbo όταν ένα φωτογραφικό prompt ή ένα prompt με καθαρές γραμμές χρειάζεται λεπτομέρεια γρήγορα. Το βασικό μοντέλο με CFG 3 για οτιδήποτε ζωγραφισμένο, σχεδιασμένο ή χειροποίητο, όπου το ίδιο το μέσο είναι το ζητούμενο.
Άλλες αποστάξεις. Η LightX2V δημοσίευσε ένα Lightning LoRA 4 βημάτων για το 2.1 στις 13 Οκτωβρίου 2026. Υπάρχει επίσης ένα κοινοτικό LoRA 8 βημάτων, το Turbo8. Και τα δύο τρέχουν με CFG 1 όπως το Turbo. Κανένα από τα δύο δεν έχει μετρηθεί εδώ.
Ο κόμβος της προσωρινής μνήμης προθέματος. Ο κόμβος QwenImage21Cache του ComfyUI ορίζει μόνο τη συσκευή και την ακρίβεια της προσωρινής μνήμης που το μοντέλο ήδη κρατά. Με τις προεπιλογές του δεν αλλάζει τίποτα. Η λειτουργία int8 μειώνει στο μισό την προσωρινή μνήμη, κάτι που βοηθά όταν η μνήμη στενεύει στα 2K ή στην επεξεργασία με πολλές εικόνες αναφοράς. Καμία ορατή απώλεια δεν εμφανίστηκε με αυτήν σε αυτές τις δοκιμές.
Λιγότερα βήματα. Τα 16 βήματα εξοικονομούν περίπου το ένα πέμπτο του χρόνου, αλλά αλλάζουν τη σύνθεση και δεν κερδίζουν ευκρίνεια σε σχέση με τα 20. Αν ο χρόνος είναι ο περιορισμός, χαμηλώστε πρώτα το μέγεθος και μετά τα βήματα.
Εκτέλεση του Qwen-Image 2.1 τοπικά
Το ComfyUI υποστηρίζει το μοντέλο εγγενώς. Τρία αρχεία πάνε στους συνηθισμένους φακέλους: το μοντέλο διάχυσης στον diffusion_models, ο κωδικοποιητής κειμένου Qwen3-VL στον text_encoders, το VAE στον vae.
Σε κάρτα 16 GB, πάρτε τις εκδόσεις int8 που δημοσίευσε η Comfy-Org. Τα βάρη bf16 δουλεύουν επίσης, αλλά ξεχειλίζουν στη μνήμη του συστήματος και παίρνουν δύο έως έξι φορές περισσότερο χρόνο χωρίς ορατό κέρδος.
Το γράφημα είναι σύντομο:
- UNETLoader, CLIPLoader με τύπο
qwen_image, VAELoader· - TextEncodeQwenImage21, που παίρνει μαζί το prompt και το αρνητικό prompt και βγάζει και τα δύο conditioning·
- ένα κενό latent στο επιλεγμένο μέγεθος·
- APG και μετά FreSca στη διαδρομή του μοντέλου·
- ένας KSampler με CFG 3, euler και scheduler simple, και μετά VAEDecode.
Για διαφανή εικόνα, τυλίξτε το θέμα στη μορφή που συνιστά η κάρτα του μοντέλου: «This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.» Μετά αποθηκεύστε ως PNG.
Μνήμη: στο 1 megapixel, το μοντέλο int8, ο κωδικοποιητής και το VAE τρέχουν σε 16 GB χωρίς να αγγίξουν τη μνήμη του συστήματος. Το ComfyUI βγάζει τον κωδικοποιητή από τη μνήμη βίντεο μόλις κωδικοποιηθεί το prompt. Στα 4 megapixel η προσωρινή μνήμη προθέματος ορίστηκε σε int8, και η μνήμη δεν εξαντλήθηκε ποτέ. Η πρώτη εικόνα μιας συνεδρίας παίρνει περισσότερο χρόνο όσο φορτώνονται τα αρχεία.