Qwen-Image 2.1 là gì
Qwen-Image 2.1 là một checkpoint làm hai việc. Nó tạo ảnh từ văn bản, và chỉnh sửa một bức ảnh có sẵn bằng một câu cùng tối đa mười ảnh tham chiếu. Phần tạo ảnh là một diffusion transformer 7 tỷ tham số. Nó đi kèm bộ mã hóa văn bản Qwen3-VL 8B, được nạp trong ComfyUI dưới dạng một tệp riêng.
Chính nhờ bộ mã hóa là một mô hình ngôn ngữ mà nó đọc được trọn câu, chỉ dẫn bố cục và các từ đặt trong ngoặc kép, thay vì danh sách từ khóa.
Qwen giới thiệu 2.1 là bản cải thiện về chất liệu bề mặt, kiểu chữ và ánh sáng chân dung. Nó chạy ở 2K gốc không cần upscaler: 2048 × 2048 cho ảnh vuông, 2528 × 1696 cho tỷ lệ 3:2, 2752 × 1536 cho 16:9. Nó cũng có thể xuất kênh alpha thật sự khi prompt yêu cầu nền trong suốt.
Cái giá phải trả là thời gian. Trên card phổ thông 16 GB VRAM, trọng số int8 mất khoảng 40 giây cho một ảnh 1 megapixel. Một ảnh 4 megapixel mất khoảng bốn phút rưỡi với các thiết lập bên dưới.
Một điều cần biết trước khi tải về. Trọng số được phát hành theo Qwen Research License: chỉ dành cho nghiên cứu và đánh giá. Mọi mục đích thương mại đều cần một giấy phép riêng từ Qwen. Qwen-Image đầu tiên, phát hành tháng 8 năm 2025, theo Apache 2.0. Phiên bản 2.1 thì không.
Cách viết prompt cho Qwen-Image 2.1
Hãy viết thành câu, đừng viết tag. Bộ mã hóa văn bản là một mô hình ngôn ngữ. Nó đọc trật tự từ, giới từ và dấu ngoặc kép, và hiểu mọi thứ theo nghĩa đen. “lighthouse cat” sẽ thành một con mèo vẽ trên ngọn hải đăng.
Cấu trúc dưới đây cho kết quả tốt nhất sau khoảng một nghìn bức ảnh. Hãy giữ đúng thứ tự này.
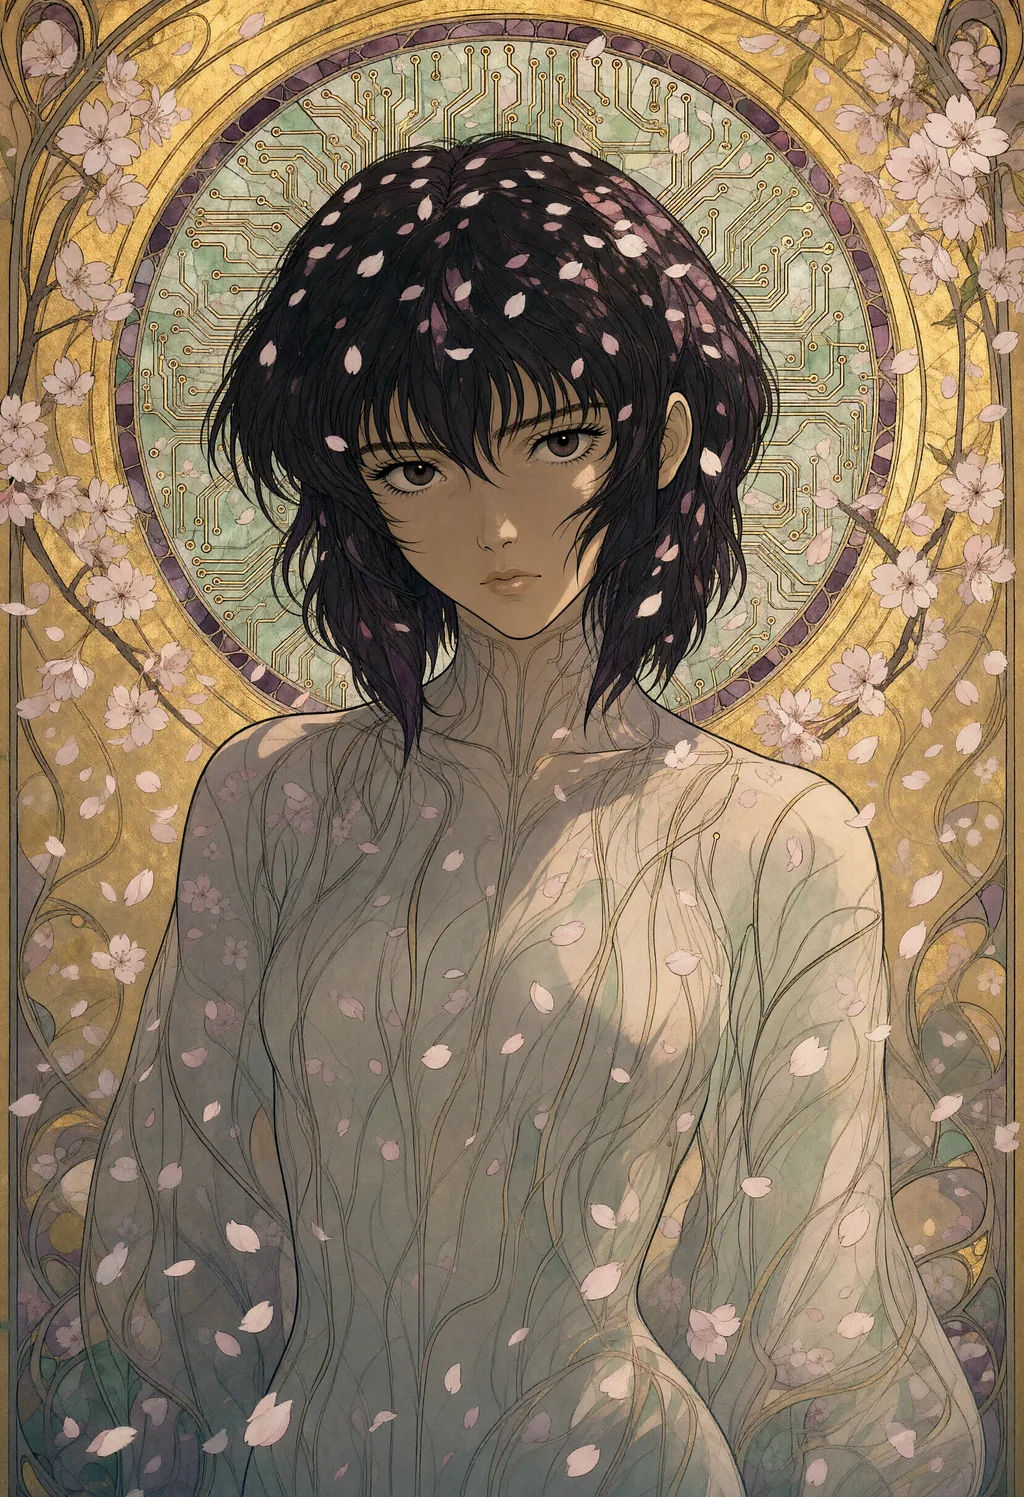
- Chất liệu và chủ thể trước tiên: “An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. Chất liệu đặt ở đầu sẽ nhuộm màu mọi thứ theo sau.
- Bối cảnh: nơi chốn, thời đại, thời tiết, hoặc thứ đang lấp đầy không trung. “in falling cherry blossoms”, “in the 1980s”, “during a blizzard”.
- Ánh sáng kèm hướng chiếu: “lit from the front by soft diffuse light, with gentle shadows”. Hướng chiếu được tuân theo. Một câu “dramatic light” trơ trọi thì không.
- Khung hình: “close-up of the subject, looking at the viewer”, trung cảnh, nhìn từ trên cao, chủ thể bé xíu giữa một khung cảnh mênh mông.
- Vật liệu và bảng màu: “flowing ink lines, flat gold leaf background, muted jade and plum”. Đây là thứ mô hình thể hiện đẹp nhất ở 2K.
- Các giới hạn, viết ngay trong prompt: “no lettering, no watermark”, “five fingers on each hand”. Ở guidance 1, negative prompt bị bỏ qua, nên chính prompt phải gánh những điều này.
Toàn bộ prompt của bức minh họa phía trên, theo đúng thứ tự ấy: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Chữ sẽ ra đúng khi được đặt trong ngoặc kép và chỉ rõ vị trí. “A banner above the door reads 'OPEN ALL NIGHT'” gần như lần nào cũng đúng, viết hoa hay không cũng vậy.
Điều ngược lại cũng đúng. Một mặt tiền cửa hàng, một quán ăn hay một tiệm trò chơi mà không yêu cầu chữ sẽ tự mọc ra một tấm biển bịa đặt. Vì vậy hãy ghi “no lettering” mỗi khi cảnh có mặt tiền nhà.
Nhân vật nào mô hình không biết sẽ bị thay bằng một hình tương tự mà không báo trước. Marsupilami thành một con khỉ. Mothra và Marvin the Martian ra đúng.
Mọi thẻ Qwen trên trang prompt mẫu đều theo cấu trúc này, kèm seed, kích thước và thiết lập.
Những thiết lập hiệu quả, đã đo
Template ComfyUI chính thức chạy ở guidance (CFG) 1 với 25 bước. Model card dùng 40 bước. Các thiết lập bên dưới dừng lại ở CFG 3.
Thử nghiệm lần cuối ngày 16 tháng 10 năm 2026, trên cùng các seed, các thiết lập sau cho ảnh chi tiết nhất và bám prompt nhất:
| Thiết lập | Giá trị |
|---|---|
| Guidance (CFG) | 3, kèm negative prompt |
| Negative prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Các patch mô hình | APG (eta 1, norm threshold 10, momentum 0.3) rồi FreSca (low 1, high 2, cutoff 8), đặt trước sampler |
| Sampler | euler, scheduler simple |
| Số bước | 25 ở 1 megapixel, 20 ở 2.5 và 4 megapixel |
| LoRA | không |
Guidance là thiết lập duy nhất không làm đổi cảnh. Cùng seed và kích thước, CFG 1 và CFG 3 cho bố cục gần như giống hệt. Khác nhau là ở cách thể hiện.
Ở CFG 1 ảnh phẳng hơn và mất các chi tiết chất liệu nhỏ. Mũi thêu biến thành vải. Mặt nhân vật hoạt hình mất con ngươi và miệng. Kim loại mất đinh tán.
Đẩy CFG 1 lên 30 bước lấy lại được độ nét, nhưng không lấy lại được vật liệu lẫn độ tương phản. Ở 2 megapixel, một kích thước chỉ thử một lần, 40 bước cho ảnh sạch nhưng vẫn phẳng hơn, và đọc prompt kém ổn định hơn.
APG giữ cho CFG 3 không bị quá bão hòa. FreSca làm nét các tần số cao. Cả hai chỉ có tác dụng khi guidance lớn hơn 1.
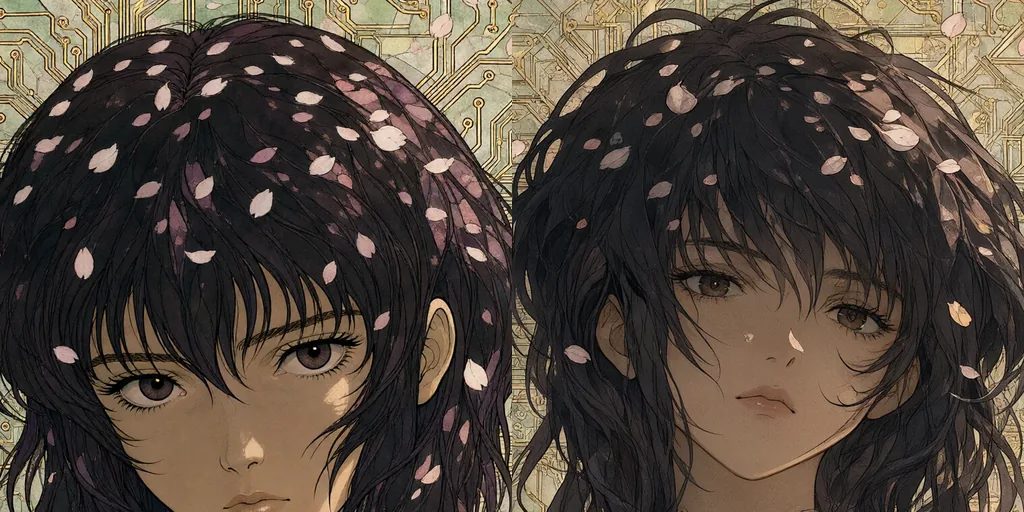
Guidance trên 1 tốn thêm một lượt tính mỗi bước, nên CFG 1 nhanh gấp đôi. Trên card thử nghiệm, đó là 120 đến 135 giây so với 255 đến 275 giây cho một ảnh 4 megapixel. Trong cả mười cặp thử nghiệm, bản chậm hơn đều đáng giá.
Độ phân giải và số bước: điều gì làm thay đổi bức ảnh
Như mọi mô hình diffusion, Qwen-Image 2.1 không phóng to hay thu nhỏ ảnh khi kích thước thay đổi. Nó tạo ra một phiên bản khác của cùng seed, nên seed tìm được ở 1 megapixel không dùng lại được ở 2K.
Đi từ 1 megapixel lên 2.5 hay 4 cho một bức khác trong mọi cặp đã thử. Giữa 2.5 và 4 megapixel, bố cục giữ nguyên ở tám trên mười cặp.
Trong bức minh họa bên dưới, chỉ có chi tiết là dịch chuyển. Ở 2.5 megapixel, những đường mạch điện rời vầng hào quang để chuyển sang mái tóc.
Đổi số bước cũng làm đổi ảnh khi chênh lệch đủ lớn. 20 và 25 bước cho gần như cùng một bức. 16 bước thì lệch đi. Vì vậy không có cách nào xem trước ở 1 megapixel rồi tạo lại đúng bức ấy ở cỡ lớn hơn. Hãy chọn kích thước trước, rồi mới chọn seed.
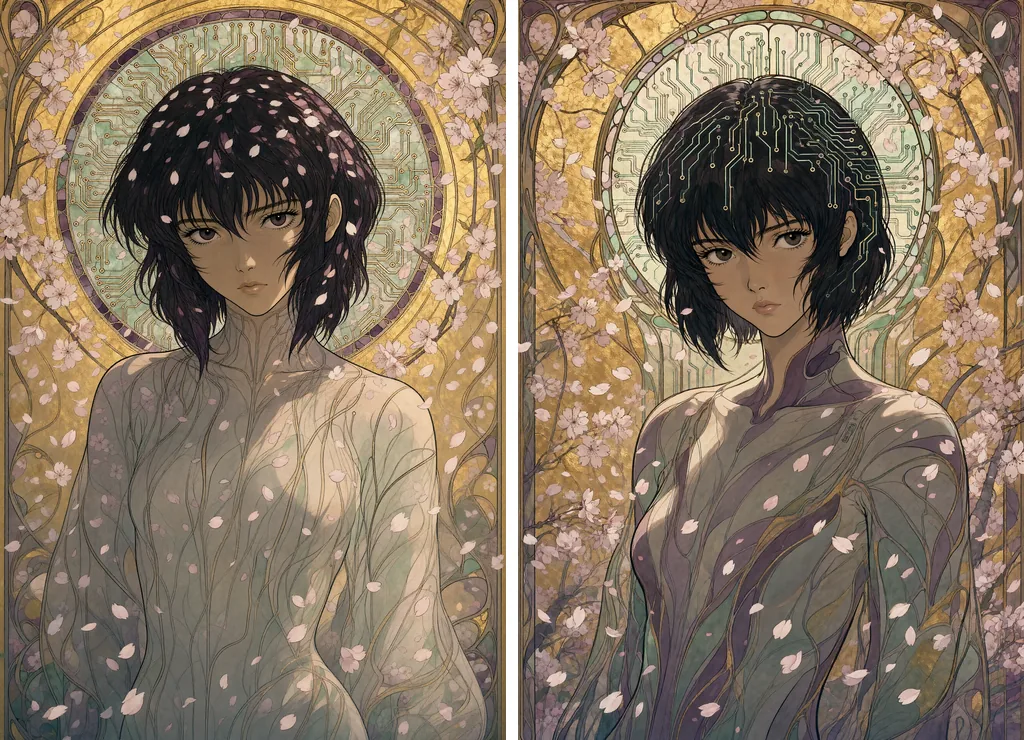
Thời gian đo với CFG 3, APG và FreSca, trọng số int8, trên một card phổ thông 16 GB, ở khổ ngang hoặc khổ dọc tương đương:
| Kích thước | Số bước | Thời gian mỗi ảnh |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | khoảng 40 giây |
| 2.5 megapixel (1920 × 1312) | 20 | 120 đến 135 giây |
| 4 megapixel (2432 × 1664) | 20 | 255 đến 275 giây |
| 4 megapixel | 25 | 315 đến 335 giây |
Ở 2.5 megapixel, chi tiết hơi mềm hơn so với 4 khi so cùng một vùng ở 100%. Nhưng mô hình bám phong cách của prompt ít nhất cũng tốt bằng, và trong mười cặp thử nghiệm đôi khi còn tốt hơn. Một bức thêu cho thấy mũi chỉ rõ hơn ở 2.5 megapixel so với 4.
Với một thư viện hiển thị ở 1024 pixel, 2.5 megapixel với 20 bước là điểm tối ưu. Để in, 4 megapixel với 20 bước.
Tăng tốc: Turbo, Turbo có guidance và phần còn lại
Bản Turbo. Qwen phát hành Qwen-Image-2.1-Turbo ngày 9 tháng 10 năm 2026. Đây là một checkpoint chưng cất chạy 8 bước ở CFG 1 với lịch sigma cố định. Comfy-Org cung cấp nó dưới dạng tệp int8 và dạng LoRA cho mô hình gốc, có template riêng trong ComfyUI. Nó được đo ngày 17 tháng 10 trên cùng mười seed và kích thước như các bản CFG 3 của hướng dẫn này, với đúng đồ thị của template.
| Thiết lập | Thời gian mỗi ảnh |
|---|---|
| Checkpoint Turbo, 8 bước, CFG 1, 1 megapixel | 9 đến 10 giây |
| Checkpoint Turbo, 8 bước, CFG 1, 4 megapixel | 38 đến 39 giây |
| Turbo có guidance, mô tả bên dưới: checkpoint Turbo, 8 bước, CFG 3 với APG và FreSca, 4 megapixel | 66 đến 71 giây |
| Checkpoint gốc cộng LoRA Turbo, 8 bước, CFG 1, 4 megapixel | 52 đến 55 giây |
| Checkpoint gốc, CFG 3, 20 bước, 4 megapixel | 255 đến 275 giây |
Nhanh gấp bảy lần ở 4 megapixel, gấp bốn ở 1. Ảnh sạch: nét, sáng đẹp, không lỗi giải phẫu nào trên mười seed, chữ đúng với cùng các prompt như mô hình gốc. Các đối tượng trong prompt đều có mặt, đôi khi còn tốt hơn mô hình gốc. Con rùa trong chiếc xe đua, thứ mà mô hình gốc bỏ sót trong mọi lần tạo, đã xuất hiện với Turbo.
Thứ nó đánh mất là chất liệu. Trên mọi prompt không phải ảnh chụp trong mười seed, mô hình chưng cất đều trôi về phía ảnh chụp thực tế. Một bức thêu cá sấu thành ảnh chụp cá sấu. Một bức vẽ than mất đi chất hạt. Một Marvin the Martian cắt giấy biến thành đồ chơi nhựa vinyl. Chữ bịa trên mặt tiền nhà thì giống hệt mô hình gốc.
Trên mười seed, LoRA trên checkpoint gốc cho ảnh y như checkpoint Turbo, chỉ chậm hơn. Nên checkpoint mới là thứ nên tải về. Cùng một seed cho bức khác với mô hình gốc, như mọi lần đổi kích thước. Giấy phép vẫn vậy: chỉ dành cho nghiên cứu và đánh giá.
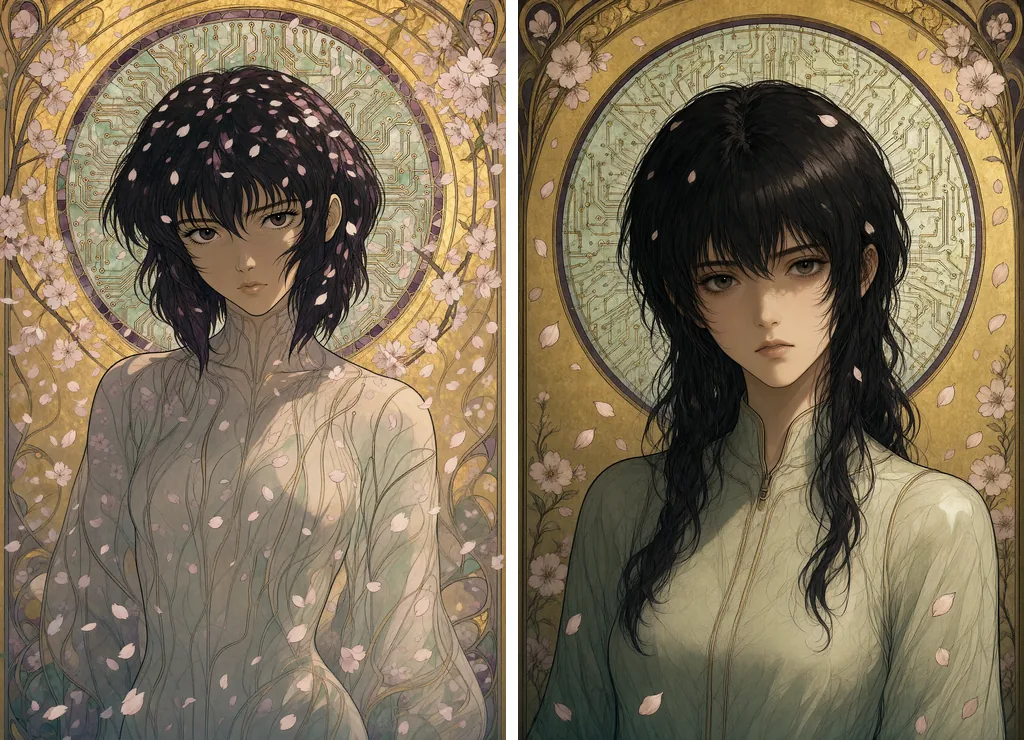
Turbo có guidance. Turbo không bị khóa ở CFG 1. Thử nghiệm ngày 17 tháng 10 năm 2026 trên cùng mười seed cộng với bức minh họa của hướng dẫn này. Giữ nguyên checkpoint và 8 sigma cố định của nó, chỉ lấy khối guidance của preset gốc: CFG 3, negative prompt, APG rồi FreSca.
Đồ thị chính là template Turbo. Đặt CFGGuider của nó thành 3 thay vì 1, điền negative prompt, và chèn APG rồi FreSca vào đường mô hình giữa loader và guider. Node ManualSigmas và sampler giữ nguyên.
Kết quả giữ bố cục của Turbo và lấy lại những gì CFG 1 đã làm phẳng: độ tương phản, độ bão hòa và chi tiết nhỏ. Trên bức minh họa của hướng dẫn này, những đường mạch điện của vầng hào quang trở lại sắc nét và ánh vàng, các cánh hoa cũng quay lại. Trên mười seed thử nghiệm, vảy, lông và chiếc áo gi-lê thêu cũng nét lên theo cùng cách. Thứ nó không lấy lại được là chất liệu. Bức thêu vẫn là một tấm ảnh chụp cá sấu.
Cái giá là lượt tính thứ hai mỗi bước: 66 đến 71 giây cho một ảnh 4 megapixel so với 38 đến 39. Vẫn nhanh gần gấp bốn lần mô hình gốc.
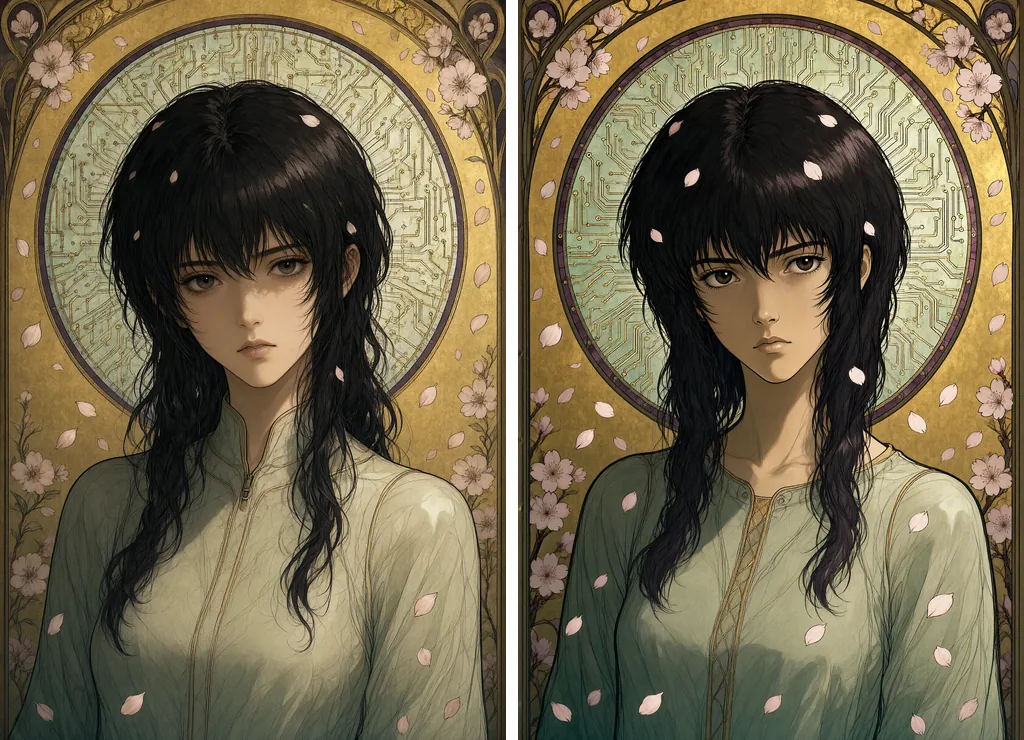
Tải workflow về. Workflow ComfyUI của Turbo có guidance (JSON) render đúng bức minh họa này như nguyên bản: 1664 × 2432, seed 57658043, CFG 3 với APG và FreSca, negative prompt của hướng dẫn này. Thả tệp vào ComfyUI; nó cần ba tệp mô hình được nêu tên ở phần cuối. Được tự do dùng lại theo CC BY 4.0, kèm liên kết đến trang này.
Đừng cố giúp Turbo bằng cách thêm bước. Cho nó 20 bước và scheduler simple ở 4 megapixel và CFG 3, như thể nó là mô hình gốc, nó bị quá lửa: sợi tóc cứng, vầng hào quang sạn, độ tương phản bị đẩy quá. Và mất 169 giây. Checkpoint chưng cất cần đúng 8 sigma của nó.
Một cách phân chia hợp lý. Turbo không guidance làm chế độ nháp, với số ứng viên mỗi giờ gấp bảy lần để chọn. Turbo có guidance khi một prompt kiểu ảnh chụp hay nét vẽ sạch cần chi tiết nhanh. Mô hình gốc ở CFG 3 cho mọi thứ thuộc loại tranh vẽ, hình vẽ tay hay thủ công, nơi chính chất liệu là điều cốt yếu.
Các bản chưng cất khác. LightX2V công bố một LoRA Lightning 4 bước cho 2.1 ngày 13 tháng 10 năm 2026. Cũng có một LoRA 8 bước của cộng đồng, Turbo8. Cả hai đều chạy ở CFG 1 như Turbo. Cả hai đều chưa được đo ở đây.
Node bộ nhớ đệm tiền tố. Node QwenImage21Cache của ComfyUI chỉ đặt thiết bị và độ chính xác cho bộ nhớ đệm mà mô hình vốn đã giữ. Ở giá trị mặc định nó không thay đổi gì. Chế độ int8 của nó giảm một nửa bộ nhớ đệm, giúp ích khi thiếu bộ nhớ ở 2K hoặc khi chỉnh sửa với nhiều ảnh tham chiếu. Không có suy giảm nào thấy được trong các thử nghiệm này.
Ít bước hơn. 16 bước tiết kiệm khoảng một phần năm thời gian, nhưng làm đổi bố cục và không nét hơn 20 bước. Nếu thời gian là giới hạn, hãy hạ kích thước trước khi hạ số bước.
Chạy Qwen-Image 2.1 trên máy của bạn
ComfyUI hỗ trợ sẵn mô hình này. Ba tệp đặt vào các thư mục quen thuộc: mô hình diffusion vào diffusion_models, bộ mã hóa văn bản Qwen3-VL vào text_encoders, VAE vào vae.
Trên card 16 GB, hãy lấy các bản int8 do Comfy-Org phát hành. Trọng số bf16 cũng chạy được, nhưng tràn sang bộ nhớ hệ thống và mất lâu gấp hai đến sáu lần mà không có lợi ích nào thấy được.
Đồ thị khá ngắn:
- UNETLoader, CLIPLoader với type
qwen_image, VAELoader; - TextEncodeQwenImage21, nhận cả prompt lẫn negative prompt và xuất ra cả hai conditioning;
- một latent rỗng ở kích thước đã chọn;
- APG rồi FreSca trên đường mô hình;
- một KSampler ở CFG 3 với euler và scheduler simple, rồi VAEDecode.
Để có ảnh trong suốt, bọc chủ thể trong dạng mà model card khuyến nghị: “This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.” Rồi lưu dưới dạng PNG.
Bộ nhớ: ở 1 megapixel, mô hình int8, bộ mã hóa và VAE chạy trong 16 GB mà không đụng đến bộ nhớ hệ thống. ComfyUI đưa bộ mã hóa ra khỏi VRAM sau khi prompt đã được mã hóa. Ở 4 megapixel, bộ nhớ đệm tiền tố được đặt ở int8 và chưa bao giờ hết bộ nhớ. Ảnh đầu tiên của một phiên mất lâu hơn trong lúc các tệp được nạp.