Qwen-Image là gì, nói ngắn gọn
Qwen-Image là nhánh tạo ảnh của Qwen, họ mô hình thuộc mảng đám mây của Alibaba. Nó ra mắt tháng 8 năm 2025 dưới dạng mô hình 20 tỷ tham số, giấy phép Apache 2.0, kèm một báo cáo kỹ thuật. Điểm nổi bật là chữ. Đoạn văn, biển hiệu và nhãn mác ra đọc được, bằng tiếng Anh và nhất là tiếng Trung, nơi Stable Diffusion 1.5 và SDXL chỉ cho ra nét nguệch ngoạc, còn các mô hình năm 2024 giỏi lắm được vài từ tiếng Anh.
Bản mở hiện tại là Qwen-Image 2.1, phát hành ngày 20 tháng 9 năm 2026. Đây là mô hình nhỏ hơn và nhanh hơn: 7 tỷ tham số cho phần tạo ảnh, cộng một bộ mã hóa thị giác-ngôn ngữ 8 tỷ tham số. Một checkpoint làm hai việc. Nó tạo ảnh từ văn bản, và sửa một bức ảnh có sẵn bằng một câu cùng tối đa mười ảnh tham chiếu. Nó xuất 2K gốc và ảnh trong suốt thật sự. Giấy phép không còn là Apache: chỉ dành cho nghiên cứu và đánh giá.
Giống Stable Diffusion và FLUX, đây là mô hình diffusion chạy trong ComfyUI trên card đồ họa phổ thông, và đọc cùng kiểu prompt. Khác biệt nằm ở bên trong, và đó là điều phần hoạt động như thế nào sẽ giải thích.
Qwen-Image 2.1 làm được gì
Text-to-image ở 2K gốc. Mô hình tạo trực tiếp ảnh vuông 2048 × 2048, 2528 × 1696 ở tỷ lệ 3:2 và 2752 × 1536 ở 16:9, không cần upscaler. Nó đọc prompt như một đoạn văn, nên câu, giới từ và chỉ dẫn bố cục đều có tác dụng, và chữ trong ngoặc kép hiện ra đúng như đã viết: “a banner above the door reads ‘OPEN ALL NIGHT’” ra đúng từng chữ trong các prompt thử nghiệm của hướng dẫn thiết lập. Hướng dẫn thiết lập đưa ra cấu trúc prompt hiệu quả nhất và các thiết lập đã đo.
Chỉnh sửa bằng cùng một checkpoint. Đưa nó một bức ảnh và một câu, nó sửa bức ảnh: thay một vật, đổi phong cách một cảnh, thêm chữ. Đưa nó tối đa mười ảnh tham chiếu, nó ghép lại, giữ một nhân vật hay một sản phẩm nhất quán qua các khung hình. Vùng cần sửa có thể chỉ bằng mặt nạ hoặc một vòng tròn vẽ tay. Không cần checkpoint inpainting riêng cho các chỉnh sửa cục bộ: cùng mô hình ấy nhận vùng đó làm gợi ý.
Xuất ảnh trong suốt. Yêu cầu một ảnh RGBA nền trong suốt, mô hình tạo kênh alpha thật, không phải ảnh cắt nền: VAE mã hóa và giải mã bốn kênh pixel thay vì ba. Logo, sticker và các tài nguyên phân lớp ra là dùng được ngay.
Viết lại prompt. Qwen cung cấp hai mô hình đi kèm, là các bản fine-tune của Qwen3.5-VL 9B, để mở rộng một prompt ngắn thành dạng chi tiết mà bộ tạo ảnh ưa thích, một cho tạo ảnh và một cho chỉnh sửa. ComfyUI đưa chúng vào template như một tùy chọn, tắt mặc định; không bắt buộc.
Tốc độ. Trên card phổ thông 16 GB, trọng số int8 mất khoảng 40 giây cho ảnh 1 megapixel và bốn đến năm phút cho 4 megapixel với thiết lập chất lượng của hướng dẫn thiết lập. Checkpoint Turbo chưng cất, phát hành ngày 9 tháng 10 năm 2026, tạo ảnh trong 8 bước, nhanh hơn khoảng bảy lần ở 4 megapixel, đổi lại là mất chất liệu: tranh vẽ, thêu và giấy cắt trôi về phía ảnh chụp.
Qwen-Image và Stable Diffusion: hoạt động như thế nào
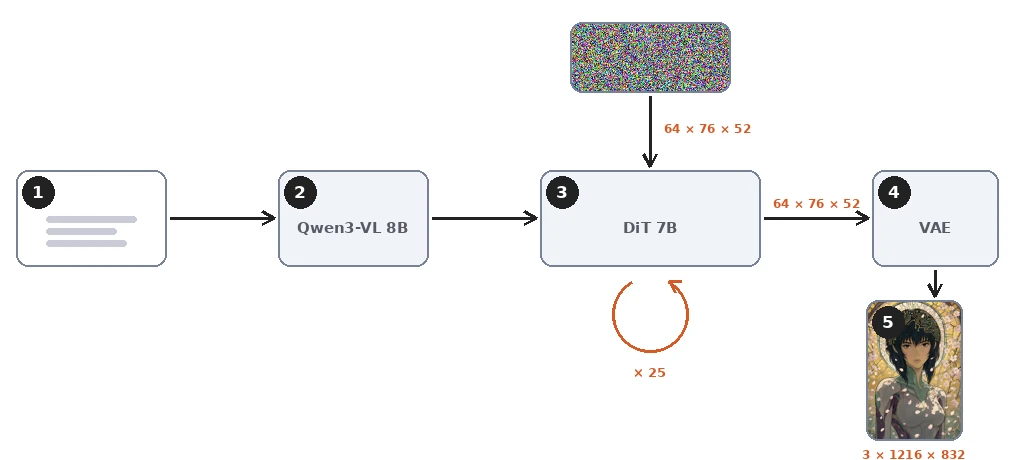
Qwen-Image 2.1 là mô hình diffusion, nên cơ chế được giải thích trong hướng dẫn Stable Diffusion áp dụng được ở đây. Một bộ mã hóa văn bản đọc prompt. Một bộ khử nhiễu làm việc trên một latent đã nén qua một số bước. Một bộ giải mã biến latent thành pixel. Khác biệt nằm ở lựa chọn cho từng phần trong ba phần đó. Kho mã của mô hình cung cấp các dữ kiện bên dưới; Qwen chưa công bố báo cáo kỹ thuật cho 2.1.
Mô hình thị giác-ngôn ngữ thay cho CLIP
Stable Diffusion 1.5 và SDXL đọc prompt bằng CLIP, một mạng được huấn luyện để khớp chú thích ngắn với ảnh. Qwen-Image 2.1 đọc bằng Qwen3-VL 8B, một mô hình thị giác-ngôn ngữ đầy đủ với tám tỷ tham số, nhiều hơn cả phần tạo ảnh. Cũng bộ mã hóa ấy đọc các ảnh tham chiếu khi chỉnh sửa. Đó là lý do cấu trúc prompt của hướng dẫn thiết lập hiệu quả. Câu, giới từ, chữ trong ngoặc kép và chỉ dẫn bố cục chính là thứ mô hình ngôn ngữ sinh ra để phân tích. Bộ mã hóa CLIP thì có xu hướng ép chúng thành một mớ khái niệm.
Transformer đơn luồng thay cho U-Net
Bộ khử nhiễu là một diffusion transformer 32 lớp và 7 tỷ tham số. SDXL dùng U-Net, các khối tích chập xen kẽ các lớp attention. Stable Diffusion 3 cũng chuyển sang transformer, MMDiT, trong đó token văn bản và token ảnh đi theo hai luồng với trọng số riêng và chỉ gặp nhau ở attention của mỗi lớp. Qwen-Image 2.1 đi xa hơn một bước: token văn bản và token ảnh hợp thành một chuỗi duy nhất và đi qua cùng một bộ trọng số, đó là nghĩa của “đơn luồng”. Qwen-Image đầu tiên năm 2025 là một MMDiT hai luồng 20 tỷ tham số; 2.1 chỉ bằng khoảng một phần ba cỡ đó.
Hai chi tiết trong attention của nó quan trọng trong thực tế. Token văn bản được đọc theo kiểu nhân quả, như trong mô hình ngôn ngữ, và mỗi ảnh, tham chiếu hay đang tạo, là một khối mà mọi token trong đó đều nhìn thấy nhau. Thứ tự là prompt trước, ảnh tham chiếu tiếp theo, ảnh đang tạo sau cùng, và một token không bao giờ nhìn vào thứ đến sau nó. Vì vậy prompt và các ảnh tham chiếu không bao giờ thấy bức ảnh đang được tạo, và phần tính toán thuộc về chúng, tiền tố, giống hệt nhau ở mọi bước: nó được tính một lần và lưu vào bộ nhớ đệm xuyên suốt các bước khử nhiễu. Node QwenImage21Cache của ComfyUI chỉ chọn bộ nhớ đệm ấy nằm ở đâu, với độ chính xác nào, hoặc có dùng hay không.
Latent 64 kênh, nén mười sáu lần
VAE của Stable Diffusion thu nhỏ ảnh tám lần mỗi chiều thành 4 kênh, 16 kênh ở phiên bản 3. VAE của Qwen-Image 2.1 thu nhỏ mười sáu lần mỗi chiều, thành 64 kênh. Nó cũng mã hóa và giải mã bốn kênh pixel, đỏ, lục, lam và alpha, thay vì ba, nhờ đó mô hình xuất được ảnh RGBA thật từ cùng latent 64 kênh ấy. Với ảnh 832 × 1216, latent có 64 kênh cỡ 52 × 76: khoảng 253.000 con số cho 3 triệu giá trị pixel, ít hơn mười hai lần.
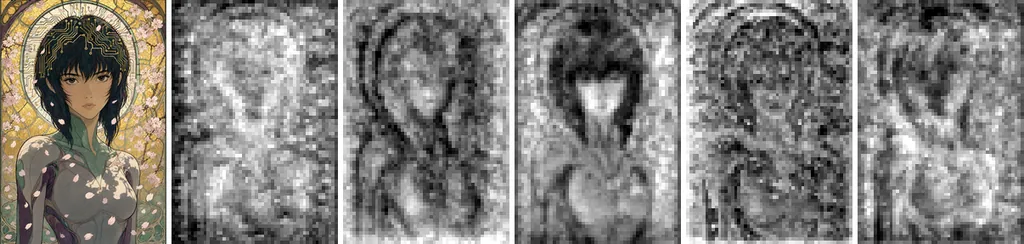
Mỗi vị trí latent là một token cho transformer, nên ảnh 1 megapixel là 3.952 token và ảnh 4 megapixel là 15.808 token. Lưới ấy không thô hơn lưới của Stable Diffusion 3 hay của Qwen-Image đầu tiên, vốn gom latent nén 8 lần của mình thành các ô 2 × 2 trước khi vào transformer. Điều 2.1 thay đổi là VAE tự làm việc gom đó, trong 64 kênh. Chi phí attention tăng theo bình phương số token, nên 4 megapixel tốn hơn nhiều so với bốn lần 1 megapixel.
Flow matching thay cho dự đoán nhiễu
Stable Diffusion 1.5 và SDXL được huấn luyện để dự đoán nhiễu đã thêm vào ảnh. Qwen-Image, như Stable Diffusion 3 và FLUX, được huấn luyện bằng flow matching. Mạng dự đoán hướng đi từ latent nhiễu về latent sạch, theo một đường thẳng. Sampler sau đó đi theo hướng ấy bằng các bước Euler. Kho mã gọi tên scheduler ấy: flow matching với các bước Euler rời rạc và shift động. Báo cáo Qwen-Image đầu tiên mô tả mục tiêu huấn luyện, một mục tiêu vận tốc dọc theo đường thẳng, và scheduler của 2.1 cho thấy nó không thay đổi.
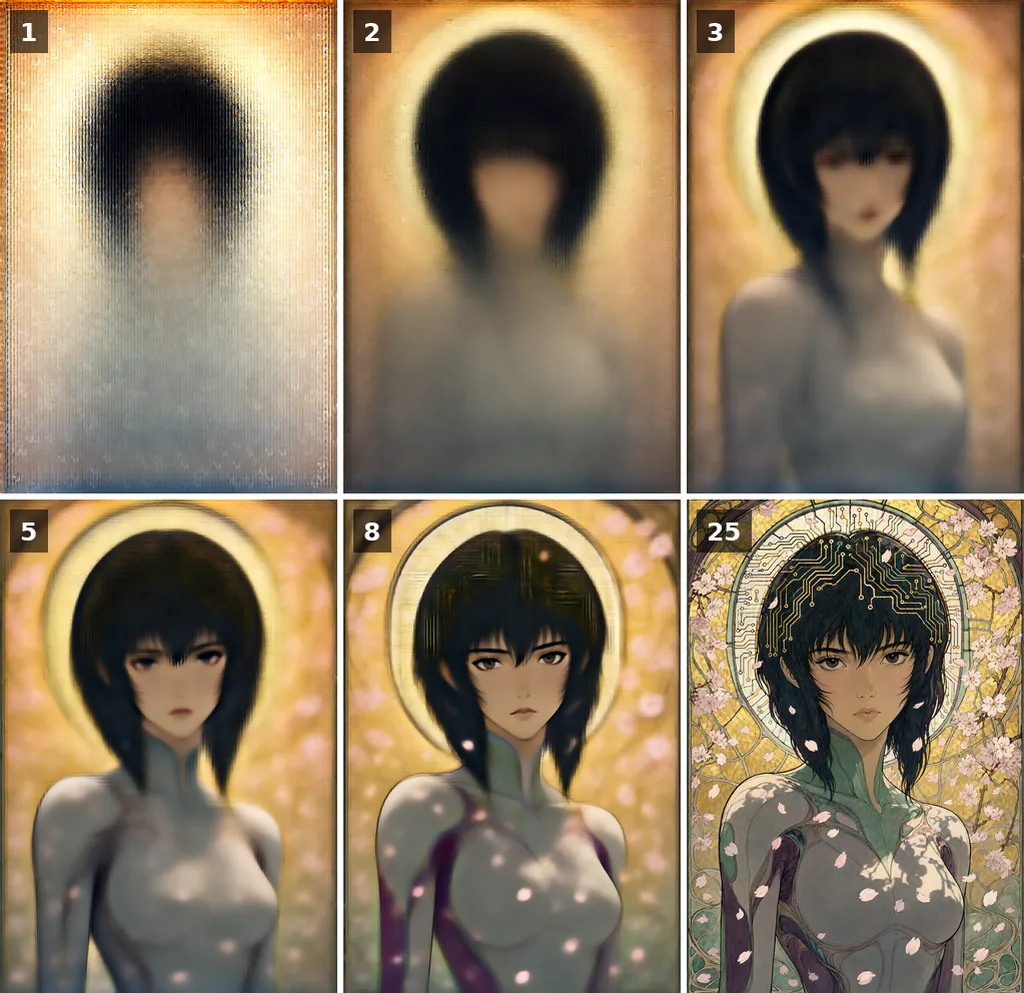
Hình bên dưới cho thấy ước lượng của mô hình về ảnh cuối trông thế nào dọc đường đi. Bố cục được chốt ở các bước đầu và chi tiết đến sau. Thứ tự từ thô đến tinh này chung cho mọi mô hình diffusion; flow matching chủ yếu thay đổi cách giãn cách các bước, và đó là thứ shift động tinh chỉnh.
Đặt cạnh nhau
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Bộ mã hóa văn bản | CLIP ViT-L và OpenCLIP bigG | Hai bộ mã hóa CLIP và T5-XXL | Qwen3-VL 8B, mô hình thị giác-ngôn ngữ |
| Bộ khử nhiễu | U-Net, 2.6 tỷ tham số | MMDiT hai luồng, 8 tỷ | Diffusion transformer đơn luồng, 7 tỷ, 32 lớp |
| Latent | 4 kênh, nén 8× | 16 kênh, 8× | 64 kênh, 16×, có alpha |
| Mục tiêu huấn luyện | Dự đoán nhiễu | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Kích thước gốc | 1024 px | 1024 px | 2048 px |
| Chỉnh sửa | Mô hình inpainting của bên thứ ba | Không có mô hình chỉnh sửa chính thức, chỉ ControlNet | Cùng checkpoint, tối đa 10 ảnh tham chiếu |
| Giấy phép | OpenRAIL++-M | Community License | Qwen Research License |
Không điều nào ở trên thay đổi cách điều khiển mô hình. Guidance, số bước, seed và kích thước hoạt động như ở mọi mô hình diffusion; chỉ các con số hiệu quả nhất là khác, và hướng dẫn thiết lập đã đo chúng.
Các phiên bản, từ Qwen-Image đến 2.1
Cách đánh số gây rối vì nó theo kiến trúc, không theo kênh phát hành. Qwen-Image 2.0, công bố tháng 2 năm 2026 và chưa bao giờ phát hành trọng số, giới thiệu thiết kế nhẹ hơn mà 2.1 nay đưa ra công khai. Qwen-Image 3.0, công bố tháng 7 năm 2026, là mô hình đầu bảng lớn hơn, chỉ phục vụ qua API của Alibaba. Qwen chưa giải thích cách đánh số này; các mốc bên dưới lấy từ các kho mã của dự án và, với 3.0, từ thông báo của Qwen.
| Phiên bản | Ngày | Là gì | Trọng số |
|---|---|---|---|
| Qwen-Image | 4 tháng 8 năm 2025 | MMDiT hai luồng 20 tỷ tham số với bộ mã hóa Qwen2.5-VL 7B; text-to-image | Mở, Apache 2.0 |
| Qwen-Image-Edit, rồi Edit-2509 và Edit-2511 | Tháng 8 đến tháng 12 năm 2025 | Các mô hình chỉnh sửa trên cùng nền; nhiều ảnh tham chiếu từ bản 2509; một mô hình RGBA phân lớp, Qwen-Image-Layered, vào tháng 12 | Mở, Apache 2.0 |
| Qwen-Image-2512 | 31 tháng 12 năm 2025 | Bản text-to-image cuối cùng của dòng 20 tỷ | Mở, Apache 2.0 |
| Qwen-Image 2.0 | 10 tháng 2 năm 2026 | Thiết kế mà 2.1 kế thừa: bộ mã hóa Qwen3-VL, VAE 64 kênh, 2K gốc, chỉ dẫn tới 1.000 token; báo cáo kỹ thuật tháng 5 năm 2026 | Không công bố |
| Qwen-Image 3.0 | 21 tháng 7 năm 2026 | Mô hình đầu bảng sau API của Alibaba: prompt tới 4.500 token, infographic và storyboard dựng trong một lượt | Chỉ qua API |
| Qwen-Image 2.1 | 20 tháng 9 năm 2026 | Transformer đơn luồng 7 tỷ tham số với bộ mã hóa Qwen3-VL 8B; tạo và chỉnh sửa trong một checkpoint, RGBA, 2K | Mở, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 tháng 10 năm 2026 | Bản 2.1 chưng cất, 8 bước | Mở, Qwen Research License |
Vậy nên trên một trang tải về, “Qwen-Image” không kèm số là mô hình 20 tỷ của năm 2025, vẫn có sẵn cùng các bản cập nhật 2512 và Edit. Mô hình mở hiện tại là 2.1, còn 3.0 là mô hình đứng sau dịch vụ trả phí của Alibaba. 2.1 và 3.0 chung dòng dõi nhưng không chung trọng số.
Giấy phép Qwen-Image: trọng số mở, chỉ cho nghiên cứu
Qwen-Image đầu tiên và các mô hình chỉnh sửa của nó theo giấy phép Apache 2.0: tự do cho mọi mục đích, kể cả thương mại. Qwen-Image 2.1 và bản Turbo theo Qwen Research License Agreement. Trọng số có thể tải về, nghiên cứu, chạy và fine-tune, nhưng chỉ cho nghiên cứu và đánh giá. Mọi mục đích thương mại cần một giấy phép riêng từ Qwen.
Điều đó đặt 2.1 vào vị trí khác với Stable Diffusion, với giấy phép 1.5 và SDXL cho phép dùng thương mại kèm danh sách mục đích bị cấm, và giấy phép 3.5 cho phép dưới mức doanh thu một triệu đô la mỗi năm, và khác với FLUX 3 Klein, miễn phí cho thương mại dưới năm triệu. Với sinh viên hay phòng thí nghiệm, không gì thay đổi. Với một studio, API trả phí hoặc giấy phép thương mại xin từ Qwen là những lối còn mở.
Thử Qwen-Image và đi xa hơn
Cách nhanh nhất là trang Qwen-Image 2.1 miễn phí của trang web này: không cần tài khoản, tạo và chỉnh sửa với ảnh tham chiếu, hàng đợi hiển thị trực tiếp.
Để chạy tại nhà, ComfyUI hỗ trợ sẵn mô hình. Ba tệp từ bản đóng gói lại của Comfy-Org đặt vào các thư mục quen thuộc: mô hình diffusion, bộ mã hóa văn bản Qwen3-VL và VAE, bản int8 cho card 16 GB. Hướng dẫn thiết lập trình bày đồ thị, cấu trúc prompt, guidance và các kích thước đã đo trên đúng card ấy, cùng với Turbo và Turbo có guidance.
Về các nguyên lý chung của mọi mô hình này, nhiễu, không gian latent, guidance và seed, hãy đọc Stable Diffusion là gì?; các giải thích ở đó áp dụng được, chỉ các con số là khác.