Vad är Qwen-Image, i korthet
Qwen-Image är bildgenereringslinjen i Qwen, modellfamiljen från Alibabas molndivision. Den kom i augusti 2025 som en modell med 20 miljarder parametrar under Apache 2.0-licensen, med en teknisk rapport. Den stack ut med sin text. Stycken, skyltar och etiketter blev läsbara, på engelska och framför allt på kinesiska, där Stable Diffusion 1.5 och SDXL gav krumelurer och modellerna från 2024 på sin höjd klarade några engelska ord.
Den aktuella öppna versionen är Qwen-Image 2.1, släppt den 20 september 2026. Det är en mindre och snabbare modell: 7 miljarder parametrar för bildgeneratorn plus en vision-language-kodare på 8 miljarder parametrar. Ett checkpoint sköter två uppgifter. Den genererar en bild från text, och den redigerar en befintlig bild utifrån en mening och upp till tio referensbilder. Den ger nativ 2K och äkta transparenta bilder. Licensen är inte längre Apache: enbart forskning och utvärdering.
Liksom Stable Diffusion och FLUX är den en diffusionsmodell som körs i ComfyUI på ett vanligt grafikkort, och den läser samma sorts prompt. Skillnaden sitter på insidan, och det är den som avsnittet om hur den fungerar förklarar.
Vad Qwen-Image 2.1 kan
Text-till-bild i nativ 2K. Modellen renderar kvadrater på 2048 × 2048, 2528 × 1696 i 3:2 och 2752 × 1536 i 16:9 direkt, utan uppskalning. Den läser prompten som en text, så meningar, prepositioner och layoutinstruktioner fungerar, och citerade ord dyker upp som de är skrivna: “a banner above the door reads ‘OPEN ALL NIGHT’” blir precis så i testprompterna i inställningsguiden. Inställningsguiden ger promptformen som fungerar bäst och de uppmätta inställningarna.
Redigering med samma checkpoint. Ge den en bild och en mening, så ändrar den bilden: byt ut ett föremål, ge en scen ny stil, lägg till text. Ge den upp till tio referensbilder, så sätter den ihop dem och håller en figur eller en produkt likadan från bild till bild. Områden kan pekas ut med en mask eller en ritad cirkel. Lokala ändringar kräver inget separat inpainting-checkpoint: samma modell tar området som en ledtråd.
Transparent utdata. Be om en RGBA-bild med transparent bakgrund, så gör modellen en riktig alfakanal, inte en friläggning: VAE:n kodar och avkodar fyra pixelkanaler i stället för tre. Logotyper, klistermärken och grafik i lager kommer ut klara att placeras.
Omskrivning av prompten. Qwen levererar två hjälpmodeller, finjusteringar av Qwen3.5-VL 9B, som bygger ut en kort prompt till den detaljerade form generatorn föredrar, en för generering och en för redigering. ComfyUI erbjuder dem som ett val i sina mallar, avstängda som standard; de behövs inte.
Hastighet. På ett 16 GB-konsumentkort tar int8-vikterna ungefär 40 sekunder för en bild på 1 megapixel och fyra till fem minuter för 4 megapixel med inställningsguidens kvalitetsinställningar. Ett destillerat Turbo-checkpoint, släppt den 9 oktober 2026, renderar i 8 steg, ungefär sju gånger snabbare vid 4 megapixel, på bekostnad av mediet: teckningar, broderier och pappersklipp driver mot fotografier.
Qwen-Image vs Stable Diffusion: hur den fungerar
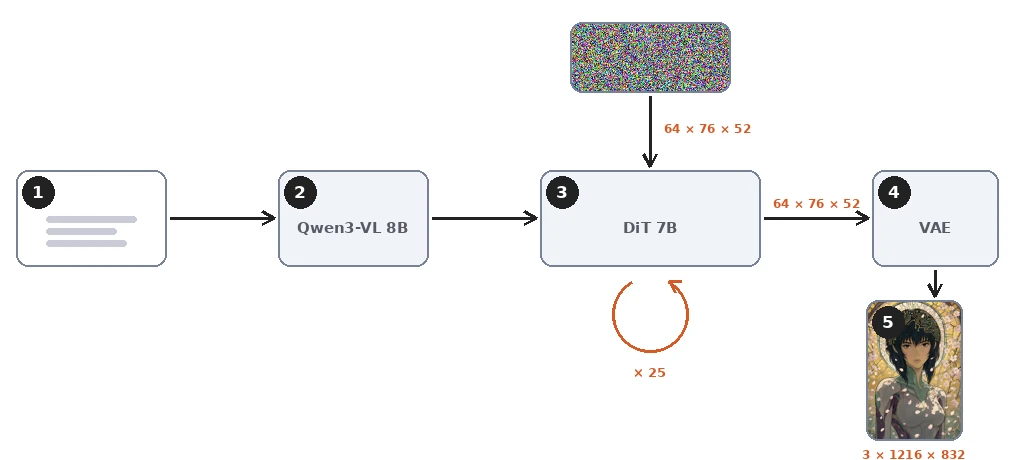
Qwen-Image 2.1 är en diffusionsmodell, så mekaniken som förklaras i Stable Diffusion-guiden gäller även här. En textkodare läser prompten. En avbrusare arbetar på en komprimerad latent över ett antal steg. En avkodare gör om latenten till pixlar. Det som skiljer är valet för var och en av de tre delarna. Modellens repository ger fakta nedan; Qwen har inte publicerat någon teknisk rapport för 2.1.
En vision-language-modell i stället för CLIP
Stable Diffusion 1.5 och SDXL läser prompten med CLIP, ett nätverk tränat att para ihop korta bildtexter med bilder. Qwen-Image 2.1 läser den med Qwen3-VL 8B, en fullständig vision-language-modell med åtta miljarder parametrar, fler än själva bildgeneratorn. Samma kodare läser referensbilderna vid redigering. Det är därför promptformen i inställningsguiden fungerar. Meningar, prepositioner, citerad text och layoutinstruktioner är precis det en språkmodell är byggd för att tolka. En CLIP-kodare tenderar att platta till dem till en påse begrepp.
En single-stream-transformer i stället för ett U-Net
Avbrusaren är en diffusionstransformer med 32 lager och 7 miljarder parametrar. SDXL använder ett U-Net, faltningsblock med attention-lager emellan. Stable Diffusion 3 gick också över till en transformer, MMDiT, där text- och bildtokens färdas i två strömmar med separata vikter och bara möts i varje lagers attention. Qwen-Image 2.1 går ett steg längre: text- och bildtokens bildar en enda sekvens och går genom samma vikter, och det är det ”single-stream” betyder. Den första Qwen-Image från 2025 var en double-stream-MMDiT med 20 miljarder parametrar; 2.1 är ungefär en tredjedel så stor.
Två detaljer i dess attention spelar roll i praktiken. Texttokens läses kausalt, som i en språkmodell, och varje bild, referens eller genererad, är ett block där alla tokens ser varandra. Ordningen är prompten först, referensbilderna sedan, den genererade bilden sist, och en token tittar aldrig på det som kommer efter. Prompten och referensbilderna ser alltså aldrig bilden som håller på att genereras, och den del av beräkningen som hör till dem, prefixet, är identisk i varje steg: den beräknas en gång och cachas över avbrusningsstegen. ComfyUI:s nod QwenImage21Cache väljer bara var den cachen ligger, i vilken precision, eller om den används alls.
En latent med 64 kanaler, komprimerad sexton gånger
Stable Diffusions VAE krymper en bild med en faktor åtta på varje sida till 4 kanaler, 16 i version 3. Qwen-Image 2.1:s VAE krymper den med sexton på varje sida, till 64 kanaler. Den kodar och avkodar dessutom fyra pixelkanaler, röd, grön, blå och alfa, i stället för tre, och det är så modellen ger äkta RGBA-bilder från samma latent med 64 kanaler. För en bild på 832 × 1216 mäter latenten 64 kanaler på 52 × 76: ungefär 253 000 tal för 3 miljoner pixelvärden, tolv gånger färre.
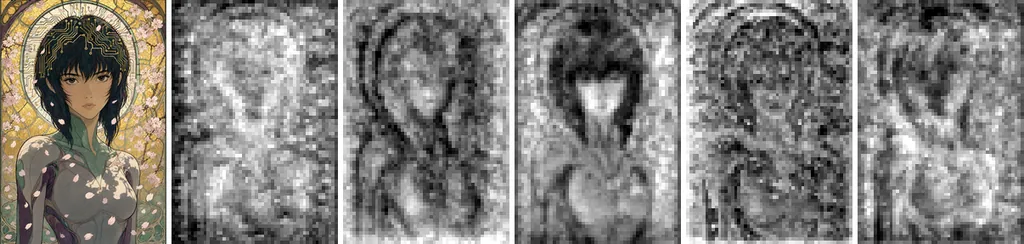
Varje position i latenten är en token för transformern, så en bild på 1 megapixel är 3 952 tokens och en på 4 megapixel 15 808. Det rutnätet är inte grövre än det i Stable Diffusion 3 eller i den första Qwen-Image, som grupperar sin 8-faldigt komprimerade latent i rutor om 2 × 2 före transformern. Det 2.1 ändrar är att VAE:n gör den grupperingen själv, i 64 kanaler. Kostnaden för attention växer med kvadraten på antalet tokens, och det är därför 4 megapixel kostar långt mer än fyra gånger 1 megapixel.
Flow matching i stället för brusprediktion
Stable Diffusion 1.5 och SDXL tränades att förutsäga bruset som lagts på en bild. Qwen-Image tränas, liksom Stable Diffusion 3 och FLUX, med flow matching. Nätverket förutsäger riktningen från den brusiga latenten mot den rena, längs en rak linje. Samplern följer sedan den riktningen med Euler-steg. Repositoryt namnger den schedulern: flow matching med diskreta Euler-steg och ett dynamiskt shift. Den första Qwen-Image-rapporten beskriver träningsmålet, en målhastighet längs raka banor, och 2.1:s scheduler tyder på att det är oförändrat.
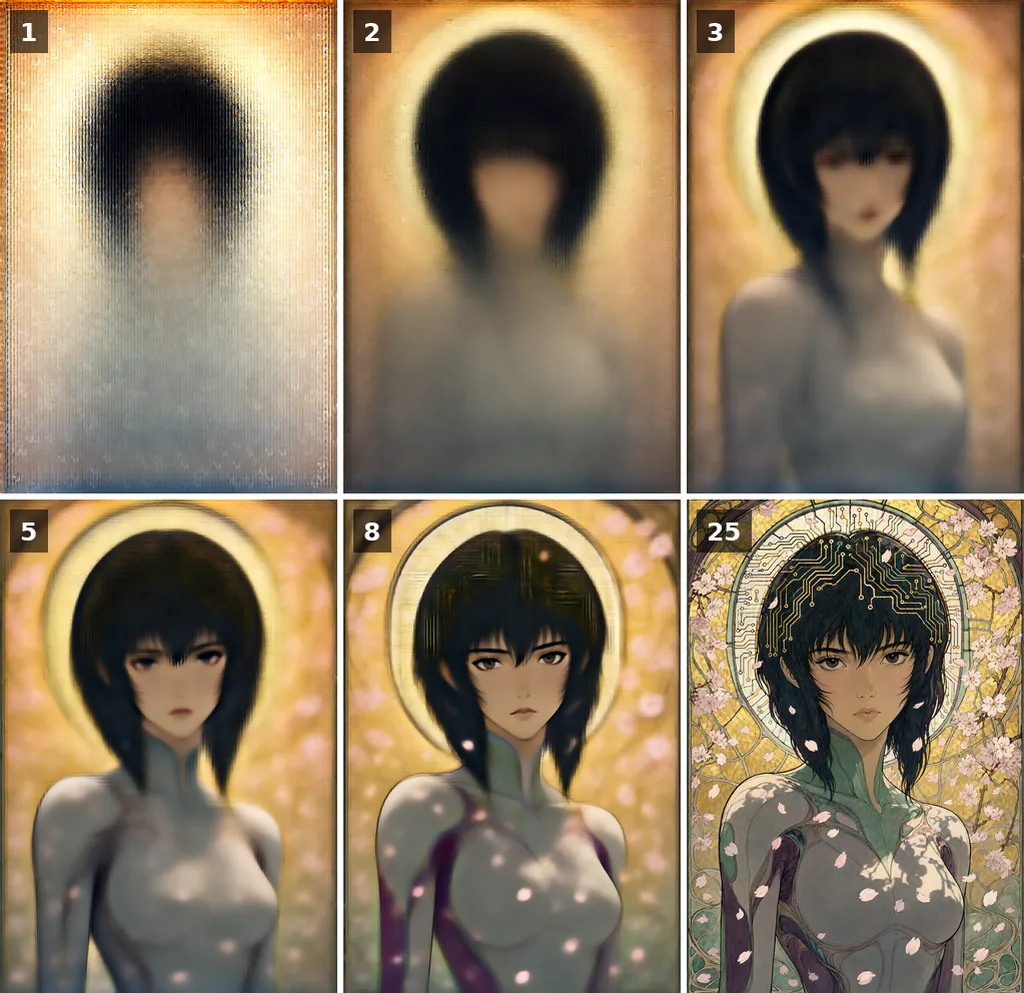
Figuren nedan visar hur modellens uppskattning av den färdiga bilden ser ut längs vägen. Kompositionen sitter i de första stegen och detaljerna kommer senare. Den ordningen från grovt till fint är gemensam för alla diffusionsmodeller; flow matching ändrar främst hur stegen är fördelade, och det är det som det dynamiska shiftet ställer in.
Sida vid sida
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Textkodare | CLIP ViT-L och OpenCLIP bigG | Två CLIP-kodare och T5-XXL | Qwen3-VL 8B, en vision-language-modell |
| Avbrusare | U-Net, 2,6 miljarder parametrar | Double-stream-MMDiT, 8 miljarder | Single-stream-diffusionstransformer, 7 miljarder, 32 lager |
| Latent | 4 kanaler, 8× komprimering | 16 kanaler, 8× | 64 kanaler, 16×, med alfa |
| Träningsmål | Brusprediktion | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Nativ storlek | 1024 px | 1024 px | 2048 px |
| Redigering | Inpainting-modell från tredje part | Ingen officiell redigeringsmodell, bara ControlNets | Samma checkpoint, upp till 10 referensbilder |
| Licens | OpenRAIL++-M | Community License | Qwen Research License |
Inget av detta ändrar hur modellen styrs. Guidance, steg, seed och storlek beter sig som i vilken diffusionsmodell som helst; bara siffrorna som fungerar bäst skiljer sig, och inställningsguiden mäter dem.
Versionerna, från Qwen-Image till 2.1
Numreringen är förvirrande eftersom den följer arkitekturen, inte utgivningskanalen. Qwen-Image 2.0, annonserad i februari 2026 och aldrig släppt som vikter, införde den lättare designen som 2.1 nu levererar öppet. Qwen-Image 3.0, annonserad i juli 2026, är ett större flaggskepp som bara serveras genom Alibabas API. Qwen har inte förklarat systemet; datumen nedan kommer från projektets repositorier och, för 3.0, från Qwens tillkännagivande.
| Utgåva | Datum | Vad det är | Vikter |
|---|---|---|---|
| Qwen-Image | 4 augusti 2025 | Double-stream-MMDiT med 20 miljarder parametrar och en Qwen2.5-VL 7B-kodare; text-till-bild | Öppna, Apache 2.0 |
| Qwen-Image-Edit, sedan Edit-2509 och Edit-2511 | augusti till december 2025 | Redigeringsmodeller på samma bas; flera referensbilder från 2509; en RGBA-modell i lager, Qwen-Image-Layered, i december | Öppna, Apache 2.0 |
| Qwen-Image-2512 | 31 december 2025 | Sista text-till-bild-utgåvan i 20-miljarderslinjen | Öppna, Apache 2.0 |
| Qwen-Image 2.0 | 10 februari 2026 | Designen som 2.1 ärver: Qwen3-VL-kodare, VAE med 64 kanaler, nativ 2K, instruktioner på upp till 1 000 tokens; teknisk rapport i maj 2026 | Inte publicerade |
| Qwen-Image 3.0 | 21 juli 2026 | Flaggskepp bakom Alibabas API: prompter på upp till 4 500 tokens, infografik och storyboards renderade i ett svep | Bara API |
| Qwen-Image 2.1 | 20 september 2026 | Single-stream-transformer med 7 miljarder parametrar och en Qwen3-VL 8B-kodare; generering och redigering i ett checkpoint, RGBA, 2K | Öppna, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 oktober 2026 | Destillerad 2.1, 8 steg | Öppna, Qwen Research License |
På en nedladdningssida är ”Qwen-Image” utan nummer alltså 20-miljardersmodellen från 2025, fortfarande tillgänglig med sina 2512- och Edit-uppdateringar. Den aktuella öppna modellen är 2.1, och 3.0 är modellen bakom Alibabas betaltjänst. 2.1 och 3.0 delar härstamning men inte vikter.
Qwen-Images licens: öppna vikter, bara forskning
Den första Qwen-Image och dess redigeringsmodeller var Apache 2.0: fria för allt, kommersiell användning inräknad. Qwen-Image 2.1 och dess Turbo ligger under Qwen Research License Agreement. Vikterna får laddas ner, studeras, köras och finjusteras, men enbart för forskning och utvärdering. All kommersiell användning kräver en separat licens från Qwen.
Det placerar 2.1 på en annan plats än Stable Diffusion, vars licenser för 1.5 och SDXL tillåter kommersiell användning med en lista över förbjudna användningar och vars 3.5-licens tillåter den under en miljon dollar i årsomsättning, och än FLUX 3 Klein, fri för kommersiell användning under fem miljoner. För en student eller ett labb ändras ingenting. För en studio är den betalda API:n eller en kommersiell licens begärd från Qwen de vägar som står öppna.
Prova Qwen-Image och gå vidare
Snabbaste vägen är den kostnadsfria Qwen-Image 2.1-sidan på den här webbplatsen: inget konto, generering och redigering med referensbilder, kön visad live.
För att köra den hemma: ComfyUI stöder modellen nativt. Tre filer från Comfy-Orgs ompaketering läggs i de vanliga mapparna: diffusionsmodellen, Qwen3-VL-textkodaren och VAE:n, i int8-versioner för ett 16 GB-kort. Guiden till inställningarna täcker grafen, promptformen, guidance och storlekarna som mättes på exakt det kortet, plus Turbo och Turbo med guidance.
För principerna som alla dessa modeller delar, brus, latent rum, guidance och seed, läs Vad är Stable Diffusion?; förklaringarna gäller rakt av, bara siffrorna ändras.