Stable Diffusion i korthet
Stable Diffusion är en latent diffusionsmodell (LDM) med öppen källkod: ett neuralt nätverk som tränats att förvandla slumpbrus till en bild, lite i taget, styrt av en text. Den byggdes av CompVis-gruppen vid Ludwig-Maximilians-Universität i München tillsammans med Runway och tränades med datorkraft från Stability AI på bilder som den ideella organisationen LAION samlat in. Metoden kommer från artikeln High-Resolution Image Synthesis with Latent Diffusion Models (Rombach med kollegor, CVPR 2022).
Vikterna publicerades den 22 augusti 2022. Det är den del som förändrade allt. DALL-E 2 och Midjourney fanns redan, men bakom väntelistor och krediter, på någon annans servrar. Stable Diffusion var en fil på 4 GB som kördes på ett grafikkort med 8 GB minne, utan konto och med ett säkerhetsfilter som gick att stänga av.
Inom några veckor kom webbgränssnitten och inpainting, sedan finjusteringarna, LoRA-filerna och ControlNet. Fyra år senare betyder namnet två saker. I strikt mening modellfamiljen från 1.4 till 3.5. I vid mening hela bruket att köra bildmodeller på sin egen dator.
Det som följer förklarar själva maskinen, med det ordförråd du möter i varje gränssnitt: latent rum, VAE, U-Net, CLIP, sampler, guidance-skala, seed. Inga formler behövs, men några siffror hjälper.
Hur fungerar Stable Diffusion? Tre nätverk och en loop
Stable Diffusion är inte ett nätverk utan tre, som körs efter varandra.
- En textkodare läser prompten och gör om den till en lista med tal. I Stable Diffusion 1.5 är det 77 tokens, var och en beskriven av 768 tal; 2 048 i SDXL, som kör två kodare.
- En avbrusare, ett U-Net i versionerna 1 till XL och en transformer (MMDiT) från version 3, utgår från ett block av slumpbrus och rensar upp det under 20 till 30 steg, och rådfrågar texttalen i varje steg. Den arbetar inte på pixlar utan på en kompakt version av bilden, den latenta bilden, som lever i det som kallas det latenta rummet: 4 × 64 × 64 tal för en bild på 512 pixlar, 4 × 128 × 128 för SDXL:s 1024 pixlar.
- En avkodare gör om den latenta bilden till de slutliga pixelvärdena, rött, grönt och blått: 3 × 512 × 512, eller 3 × 1024 × 1024 för SDXL.
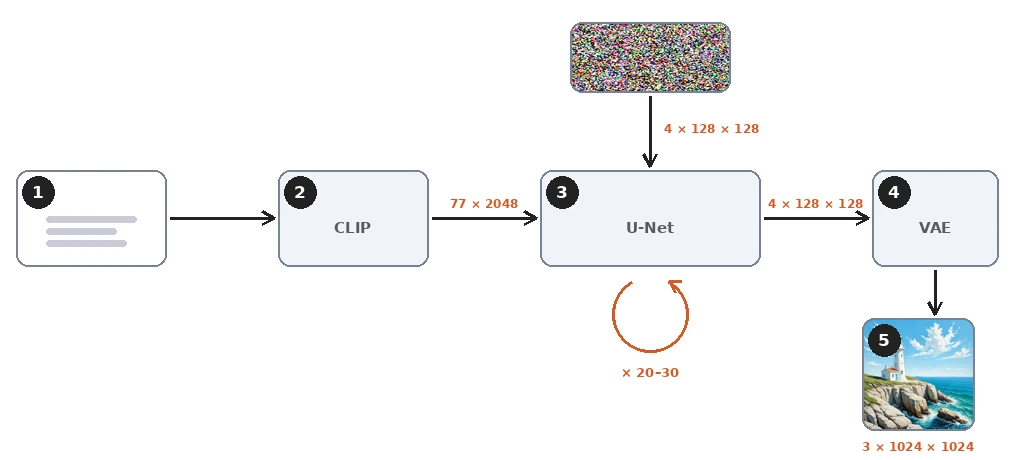
Ingenting söks upp eller kopieras på vägen. Det finns ingen bilddatabas inne i filen. De 2 till 16 GB vikter rymmer det nätverket lärt sig om hur bildtexter och bilder hör ihop, och varje resultat beräknas ur brus. Nätverket kan ändå memorera bilder som förekom många gånger i träningen, och forskare har extraherat några hundra av dem, men det är undantaget.
Vad är en diffusionsmodell? Att lära sig ta bort brus
Framåtprocessen: att lägga till brus
Idén bakom diffusion är enkel att formulera. Ta ett foto med dess bildtext. Lägg till en uppmätt mängd slumpbrus. Be ett nätverk gissa vilket brus som lades till, med bildtexten som ledtråd. Jämför gissningen med sanningen och rätta nätverket en aning.
Att lägga till bruset är framåtprocessen. Den följer ett fast schema med tusen nivåer, från en svag kornighet på nivå 50 till rent brus på nivå 999. Nätverket ser aldrig schemat köras; det ser bara en brusig bild på en nivå i taget.
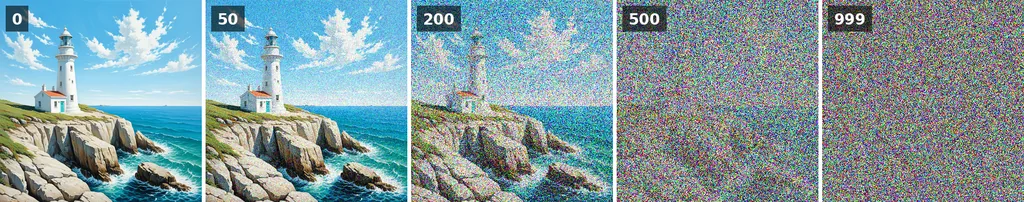
Gör det över miljarder exempel och resultatet är en brusprediktor: givet en brusig bild, dess brusnivå och en text säger den vad bruset troligen är. Träningsmålet är helt enkelt gapet mellan det förutsagda bruset och det verkliga. Att träna Stable Diffusion 1 tog ungefär 150 000 timmar på A100-GPU:er i datacenter, enligt dess modellkort.
Bakåtprocessen: brusprediktorn i arbete
Genereringen kör lektionen baklänges. Det är bakåtprocessen. Börja från rent brus, som seedet väljer. Fråga prediktorn vad bruset är, ta bort en del av det, fråga igen. DDPM, artikeln från 2020 som gjorde diffusion praktiskt användbar, gjorde det i tusen små steg.
Samplern, i vissa gränssnitt kallad scheduler, är regeln som avgör hur stort varje steg är och om lite nytt brus läggs tillbaka. Bättre samplers, DDIM, Euler och DPM++-familjen, tar större steg längs samma väg, och det är därför 20 till 30 steg räcker i dag.
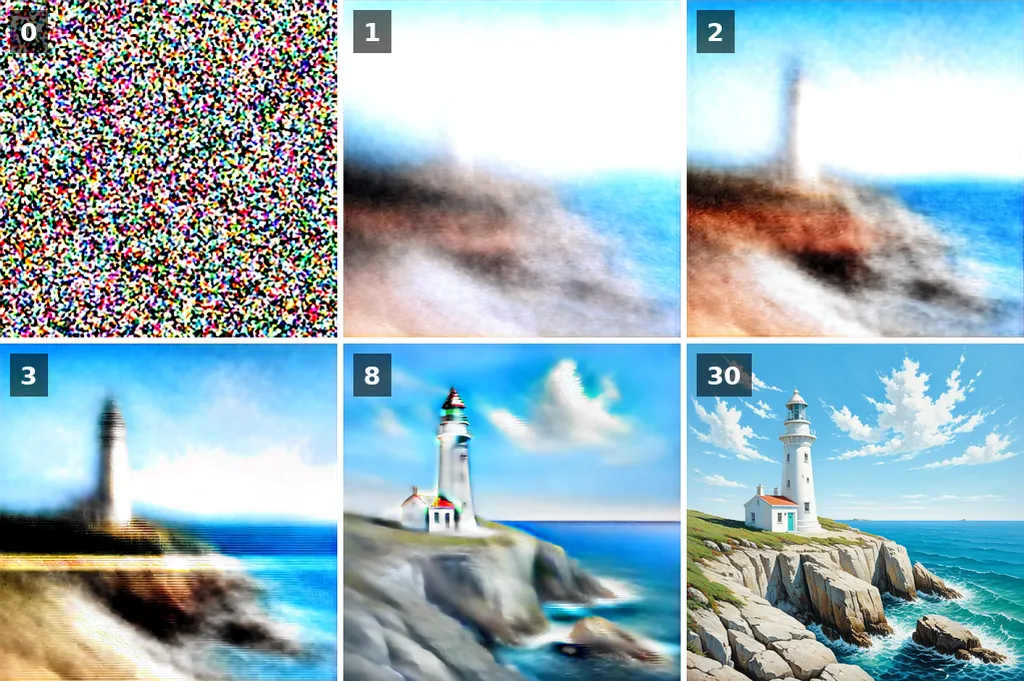
Figuren visar det som är värt att minnas. I varje steg har modellen en gissning om den färdiga bilden, och gissningen sätter sig tidigt. De första två eller tre stegen, medan bruset är kraftigt, låser kompositionen: var horisonten ligger, var fyren står, hur mycket himmel det finns. De senare stegen förfinar textur och små detaljer.
Reglaget nedan går igenom alla trettio gissningar från samma rendering.
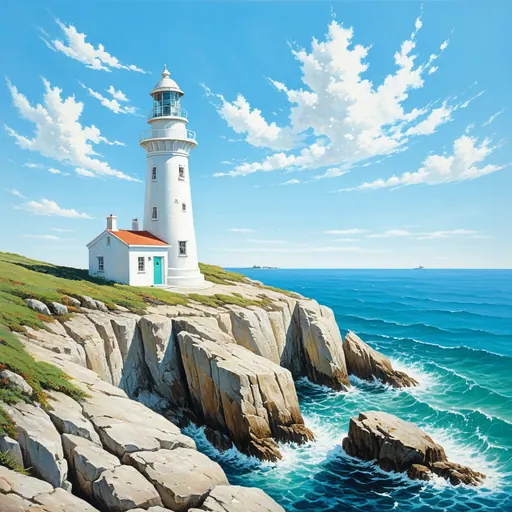
Två praktiska följder kommer av det. Att ändra antalet steg ändrar detaljerna och ibland kompositionen, eftersom de tidiga stegen landar på andra värden; det gör inte bara samma bild skarpare. Och samma seed i en annan bildstorlek startar från ett annat block av brus, så den ger också en annan bild. Välj storleken först, leta sedan efter ett seed.
Latent diffusion: VAE-tricket som får den att rymmas på ett spelgrafikkort
Tidigare diffusionsmodeller arbetade på pixlar. En bild på 512 × 512 är 786 432 tal, och prediktorn var tvungen att läsa och skriva alla i vart och ett av sina steg. Pixelmodeller som DALL-E 2 och Imagen kom runt det genom att diffundera i 64 pixlar och lägga på uppskalningsnätverk, och de släpptes ändå aldrig.
Stable Diffusion lägger till en variational autoencoder, VAE:n. Dess kodare pressar ihop en bild med en faktor åtta på varje sida till fyra kanaler: 4 × 64 × 64, det vill säga 16 384 tal, 48 gånger färre. Diffusionen körs helt och hållet i det komprimerade rummet, det latenta rummet. Först allra sist vecklar VAE:ns avkodare ut resultatet till pixlar.

Den latenta bilden är inte en liten bild. Dess fyra kanaler är en kod som avkodaren vet hur den ska läsa, och ingen enskild kanal ser riktigt ut som bilden. Men layouten överlever komprimeringen, och det är det som låter avbrusaren avgöra kompositionen i ett så litet rum.
Det är också därför valet av VAE spelar roll för färg och fina detaljer: varje latent tal står för en ruta på 8 × 8 pixlar, och avkodaren hittar på vad som finns inne i rutan. Stable Diffusion 3 gick över till en latent bild med 16 kanaler av just det skälet, och fina detaljer och liten text blev bättre med den.
CLIP och cross-attention: så styr texten bilden
Tre delar förvandlar ord till en riktning för avbrusaren.
Tokenizer och textkodare: så läser CLIP en prompt
Tokenizern delar upp prompten i tokens, hela vanliga ord eller delar av ovanligare. Stable Diffusion 1.5 och SDXL läser högst 77 tokens, varav två är start- och slutmarkörer, ungefär 50 till 60 engelska ord. Allt därutöver klipps av, om inte gränssnittet delar upp den i flera pass. Sätt det viktigaste först.
Textkodaren i 1.5 är CLIP, ett nätverk som OpenAI tränade på 400 miljoner par av bilder och bildtexter, med en enda uppgift: att föra talen som beskriver en bildtext nära talen som beskriver dess bild. Efter den träningen bär talen för ”lighthouse” redan på hur fyrar ser ut. SDXL kör två sådana kodare sida vid sida, den andra en öppen omträning gjord av LAION på två miljarder par. Stable Diffusion 3 lägger till en tredje, T5, som läser hela meningar.
Cross-attention inuti U-Net
Cross-attention är där texten möter bilden. U-Net är en stapel faltningsblock som krymper den latenta bilden och sedan låter den växa tillbaka, med skip-kopplingar mellan matchande storlekar. Mellan de blocken sitter attention-lager. I varje steg tittar varje område av den latenta bilden på de 77 tokenvektorerna och väger vilka av dem som angår det. Himmelsområdet lyssnar på ”sunset” och ”clouds”, klippan på ”cliff”. Det är därför ordföljd, upprepning och gränssnittens viktningssyntax har effekt, och därför ett stilord i början färgar hela bilden.
Det är också de första versionernas begränsning. CLIP lärde sig av korta alt-texter, så den förstår listor av motiv och stilar bra och relationer mellan dem dåligt. ”A red cube on a blue sphere” kommer ofta ut omkastat i 1.5. Promptguiden visar vad som fungerar pålitligt.
Guidance-skala, negativ prompt och seed: de tre inställningarna
Tre inställningar finns i varje Stable Diffusion-gränssnitt. De motsvarar direkt maskineriet ovan.
Guidance-skalan, CFG-skalan, kort för classifier-free guidance (CFG), är den som avgör hur hårt texten trycks igenom. I varje steg gör avbrusaren egentligen två förutsägelser: en med prompten och en med en tom prompt. Skillnaden mellan de två är riktningen som prompten ger. Den slutliga förutsägelsen är den tomma plus den skillnaden multiplicerad med guidance-skalan. På 1 används förutsägelsen med prompt som den är, utan påtryckning: bilden följer texten löst, med dämpade färger och en grå himmel där prompten bad om en blå. Runt 5 till 8 följer den prompten nära med naturliga färger. Över 12 hårdnar kontrasten, färgerna mättas och penseldragen blir grova.
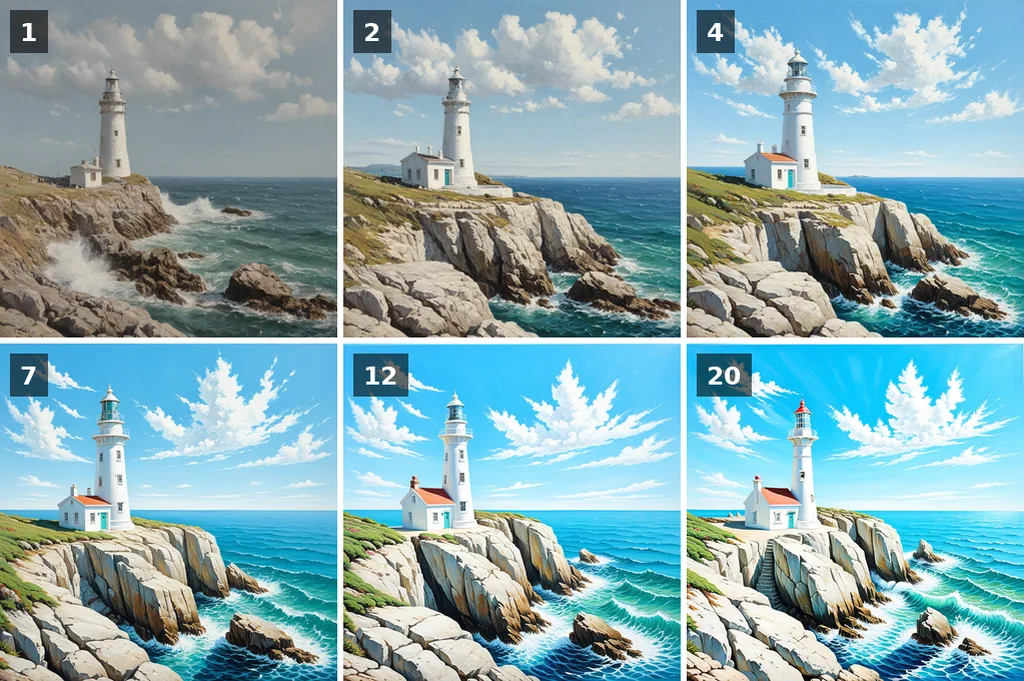
Den negativa prompten ersätter den tomma prompten i den andra förutsägelsen. I stället för att läsa ingenting läser det andra passet ”blurry, text, watermark”, och guidance trycker bort från det. Det kostar inget extra, eftersom det andra passet körs ändå, och det fungerar bara när guidance är över 1. Guiden om negativ prompt ger listor som fungerar.
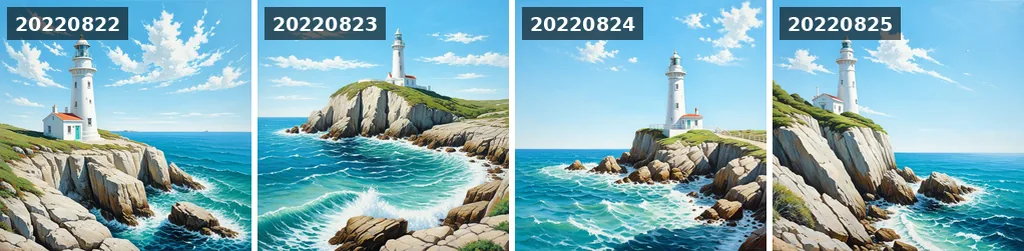
Seedet är talet som genererar startbruset. Samma seed, samma prompt, samma inställningar och samma modell ger samma bild, ner till pixeln, på samma programvara och hårdvara; ett annat gränssnitt eller ett annat kort drar bruset annorlunda. Byt seed och kompositionen byts, eftersom de första stegen läser ett annat block av brus. Byt ett ord i prompten och behåll seedet, så håller det mesta av bilden oftast. Så förfinar man en prompt.
Från U-Net till transformer: versionerna från 1.5 till 3.5
Sex huvudgenerationer kom på två år, de två första från CompVis och Runway, resten från Stability AI. Var och en ändrade minst ett av de tre nätverken.
| Version | Datum | Avbrusare | Textkodare | Nativ storlek |
|---|---|---|---|---|
| 1.4 och 1.5 | augusti och oktober 2022 | U-Net, 860 miljoner parametrar | CLIP ViT-L | 512 px |
| 2.0 och 2.1 | november och december 2022 | U-Net med samma design, omtränat från grunden | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | juli 2023 | U-Net, 2,6 miljarder, plus en refiner | CLIP ViT-L och OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | november 2023 | SDXL destillerad till 1 till 4 steg | Samma som SDXL | 512 px |
| 3 Medium | juni 2024 | Diffusionstransformer (MMDiT), 2 miljarder | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | oktober 2024 | MMDiT, 8 miljarder; Medium 2,5 miljarder | Samma tre | 1024 px |
1.5 är fortfarande en av de mest finjusterade modellerna som finns, med tiotusentals checkpoints och LoRAs från communityn, och den körs fortfarande på 4 GB grafikminne. SDXL är arbetshästen: bättre händer, ansikten och komposition, och nativ utmatning i 1024 pixlar. 3 och 3.5 ersatte U-Net med en transformer som behandlar text- och bildtokens tillsammans, vilket är det som till slut gjorde läsbar text i bilder möjlig: sätt orden inom citattecken i prompten. Jämförelsen mellan SDXL och Stable Diffusion 3 visar samma prompts på båda.
Licenserna ändrades också. 1.5 ligger under licensen CreativeML OpenRAIL-M och SDXL under OpenRAIL++-M, båda fria för kommersiellt bruk med en lista över förbjudna användningar. 3.x-modellerna ligger under Stability AI Community License, gratis under en miljon dollar i årsomsättning.
Vad du kan göra med den: img2img, inpainting, ControlNet, LoRA
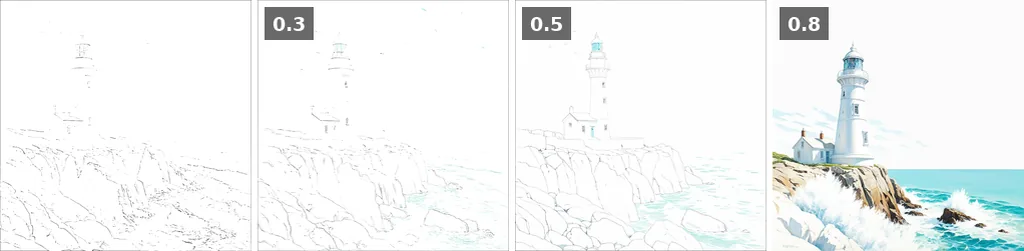
Text till bild är bara början, eftersom varje del av pipelinen kan återanvändas. Koda en skiss till en latent bild, lägg till bara en del av bruset och avbrusa därifrån, och du har bild till bild, img2img i gränssnitten: inställningen strength, eller denoise, är hur mycket brus du lägger till. Idén kommer från SDEdit. Maskera ett område av den latenta bilden och du har inpainting, eller outpainting när masken ligger utanför bildytan. Lägg till ett litet sidonätverk som läser en pose, en djupkarta eller kanter, och du har ControlNet. Träna några miljoner extra vikter på tjugo foton och du har ett LoRA som lär modellen ett ansikte eller en stil. Särskilda superupplösningsmodeller sköter uppskalning.
För att köra den själv räcker ett nyare NVIDIA-kort med 6 GB grafikminne (VRAM) för 1.5 och 8 GB för SDXL. AMD-kort fungerar via ROCm, Apple Silicon via MPS-backend. Installationsguiden täcker de tre viktigaste gränssnitten. Utan kort behöver verktygen på den här webbplatsen ingen hårdvara: Stable Diffusion XL och Stable Diffusion 1.5 körs på webbplatsens egen GPU med kön visad live, dokumenterade prompts visar vad varje inställning gör, och 1 731 konstnärsstilar visar vad modellen lärt sig om målare.
Stable Diffusion vs Midjourney vs DALL-E
Gentemot Midjourney och OpenAI:s bildmodeller är skillnaden inte kvalitet utan kontroll. Vikterna är offentliga och modellen körs lokalt: dina bilder stannar på din disk, du väljer modellen, du sätter seedet och du kan byta ut vilken komponent som helst. I gengäld kräver den mer av dig. Midjourney ber om en mening och ger en polerad bild; Stable Diffusion ber om en modell, en prompt, en negativ prompt och en guidance-skala, och ger dig exakt det du ställt in.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Vikter | Offentliga, nedladdningsbara | Stängda | Stängda |
| Körs på din egen dator | Ja, 6 till 8 GB VRAM | Nej | Nej |
| Pris | Gratis lokalt; gratisverktyg online | Prenumeration | Prenumeration eller per bild |
| Kontroll | Seed, modell, LoRA, ControlNet, inpainting, varje inställning | Parametrar och stilreferenser | Konversation |
| Finjustering | Ja, av vem som helst | Nej | Nej |
| Text i bilder | Svag före 3, bra från 3.5 | Bra sedan v6 | Mycket bra |
Samma diffusionsprincip driver nu modeller från andra labb, med andra kodare och andra licenser: FLUX från Black Forest Labs, grundat av de ursprungliga Stable Diffusion-författarna, och Qwen-Image från Alibaba. De körs i samma gränssnitt, med samma seeds, steg och samplers, så det mesta på den här sidan gäller även dem. Deras guidance fungerar annorlunda, FLUX dev har ingen negativ prompt, och de föredrar hela meningar framför nyckelordslistor.
Källor, och hur du får återanvända figurerna
Primärkällorna, i den ordning sidan möter dem:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach m.fl., 2022: Stable Diffusion-artikeln.
- Denoising Diffusion Probabilistic Models, Ho m.fl., 2020: framåt- och bakåtprocessen och schemat med tusen steg.
- Learning Transferable Visual Models From Natural Language Supervision, Radford m.fl., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho och Salimans, 2022: guidance-skalan.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, och Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL och Stable Diffusion 3.
Att återanvända figurerna. Renderingarna och diagrammen på den här sidan släpps under CC BY 4.0: återanvänd dem i en kurs, ett föredrag eller en artikel med en länk till den här sidan. Varje rendering använder Stable Diffusion XL, euler, 30 steg, CFG 6, seed 20220822, prompten nedan och den negativa prompten ”text, watermark, signature, blurry, low quality, storm, dark clouds, sunset”.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesSå citerar du den här sidan.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion