Vad Qwen-Image 2.1 är
Qwen-Image 2.1 är ett enda checkpoint för två uppgifter. Den genererar en bild från text, och den redigerar en befintlig bild utifrån en mening och upp till tio referensbilder. Genereringsdelen är en diffusionstransformer med 7 miljarder parametrar. Den är kopplad till en Qwen3-VL 8B-textkodare, som laddas i ComfyUI som en separat fil.
En språkmodell som kodare är det som gör att den läser hela meningar, layoutinstruktioner och citerade ord i stället för nyckelordslistor.
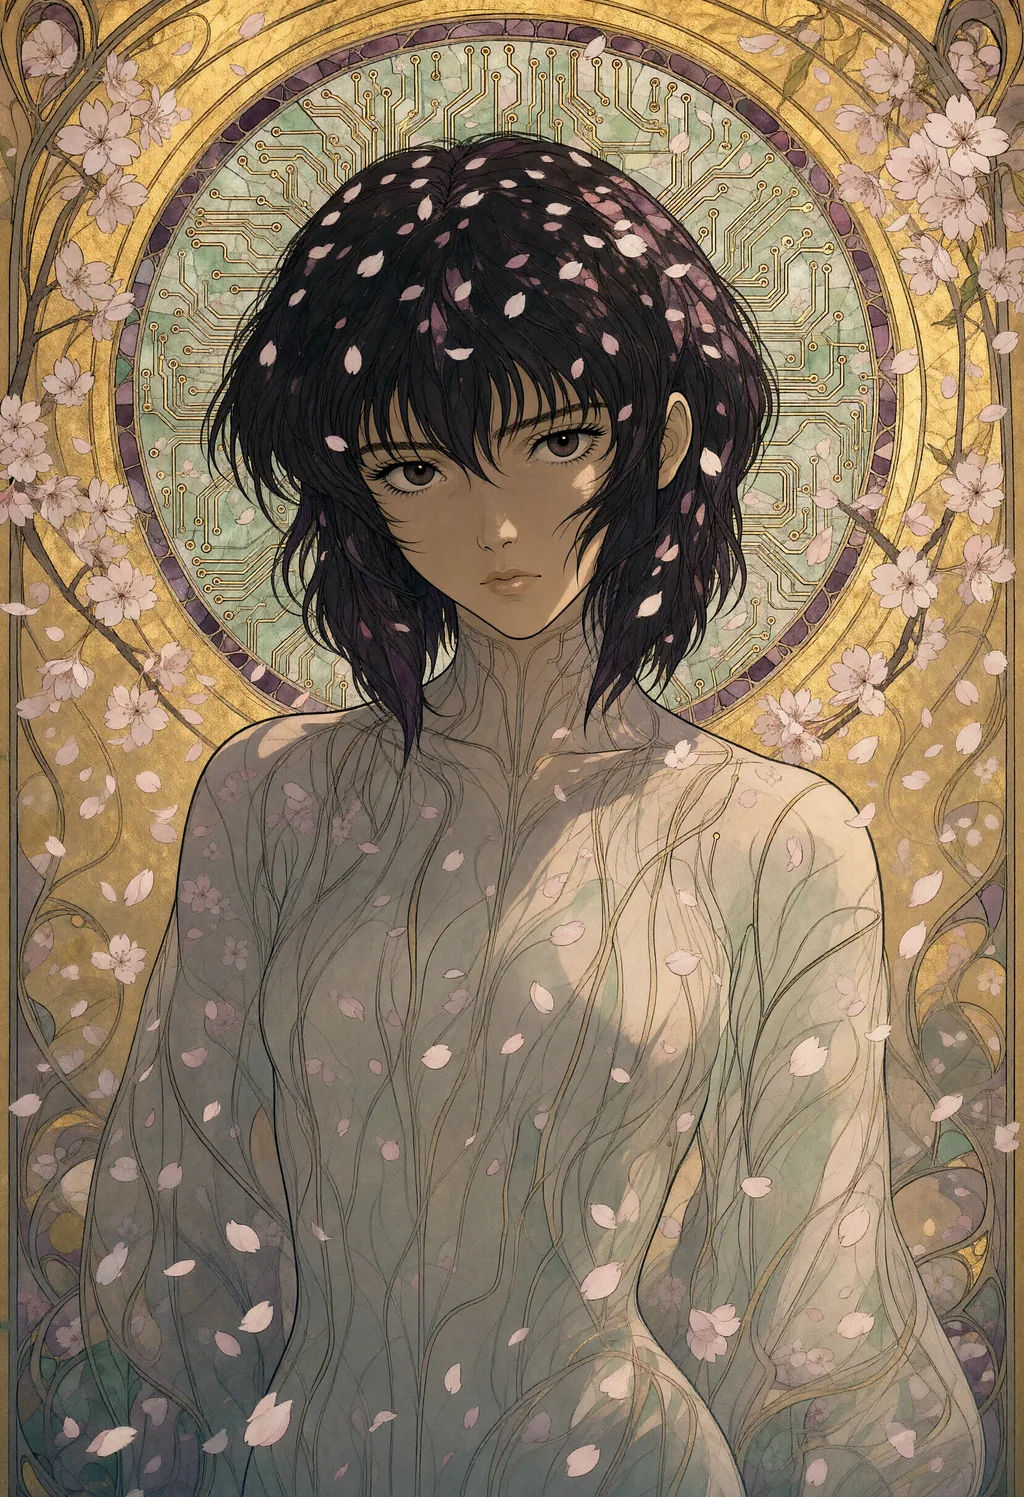
Qwen presenterar 2.1 som bättre på texturer, typografi och porträttljus. Den arbetar i nativ 2K utan uppskalning: 2048 × 2048 för en kvadrat, 2528 × 1696 för 3:2, 2752 × 1536 för 16:9. Den kan också ge en riktig alfakanal när prompten ber om en transparent bakgrund.
Priset är tid. På ett konsumentgrafikkort med 16 GB videominne tar int8-vikterna ungefär 40 sekunder för en bild på 1 megapixel. En bild på 4 megapixel tar ungefär fyra och en halv minut med inställningarna nedan.
En sak att veta före nedladdningen. Vikterna ligger under Qwen Research License: enbart forskning och utvärdering. All kommersiell användning kräver en separat licens från Qwen. Den första Qwen-Image, släppt i augusti 2025, var Apache 2.0. Version 2.1 är det inte.
Så skriver du en prompt för Qwen-Image 2.1
Skriv meningar, inte taggar. Textkodaren är en språkmodell. Den läser ordföljd, prepositioner och citattecken, och den tar allt bokstavligt. En ”lighthouse cat” blir en katt ritad på en fyr.
Strukturen nedan gav de bästa resultaten över ungefär tusen bilder. Behåll den här ordningen.
- Medium och motiv först: ”An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. Mediet som sätts först färgar allt som kommer efter.
- Miljö: plats, epok, väder eller det som fyller luften. ”in falling cherry blossoms”, ”in the 1980s”, ”during a blizzard”.
- Ljus med riktning: ”lit from the front by soft diffuse light, with gentle shadows”. Riktningen följs. Ett naket ”dramatic light” gör det inte.
- Bildutsnitt: ”close-up of the subject, looking at the viewer”, medium shot, sett uppifrån, motivet pyttelitet i ett vidsträckt landskap.
- Material och palett: ”flowing ink lines, flat gold leaf background, muted jade and plum”. Det är det modellen renderar bäst i 2K.
- Begränsningar, skrivna i prompten: ”no lettering, no watermark”, ”five fingers on each hand”. På guidance 1 ignoreras den negativa prompten, så prompten själv måste bära dem.
Hela prompten till illustrationen ovan, i den ordningen: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Text fungerar när den är citerad och placerad. ”A banner above the door reads 'OPEN ALL NIGHT'” blir rätt nästan varje gång, med versaler eller inte.
Det omvända gäller också. En butiksfasad, en diner eller en spelhall utan begärd text får en påhittad skylt. Säg därför ”no lettering” så fort scenen innehåller en fasad.
Figurer som modellen inte känner till byts ut mot en dubbelgångare utan förvarning. Marsupilami blev en apa. Mothra och Marvin the Martian blev rätt.
Varje Qwen-kort på sidan med promptexempel följer den här strukturen, med seed, storlek och inställningar.
Inställningar som fungerar, mätta
Den officiella ComfyUI-mallen körs med en guidance (CFG) på 1 och 25 steg. Modellkortet använder 40 steg. Inställningarna nedan landade på CFG 3.
Senast testat den 16 oktober 2026, på samma seeds, gav de här inställningarna de mest detaljerade och mest trogna bilderna:
| Inställning | Värde |
|---|---|
| Guidance (CFG) | 3, med en negativ prompt |
| Negativ prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Modellpatchar | APG (eta 1, norm threshold 10, momentum 0,3) och sedan FreSca (low 1, high 2, cutoff 8), före samplern |
| Sampler | euler, scheduler simple |
| Steg | 25 vid 1 megapixel, 20 vid 2,5 och 4 megapixel |
| LoRA | inget |
Guidance är den enda inställningen som inte ändrar scenen. Med samma seed och storlek ger CFG 1 och CFG 3 nästan samma komposition. Det som skiljer är renderingen.
På CFG 1 är bilden plattare och tappar fin textur. Broderistygn blir tyg. Ett tecknat ansikte tappar pupiller och mun. Metall tappar sina nitar.
Att driva CFG 1 till 30 steg ger tillbaka skärpan, men varken materialen eller kontrasten. Vid 2 megapixel, en storlek som provades en gång, ger 40 steg en ren bild som fortfarande är plattare, och prompten läses mindre tillförlitligt.
APG hindrar CFG 3 från att övermätta. FreSca skärper de höga frekvenserna. Båda verkar bara när guidance är över 1.
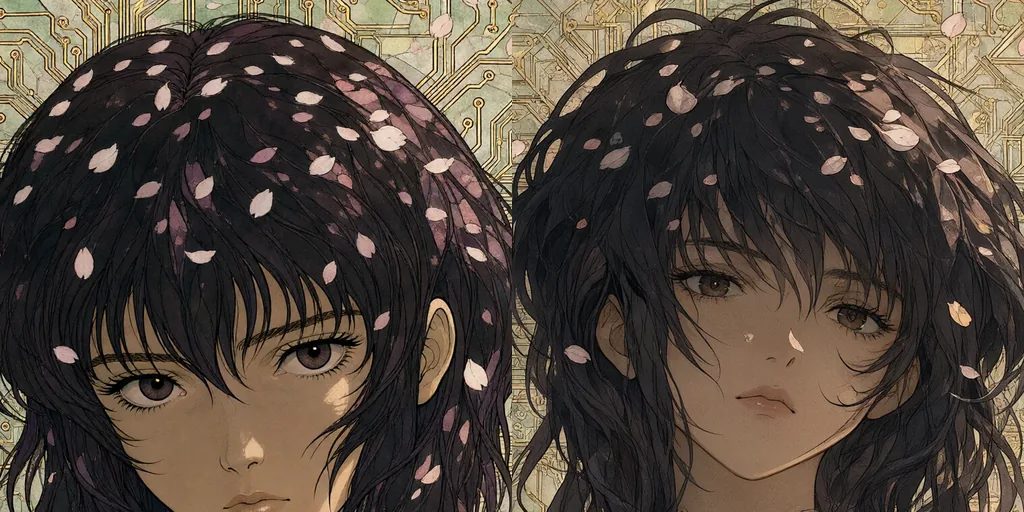
Guidance över 1 kostar ett andra pass per steg, så CFG 1 är dubbelt så snabb. På testkortet är det 120 till 135 sekunder mot 255 till 275 för en bild på 4 megapixel. Den långsammare var värd det i vart och ett av tio testpar.
Upplösning och steg: vad som ändrar bilden
Som alla diffusionsmodeller skalar Qwen-Image 2.1 inte om bilden när storleken ändras. Det ger en annan tagning av samma seed, så ett seed som hittats i 1 megapixel går inte att föra över till 2K.
Att gå från 1 megapixel till 2,5 eller 4 gav en annan bild i varje testat par. Mellan 2,5 och 4 megapixel höll kompositionen i åtta par av tio.
I illustrationen nedan flyttade bara detaljerna på sig. Vid 2,5 megapixel lämnade kretskortsbanorna glorian för håret.
Att ändra antalet steg ändrar också bilden när gapet är stort. 20 och 25 steg ger nästan samma bild. 16 steg driver iväg. Det går alltså inte att förhandsgranska i 1 megapixel och rendera samma bild större. Välj storleken först, sedan seedet.
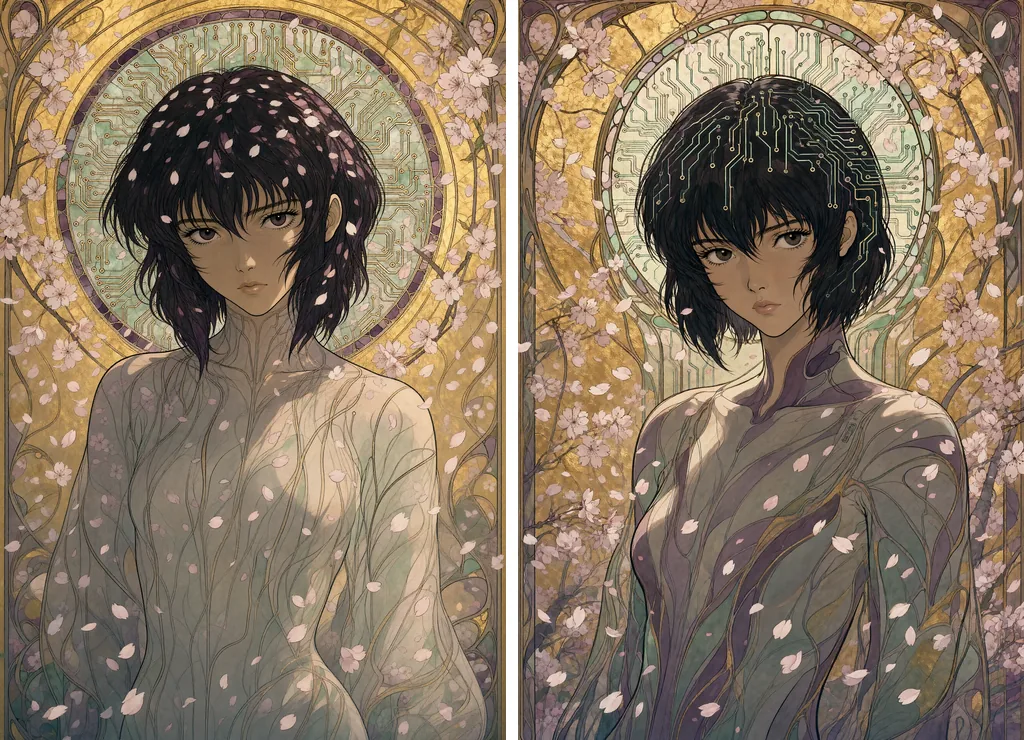
Tider mätta med CFG 3, APG och FreSca, int8-vikter, på ett enda 16 GB-konsumentkort, i liggande format eller motsvarande stående:
| Storlek | Steg | Tid per bild |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | ungefär 40 s |
| 2,5 megapixel (1920 × 1312) | 20 | 120 till 135 s |
| 4 megapixel (2432 × 1664) | 20 | 255 till 275 s |
| 4 megapixel | 25 | 315 till 335 s |
Vid 2,5 megapixel är detaljerna lite mjukare än vid 4 när man jämför samma yta i 100 %. Men modellen följer promptens stil minst lika bra, och i de tio testparen ibland bättre. Ett broderi visade sina stygn tydligare vid 2,5 megapixel än vid 4.
För ett galleri som visas i 1024 pixlar är 2,5 megapixel på 20 steg den bästa avvägningen. För ett tryck, 4 megapixel på 20 steg.
Snabbare: Turbo, Turbo med guidance och resten
Turbo. Qwen släppte Qwen-Image-2.1-Turbo den 9 oktober 2026. Det är ett destillerat checkpoint som körs i 8 steg på CFG 1 med ett fast sigmaschema. Comfy-Org levererar det som int8-fil och som LoRA för basmodellen, med egna mallar i ComfyUI. Det mättes den 17 oktober på samma tio seeds och storlekar som den här guidens CFG 3-renderingar, med mallens exakta graf.
| Inställning | Tid per bild |
|---|---|
| Turbo-checkpoint, 8 steg, CFG 1, 1 megapixel | 9 till 10 s |
| Turbo-checkpoint, 8 steg, CFG 1, 4 megapixel | 38 till 39 s |
| Turbo med guidance, beskriven nedan: Turbo-checkpoint, 8 steg, CFG 3 med APG och FreSca, 4 megapixel | 66 till 71 s |
| Bas-checkpoint plus Turbo-LoRA, 8 steg, CFG 1, 4 megapixel | 52 till 55 s |
| Bas-checkpoint, CFG 3, 20 steg, 4 megapixel | 255 till 275 s |
Sju gånger snabbare vid 4 megapixel, fyra gånger vid 1. Bilderna är rena: skarpa, väl belysta, inga anatomimissar på de tio seedsen, text rätt på samma prompts som basmodellen. Promptens objekt finns med, ibland bättre än med basmodellen. Sköldpaddan i sin racerbil, som basmodellen hade tappat i varje rendering, dök upp med Turbo.
Det den förlorar är mediet. På varje icke-fotografisk prompt bland de tio seedsen drev den destillerade modellen mot fotografisk realism. Ett broderi av en krokodil blev ett fotografi av en krokodil. En kolteckning tappade sin kornighet. En Marvin the Martian i pappersklipp blev en vinylfigur. Påhittad text på fasader är densamma som med basmodellen.
På de tio seedsen gav LoRA:t på bas-checkpointet samma bilder som Turbo-checkpointet, bara långsammare. Så det är checkpointet man ska ladda ner. Ett seed ger en annan bild än med basmodellen, som vid varje storleksändring. Licensen är densamma: enbart forskning och utvärdering.
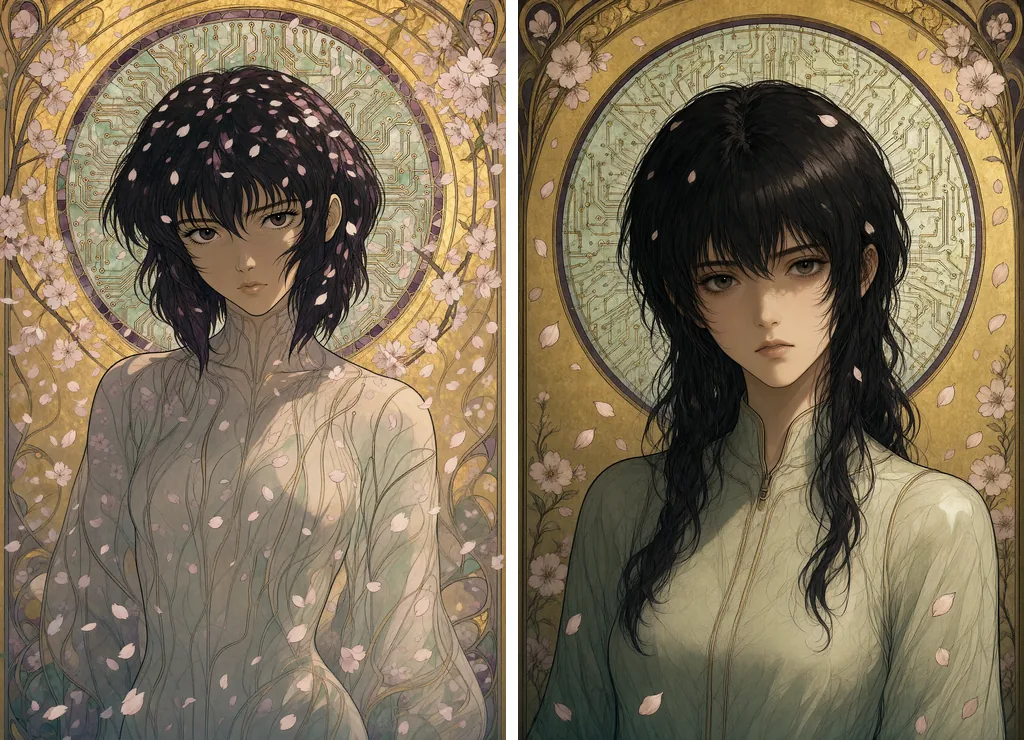
Turbo med guidance. Turbo är inte låst till CFG 1. Testat den 17 oktober 2026 på samma tio seeds plus den här guidens illustration. Behåll dess checkpoint och dess 8 fasta sigman, och ta bara guidance-blocket från basinställningen: CFG 3, den negativa prompten, APG och sedan FreSca.
Grafen är själva Turbo-mallen. Sätt dess CFGGuider på 3 i stället för 1, fyll i den negativa prompten, och lägg in APG och sedan FreSca på modellvägen mellan laddaren och guidern. Noden ManualSigmas och samplern lämnas som de är.
Resultatet behåller Turbos komposition och återfår det som CFG 1 hade plattat till: kontrast, mättnad och fina detaljer. På den här guidens illustration kommer glorians kretskortsbanor tillbaka skarpa och förgyllda, och kronbladen återvänder. På de tio test-seedsen skärps fjällen, pälsen och den broderade västen på samma sätt. Det den inte återfår är mediet. Broderiet förblir ett fotografi av en krokodil.
Kostnaden är det andra passet per steg: 66 till 71 sekunder för en bild på 4 megapixel mot 38 till 39. Det är fortfarande nästan fyra gånger snabbare än basmodellen.
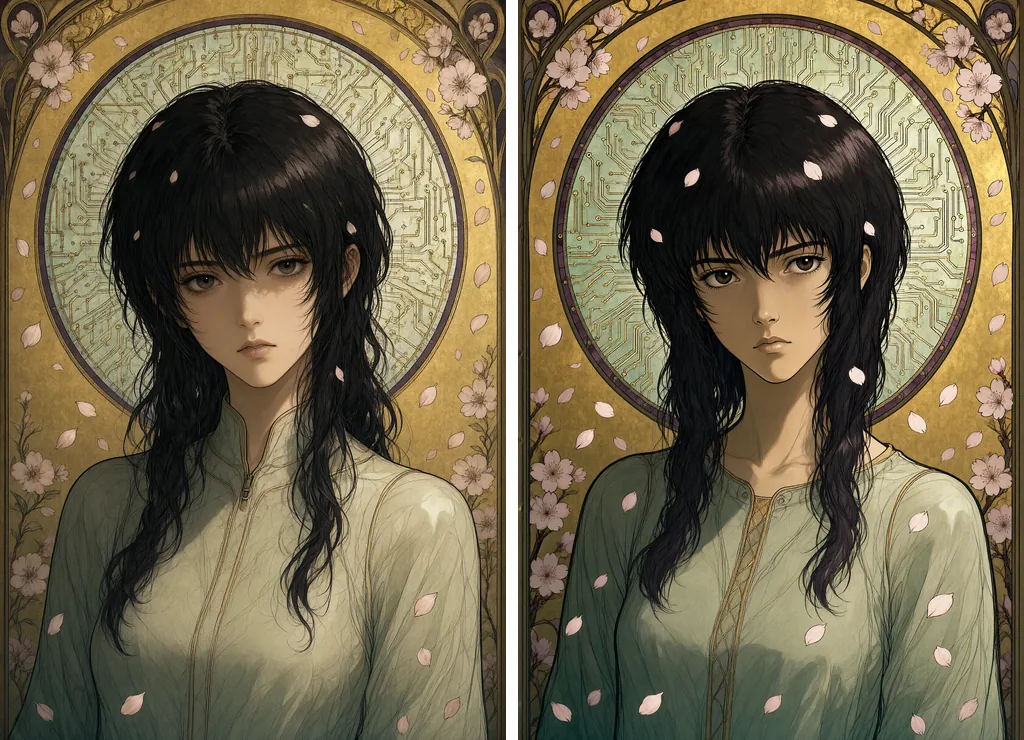
Ladda ner workflowet. ComfyUI-workflowet för Turbo med guidance (JSON) renderar den här illustrationen precis som den är: 1664 × 2432, seed 57658043, CFG 3 med APG och FreSca, den här guidens negativa prompt. Släpp filen i ComfyUI; det förväntar sig de tre modellfilerna som nämns i sista avsnittet. Fritt att återanvända under CC BY 4.0, med en länk till den här sidan.
Försök inte hjälpa Turbo med fler steg. Med 20 steg och scheduler simple vid 4 megapixel och CFG 3, som om den vore basmodellen, överdriver den: hårda hårstrån, en kornig gloria, uppdriven kontrast. Och det tar 169 sekunder. Det destillerade checkpointet vill ha sina 8 sigman.
En rimlig uppdelning. Den rena Turbo som utkastläge, med sju gånger fler kandidater i timmen att välja bland. Turbo med guidance när en fotografisk eller rent tecknad prompt snabbt behöver detaljer. Basmodellen på CFG 3 för allt som är målat, tecknat eller gjort för hand, där själva mediet är poängen.
Andra destillationer. LightX2V publicerade ett 4-stegs Lightning-LoRA för 2.1 den 13 oktober 2026. Det finns även ett 8-stegs-LoRA från communityn, Turbo8. Båda körs på CFG 1 som Turbo. Ingen av dem har mätts här.
Prefixcache-noden. ComfyUI:s nod QwenImage21Cache sätter bara enhet och precision för den cache modellen redan håller. Med standardvärdena ändrar den ingenting. Dess int8-läge halverar cachen, vilket hjälper när minnet tar slut i 2K eller vid redigering med flera referensbilder. Ingen synlig förlust följde med den i de här testerna.
Färre steg. 16 steg sparar ungefär en femtedel av tiden, men ändrar kompositionen och vinner ingen skärpa jämfört med 20. Om tiden är begränsningen, sänk storleken före stegen.
Köra Qwen-Image 2.1 lokalt
ComfyUI stöder modellen nativt. Tre filer läggs i de vanliga mapparna: diffusionsmodellen i diffusion_models, Qwen3-VL-textkodaren i text_encoders, VAE:n i vae.
På ett 16 GB-kort, ta de int8-versioner som Comfy-Org publicerat. bf16-vikterna fungerar också, men svämmar över i systemminnet och tar två till sex gånger längre utan synlig vinst.
Grafen är kort:
- UNETLoader, CLIPLoader med typen
qwen_image, VAELoader; - TextEncodeQwenImage21, som tar prompten och den negativa prompten tillsammans och ger båda konditioneringarna;
- en tom latent i vald storlek;
- APG och sedan FreSca på modellvägen;
- en KSampler på CFG 3 med euler och scheduler simple, sedan VAEDecode.
För en transparent bild sveper du in motivet i formen som modellkortet rekommenderar: ”This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.” Spara sedan som PNG.
Minne: vid 1 megapixel körs int8-modellen, kodaren och VAE:n i 16 GB utan att röra systemminnet. ComfyUI flyttar ut kodaren ur videominnet så snart prompten är kodad. Vid 4 megapixel var prefixcachen satt till int8, och minnet tog aldrig slut. Den första bilden i en session tar längre tid medan filerna laddas.