Qué es Qwen-Image 2.1
Qwen-Image 2.1 es un solo checkpoint para dos tareas. Genera una imagen a partir de un texto, y edita una imagen existente a partir de una frase y hasta diez imágenes de referencia. La parte de generación es un transformador de difusión de 7.000 millones de parámetros. Va emparejado con un codificador de texto Qwen3-VL 8B, cargado en ComfyUI como un archivo aparte.
Un modelo de lenguaje como codificador es lo que le permite leer frases enteras, instrucciones de composición y palabras entrecomilladas, en lugar de listas de palabras clave.
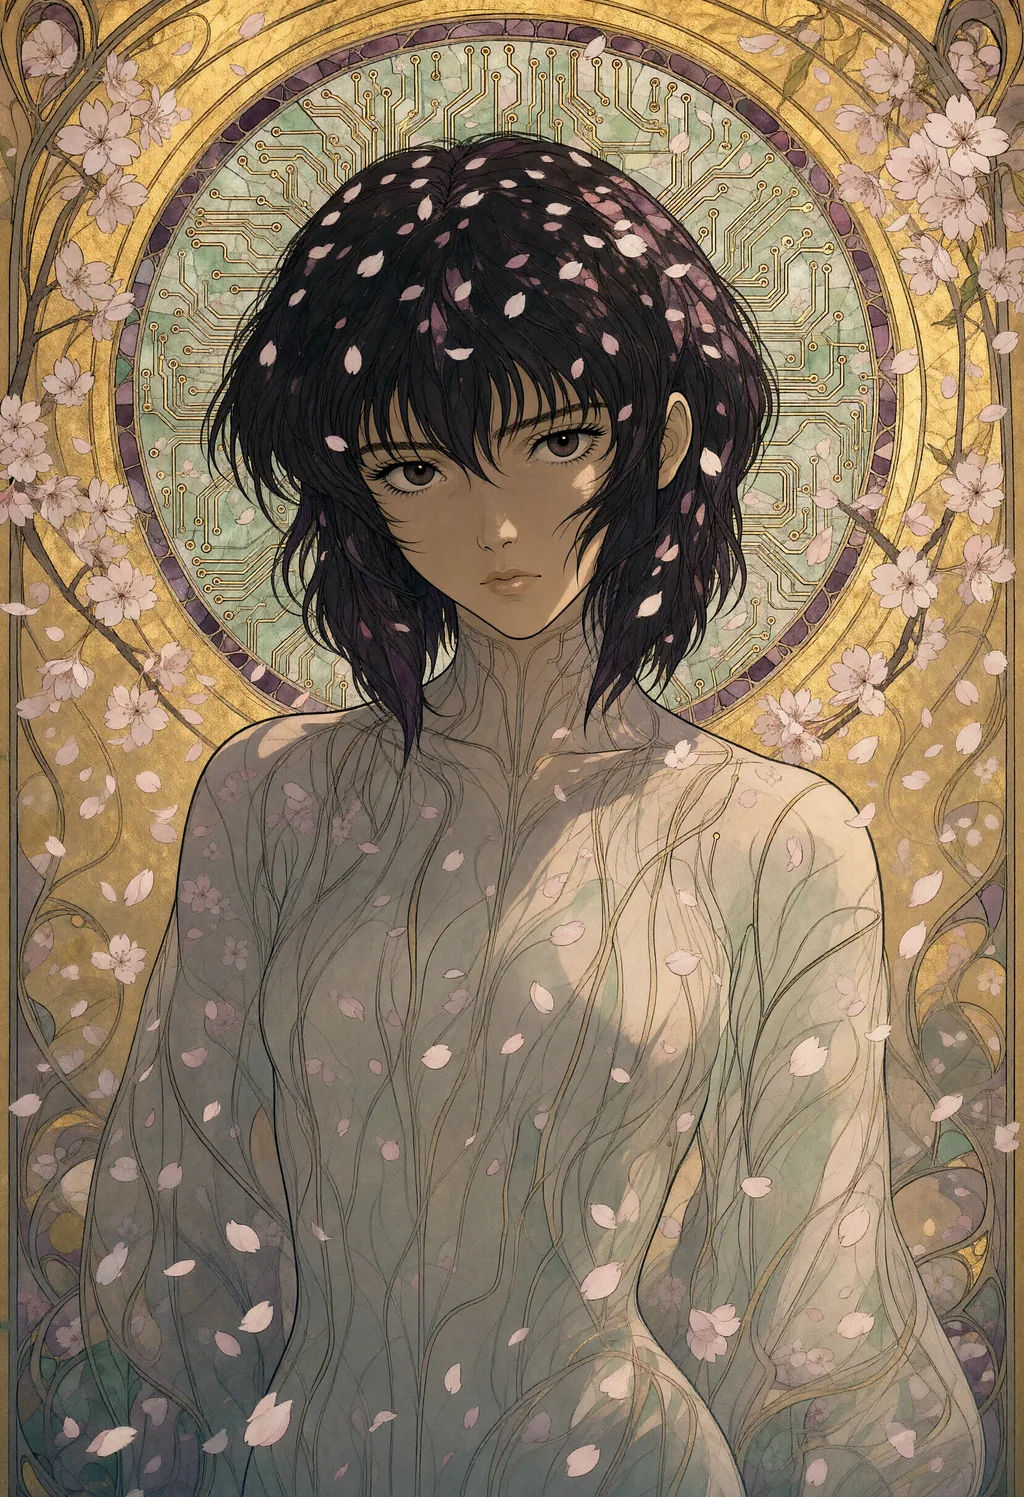
Qwen presenta la 2.1 como una mejora en texturas, tipografía e iluminación de retratos. Trabaja en 2K nativo sin escalado: 2048 × 2048 en cuadrado, 2528 × 1696 en 3:2, 2752 × 1536 en 16:9. También puede producir un canal alfa real cuando el prompt pide un fondo transparente.
El precio es el tiempo. En una tarjeta de consumo con 16 GB de memoria de vídeo, los pesos int8 tardan unos 40 segundos en una imagen de 1 megapíxel. Una imagen de 4 megapíxeles tarda unos cuatro minutos y medio con los ajustes de abajo.
Una cosa que conviene saber antes de descargar. Los pesos están bajo la Qwen Research License: solo investigación y evaluación. Cualquier uso comercial necesita una licencia aparte de Qwen. El primer Qwen-Image, publicado en agosto de 2025, era Apache 2.0. La versión 2.1 no lo es.
Cómo escribir un prompt para Qwen-Image 2.1
Escribe frases, no etiquetas. El codificador de texto es un modelo de lenguaje. Lee el orden de las palabras, las preposiciones y las comillas, y se lo toma todo al pie de la letra. Un «lighthouse cat» se convierte en un gato dibujado sobre un faro.
La estructura de abajo dio los mejores resultados a lo largo de unas mil imágenes. Mantén este orden.
- Medio y sujeto primero: «An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms». El medio fijado al principio tiñe todo lo que viene después.
- Escenario: lugar, época, clima, o lo que llena el aire. «in falling cherry blossoms», «in the 1980s», «during a blizzard».
- Luz con su dirección: «lit from the front by soft diffuse light, with gentle shadows». La dirección se respeta. Un simple «dramatic light», no.
- Encuadre: «close-up of the subject, looking at the viewer», plano medio, visto desde arriba, el sujeto diminuto en un paisaje inmenso.
- Materiales y paleta: «flowing ink lines, flat gold leaf background, muted jade and plum». Es lo que el modelo mejor renderiza en 2K.
- Restricciones, escritas en el prompt: «no lettering, no watermark», «five fingers on each hand». Con guidance 1 el prompt negativo se ignora. Así que el propio prompt tiene que cargar con ellas.
El prompt completo de la ilustración de arriba, en este orden: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
El texto funciona cuando va entrecomillado y con un lugar asignado. «A banner above the door reads 'OPEN ALL NIGHT'» sale bien casi siempre, en mayúsculas o no.
Lo contrario también es cierto. Un escaparate, un diner o un salón recreativo sin texto pedido acaban con un rótulo inventado. Así que di «no lettering» siempre que la escena contenga una fachada.
Los personajes que el modelo no conoce se sustituyen por un doble sin avisar. El Marsupilami se convirtió en un mono. Mothra y Marvin the Martian salieron bien.
Cada ficha Qwen de la página de ejemplos de prompts sigue esta estructura, con su seed, su tamaño y sus ajustes.
Ajustes que funcionan, medidos
La plantilla oficial de ComfyUI trabaja con una guidance (CFG) de 1 y 25 pasos. La ficha del modelo usa 40 pasos. Los ajustes de abajo se quedaron en CFG 3.
En la última prueba, el 16 de octubre de 2026, con las mismas seeds, estos ajustes dieron las imágenes más detalladas y más fieles:
| Ajuste | Valor |
|---|---|
| Guidance (CFG) | 3, con prompt negativo |
| Prompt negativo | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Parches del modelo | APG (eta 1, norm threshold 10, momentum 0,3) y después FreSca (low 1, high 2, cutoff 8), antes del sampler |
| Sampler | euler, scheduler simple |
| Pasos | 25 a 1 megapíxel, 20 a 2,5 y 4 megapíxeles |
| LoRA | ninguno |
La guidance es el único ajuste que no cambia la escena. Con la misma seed y el mismo tamaño, CFG 1 y CFG 3 dan casi la misma composición. Lo que difiere es el acabado.
Con CFG 1 la imagen es más plana y pierde la textura fina. Las puntadas de un bordado se vuelven tela. Una cara de dibujo animado pierde las pupilas y la boca. El metal pierde sus remaches.
Subir CFG 1 a 30 pasos devuelve la nitidez, pero no los materiales ni el contraste. A 2 megapíxeles, un tamaño probado una vez, 40 pasos dan una imagen limpia pero que sigue siendo más plana, y que lee el prompt con menos fiabilidad.
APG evita que CFG 3 sature de más. FreSca afila las frecuencias altas. Los dos solo actúan cuando la guidance está por encima de 1.
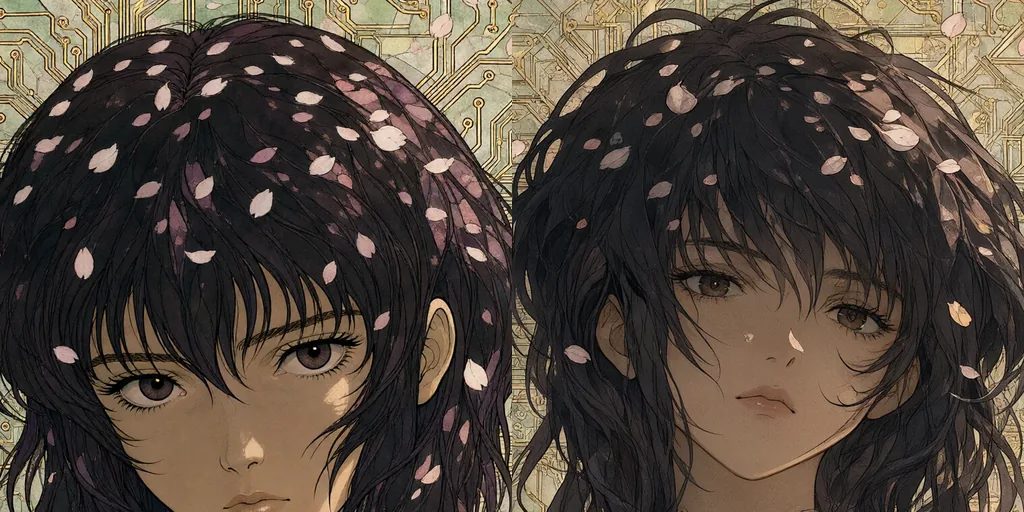
Una guidance por encima de 1 cuesta una segunda pasada por paso, así que CFG 1 es el doble de rápido. En la tarjeta de prueba son de 120 a 135 segundos frente a 255 a 275 para una imagen de 4 megapíxeles. La lenta valió la pena en cada una de las diez parejas de prueba.
Resolución y pasos: qué cambia la imagen
Como cualquier modelo de difusión, Qwen-Image 2.1 no reescala la imagen cuando cambia el tamaño. Produce otra toma de la misma seed, así que una seed encontrada a 1 megapíxel no se traslada a 2K.
Pasar de 1 megapíxel a 2,5 o 4 dio una imagen distinta en todas las parejas probadas. Entre 2,5 y 4 megapíxeles la composición se mantuvo en ocho parejas de diez.
En la ilustración de abajo solo se movieron los detalles. A 2,5 megapíxeles las pistas de circuito dejaron el halo y pasaron al pelo.
Cambiar el número de pasos también cambia la imagen en cuanto la diferencia es grande. 20 y 25 pasos dan casi la misma imagen. Con 16 pasos se desvía. Así que no hay forma de previsualizar a 1 megapíxel y renderizar la misma imagen más grande. Elige primero el tamaño, luego la seed.
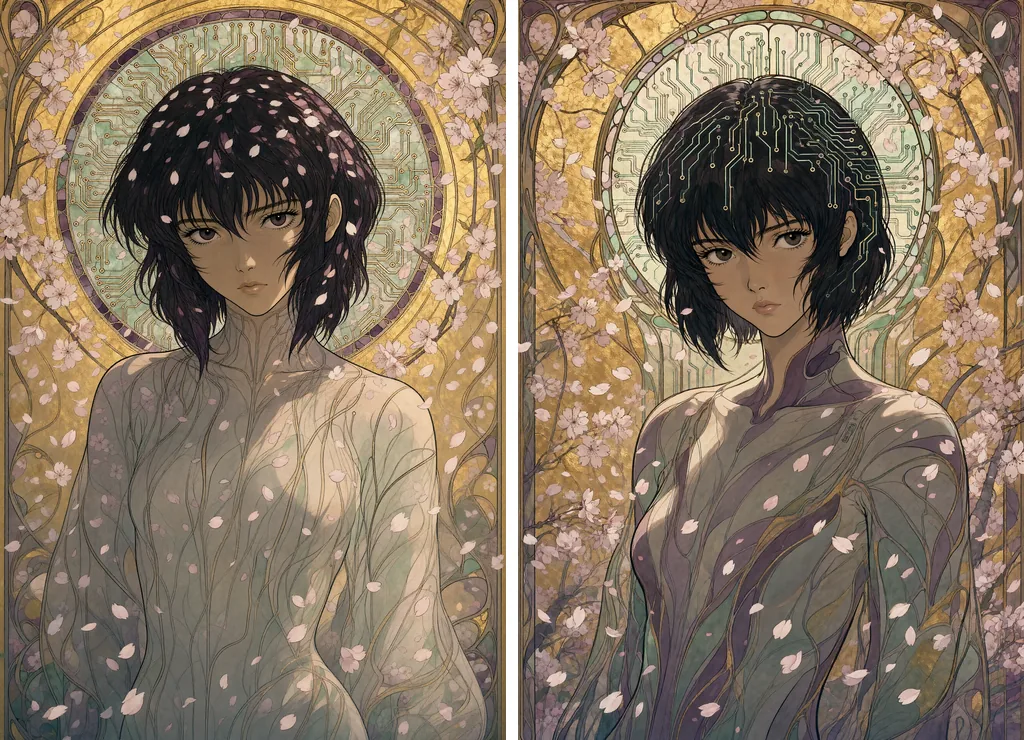
Tiempos medidos con CFG 3, APG y FreSca, pesos int8, en una sola tarjeta de consumo de 16 GB, en horizontal o en el equivalente vertical:
| Tamaño | Pasos | Tiempo por imagen |
|---|---|---|
| 1 megapíxel (1216 × 832) | 25 | unos 40 s |
| 2,5 megapíxeles (1920 × 1312) | 20 | 120 a 135 s |
| 4 megapíxeles (2432 × 1664) | 20 | 255 a 275 s |
| 4 megapíxeles | 25 | 315 a 335 s |
A 2,5 megapíxeles el detalle es algo más suave que a 4 cuando se compara la misma zona al 100 %. Pero el modelo sigue el estilo del prompt al menos igual de bien, y en las diez parejas de prueba a veces mejor. Un bordado mostró sus puntadas con más claridad a 2,5 megapíxeles que a 4.
Para una galería servida a 1024 píxeles, 2,5 megapíxeles a 20 pasos es el punto óptimo. Para imprimir, 4 megapíxeles a 20 pasos.
Acelerar: Turbo, Turbo guiado y el resto
El Turbo. Qwen publicó Qwen-Image-2.1-Turbo el 9 de octubre de 2026. Es un checkpoint destilado que trabaja en 8 pasos con CFG 1 y una secuencia de sigmas fija. Comfy-Org lo distribuye como archivo int8 y como LoRA para el modelo base, con sus propias plantillas en ComfyUI. Se midió el 17 de octubre con las mismas diez seeds y tamaños que los renders a CFG 3 de esta guía, con el grafo exacto de la plantilla.
| Ajuste | Tiempo por imagen |
|---|---|
| Checkpoint Turbo, 8 pasos, CFG 1, 1 megapíxel | 9 a 10 s |
| Checkpoint Turbo, 8 pasos, CFG 1, 4 megapíxeles | 38 a 39 s |
| Turbo guiado, descrito más abajo: checkpoint Turbo, 8 pasos, CFG 3 con APG y FreSca, 4 megapíxeles | 66 a 71 s |
| Checkpoint base más LoRA Turbo, 8 pasos, CFG 1, 4 megapíxeles | 52 a 55 s |
| Checkpoint base, CFG 3, 20 pasos, 4 megapíxeles | 255 a 275 s |
Siete veces más rápido a 4 megapíxeles, cuatro veces a 1. Las imágenes son limpias: nítidas, bien iluminadas, sin fallos de anatomía en las diez seeds, con el texto correcto en los mismos prompts que el modelo base. Los objetos del prompt están ahí, a veces mejor que con el modelo base. La tortuga en su coche de carreras, que el modelo base había omitido en todos los renders, apareció con el Turbo.
Lo que pierde es el medio. En todos los prompts no fotográficos de las diez seeds, el modelo destilado derivó hacia el realismo fotográfico. Un bordado de un cocodrilo se convirtió en una fotografía de un cocodrilo. Un dibujo al carboncillo perdió su grano. Un Marvin the Martian de papel recortado se volvió un muñeco de vinilo. Los rótulos inventados en las fachadas son los mismos que con el modelo base.
En las diez seeds, el LoRA sobre el checkpoint base dio las mismas imágenes que el checkpoint Turbo, solo que más despacio. Así que el checkpoint es lo que hay que descargar. Una seed da una imagen distinta de la del modelo base, como con cualquier cambio de tamaño. La licencia es la misma: solo investigación y evaluación.
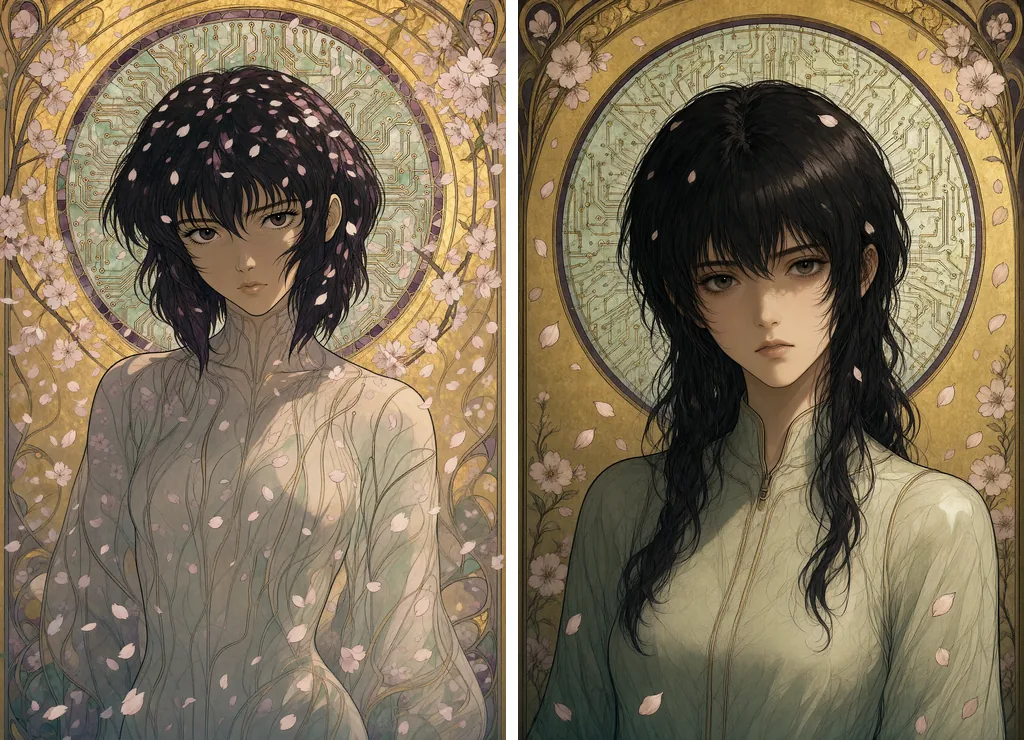
El Turbo guiado. El Turbo no está atado a CFG 1. Probado el 17 de octubre de 2026 con las mismas diez seeds más la ilustración de esta guía. Conserva su checkpoint y sus 8 sigmas fijos, y toma solo el bloque de guidance del preajuste base: CFG 3, el prompt negativo, APG y después FreSca.
El grafo es la propia plantilla Turbo. Pon su CFGGuider a 3 en vez de 1, rellena el prompt negativo e inserta APG y después FreSca en la ruta del modelo entre el loader y el guider. El nodo ManualSigmas y el sampler se quedan como están.
El resultado conserva la composición del Turbo y recupera lo que CFG 1 había aplanado: contraste, saturación y detalle fino. En la ilustración de esta guía, las pistas de circuito del halo vuelven nítidas y doradas, y los pétalos regresan. En las diez seeds de prueba, las escamas, el pelaje y el chaleco bordado ganan nitidez de la misma manera. Lo que no recupera es el medio. El bordado sigue siendo una fotografía de un cocodrilo.
El coste es la segunda pasada por paso: de 66 a 71 segundos para una imagen de 4 megapíxeles frente a 38 a 39. Sigue siendo casi cuatro veces más rápido que el modelo base.
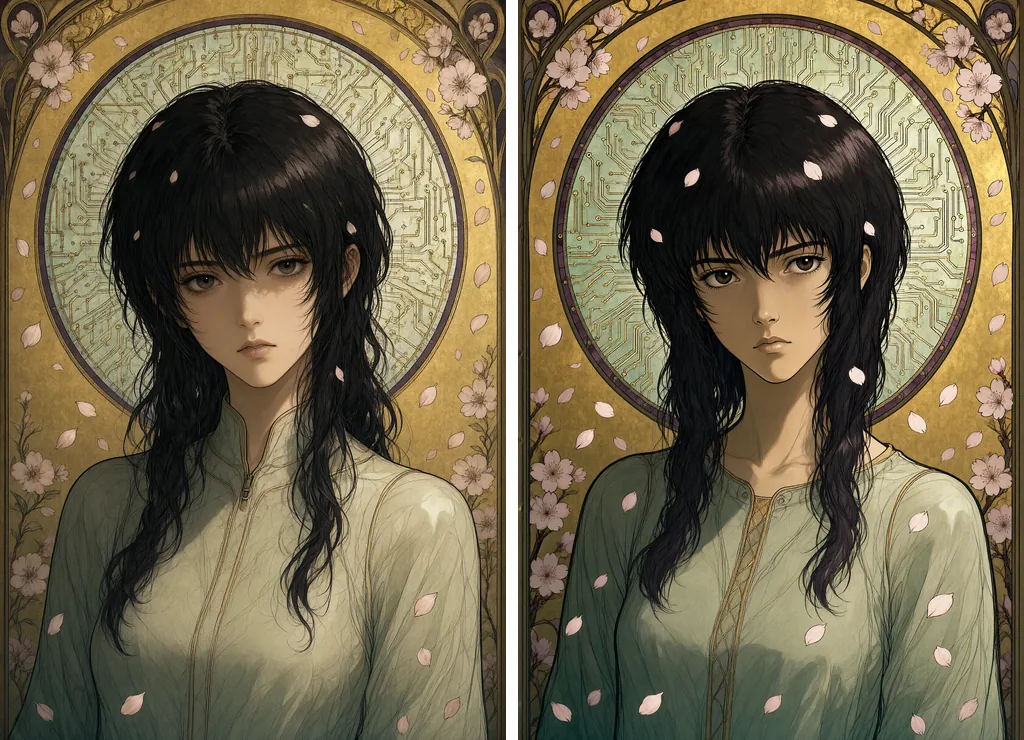
Descarga el workflow. El workflow de ComfyUI del Turbo guiado (JSON) renderiza esta ilustración tal cual: 1664 × 2432, seed 57658043, CFG 3 con APG y FreSca, el prompt negativo de esta guía. Suelta el archivo en ComfyUI; espera los tres archivos de modelo nombrados en la última sección. Libre para reutilizar bajo CC BY 4.0, con un enlace a esta página.
No intentes ayudar al Turbo con más pasos. Con 20 pasos y el scheduler simple a 4 megapíxeles y CFG 3, como si fuera el modelo base, se pasa de cocción: mechones de pelo duros, un halo granulado, contraste forzado. Y tarda 169 segundos. El checkpoint destilado quiere sus 8 sigmas.
Un reparto sensato. El Turbo a secas como modo borrador, con siete veces más candidatas por hora para la criba. El Turbo guiado cuando un prompt fotográfico o de líneas limpias necesita detalle rápido. El modelo base con CFG 3 para todo lo pintado, dibujado o artesanal, donde el propio medio es lo que importa.
Otras destilaciones. LightX2V publicó un LoRA Lightning de 4 pasos para la 2.1 el 13 de octubre de 2026. Existe también un LoRA comunitario de 8 pasos, Turbo8. Los dos trabajan con CFG 1 como el Turbo. Ninguno de los dos se ha medido aquí.
El nodo de caché de prefijo. El nodo QwenImage21Cache de ComfyUI solo fija el dispositivo y la precisión de la caché que el modelo ya mantiene. Con sus valores por defecto no cambia nada. Su modo int8 reduce la caché a la mitad, lo que ayuda cuando la memoria se queda corta en 2K o en edición con varias imágenes de referencia. En estas pruebas no trajo ninguna pérdida visible.
Menos pasos. 16 pasos ahorran alrededor de una quinta parte del tiempo, pero cambian la composición y no ganan nitidez frente a 20. Si la limitación es el tiempo, baja el tamaño antes que los pasos.
Ejecutar Qwen-Image 2.1 en local
ComfyUI admite el modelo de forma nativa. Tres archivos van en las carpetas habituales: el modelo de difusión en diffusion_models, el codificador de texto Qwen3-VL en text_encoders, el VAE en vae.
En una tarjeta de 16 GB, usa las versiones int8 publicadas por Comfy-Org. Los pesos bf16 también funcionan, pero se desbordan a la memoria del sistema y tardan de dos a seis veces más sin ganancia visible.
El grafo es corto:
- UNETLoader, CLIPLoader con el tipo
qwen_image, VAELoader; - TextEncodeQwenImage21, que recibe juntos el prompt y el prompt negativo y devuelve los dos condicionamientos;
- un latente vacío del tamaño elegido;
- APG y después FreSca en la ruta del modelo;
- un KSampler con CFG 3, euler y el scheduler simple, y después VAEDecode.
Para una imagen transparente, envuelve el sujeto en la forma recomendada por la ficha del modelo: «This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.» Después guarda en PNG.
Memoria: a 1 megapíxel, el modelo int8, el codificador y el VAE funcionan en 16 GB sin tocar la memoria del sistema. ComfyUI saca el codificador de la memoria de vídeo una vez codificado el prompt. A 4 megapíxeles la caché de prefijo se puso en int8, y la memoria nunca se agotó. La primera imagen de una sesión tarda más mientras se cargan los archivos.