Czym jest Qwen-Image 2.1
Qwen-Image 2.1 to jeden checkpoint do dwóch zadań. Generuje obraz z tekstu i edytuje istniejący obraz na podstawie zdania i maksymalnie dziesięciu obrazów referencyjnych. Część generująca to transformer dyfuzyjny z 7 miliardami parametrów. Jest sparowana z enkoderem tekstu Qwen3-VL 8B, ładowanym w ComfyUI jako osobny plik.
Model językowy w roli enkodera sprawia, że czyta on całe zdania, instrukcje dotyczące układu i słowa w cudzysłowie, a nie listy słów kluczowych.
Qwen przedstawia 2.1 jako wersję lepszą pod względem tekstur, typografii i oświetlenia portretów. Pracuje w natywnym 2K bez upscalera: 2048 × 2048 dla kwadratu, 2528 × 1696 dla 3:2, 2752 × 1536 dla 16:9. Gdy prompt prosi o przezroczyste tło, model zwraca też prawdziwy kanał alfa.
Ceną jest czas. Na karcie konsumenckiej z 16 GB pamięci wideo wagi int8 dają obraz 1-megapikselowy w około 40 sekund. Obraz 4-megapikselowy zajmuje około czterech i pół minuty z ustawieniami opisanymi niżej.
Jedno trzeba wiedzieć przed pobraniem. Wagi są objęte licencją Qwen Research License: wyłącznie do badań i ewaluacji. Każde użycie komercyjne wymaga osobnej licencji od Qwen. Pierwszy Qwen-Image, wydany w sierpniu 2025 roku, był na licencji Apache 2.0. Wersja 2.1 już nie.
Jak napisać prompt do Qwen-Image 2.1
Pisz zdania, nie tagi. Enkoder tekstu to model językowy. Czyta szyk wyrazów, przyimki i cudzysłowy, i wszystko bierze dosłownie. Prompt „lighthouse cat” zamienia się w kota narysowanego na latarni morskiej.
Poniższa struktura dała najlepsze wyniki na około tysiącu obrazów. Zachowaj tę kolejność.
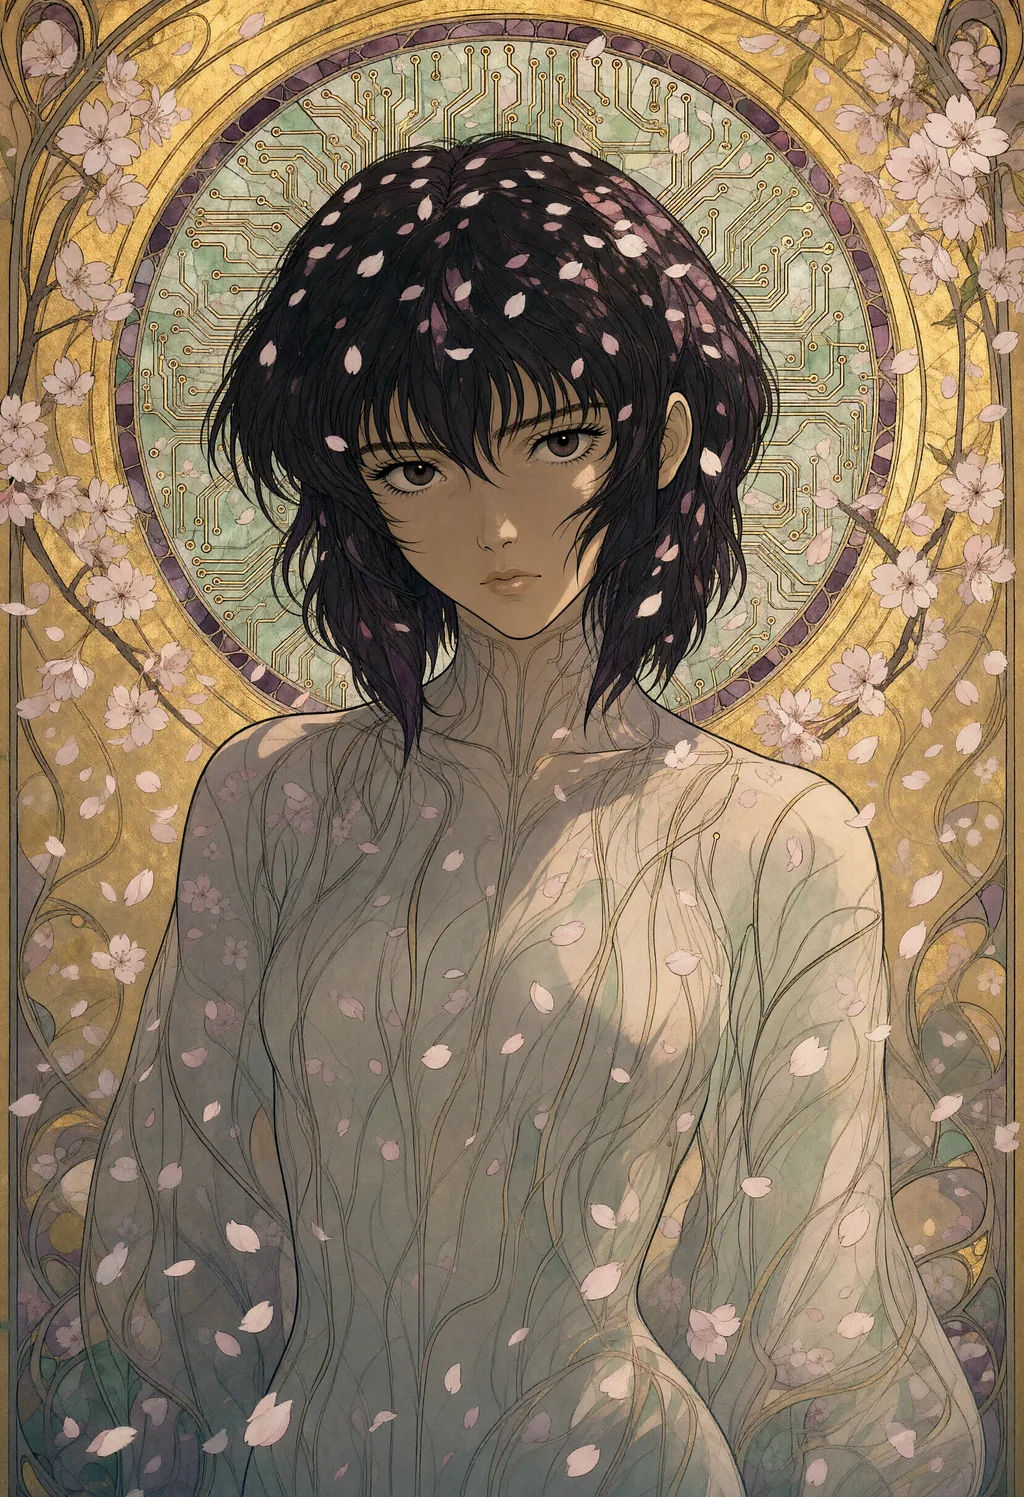
- Najpierw medium i temat: „An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms”. Medium ustawione na początku zabarwia wszystko, co po nim następuje.
- Sceneria: miejsce, epoka, pogoda albo to, co wypełnia powietrze. „in falling cherry blossoms”, „in the 1980s”, „during a blizzard”.
- Światło wraz z kierunkiem: „lit from the front by soft diffuse light, with gentle shadows”. Kierunek jest respektowany. Samo „dramatic light” już nie.
- Kadr: „close-up of the subject, looking at the viewer”, plan średni, widok z góry, maleńka postać w ogromnym krajobrazie.
- Materiały i paleta: „flowing ink lines, flat gold leaf background, muted jade and plum”. To właśnie model renderuje najlepiej w 2K.
- Ograniczenia, wpisane w prompt: „no lettering, no watermark”, „five fingers on each hand”. Przy guidance 1 negatywny prompt jest ignorowany, więc sam prompt musi je zawierać.
Cały prompt ilustracji powyżej, w tej kolejności: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Tekst działa, gdy jest w cudzysłowie i ma wskazane miejsce. „A banner above the door reads 'OPEN ALL NIGHT'” wychodzi poprawnie niemal za każdym razem, wielkimi literami lub nie.
Działa to też w drugą stronę. Witryna sklepu, bar czy salon gier bez zamówionego tekstu obrośnie wymyślonym szyldem. Dopisuj więc „no lettering” zawsze, gdy w scenie jest fasada.
Postacie, których model nie zna, bez ostrzeżenia zastępuje sobowtórem. Marsupilami stał się małpą. Mothra i Marvin the Martian wyszli poprawnie.
Każda karta Qwen na stronie z przykładami promptów trzyma się tej struktury, wraz z seedem, rozmiarem i ustawieniami.
Ustawienia, które działają, zmierzone
Oficjalny szablon ComfyUI pracuje z guidance (CFG) 1 i 25 krokami. Karta modelu używa 40 kroków. Poniższe ustawienia zatrzymały się na CFG 3.
W ostatnim teście 16 października 2026 roku, na tych samych seedach, najbardziej szczegółowe i najwierniejsze obrazy dały te ustawienia:
| Ustawienie | Wartość |
|---|---|
| Guidance (CFG) | 3, z negatywnym promptem |
| Negatywny prompt | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Patche modelu | APG (eta 1, norm threshold 10, momentum 0.3), potem FreSca (low 1, high 2, cutoff 8), przed samplerem |
| Sampler | euler, scheduler simple |
| Kroki | 25 przy 1 megapikselu, 20 przy 2,5 i 4 megapikselach |
| LoRA | brak |
Guidance to jedyne ustawienie, które nie zmienia sceny. Przy tym samym seedzie i rozmiarze CFG 1 i CFG 3 dają niemal tę samą kompozycję. Różni się rendering.
Przy CFG 1 obraz jest bardziej płaski i traci drobną fakturę. Ściegi haftu zamieniają się w tkaninę. Kreskówkowa twarz traci źrenice i usta. Metal traci nity.
Podniesienie CFG 1 do 30 kroków przywraca ostrość, ale nie materiały ani kontrast. Przy 2 megapikselach, rozmiarze wypróbowanym raz, 40 kroków daje czysty, lecz wciąż bardziej płaski obraz, który rzadziej trzyma się promptu.
APG nie pozwala CFG 3 przesycić kolorów. FreSca wyostrza wysokie częstotliwości. Oba działają tylko wtedy, gdy guidance jest większe niż 1.
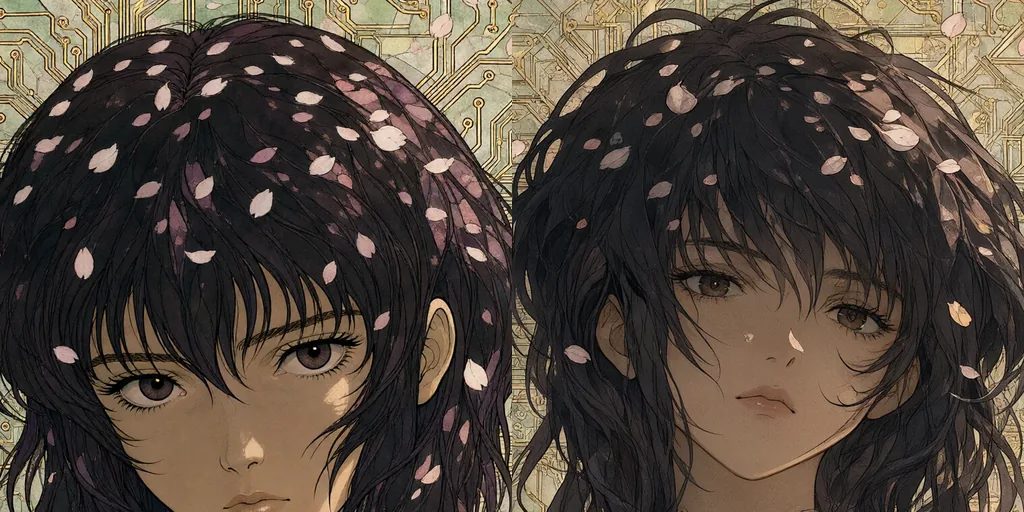
Guidance powyżej 1 kosztuje drugi przebieg na każdy krok, więc CFG 1 jest dwa razy szybsze. Na karcie testowej to 120 do 135 sekund wobec 255 do 275 dla obrazu 4-megapikselowego. Wolniejszy wariant okazał się tego wart w każdej z dziesięciu par testowych.
Rozdzielczość i kroki: co zmienia obraz
Jak każdy model dyfuzyjny, Qwen-Image 2.1 nie skaluje obrazu, gdy zmienia się rozmiar. Daje inne ujęcie tego samego seeda, więc seed znaleziony w 1 megapikselu nie przenosi się na 2K.
Przejście z 1 megapiksela do 2,5 lub 4 dawało inny obraz w każdej testowanej parze. Między 2,5 a 4 megapikselami kompozycja utrzymała się w ośmiu parach na dziesięć.
Na ilustracji poniżej przesunęły się tylko detale. Przy 2,5 megapiksela ścieżki obwodów przeszły z aureoli na włosy.
Zmiana liczby kroków również zmienia obraz, gdy różnica jest duża. 20 i 25 kroków dają niemal ten sam obraz. 16 kroków już odbiega. Nie da się więc zrobić podglądu w 1 megapikselu i wyrenderować tego samego obrazu w większym rozmiarze. Najpierw wybierz rozmiar, potem seed.
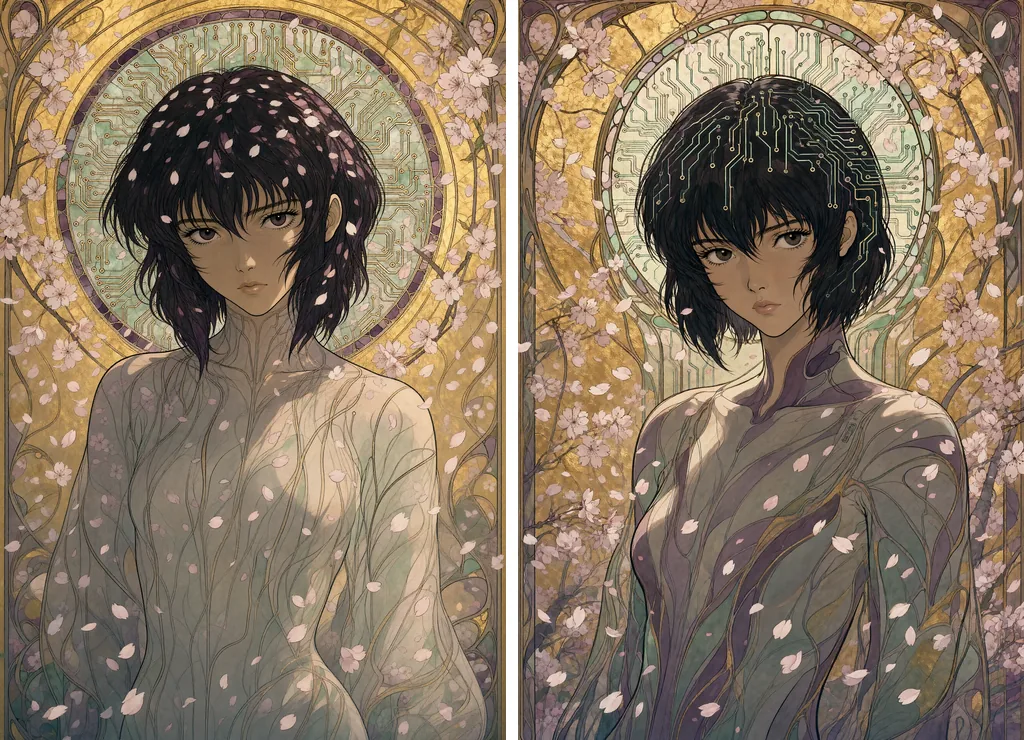
Czasy zmierzone z CFG 3, APG i FreSca, wagami int8, na jednej karcie konsumenckiej 16 GB, w poziomie lub w równoważnym pionie:
| Rozmiar | Kroki | Czas na obraz |
|---|---|---|
| 1 megapiksel (1216 × 832) | 25 | około 40 s |
| 2,5 megapiksela (1920 × 1312) | 20 | 120 do 135 s |
| 4 megapiksele (2432 × 1664) | 20 | 255 do 275 s |
| 4 megapiksele | 25 | 315 do 335 s |
Przy 2,5 megapiksela detal jest nieco bardziej miękki niż przy 4, gdy porównać ten sam fragment w skali 100%. Ale model trzyma się stylu promptu co najmniej równie dobrze, a w dziesięciu parach testowych czasem lepiej. Haft pokazał ściegi wyraźniej przy 2,5 megapiksela niż przy 4.
Do galerii serwowanej w 1024 pikselach optimum to 2,5 megapiksela przy 20 krokach. Do druku: 4 megapiksele przy 20 krokach.
Przyspieszenia: Turbo, Turbo z guidance i reszta
Turbo. 9 października 2026 roku Qwen wydał Qwen-Image-2.1-Turbo. To destylowany checkpoint, który działa w 8 krokach przy CFG 1 ze stałym harmonogramem sigm. Comfy-Org dostarcza go jako plik int8 i jako LoRA do modelu bazowego, z własnymi szablonami w ComfyUI. Został zmierzony 17 października na tych samych dziesięciu seedach i rozmiarach co rendery z CFG 3 w tym poradniku, z dokładnie takim grafem jak w szablonie.
| Ustawienie | Czas na obraz |
|---|---|
| Checkpoint Turbo, 8 kroków, CFG 1, 1 megapiksel | 9 do 10 s |
| Checkpoint Turbo, 8 kroków, CFG 1, 4 megapiksele | 38 do 39 s |
| Turbo z guidance, opisany niżej: checkpoint Turbo, 8 kroków, CFG 3 z APG i FreSca, 4 megapiksele | 66 do 71 s |
| Checkpoint bazowy plus LoRA Turbo, 8 kroków, CFG 1, 4 megapiksele | 52 do 55 s |
| Checkpoint bazowy, CFG 3, 20 kroków, 4 megapiksele | 255 do 275 s |
Siedem razy szybciej przy 4 megapikselach, cztery razy przy 1. Obrazy są czyste: ostre, dobrze oświetlone, bez potknięć anatomii na dziesięciu seedach, tekst poprawny na tych samych promptach co w modelu bazowym. Obiekty z promptu są na miejscu, czasem lepiej niż w modelu bazowym. Żółwica w swoim samochodzie wyścigowym, którą model bazowy gubił w każdym renderze, z Turbo się pojawiła.
To, co traci, to medium. W każdym niefotograficznym prompcie z dziesięciu seedów destylowany model dryfował w stronę fotograficznego realizmu. Haft z krokodylem stał się zdjęciem krokodyla. Rysunek węglem stracił ziarno. Marvin the Martian z wycinanki zamienił się w winylową figurkę. Wymyślone napisy na fasadach są takie same jak w modelu bazowym.
Na dziesięciu seedach LoRA na checkpoincie bazowym dała te same obrazy co checkpoint Turbo, tylko wolniej. Pobierać warto więc checkpoint. Seed daje inny obraz niż w modelu bazowym, jak przy każdej zmianie rozmiaru. Licencja jest ta sama: wyłącznie badania i ewaluacja.
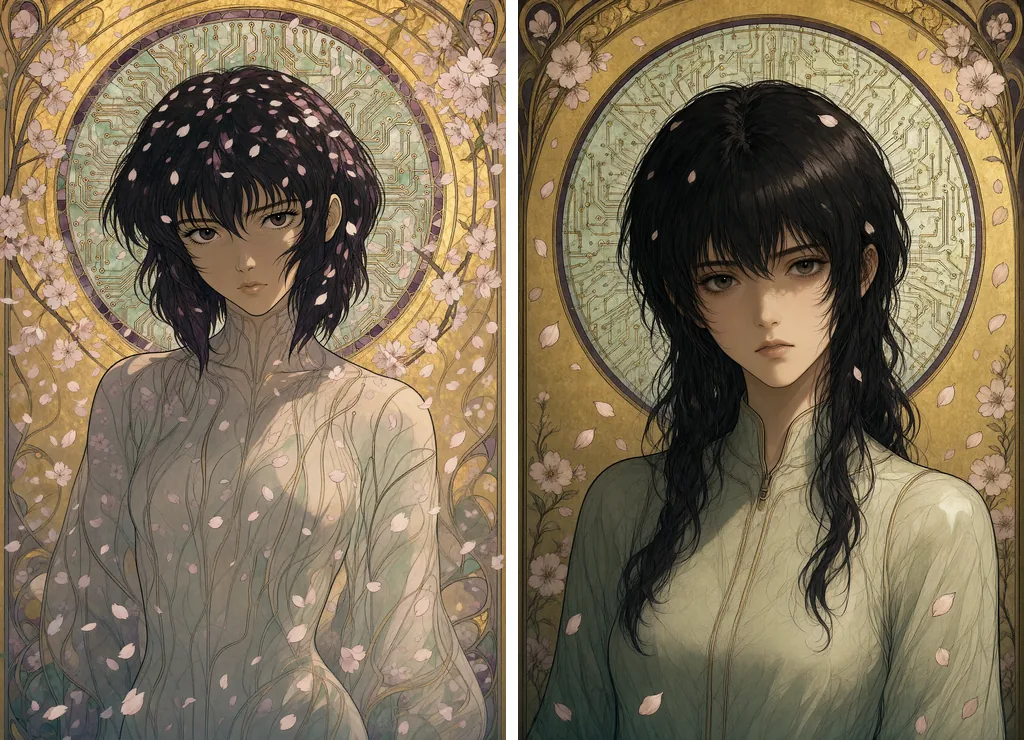
Turbo z guidance. Turbo nie jest przywiązany do CFG 1. Przetestowano to 17 października 2026 roku na tych samych dziesięciu seedach oraz na ilustracji z tego poradnika. Zostaw jego checkpoint i jego 8 stałych sigm, a z presetu bazowego weź tylko blok guidance: CFG 3, negatywny prompt, APG, potem FreSca.
Graf to sam szablon Turbo. Ustaw jego CFGGuider na 3 zamiast 1, wpisz negatywny prompt i wstaw APG, a potem FreSca na ścieżce modelu między loaderem a guiderem. Węzeł ManualSigmas i sampler zostają bez zmian.
Wynik zachowuje kompozycję Turbo i odzyskuje to, co CFG 1 spłaszczyło: kontrast, nasycenie i drobne detale. Na ilustracji z tego poradnika ścieżki obwodów w aureoli wracają ostre i złocone, a płatki pojawiają się znowu. Na dziesięciu seedach testowych łuski, futro i haftowana kamizelka wyostrzają się tak samo. Nie odzyskuje natomiast medium. Haft pozostaje zdjęciem krokodyla.
Kosztem jest drugi przebieg na każdy krok: 66 do 71 sekund dla obrazu 4-megapikselowego wobec 38 do 39. To wciąż prawie cztery razy szybciej niż model bazowy.
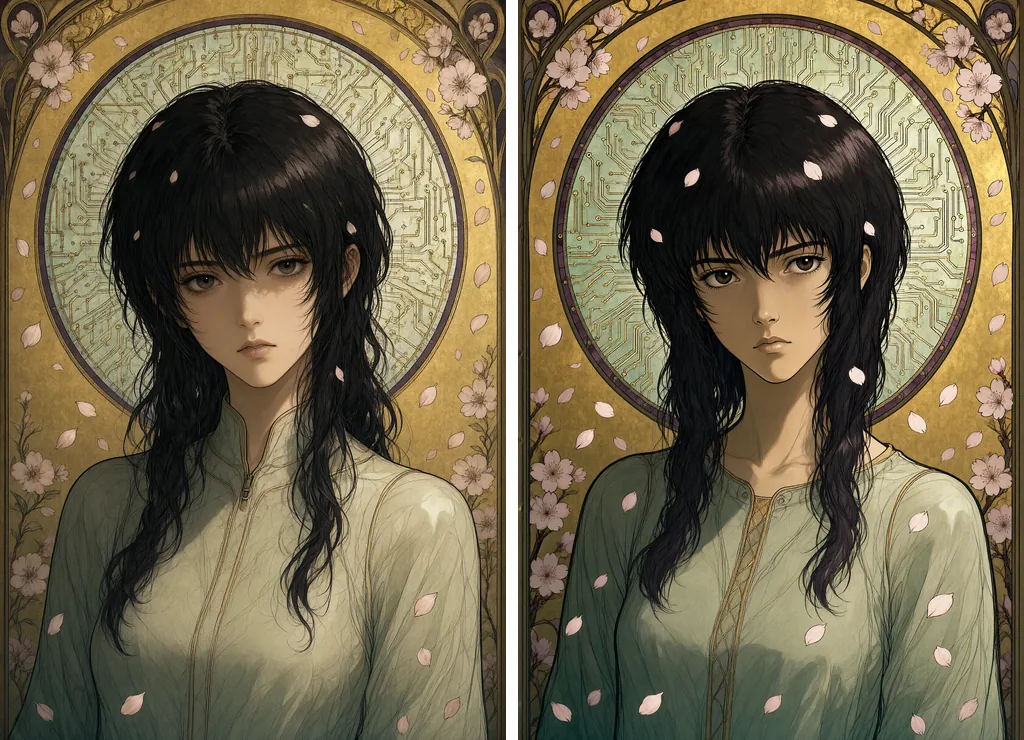
Pobierz workflow. Workflow ComfyUI dla Turbo z guidance (JSON) renderuje tę ilustrację dokładnie tak, jak jest: 1664 × 2432, seed 57658043, CFG 3 z APG i FreSca, negatywny prompt z tego poradnika. Przeciągnij plik do ComfyUI; oczekuje on trzech plików modelu wymienionych w ostatniej sekcji. Do swobodnego ponownego użycia na licencji CC BY 4.0, z linkiem do tej strony.
Nie próbuj pomagać Turbo większą liczbą kroków. Przy 20 krokach i schedulerze simple w 4 megapikselach i CFG 3, jak gdyby był modelem bazowym, przypala obraz: twarde kosmyki włosów, ziarnista aureola, przeciągnięty kontrast. I zajmuje to 169 sekund. Destylowany checkpoint chce swoich 8 sigm.
Rozsądny podział. Zwykły Turbo jako tryb szkicu, z siedem razy większą liczbą kandydatów na godzinę do wyboru. Turbo z guidance, gdy prompt fotograficzny lub o czystej kresce potrzebuje szybko detalu. Model bazowy z CFG 3 do wszystkiego, co malowane, rysowane lub rękodzielnicze, gdzie samo medium jest istotą.
Inne destylacje. LightX2V opublikował 13 października 2026 roku 4-krokową LoRA Lightning dla 2.1. Istnieje też społecznościowa 8-krokowa LoRA, Turbo8. Obie działają przy CFG 1, tak jak Turbo. Żadnej z nich tu nie zmierzono.
Węzeł cache prefiksu. Węzeł QwenImage21Cache w ComfyUI ustawia tylko urządzenie i precyzję cache, który model i tak utrzymuje. Z domyślnymi wartościami nie zmienia niczego. Jego tryb int8 zmniejsza cache o połowę, co pomaga, gdy brakuje pamięci w 2K albo przy edycji z kilkoma obrazami referencyjnymi. W tych testach nie przyniósł żadnej widocznej straty.
Mniej kroków. 16 kroków oszczędza około jednej piątej czasu, ale zmienia kompozycję i nie daje więcej ostrości niż 20. Jeśli ograniczeniem jest czas, obniż najpierw rozmiar, a dopiero potem liczbę kroków.
Uruchamianie Qwen-Image 2.1 lokalnie
ComfyUI obsługuje model natywnie. Trzy pliki trafiają do zwykłych folderów: model dyfuzyjny do diffusion_models, enkoder tekstu Qwen3-VL do text_encoders, VAE do vae.
Na karcie 16 GB bierz wersje int8 opublikowane przez Comfy-Org. Wagi bf16 też działają, ale wylewają się do pamięci systemowej i potrzebują od dwóch do sześciu razy więcej czasu bez widocznego zysku.
Graf jest krótki:
- UNETLoader, CLIPLoader z typem
qwen_image, VAELoader; - TextEncodeQwenImage21, który przyjmuje prompt i negatywny prompt razem i zwraca oba conditioningi;
- pusty latent w wybranym rozmiarze;
- APG, a potem FreSca na ścieżce modelu;
- KSampler z CFG 3, euler i schedulerem simple, następnie VAEDecode.
Dla przezroczystego obrazu obuduj temat zalecaną przez kartę modelu formułą: „This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.” Następnie zapisz jako PNG.
Pamięć: przy 1 megapikselu model int8, enkoder i VAE działają w 16 GB bez sięgania do pamięci systemowej. ComfyUI wyrzuca enkoder z pamięci wideo, gdy prompt jest już zakodowany. Przy 4 megapikselach cache prefiksu był ustawiony na int8 i pamięci ani razu nie zabrakło. Pierwszy obraz w sesji trwa dłużej, bo pliki się ładują.