Czym jest Qwen-Image, w skrócie
Qwen-Image to linia modeli do generowania obrazów w Qwen, rodzinie modeli chmurowego działu Alibaby. Pojawił się w sierpniu 2025 roku jako model o 20 miliardach parametrów na licencji Apache 2.0, z raportem technicznym. Wyróżniał się tekstem. Akapity, szyldy i etykiety wychodziły czytelne, po angielsku, a przede wszystkim po chińsku, tam gdzie Stable Diffusion 1.5 i SDXL dawały bazgroły, a modele z 2024 roku radziły sobie najwyżej z kilkoma angielskimi słowami.
Aktualne otwarte wydanie to Qwen-Image 2.1, opublikowane 20 września 2026 roku. To model mniejszy i szybszy: 7 miliardów parametrów w generatorze obrazu plus enkoder wizyjno-językowy o 8 miliardach parametrów. Jeden checkpoint robi dwie rzeczy. Generuje obraz z tekstu i edytuje istniejący obraz na podstawie zdania i maksymalnie dziesięciu obrazów referencyjnych. Zwraca natywne 2K i prawdziwie przezroczyste obrazy. Jego licencja nie jest już Apache: wyłącznie badania i ewaluacja.
Podobnie jak Stable Diffusion i FLUX jest to model dyfuzyjny, który działa w ComfyUI na konsumenckiej karcie graficznej i czyta ten sam rodzaj promptu. Różnice są w środku, i właśnie je wyjaśnia sekcja o tym, jak działa.
Co potrafi Qwen-Image 2.1
Text-to-image w natywnym 2K. Model renderuje bezpośrednio kwadraty 2048 × 2048, 2528 × 1696 w 3:2 i 2752 × 1536 w 16:9, bez upscalera. Czyta prompt jak tekst, więc działają zdania, przyimki i instrukcje dotyczące układu, a słowa w cudzysłowie pojawiają się tak, jak zostały napisane: „a banner above the door reads ‘OPEN ALL NIGHT’” wychodzi dosłownie na promptach testowych z poradnika ustawień. Poradnik ustawień podaje strukturę promptu, która działa najlepiej, oraz zmierzone ustawienia.
Edycja tym samym checkpointem. Daj mu obraz i zdanie, a zmieni obraz: podmieni obiekt, przestylizuje scenę, doda tekst. Daj mu do dziesięciu obrazów referencyjnych, a złoży je w całość, zachowując spójność postaci lub produktu między ujęciami. Obszary można wskazać maską albo narysowanym kółkiem. Do lokalnych poprawek nie trzeba osobnego checkpointu do inpaintingu: ten sam model traktuje obszar jako wskazówkę.
Przezroczyste wyjście. Poproś o obraz RGBA z przezroczystym tłem, a model wygeneruje prawdziwy kanał alfa, a nie wycinek z tła: VAE koduje i dekoduje cztery kanały pikseli zamiast trzech. Loga, naklejki i warstwowe zasoby wychodzą gotowe do wstawienia.
Przepisywanie promptu. Qwen dostarcza dwa modele towarzyszące, dotrenowane wersje Qwen3.5-VL 9B, które rozwijają krótki prompt do szczegółowej formy, jaką generator woli: jeden do generowania, drugi do edycji. ComfyUI udostępnia je w swoich szablonach jako opcję, domyślnie wyłączoną; nie są wymagane.
Szybkość. Na konsumenckiej karcie 16 GB wagi int8 potrzebują około 40 sekund na obraz 1-megapikselowy i od czterech do pięciu minut na 4 megapiksele przy ustawieniach jakościowych z poradnika ustawień. Destylowany checkpoint Turbo, wydany 9 października 2026 roku, renderuje w 8 krokach, około siedem razy szybciej przy 4 megapikselach, kosztem medium: rysunki, hafty i wycinanki z papieru dryfują w stronę fotografii.
Qwen-Image vs Stable Diffusion: jak działa
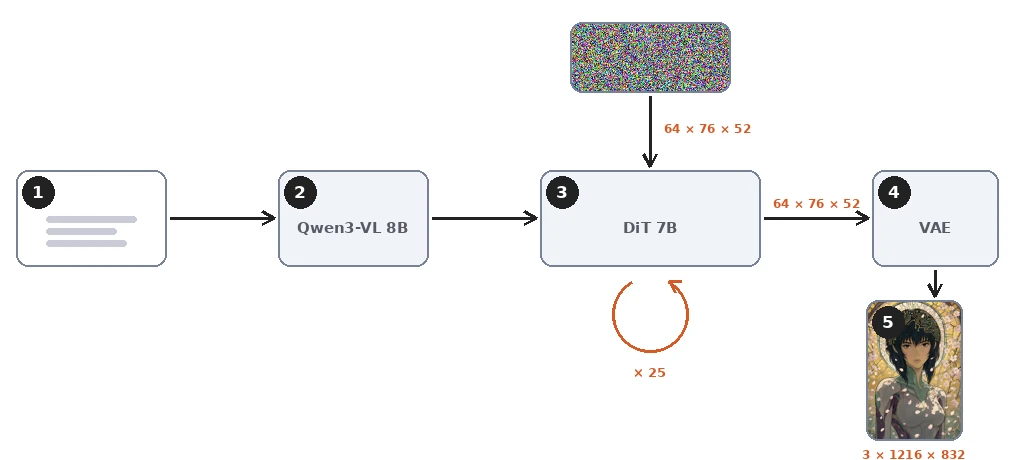
Qwen-Image 2.1 to model dyfuzyjny, więc obowiązuje mechanika opisana w poradniku o Stable Diffusion. Enkoder tekstu czyta prompt. Odszumiacz pracuje na skompresowanym latencie przez pewną liczbę kroków. Dekoder zamienia latent w piksele. Różnica tkwi w wyborze dokonanym dla każdej z trzech części. Repozytorium modelu podaje poniższe fakty; Qwen nie opublikował raportu technicznego dla 2.1.
Model wizyjno-językowy zamiast CLIP
Stable Diffusion 1.5 i SDXL czytają prompt za pomocą CLIP, sieci wytrenowanej do dopasowywania krótkich podpisów do obrazów. Qwen-Image 2.1 czyta go za pomocą Qwen3-VL 8B, pełnego modelu wizyjno-językowego o ośmiu miliardach parametrów, większego niż sam generator obrazu. Ten sam enkoder czyta obrazy referencyjne przy edycji. Dlatego właśnie działa struktura promptu z poradnika ustawień. Zdania, przyimki, tekst w cudzysłowie i instrukcje dotyczące układu to dokładnie to, do czego stworzono model językowy. Enkoder CLIP zwykle spłaszcza je do worka pojęć.
Jednostrumieniowy transformer zamiast U-Netu
Odszumiacz to transformer dyfuzyjny o 32 warstwach i 7 miliardach parametrów. SDXL używa U-Netu, bloków konwolucyjnych z warstwami atencji między nimi. Stable Diffusion 3 również przeszedł na transformer, MMDiT, w którym tokeny tekstu i obrazu płyną dwoma strumieniami o osobnych wagach i spotykają się tylko w atencji każdej warstwy. Qwen-Image 2.1 idzie o krok dalej: tokeny tekstu i obrazu tworzą jedną sekwencję i przechodzą przez te same wagi, i to właśnie znaczy „jednostrumieniowy”. Pierwszy Qwen-Image z 2025 roku był dwustrumieniowym MMDiT o 20 miliardach parametrów; 2.1 ma około jednej trzeciej tego rozmiaru.
Dwa szczegóły jego atencji mają znaczenie w praktyce. Tokeny tekstu są czytane przyczynowo, jak w modelu językowym, a każdy obraz, referencyjny lub generowany, to jeden blok, w którym wszystkie tokeny widzą się nawzajem. Kolejność jest taka: najpierw prompt, potem obrazy referencyjne, na końcu generowany obraz, a token nigdy nie patrzy na to, co jest po nim. Prompt i obrazy referencyjne nie widzą więc nigdy generowanego obrazu, a należąca do nich część obliczeń, prefiks, jest identyczna w każdym kroku: liczy się ją raz i trzyma w cache przez wszystkie kroki odszumiania. Węzeł QwenImage21Cache w ComfyUI wybiera tylko, gdzie ten cache ma być, w jakiej precyzji i czy w ogóle jest używany.
Latent o 64 kanałach, skompresowany szesnastokrotnie
VAE Stable Diffusion zmniejsza obraz ośmiokrotnie na każdym boku, do 4 kanałów, 16 w wersji 3. VAE Qwen-Image 2.1 zmniejsza go szesnastokrotnie na każdym boku, do 64 kanałów. Koduje też i dekoduje cztery kanały pikseli, czerwony, zielony, niebieski i alfa, zamiast trzech, i właśnie dzięki temu model zwraca prawdziwe obrazy RGBA z tego samego latentu o 64 kanałach. Dla obrazu 832 × 1216 latent ma 64 kanały po 52 × 76: około 253 000 liczb na 3 miliony wartości pikseli, dwanaście razy mniej.
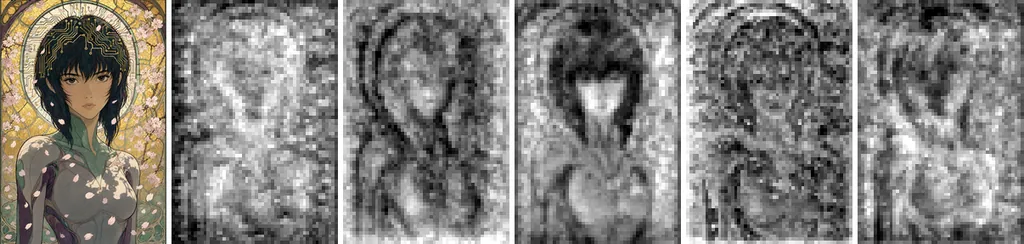
Każda pozycja latentu to jeden token dla transformera, więc obraz 1-megapikselowy to 3 952 tokeny, a 4-megapikselowy 15 808. Ta siatka nie jest rzadsza niż w Stable Diffusion 3 czy w pierwszym Qwen-Image, które przed transformerem grupują swój latent o kompresji 8× w łaty 2 × 2. Zmiana w 2.1 polega na tym, że to grupowanie wykonuje sam VAE, w 64 kanałach. Koszt atencji rośnie z kwadratem liczby tokenów, dlatego 4 megapiksele kosztują znacznie więcej niż cztery razy 1 megapiksel.
Flow matching zamiast przewidywania szumu
Stable Diffusion 1.5 i SDXL trenowano tak, by przewidywały szum dodany do obrazu. Qwen-Image, podobnie jak Stable Diffusion 3 i FLUX, jest trenowany metodą flow matching. Sieć przewiduje kierunek od zaszumionego latentu do czystego, wzdłuż linii prostej. Sampler podąża następnie w tym kierunku krokami Eulera. Repozytorium nazywa ten scheduler: flow matching z dyskretnymi krokami Eulera i dynamicznym przesunięciem (shift). Pierwszy raport o Qwen-Image opisuje cel treningu, jakim jest prędkość wzdłuż prostych ścieżek, a scheduler 2.1 sugeruje, że pozostał on bez zmian.
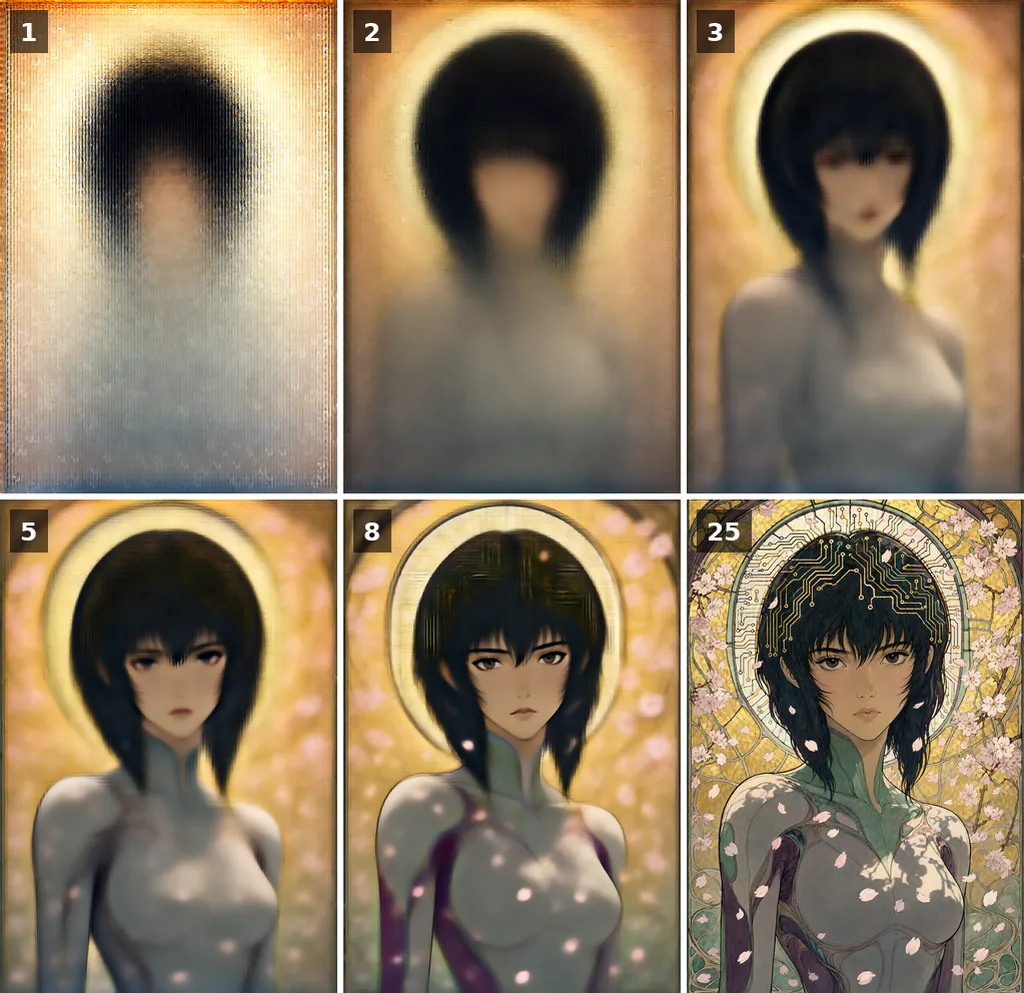
Poniższa ilustracja pokazuje, jak po drodze wygląda szacowany przez model gotowy obraz. Kompozycja ustala się w pierwszych krokach, a szczegóły przychodzą później. Ta kolejność, od ogółu do szczegółu, jest wspólna dla wszystkich modeli dyfuzyjnych; flow matching zmienia głównie rozmieszczenie kroków, i to właśnie reguluje dynamiczny shift.
Obok siebie
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Enkoder tekstu | CLIP ViT-L i OpenCLIP bigG | Dwa enkodery CLIP i T5-XXL | Qwen3-VL 8B, model wizyjno-językowy |
| Odszumiacz | U-Net, 2,6 miliarda parametrów | Dwustrumieniowy MMDiT, 8 miliardów | Jednostrumieniowy transformer dyfuzyjny, 7 miliardów, 32 warstwy |
| Latent | 4 kanały, kompresja 8× | 16 kanałów, 8× | 64 kanały, 16×, z kanałem alfa |
| Cel treningu | Przewidywanie szumu | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Natywny rozmiar | 1024 px | 1024 px | 2048 px |
| Edycja | Model do inpaintingu od firm trzecich | Brak oficjalnego modelu do edycji, tylko ControlNety | Ten sam checkpoint, do 10 obrazów referencyjnych |
| Licencja | OpenRAIL++-M | Community License | Qwen Research License |
Nic z tego nie zmienia sposobu sterowania modelem. Guidance, kroki, seed i rozmiar zachowują się jak w każdym modelu dyfuzyjnym; różnią się tylko liczby, które działają najlepiej, a poradnik ustawień je mierzy.
Wersje: od Qwen-Image do 2.1
Numeracja jest myląca, bo idzie za architekturą, a nie za kanałem wydania. Qwen-Image 2.0, zapowiedziany w lutym 2026 roku i nigdy nie wydany jako wagi, wprowadził lżejszą konstrukcję, którą 2.1 teraz udostępnia otwarcie. Qwen-Image 3.0, zapowiedziany w lipcu 2026 roku, to większy flagowiec dostępny wyłącznie przez API Alibaby. Qwen nie wyjaśnił tego schematu; poniższe daty pochodzą z repozytoriów projektu, a dla 3.0 z ogłoszenia Qwen.
| Wydanie | Data | Co to jest | Wagi |
|---|---|---|---|
| Qwen-Image | 4 sierpnia 2025 | Dwustrumieniowy MMDiT o 20 miliardach parametrów z enkoderem Qwen2.5-VL 7B; text-to-image | Otwarte, Apache 2.0 |
| Qwen-Image-Edit, potem Edit-2509 i Edit-2511 | Od sierpnia do grudnia 2025 | Modele do edycji na tej samej bazie; kilka obrazów referencyjnych od 2509; warstwowy model RGBA, Qwen-Image-Layered, w grudniu | Otwarte, Apache 2.0 |
| Qwen-Image-2512 | 31 grudnia 2025 | Ostatnie wydanie text-to-image linii 20-miliardowej | Otwarte, Apache 2.0 |
| Qwen-Image 2.0 | 10 lutego 2026 | Konstrukcja, którą dziedziczy 2.1: enkoder Qwen3-VL, VAE o 64 kanałach, natywne 2K, instrukcje do 1 000 tokenów; raport techniczny w maju 2026 | Nieopublikowane |
| Qwen-Image 3.0 | 21 lipca 2026 | Flagowiec za API Alibaby: prompty do 4 500 tokenów, infografiki i storyboardy renderowane w jednym przebiegu | Tylko API |
| Qwen-Image 2.1 | 20 września 2026 | Jednostrumieniowy transformer o 7 miliardach parametrów z enkoderem Qwen3-VL 8B; generowanie i edycja w jednym checkpoincie, RGBA, 2K | Otwarte, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 października 2026 | Destylowany 2.1, 8 kroków | Otwarte, Qwen Research License |
Na stronie pobierania „Qwen-Image” bez numeru to więc model o 20 miliardach parametrów z 2025 roku, wciąż dostępny ze swoimi aktualizacjami 2512 i Edit. Aktualny otwarty model to 2.1, a 3.0 to model stojący za płatną usługą Alibaby. 2.1 i 3.0 mają wspólny rodowód, ale nie wagi.
Licencja Qwen-Image: otwarte wagi, tylko do badań
Pierwszy Qwen-Image i jego modele do edycji były na licencji Apache 2.0: wolne do wszystkiego, łącznie z użyciem komercyjnym. Qwen-Image 2.1 i jego Turbo są objęte Qwen Research License Agreement. Wagi można pobierać, badać, uruchamiać i dotrenowywać, ale wyłącznie do badań i ewaluacji. Każde użycie komercyjne wymaga osobnej licencji od Qwen.
To stawia 2.1 w innym miejscu niż Stable Diffusion, którego licencje 1.5 i SDXL pozwalają na użycie komercyjne z listą zastosowań zabronionych, a licencja 3.5 pozwala na nie poniżej miliona dolarów rocznego przychodu, oraz niż FLUX 3 Klein, darmowy do użytku komercyjnego poniżej pięciu milionów. Dla studenta czy laboratorium nic się nie zmienia. Dla studia otwarte pozostają dwie drogi: płatne API albo licencja komercyjna, o którą trzeba wystąpić do Qwen.
Jak wypróbować Qwen-Image i co dalej
Najszybsza droga to darmowa strona Qwen-Image 2.1 w tym serwisie: bez konta, z generowaniem i edycją z obrazami referencyjnymi, z kolejką pokazywaną na żywo.
Żeby uruchomić go u siebie, ComfyUI obsługuje model natywnie. Trzy pliki przepakowane przez Comfy-Org trafiają do zwykłych folderów: model dyfuzyjny, enkoder tekstu Qwen3-VL i VAE, w wersjach int8 na kartę 16 GB. Poradnik ustawień opisuje graf, strukturę promptu, guidance i rozmiary zmierzone dokładnie na tej karcie, a także Turbo i Turbo z guidance.
O zasadach wspólnych dla wszystkich tych modeli, szumie, przestrzeni latentnej, guidance i seedzie, przeczytasz w Co to jest Stable Diffusion?; wyjaśnienia przenoszą się wprost, zmieniają się tylko liczby.