Qwen-Image คืออะไร โดยย่อ
Qwen-Image คือสายโมเดลสร้างภาพของ Qwen ซึ่งเป็นตระกูลโมเดลของฝ่ายคลาวด์ Alibaba เปิดตัวเมื่อสิงหาคม 2025 เป็นโมเดล 20 พันล้านพารามิเตอร์ภายใต้ใบอนุญาต Apache 2.0 พร้อมรายงานทางเทคนิค จุดที่โดดเด่นคือตัวอักษร ย่อหน้า ป้าย และฉลากออกมาอ่านออก ทั้งภาษาอังกฤษและยิ่งกว่านั้นคือภาษาจีน ในขณะที่ Stable Diffusion 1.5 กับ SDXL ได้แค่เส้นยึกยือ และโมเดลของปี 2024 เขียนคำอังกฤษถูกได้ไม่กี่คำ
รุ่นเปิดปัจจุบันคือ Qwen-Image 2.1 เผยแพร่เมื่อ 20 กันยายน 2026 เป็นโมเดลที่เล็กลงและเร็วขึ้น: ตัวสร้างภาพ 7 พันล้านพารามิเตอร์ บวก encoder แบบ vision-language อีก 8 พันล้านพารามิเตอร์ checkpoint เดียวทำสองงาน สร้างภาพจากข้อความ และแก้ไขภาพที่มีอยู่จากประโยคเดียวบวกภาพอ้างอิงได้ถึงสิบภาพ ส่งออก 2K แบบ native และภาพโปร่งใสจริง ส่วนใบอนุญาตไม่ใช่ Apache อีกต่อไป: ใช้เพื่อการวิจัยและประเมินผลเท่านั้น
เช่นเดียวกับ Stable Diffusion และ FLUX มันคือ diffusion model ที่รันใน ComfyUI บนการ์ดจอทั่วไป และอ่าน prompt แบบเดียวกัน สิ่งที่ต่างอยู่ข้างใน และนั่นคือสิ่งที่หัวข้อเรื่องการทำงานจะอธิบาย
Qwen-Image 2.1 ทำอะไรได้บ้าง
Text-to-image ที่ 2K แบบ native โมเดลเรนเดอร์ 2048 × 2048 สำหรับจัตุรัส, 2528 × 1696 สำหรับ 3:2 และ 2752 × 1536 สำหรับ 16:9 ได้โดยตรง ไม่ต้องอัปสเกล มันอ่าน prompt เป็นข้อความ ประโยค คำบุพบท และคำสั่งจัดวางจึงใช้ได้ และคำในเครื่องหมายคำพูดจะปรากฏตามที่เขียน: “a banner above the door reads ‘OPEN ALL NIGHT’” ออกมาตรงตามนั้นใน prompt ทดสอบของคู่มือการตั้งค่า คู่มือการตั้งค่าให้โครง prompt ที่ได้ผลดีที่สุดและค่าที่วัดจริง
แก้ไขภาพด้วย checkpoint เดียวกัน ให้ภาพกับประโยคหนึ่ง มันจะเปลี่ยนภาพให้: เปลี่ยนวัตถุ เปลี่ยนสไตล์ฉาก เพิ่มตัวอักษร ให้ภาพอ้างอิงได้ถึงสิบภาพ มันจะประกอบเข้าด้วยกัน โดยคงตัวละครหรือสินค้าให้เหมือนเดิมทุกช็อต ระบุบริเวณได้ด้วย mask หรือวงกลมที่วาดเอง ไม่ต้องมี checkpoint สำหรับ inpainting แยกต่างหากสำหรับการแก้เฉพาะจุด: โมเดลเดียวกันรับบริเวณนั้นเป็นคำใบ้
ภาพโปร่งใส ขอภาพ RGBA พื้นหลังโปร่งใส โมเดลจะสร้าง alpha channel จริง ไม่ใช่การไดคัท: VAE เข้ารหัสและถอดรหัสช่องสีพิกเซลสี่ช่องแทนที่จะเป็นสาม โลโก้ สติกเกอร์ และชิ้นงานแบบเลเยอร์ออกมาพร้อมวางใช้ได้เลย
เขียน prompt ใหม่ให้ Qwen มาพร้อมโมเดลคู่หูสองตัว เป็น Qwen3.5-VL 9B ที่ fine-tune มา ซึ่งขยาย prompt สั้น ๆ ให้เป็นแบบละเอียดอย่างที่ตัวสร้างภาพชอบ ตัวหนึ่งสำหรับสร้างภาพ อีกตัวสำหรับแก้ไข ComfyUI มีให้เป็นตัวเลือกในเทมเพลต ปิดไว้เป็นค่าเริ่มต้น และไม่จำเป็นต้องใช้
ความเร็ว บนการ์ดจอทั่วไป 16 GB weights แบบ int8 ใช้เวลาราว 40 วินาทีสำหรับภาพ 1 ล้านพิกเซล และสี่ถึงห้านาทีสำหรับ 4 ล้านพิกเซล ด้วยค่าคุณภาพของคู่มือการตั้งค่า checkpoint Turbo ที่ distill แล้ว ออกเมื่อ 9 ตุลาคม 2026 เรนเดอร์ใน 8 step เร็วกว่าราวเจ็ดเท่าที่ 4 ล้านพิกเซล แลกกับเรื่องสื่อวัสดุ: ภาพวาดลายเส้น งานปัก และงานตัดกระดาษจะเอนไปทางภาพถ่าย
Qwen-Image กับ Stable Diffusion: ทำงานอย่างไร
Qwen-Image 2.1 เป็น diffusion model ดังนั้นกลไกที่อธิบายในคู่มือ Stable Diffusion ใช้ได้ทั้งหมด text encoder อ่าน prompt ส่วน denoiser ทำงานบน latent ที่บีบอัดแล้วเป็นจำนวน step หนึ่ง จากนั้น decoder แปลง latent กลับเป็นพิกเซล สิ่งที่ต่างคือทางเลือกในแต่ละส่วนจากสามส่วนนี้ ข้อเท็จจริงด้านล่างมาจากrepository ของโมเดล ทั้งนี้ Qwen ยังไม่ได้เผยแพร่รายงานทางเทคนิคสำหรับ 2.1
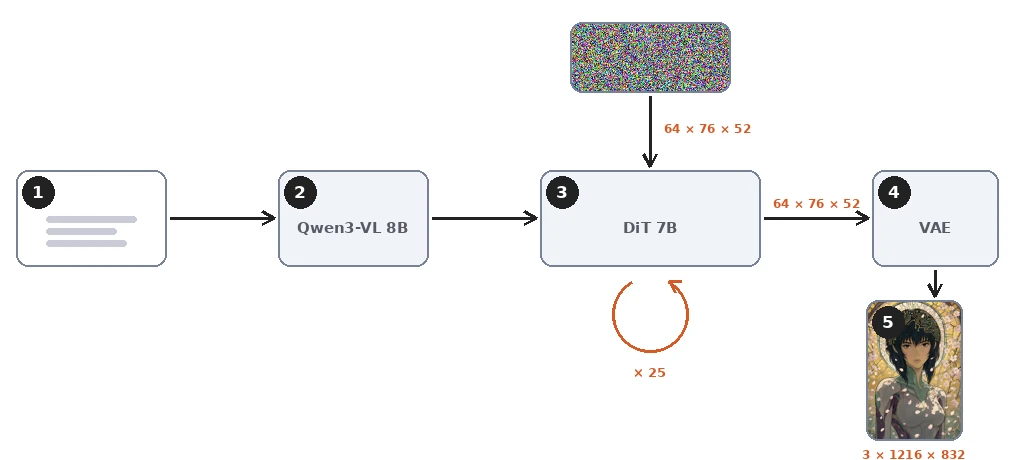
โมเดล vision-language แทน CLIP
Stable Diffusion 1.5 และ SDXL อ่าน prompt ด้วย CLIP โครงข่ายที่ฝึกให้จับคู่คำบรรยายสั้น ๆ กับภาพ Qwen-Image 2.1 อ่านด้วย Qwen3-VL 8B โมเดล vision-language เต็มรูปแบบ 8 พันล้านพารามิเตอร์ ซึ่งมากกว่าตัวสร้างภาพเสียอีก encoder ตัวเดียวกันนี้อ่านภาพอ้างอิงตอนแก้ไขด้วย นี่คือเหตุผลที่โครง prompt ในคู่มือการตั้งค่าได้ผล ประโยค คำบุพบท ข้อความในเครื่องหมายคำพูด และคำสั่งจัดวาง คือสิ่งที่โมเดลภาษาถูกสร้างมาเพื่อแยกแยะ ส่วน encoder แบบ CLIP มักบี้มันให้แบนเป็นกองแนวคิด
Transformer แบบ single-stream แทน U-Net
denoiser คือ diffusion transformer 32 ชั้น 7 พันล้านพารามิเตอร์ SDXL ใช้ U-Net ซึ่งเป็นบล็อก convolution ที่มีชั้น attention คั่นอยู่ Stable Diffusion 3 ย้ายมาใช้ transformer เช่นกันคือ MMDiT ซึ่งtoken ของข้อความและของภาพวิ่งในสองสายที่มี weights แยกกัน และมาเจอกันเฉพาะใน attention ของแต่ละชั้น Qwen-Image 2.1 ไปไกลกว่านั้นอีกขั้น: token ของข้อความและภาพรวมเป็นลำดับเดียวและผ่าน weights ชุดเดียวกัน นี่คือความหมายของ “single-stream” Qwen-Image รุ่นแรกของปี 2025 เป็น MMDiT แบบ double-stream ขนาด 20 พันล้านพารามิเตอร์ ส่วน 2.1 มีขนาดราวหนึ่งในสามของนั้น
รายละเอียดของ attention สองข้อมีผลในทางปฏิบัติ token ของข้อความถูกอ่านแบบ causal เหมือนในโมเดลภาษา และแต่ละภาพ ไม่ว่าภาพอ้างอิงหรือภาพที่สร้าง เป็นหนึ่งบล็อกที่ token ทั้งหมดมองเห็นกันเอง ลำดับคือ prompt ก่อน ตามด้วยภาพอ้างอิง และภาพที่สร้างมาท้ายสุด token จะไม่มองสิ่งที่อยู่ถัดจากมันเลย ดังนั้น prompt และภาพอ้างอิงจึงไม่เคยเห็นภาพที่กำลังสร้าง และส่วนของการคำนวณที่เป็นของพวกมัน ซึ่งก็คือ prefix จะเหมือนกันทุก step: คำนวณครั้งเดียวแล้วแคชไว้ใช้ข้าม step ของการลดสัญญาณรบกวน โหนด QwenImage21Cache ของ ComfyUI แค่เลือกว่าแคชนั้นอยู่ที่ไหน ความละเอียดเชิงตัวเลขเท่าใด หรือจะใช้หรือไม่
Latent 64 channel บีบอัดสิบหกเท่า
VAE ของ Stable Diffusion ย่อภาพลงแปดเท่าในแต่ละด้านให้เหลือ 4 channel และ 16 channel ในเวอร์ชัน 3 ส่วน VAE ของ Qwen-Image 2.1 ย่อลงสิบหกเท่าในแต่ละด้าน เป็น 64 channel มันยังเข้ารหัสและถอดรหัสช่องสีพิกเซลสี่ช่อง คือแดง เขียว น้ำเงิน และ alpha แทนที่จะเป็นสาม นี่คือวิธีที่โมเดลส่งออกภาพ RGBA จริงจาก latent 64 channel ชุดเดียวกัน สำหรับภาพ 832 × 1216 latent มีขนาด 64 channel ของ 52 × 76: ราว 253,000 ตัวเลข แทนค่าพิกเซล 3 ล้านค่า น้อยกว่าสิบสองเท่า
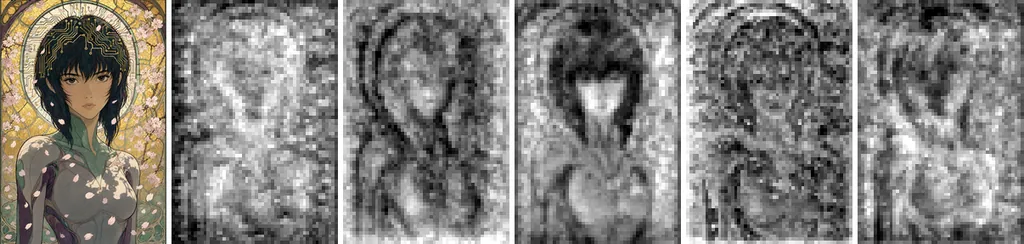
แต่ละตำแหน่งของ latent คือหนึ่ง token สำหรับ transformer ภาพ 1 ล้านพิกเซลจึงเป็น 3,952 token และภาพ 4 ล้านพิกเซลเป็น 15,808 token ตารางนี้ไม่ได้หยาบกว่าของ Stable Diffusion 3 หรือ Qwen-Image รุ่นแรก ซึ่งจับ latent ที่บีบอัด 8 เท่าของพวกมันเป็นแพตช์ 2 × 2 ก่อนเข้า transformer สิ่งที่ 2.1 เปลี่ยนคือ VAE ทำการจัดกลุ่มนั้นเองใน 64 channel ต้นทุนของ attention โตตามกำลังสองของจำนวน token นี่คือเหตุผลที่ 4 ล้านพิกเซลแพงกว่าสี่เท่าของ 1 ล้านพิกเซลมาก
Flow matching แทนการทำนายสัญญาณรบกวน
Stable Diffusion 1.5 และ SDXL ถูกฝึกให้ทำนายสัญญาณรบกวนที่ใส่เข้าไปในภาพ Qwen-Image เหมือน Stable Diffusion 3 และ FLUX ถูกฝึกด้วย flow matching โครงข่ายทำนายทิศทางจาก latent ที่มีสัญญาณรบกวนไปยัง latent ที่สะอาด ตามเส้นตรง จากนั้น sampler เดินตามทิศทางนั้นด้วย step แบบ Euler repository ระบุชื่อ scheduler นี้ไว้ว่า flow matching ด้วย step แบบ Euler discrete และ dynamic shift รายงานของ Qwen-Image รุ่นแรกบรรยายเป้าหมายการฝึกไว้เป็น velocity target ตามเส้นทางตรง ซึ่ง scheduler ของ 2.1 บ่งบอกว่าไม่ได้เปลี่ยน
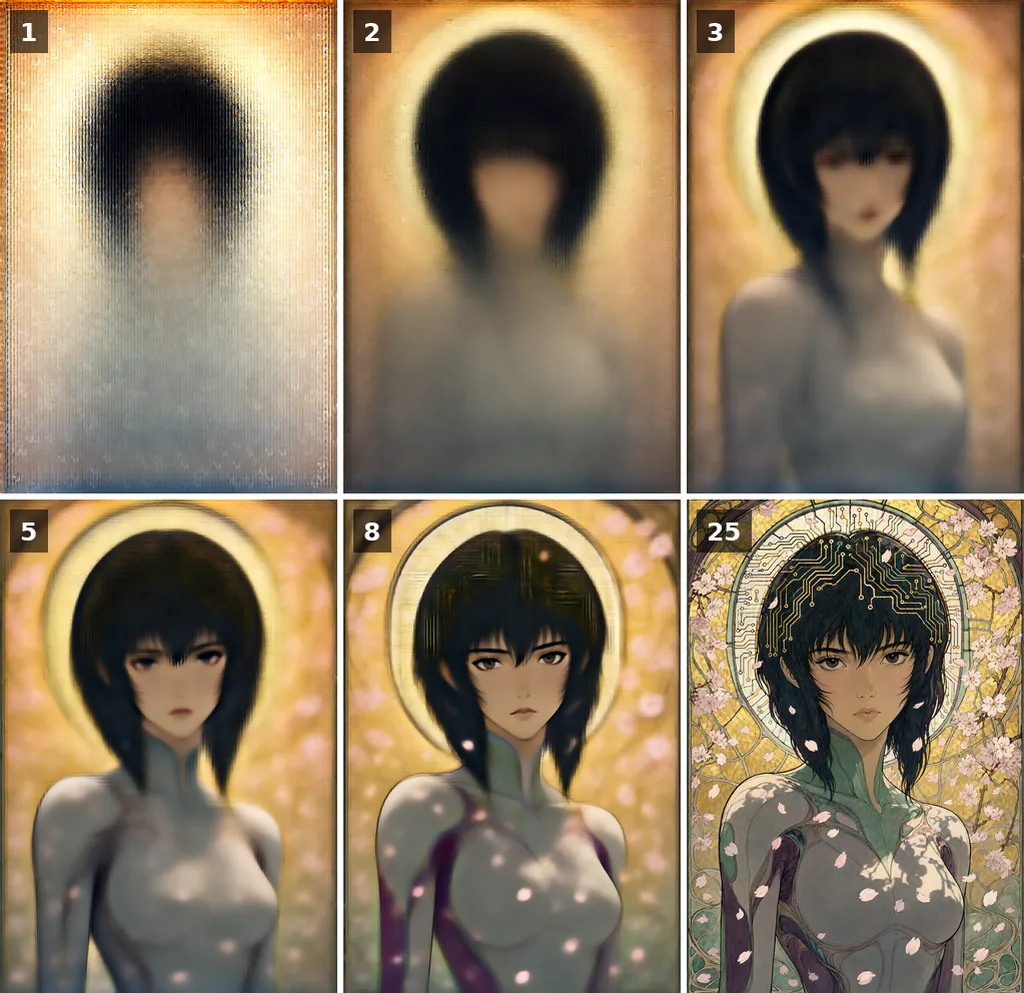
ภาพด้านล่างแสดงว่าภาพสำเร็จที่โมเดลคาดเดาไว้ระหว่างทางหน้าตาเป็นอย่างไร องค์ประกอบถูกกำหนดใน step แรก ๆ และรายละเอียดมาทีหลัง ลำดับจากหยาบไปละเอียดนี้เป็นเรื่องปกติของ diffusion model ทุกตัว สิ่งที่ flow matching เปลี่ยนเป็นหลักคือระยะห่างของ step ซึ่งเป็นสิ่งที่ dynamic shift ปรับ
เทียบกันแบบเคียงข้าง
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Text encoder | CLIP ViT-L และ OpenCLIP bigG | CLIP encoder สองตัวและ T5-XXL | Qwen3-VL 8B โมเดล vision-language |
| Denoiser | U-Net 2.6 พันล้านพารามิเตอร์ | MMDiT แบบ double-stream 8 พันล้าน | Diffusion transformer แบบ single-stream 7 พันล้าน 32 ชั้น |
| Latent | 4 channel บีบอัด 8× | 16 channel 8× | 64 channel 16× พร้อม alpha |
| เป้าหมายการฝึก | ทำนายสัญญาณรบกวน | Flow matching (rectified flow) | Flow matching (rectified flow) |
| ขนาด native | 1024 px | 1024 px | 2048 px |
| การแก้ไขภาพ | โมเดล inpainting จากบุคคลที่สาม | ไม่มีโมเดลแก้ไขอย่างเป็นทางการ มีแต่ ControlNet | checkpoint เดียวกัน ภาพอ้างอิงได้ถึง 10 ภาพ |
| ใบอนุญาต | OpenRAIL++-M | Community License | Qwen Research License |
ทั้งหมดนี้ไม่ได้เปลี่ยนวิธีควบคุมโมเดล guidance, step, seed และขนาดทำงานเหมือนใน diffusion model ทุกตัว ต่างกันแค่ตัวเลขที่ได้ผลดีที่สุด และคู่มือการตั้งค่าวัดค่าเหล่านั้นไว้แล้ว
เวอร์ชันต่าง ๆ จาก Qwen-Image ถึง 2.1
เลขเวอร์ชันชวนสับสน เพราะมันไล่ตามสถาปัตยกรรม ไม่ใช่ช่องทางเผยแพร่ Qwen-Image 2.0 ประกาศเมื่อกุมภาพันธ์ 2026 และไม่เคยเผยแพร่เป็น weights เป็นรุ่นที่เปิดตัวการออกแบบที่เบากว่าซึ่ง 2.1 นำมาเผยแพร่แบบเปิดในตอนนี้ Qwen-Image 3.0 ประกาศเมื่อกรกฎาคม 2026 เป็นรุ่นเรือธงที่ใหญ่กว่า ให้บริการผ่าน API ของ Alibaba เท่านั้น Qwen ไม่ได้อธิบายระบบเลขนี้ วันที่ด้านล่างมาจาก repository ของโครงการ และสำหรับ 3.0 มาจากประกาศของ Qwen
| รุ่น | วันที่ | คืออะไร | Weights |
|---|---|---|---|
| Qwen-Image | 4 สิงหาคม 2025 | MMDiT แบบ double-stream 20 พันล้านพารามิเตอร์ พร้อม encoder Qwen2.5-VL 7B; text-to-image | เปิด Apache 2.0 |
| Qwen-Image-Edit ตามด้วย Edit-2509 และ Edit-2511 | สิงหาคมถึงธันวาคม 2025 | โมเดลแก้ไขภาพบนฐานเดียวกัน; รับภาพอ้างอิงหลายภาพตั้งแต่ 2509; โมเดล RGBA แบบเลเยอร์ Qwen-Image-Layered ในเดือนธันวาคม | เปิด Apache 2.0 |
| Qwen-Image-2512 | 31 ธันวาคม 2025 | รุ่น text-to-image สุดท้ายของสาย 20 พันล้าน | เปิด Apache 2.0 |
| Qwen-Image 2.0 | 10 กุมภาพันธ์ 2026 | การออกแบบที่ 2.1 สืบทอดมา: encoder Qwen3-VL, VAE 64 channel, 2K แบบ native, คำสั่งยาวได้ถึง 1,000 token; รายงานทางเทคนิคเมื่อพฤษภาคม 2026 | ไม่เผยแพร่ |
| Qwen-Image 3.0 | 21 กรกฎาคม 2026 | เรือธงหลัง API ของ Alibaba: prompt ยาวได้ถึง 4,500 token เรนเดอร์อินโฟกราฟิกและสตอรีบอร์ดได้ในรอบเดียว | API เท่านั้น |
| Qwen-Image 2.1 | 20 กันยายน 2026 | Transformer แบบ single-stream 7 พันล้านพารามิเตอร์ พร้อม encoder Qwen3-VL 8B; สร้างและแก้ไขภาพใน checkpoint เดียว, RGBA, 2K | เปิด Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 ตุลาคม 2026 | 2.1 ที่ distill แล้ว 8 step | เปิด Qwen Research License |
ดังนั้นในหน้าดาวน์โหลด “Qwen-Image” ที่ไม่มีตัวเลขคือโมเดล 20 พันล้านของปี 2025 ซึ่งยังหาได้พร้อมอัปเดต 2512 และ Edit ส่วนโมเดลเปิดรุ่นปัจจุบันคือ 2.1 และ 3.0 คือโมเดลที่อยู่หลังบริการแบบเสียเงินของ Alibaba ทั้งนี้ 2.1 กับ 3.0 มีสายพันธุ์เดียวกันแต่ไม่ได้ใช้ weights ร่วมกัน
ใบอนุญาตของ Qwen-Image: open weights แต่วิจัยเท่านั้น
Qwen-Image รุ่นแรกและโมเดลแก้ไขภาพของมันเป็น Apache 2.0: ใช้ได้ฟรีทุกอย่าง รวมถึงเชิงพาณิชย์ Qwen-Image 2.1 และ Turbo ของมันอยู่ภายใต้ Qwen Research License Agreement ดาวน์โหลด weights ไปศึกษา รัน และ fine-tune ได้ แต่เพื่อการวิจัยและประเมินผลเท่านั้น การใช้เชิงพาณิชย์ใด ๆ ต้องขอใบอนุญาตแยกจาก Qwen
นั่นทำให้ 2.1 อยู่คนละตำแหน่งกับ Stable Diffusion ซึ่งใบอนุญาตของ 1.5 และ SDXL อนุญาตให้ใช้เชิงพาณิชย์ได้โดยมีรายการข้อห้าม และใบอนุญาตของ 3.5 อนุญาตเมื่อรายได้ต่อปีต่ำกว่าหนึ่งล้านดอลลาร์ และต่างจาก FLUX 3 Klein ที่ใช้เชิงพาณิชย์ได้ฟรีเมื่อต่ำกว่าห้าล้าน สำหรับนักศึกษาหรือห้องแล็บ ไม่มีอะไรเปลี่ยน สำหรับสตูดิโอ ทางที่ยังเปิดอยู่คือ API แบบเสียเงิน หรือใบอนุญาตเชิงพาณิชย์ที่ขอจาก Qwen
ลอง Qwen-Image และไปต่อ
วิธีที่เร็วที่สุดคือหน้า Qwen-Image 2.1 ฟรีของเว็บไซต์นี้: ไม่ต้องมีบัญชี สร้างและแก้ไขภาพด้วยภาพอ้างอิงได้ และเห็นคิวแบบสด
หากจะรันที่บ้าน ComfyUI รองรับโมเดลนี้โดยตรง ไฟล์สามไฟล์จากชุดที่ Comfy-Org แพ็กใหม่ใส่ในโฟลเดอร์ตามปกติ: diffusion model, text encoder Qwen3-VL และ VAE เป็นรุ่น int8 สำหรับการ์ด 16 GB คู่มือการตั้งค่าครอบคลุมกราฟ โครง prompt, guidance และขนาดที่วัดบนการ์ดใบนั้นจริง ๆ รวมถึง Turbo และ Turbo แบบมี guidance
สำหรับหลักการที่โมเดลเหล่านี้ใช้ร่วมกัน สัญญาณรบกวน, latent space, guidance และ seed อ่าน Stable Diffusion คืออะไร? คำอธิบายใช้ได้ทั้งหมด เปลี่ยนแค่ตัวเลข