Τι είναι το Qwen-Image, με λίγα λόγια
Το Qwen-Image είναι η γραμμή δημιουργίας εικόνων του Qwen, της οικογένειας μοντέλων του τμήματος cloud της Alibaba. Εμφανίστηκε τον Αύγουστο του 2025 ως μοντέλο 20 δισεκατομμυρίων παραμέτρων με άδεια Apache 2.0, συνοδευόμενο από τεχνική αναφορά. Ξεχώρισε για το κείμενό του. Παράγραφοι, πινακίδες και ετικέτες έβγαιναν ευανάγνωστες, στα αγγλικά και κυρίως στα κινεζικά, εκεί όπου το Stable Diffusion 1.5 και το SDXL έβγαζαν ορνιθοσκαλίσματα και τα μοντέλα του 2024 κατάφερναν στην καλύτερη περίπτωση λίγες αγγλικές λέξεις.
Η τρέχουσα ανοιχτή έκδοση είναι το Qwen-Image 2.1, που δημοσιεύτηκε στις 20 Σεπτεμβρίου 2026. Είναι μικρότερο και γρηγορότερο μοντέλο: 7 δισεκατομμύρια παράμετροι για τη γεννήτρια εικόνας, συν ένας κωδικοποιητής όρασης-γλώσσας 8 δισεκατομμυρίων παραμέτρων. Ένα checkpoint κάνει δύο δουλειές. Δημιουργεί εικόνα από κείμενο, και επεξεργάζεται μια υπάρχουσα εικόνα από μια πρόταση και έως δέκα εικόνες αναφοράς. Βγάζει εγγενές 2K και πραγματικά διαφανείς εικόνες. Η άδειά του δεν είναι πια Apache: μόνο έρευνα και αξιολόγηση.
Όπως το Stable Diffusion και το FLUX, είναι μοντέλο διάχυσης που τρέχει στο ComfyUI σε κάρτα γραφικών καταναλωτικής κατηγορίας, και διαβάζει το ίδιο είδος prompt. Εκεί που διαφέρει είναι στο εσωτερικό, και αυτό εξηγεί η ενότητα για το πώς λειτουργεί.
Τι μπορεί να κάνει το Qwen-Image 2.1
Text-to-image σε εγγενές 2K. Το μοντέλο αποδίδει απευθείας τετράγωνα 2048 × 2048, 2528 × 1696 σε 3:2 και 2752 × 1536 σε 16:9, χωρίς upscaler. Διαβάζει το prompt ως κείμενο, οπότε προτάσεις, προθέσεις και οδηγίες διάταξης δουλεύουν, και οι λέξεις σε εισαγωγικά εμφανίζονται όπως γράφτηκαν: το “a banner above the door reads ‘OPEN ALL NIGHT’” βγαίνει κατά λέξη στα δοκιμαστικά prompt του οδηγού ρυθμίσεων. Ο οδηγός ρυθμίσεων δίνει τη δομή prompt που δουλεύει καλύτερα και τις μετρημένες ρυθμίσεις.
Επεξεργασία με το ίδιο checkpoint. Δώστε του μια εικόνα και μια πρόταση, και αλλάζει την εικόνα: αντικαθιστά ένα αντικείμενο, αλλάζει το στυλ μιας σκηνής, προσθέτει κείμενο. Δώστε του έως δέκα εικόνες αναφοράς και τις συνθέτει, κρατώντας έναν χαρακτήρα ή ένα προϊόν συνεπή από λήψη σε λήψη. Περιοχές μπορούν να υποδειχθούν με μάσκα ή με έναν σχεδιασμένο κύκλο. Δεν χρειάζεται ξεχωριστό checkpoint inpainting για τοπικές αλλαγές: το ίδιο μοντέλο παίρνει την περιοχή ως υπόδειξη.
Διαφανής έξοδος. Ζητήστε εικόνα RGBA με διαφανές φόντο και το μοντέλο παράγει πραγματικό κανάλι άλφα, όχι αποκοπή: το VAE κωδικοποιεί και αποκωδικοποιεί τέσσερα κανάλια pixel αντί για τρία. Λογότυπα, αυτοκόλλητα και στοιχεία σε επίπεδα βγαίνουν έτοιμα για τοποθέτηση.
Επανεγγραφή του prompt. Η Qwen διαθέτει δύο συνοδευτικά μοντέλα, fine-tune του Qwen3.5-VL 9B, που αναπτύσσουν ένα σύντομο prompt στην αναλυτική μορφή που προτιμά η γεννήτρια, ένα για δημιουργία και ένα για επεξεργασία. Το ComfyUI τα προσφέρει ως επιλογή στα πρότυπά του, απενεργοποιημένη από προεπιλογή· δεν είναι απαραίτητα.
Ταχύτητα. Σε κάρτα καταναλωτικής κατηγορίας 16 GB, τα βάρη int8 χρειάζονται περίπου 40 δευτερόλεπτα για εικόνα 1 megapixel και τέσσερα έως πέντε λεπτά για 4 megapixel με τις ρυθμίσεις ποιότητας του οδηγού ρυθμίσεων. Ένα αποσταγμένο checkpoint Turbo, που κυκλοφόρησε στις 9 Οκτωβρίου 2026, αποδίδει σε 8 βήματα, περίπου επτά φορές πιο γρήγορα στα 4 megapixel, με κόστος το μέσο: σχέδια, κεντήματα και χαρτοκοπτική γλιστρούν προς τη φωτογραφία.
Qwen-Image vs Stable Diffusion: πώς λειτουργεί
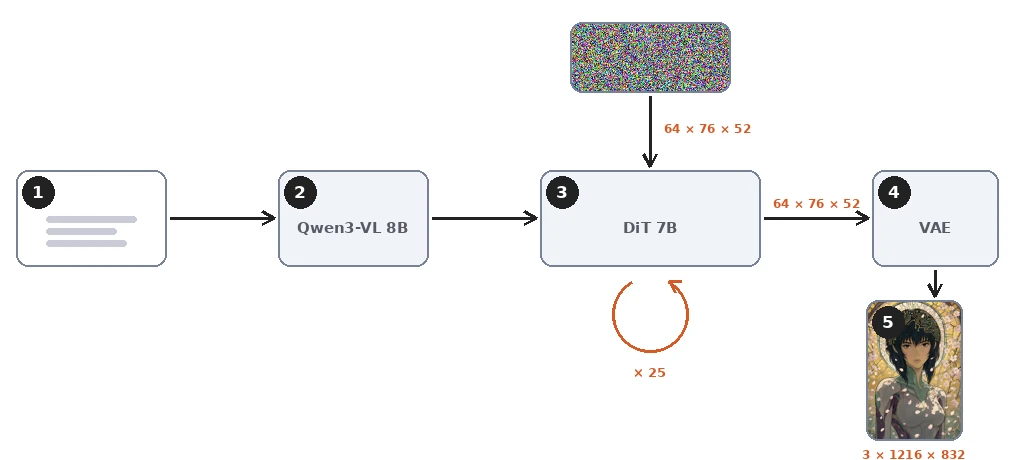
Το Qwen-Image 2.1 είναι μοντέλο διάχυσης, οπότε ισχύει η μηχανική που εξηγεί ο οδηγός του Stable Diffusion. Ένας κωδικοποιητής κειμένου διαβάζει το prompt. Ένας αποθορυβοποιητής δουλεύει πάνω σε ένα συμπιεσμένο latent για έναν αριθμό βημάτων. Ένας αποκωδικοποιητής μετατρέπει το latent σε pixel. Αυτό που διαφέρει είναι η επιλογή που έγινε για καθένα από τα τρία μέρη. Το αποθετήριο του μοντέλου δίνει τα παρακάτω στοιχεία· η Qwen δεν έχει δημοσιεύσει τεχνική αναφορά για το 2.1.
Μοντέλο όρασης-γλώσσας αντί για CLIP
Το Stable Diffusion 1.5 και το SDXL διαβάζουν το prompt με το CLIP, ένα δίκτυο εκπαιδευμένο να ταιριάζει σύντομες λεζάντες με εικόνες. Το Qwen-Image 2.1 το διαβάζει με το Qwen3-VL 8B, ένα πλήρες μοντέλο όρασης-γλώσσας οκτώ δισεκατομμυρίων παραμέτρων, περισσότερων από την ίδια τη γεννήτρια εικόνας. Ο ίδιος κωδικοποιητής διαβάζει τις εικόνες αναφοράς στην επεξεργασία. Γι’ αυτό δουλεύει η δομή prompt του οδηγού ρυθμίσεων. Προτάσεις, προθέσεις, κείμενο σε εισαγωγικά και οδηγίες διάταξης είναι ακριβώς αυτά που ένα γλωσσικό μοντέλο είναι φτιαγμένο να αναλύει. Ένας κωδικοποιητής CLIP τείνει να τα ισοπεδώνει σε ένα σακί εννοιών.
Transformer ενός ρεύματος αντί για U-Net
Ο αποθορυβοποιητής είναι ένας diffusion transformer 32 επιπέδων και 7 δισεκατομμυρίων παραμέτρων. Το SDXL χρησιμοποιεί U-Net, συνελικτικά μπλοκ με επίπεδα προσοχής ανάμεσά τους. Το Stable Diffusion 3 πέρασε κι αυτό σε transformer, το MMDiT, όπου τα token κειμένου και εικόνας ταξιδεύουν σε δύο ρεύματα με ξεχωριστά βάρη και συναντιούνται μόνο στην προσοχή κάθε επιπέδου. Το Qwen-Image 2.1 πάει ένα βήμα παραπέρα: τα token κειμένου και εικόνας σχηματίζουν μία ακολουθία και περνούν από τα ίδια βάρη, και αυτό σημαίνει το «single-stream», ενός ρεύματος. Το πρώτο Qwen-Image του 2025 ήταν ένα MMDiT δύο ρευμάτων 20 δισεκατομμυρίων παραμέτρων· το 2.1 είναι περίπου το ένα τρίτο αυτού του μεγέθους.
Δύο λεπτομέρειες της προσοχής του μετρούν στην πράξη. Τα token κειμένου διαβάζονται αιτιακά, όπως σε ένα γλωσσικό μοντέλο, και κάθε εικόνα, αναφοράς ή παραγόμενη, είναι ένα μπλοκ του οποίου τα token βλέπουν όλα το ένα το άλλο. Η σειρά είναι: πρώτα το prompt, μετά οι εικόνες αναφοράς, τελευταία η παραγόμενη εικόνα, και ένα token δεν κοιτάζει ποτέ ό,τι έρχεται μετά από αυτό. Έτσι το prompt και οι εικόνες αναφοράς δεν βλέπουν ποτέ την εικόνα που παράγεται, και το μέρος του υπολογισμού που τους ανήκει, το πρόθεμα, είναι πανομοιότυπο σε κάθε βήμα: υπολογίζεται μία φορά και κρατιέται σε προσωρινή μνήμη σε όλα τα βήματα αποθορυβοποίησης. Ο κόμβος QwenImage21Cache του ComfyUI επιλέγει μόνο πού βρίσκεται αυτή η προσωρινή μνήμη, σε ποια ακρίβεια, ή αν χρησιμοποιείται καθόλου.
Latent 64 καναλιών, συμπιεσμένο δεκαέξι φορές
Το VAE του Stable Diffusion συρρικνώνει μια εικόνα κατά οκτώ φορές σε κάθε πλευρά σε 4 κανάλια, 16 στην έκδοση 3. Το VAE του Qwen-Image 2.1 τη συρρικνώνει δεκαέξι φορές σε κάθε πλευρά, σε 64 κανάλια. Κωδικοποιεί και αποκωδικοποιεί επίσης τέσσερα κανάλια pixel, κόκκινο, πράσινο, μπλε και άλφα, αντί για τρία, και έτσι το μοντέλο βγάζει πραγματικές εικόνες RGBA από το ίδιο latent 64 καναλιών. Για εικόνα 832 × 1216 το latent μετρά 64 κανάλια των 52 × 76: περίπου 253 000 αριθμοί για 3 εκατομμύρια τιμές pixel, δώδεκα φορές λιγότεροι.
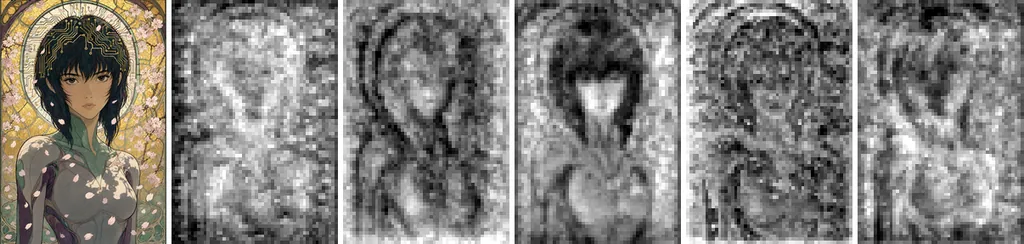
Κάθε θέση του latent είναι ένα token για τον transformer, οπότε μια εικόνα 1 megapixel είναι 3 952 token και μία 4 megapixel 15 808. Αυτό το πλέγμα δεν είναι πιο αδρό από εκείνο του Stable Diffusion 3 ή του πρώτου Qwen-Image, που ομαδοποιούν το latent τους συμπίεσης 8× σε τμήματα 2 × 2 πριν από τον transformer. Αυτό που αλλάζει το 2.1 είναι ότι την ομαδοποίηση την κάνει το ίδιο το VAE, σε 64 κανάλια. Το κόστος της προσοχής μεγαλώνει με το τετράγωνο του αριθμού των token, γι’ αυτό τα 4 megapixel κοστίζουν πολύ περισσότερο από τέσσερις φορές το 1 megapixel.
Flow matching αντί για πρόβλεψη θορύβου
Το Stable Diffusion 1.5 και το SDXL εκπαιδεύτηκαν να προβλέπουν τον θόρυβο που προστέθηκε σε μια εικόνα. Το Qwen-Image, όπως το Stable Diffusion 3 και το FLUX, εκπαιδεύεται με flow matching. Το δίκτυο προβλέπει την κατεύθυνση από το θορυβώδες latent προς το καθαρό, κατά μήκος μιας ευθείας. Ο δειγματολήπτης ακολουθεί έπειτα αυτή την κατεύθυνση με βήματα Euler. Το αποθετήριο κατονομάζει αυτόν τον scheduler: flow matching με διακριτά βήματα Euler και δυναμική μετατόπιση (shift). Η πρώτη αναφορά του Qwen-Image περιγράφει τον στόχο εκπαίδευσης, έναν στόχο ταχύτητας κατά μήκος ευθειών διαδρομών, που ο scheduler του 2.1 υπονοεί ότι δεν άλλαξε.
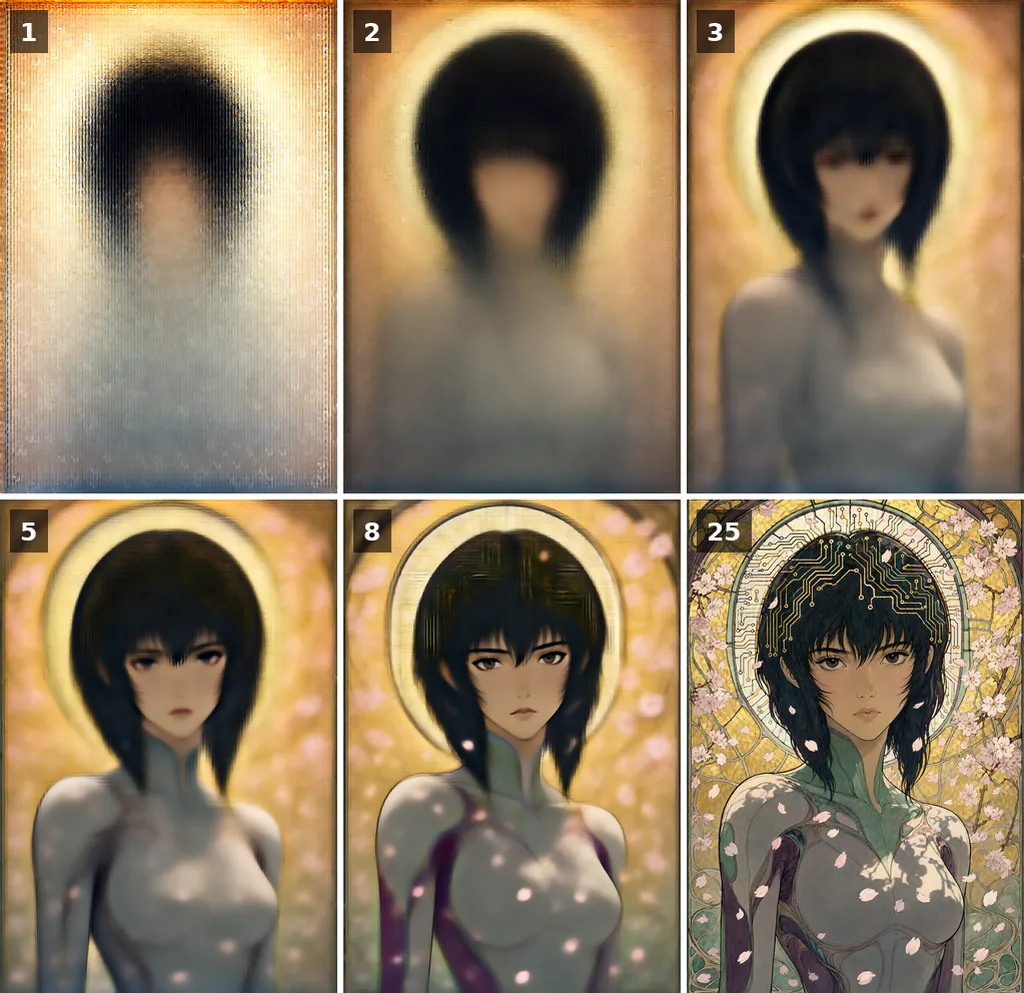
Το παρακάτω σχήμα δείχνει πώς μοιάζει στην πορεία η εκτίμηση του μοντέλου για την τελική εικόνα. Η σύνθεση κλειδώνει στα πρώτα βήματα και η λεπτομέρεια έρχεται αργότερα. Αυτή η σειρά, από το αδρό στο λεπτομερές, είναι κοινή σε όλα τα μοντέλα διάχυσης· το flow matching αλλάζει κυρίως το πώς κατανέμονται τα βήματα, που είναι αυτό που ρυθμίζει η δυναμική μετατόπιση.
Δίπλα δίπλα
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Κωδικοποιητής κειμένου | CLIP ViT-L και OpenCLIP bigG | Δύο κωδικοποιητές CLIP και T5-XXL | Qwen3-VL 8B, μοντέλο όρασης-γλώσσας |
| Αποθορυβοποιητής | U-Net, 2.6 δισεκατομμύρια παράμετροι | MMDiT δύο ρευμάτων, 8 δισεκατομμύρια | Diffusion transformer ενός ρεύματος, 7 δισεκατομμύρια, 32 επίπεδα |
| Latent | 4 κανάλια, συμπίεση 8× | 16 κανάλια, 8× | 64 κανάλια, 16×, με άλφα |
| Στόχος εκπαίδευσης | Πρόβλεψη θορύβου | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Εγγενές μέγεθος | 1024 px | 1024 px | 2048 px |
| Επεξεργασία | Μοντέλο inpainting τρίτων | Χωρίς επίσημο μοντέλο επεξεργασίας, μόνο ControlNet | Ίδιο checkpoint, έως 10 εικόνες αναφοράς |
| Άδεια | OpenRAIL++-M | Community License | Qwen Research License |
Τίποτα από αυτά δεν αλλάζει τον τρόπο που οδηγείται το μοντέλο. Καθοδήγηση, βήματα, seed και μέγεθος συμπεριφέρονται όπως σε κάθε μοντέλο διάχυσης· μόνο οι αριθμοί που δουλεύουν καλύτερα διαφέρουν, και ο οδηγός ρυθμίσεων τους μετρά.
Οι εκδόσεις, από το Qwen-Image έως το 2.1
Η αρίθμηση μπερδεύει, επειδή ακολουθεί την αρχιτεκτονική και όχι το κανάλι κυκλοφορίας. Το Qwen-Image 2.0, που ανακοινώθηκε τον Φεβρουάριο του 2026 και δεν κυκλοφόρησε ποτέ ως βάρη, εισήγαγε τον ελαφρύτερο σχεδιασμό που το 2.1 διαθέτει τώρα ανοιχτά. Το Qwen-Image 3.0, που ανακοινώθηκε τον Ιούλιο του 2026, είναι μια μεγαλύτερη ναυαρχίδα που προσφέρεται μόνο μέσω του API της Alibaba. Η Qwen δεν έχει εξηγήσει το σχήμα· οι παρακάτω ημερομηνίες προέρχονται από τα αποθετήρια του έργου και, για το 3.0, από την ανακοίνωση της Qwen.
| Έκδοση | Ημερομηνία | Τι είναι | Βάρη |
|---|---|---|---|
| Qwen-Image | 4 Αυγούστου 2025 | MMDiT δύο ρευμάτων 20 δισεκατομμυρίων παραμέτρων με κωδικοποιητή Qwen2.5-VL 7B· text-to-image | Ανοιχτά, Apache 2.0 |
| Qwen-Image-Edit, μετά Edit-2509 και Edit-2511 | Αύγουστος έως Δεκέμβριος 2025 | Μοντέλα επεξεργασίας στην ίδια βάση· πολλαπλές εικόνες αναφοράς από το 2509· ένα μοντέλο RGBA σε επίπεδα, το Qwen-Image-Layered, τον Δεκέμβριο | Ανοιχτά, Apache 2.0 |
| Qwen-Image-2512 | 31 Δεκεμβρίου 2025 | Τελευταία έκδοση text-to-image της γραμμής των 20 δισεκατομμυρίων | Ανοιχτά, Apache 2.0 |
| Qwen-Image 2.0 | 10 Φεβρουαρίου 2026 | Ο σχεδιασμός που κληρονομεί το 2.1: κωδικοποιητής Qwen3-VL, VAE 64 καναλιών, εγγενές 2K, οδηγίες έως 1 000 token· τεχνική αναφορά τον Μάιο του 2026 | Δεν δημοσιεύτηκαν |
| Qwen-Image 3.0 | 21 Ιουλίου 2026 | Ναυαρχίδα πίσω από το API της Alibaba: prompt έως 4 500 token, infographics και storyboard που αποδίδονται σε ένα πέρασμα | Μόνο API |
| Qwen-Image 2.1 | 20 Σεπτεμβρίου 2026 | Transformer ενός ρεύματος 7 δισεκατομμυρίων παραμέτρων με κωδικοποιητή Qwen3-VL 8B· δημιουργία και επεξεργασία σε ένα checkpoint, RGBA, 2K | Ανοιχτά, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 Οκτωβρίου 2026 | Αποσταγμένο 2.1, 8 βήματα | Ανοιχτά, Qwen Research License |
Έτσι, σε μια σελίδα λήψης, το «Qwen-Image» χωρίς αριθμό είναι το μοντέλο των 20 δισεκατομμυρίων του 2025, ακόμη διαθέσιμο με τις ενημερώσεις 2512 και Edit. Το τρέχον ανοιχτό μοντέλο είναι το 2.1, και το 3.0 είναι το μοντέλο πίσω από την επί πληρωμή υπηρεσία της Alibaba. Το 2.1 και το 3.0 μοιράζονται καταγωγή, αλλά όχι τα βάρη τους.
Η άδεια του Qwen-Image: ανοιχτά βάρη, μόνο για έρευνα
Το πρώτο Qwen-Image και τα μοντέλα επεξεργασίας του ήταν Apache 2.0: ελεύθερα για οτιδήποτε, μαζί και για εμπορική χρήση. Το Qwen-Image 2.1 και το Turbo του διατίθενται με την Qwen Research License Agreement. Τα βάρη μπορούν να κατέβουν, να μελετηθούν, να τρέξουν και να γίνουν fine-tune, αλλά μόνο για έρευνα και αξιολόγηση. Κάθε εμπορική χρήση χρειάζεται ξεχωριστή άδεια από την Qwen.
Αυτό τοποθετεί το 2.1 σε διαφορετική θέση από το Stable Diffusion, του οποίου οι άδειες 1.5 και SDXL επιτρέπουν εμπορική χρήση με μια λίστα απαγορευμένων χρήσεων και του οποίου η άδεια 3.5 την επιτρέπει κάτω από ένα εκατομμύριο δολάρια ετήσιων εσόδων, και από το FLUX 3 Klein, δωρεάν για εμπορική χρήση κάτω από πέντε εκατομμύρια. Για έναν φοιτητή ή ένα εργαστήριο, τίποτα δεν αλλάζει. Για ένα στούντιο, το επί πληρωμή API ή μια εμπορική άδεια που ζητείται από την Qwen είναι οι δρόμοι που μένουν ανοιχτοί.
Δοκιμή του Qwen-Image και πώς να προχωρήσετε
Ο γρηγορότερος τρόπος είναι η δωρεάν σελίδα Qwen-Image 2.1 αυτού του ιστότοπου: χωρίς λογαριασμό, δημιουργία και επεξεργασία με εικόνες αναφοράς, με την ουρά να φαίνεται ζωντανά.
Για να το τρέξετε στο σπίτι, το ComfyUI υποστηρίζει το μοντέλο εγγενώς. Τρία αρχεία από την ανασυσκευασία της Comfy-Org πάνε στους συνηθισμένους φακέλους: το μοντέλο διάχυσης, ο κωδικοποιητής κειμένου Qwen3-VL και το VAE, σε εκδόσεις int8 για κάρτα 16 GB. Ο οδηγός ρυθμίσεων καλύπτει το γράφημα, τη δομή του prompt, την καθοδήγηση και τα μεγέθη που μετρήθηκαν ακριβώς σε αυτή την κάρτα, συν το Turbo και το καθοδηγούμενο Turbo.
Για τις αρχές που μοιράζονται όλα αυτά τα μοντέλα, θόρυβο, λανθάνοντα χώρο, καθοδήγηση και seed, διαβάστε το Τι είναι το Stable Diffusion;· οι εξηγήσεις μεταφέρονται αυτούσιες, μόνο οι αριθμοί αλλάζουν.