Qu’est-ce que Qwen-Image, en bref
Qwen-Image est la gamme de génération d’images de Qwen, la famille de modèles de la division cloud d’Alibaba. Elle est arrivée en août 2025 sous la forme d’un modèle de 20 milliards de paramètres sous licence Apache 2.0, accompagné d’un rapport technique. Ce qui l’a distinguée, c’est le texte. Les paragraphes, les enseignes et les étiquettes sortaient lisibles, en anglais et surtout en chinois, là où Stable Diffusion 1.5 et SDXL produisaient des gribouillis et où les modèles de 2024 alignaient au mieux quelques mots d’anglais.
La version ouverte actuelle est Qwen-Image 2.1, publiée le 20 septembre 2026. C’est un modèle plus petit et plus rapide : 7 milliards de paramètres pour le générateur d’images, plus un encodeur vision-langage de 8 milliards. Un seul checkpoint fait deux choses. Il génère une image à partir d’un texte, et il modifie une image existante à partir d’une phrase et de dix images de référence au maximum. Il sort du 2K natif et de vraies images transparentes. Sa licence n’est plus Apache : recherche et évaluation seulement.
Comme Stable Diffusion et FLUX, c’est un modèle de diffusion qui tourne dans ComfyUI sur une carte graphique grand public, et il lit le même genre de prompt. La différence est à l’intérieur, et c’est ce qu’explique la section sur son fonctionnement.
Ce que sait faire Qwen-Image 2.1
Texte vers image en 2K natif. Le modèle rend directement des carrés de 2048 × 2048, du 2528 × 1696 en 3:2 et du 2752 × 1536 en 16:9, sans agrandissement. Il lit le prompt comme un texte : les phrases, les prépositions et les consignes de mise en page fonctionnent, et les mots entre guillemets apparaissent tels quels. « a banner above the door reads ‘OPEN ALL NIGHT’ » sort écrit à la lettre sur les prompts de test du guide des réglages. Le guide des réglages donne la structure de prompt qui marche le mieux et les réglages mesurés.
La retouche avec le même checkpoint. Donnez-lui une image et une phrase, et il modifie l’image : remplacer un objet, changer le style d’une scène, ajouter du texte. Donnez-lui jusqu’à dix images de référence et il les compose, en gardant un personnage ou un produit cohérent d’un plan à l’autre. Une zone peut être désignée par un masque ou un cercle tracé à la main. Aucun checkpoint d’inpainting séparé n’est nécessaire pour les retouches locales : le même modèle prend la zone comme indication.
Sortie transparente. Demandez une image RGBA à fond transparent et le modèle produit un vrai canal alpha, pas un détourage : le VAE encode et décode quatre canaux de pixels au lieu de trois. Logos, stickers et éléments à superposer sortent prêts à placer.
Réécriture du prompt. Qwen livre deux modèles compagnons, des fine-tunes de Qwen3.5-VL 9B, qui développent un prompt court dans la forme détaillée que préfère le générateur, l’un pour la génération, l’autre pour la retouche. ComfyUI les propose en option dans ses templates, désactivés par défaut ; ils ne sont pas indispensables.
Vitesse. Sur une carte grand public de 16 Go, les poids int8 prennent environ 40 secondes pour une image de 1 mégapixel et quatre à cinq minutes pour 4 mégapixels, avec les réglages de qualité du guide des réglages. Un checkpoint distillé, Turbo, sorti le 9 octobre 2026, rend en 8 étapes, environ sept fois plus vite à 4 mégapixels, au prix du médium : dessins, broderies et papier découpé glissent vers la photographie.
Qwen-Image vs Stable Diffusion : comment ça marche
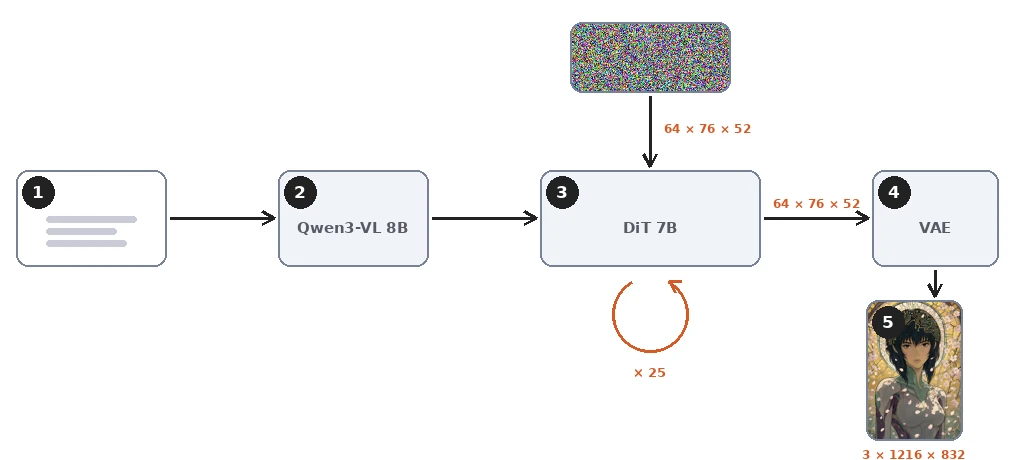
Qwen-Image 2.1 est un modèle de diffusion, donc la mécanique expliquée dans le guide Stable Diffusion s’applique. Un encodeur de texte lit le prompt. Un débruiteur travaille sur un latent compressé pendant un certain nombre d’étapes. Un décodeur transforme le latent en pixels. Ce qui change, c’est le choix fait pour chacune des trois parties. Le dépôt du modèle donne les faits ci-dessous ; Qwen n’a pas publié de rapport technique pour la 2.1.
Un modèle vision-langage à la place de CLIP
Stable Diffusion 1.5 et SDXL lisent le prompt avec CLIP, un réseau entraîné à faire correspondre de courtes légendes à des images. Qwen-Image 2.1 le lit avec Qwen3-VL 8B, un modèle vision-langage complet de huit milliards de paramètres, plus que le générateur d’images lui-même. Le même encodeur lit les images de référence en retouche. C’est pour cela que la structure de prompt du guide des réglages fonctionne. Les phrases, les prépositions, le texte entre guillemets et les consignes de mise en page sont exactement ce qu’un modèle de langage est fait pour analyser. Un encodeur CLIP a tendance à les aplatir en un sac de concepts.
Un transformeur à flux unique à la place d’un U-Net
Le débruiteur est un transformeur de diffusion de 32 couches et 7 milliards de paramètres. SDXL utilise un U-Net, des blocs de convolution avec des couches d’attention entre eux. Stable Diffusion 3 est aussi passé au transformeur, le MMDiT, où les tokens de texte et d’image circulent dans deux flux aux poids séparés et ne se rencontrent que dans l’attention de chaque couche. Qwen-Image 2.1 va un cran plus loin : les tokens de texte et d’image forment une seule séquence et traversent les mêmes poids, c’est le sens de « flux unique » (single-stream). Le premier Qwen-Image de 2025 était un MMDiT à double flux de 20 milliards de paramètres ; la 2.1 fait environ un tiers de cette taille.
Deux détails de son attention comptent en pratique. Les tokens de texte sont lus de façon causale, comme dans un modèle de langage, et chaque image, de référence ou générée, forme un bloc dont tous les tokens se voient entre eux. L’ordre est le prompt d’abord, les images de référence ensuite, l’image générée en dernier, et un token ne regarde jamais ce qui vient après lui. Le prompt et les images de référence ne voient donc jamais l’image en cours de génération, et la part du calcul qui leur revient, le préfixe, est identique à chaque étape : elle est calculée une fois et mise en cache pour toutes les étapes de débruitage. Le nœud QwenImage21Cache de ComfyUI choisit seulement où vit ce cache, dans quelle précision, ou s’il est utilisé.
Un latent à 64 canaux, compressé seize fois
Le VAE de Stable Diffusion réduit une image d’un facteur huit de chaque côté, en 4 canaux, 16 dans la version 3. Le VAE de Qwen-Image 2.1 la réduit d’un facteur seize de chaque côté, en 64 canaux. Il encode et décode aussi quatre canaux de pixels, rouge, vert, bleu et alpha, au lieu de trois : c’est ainsi que le modèle sort de vraies images RGBA depuis le même latent à 64 canaux. Pour une image de 832 × 1216, le latent mesure 64 canaux de 52 × 76 : environ 253 000 nombres pour 3 millions de valeurs de pixels, douze fois moins.
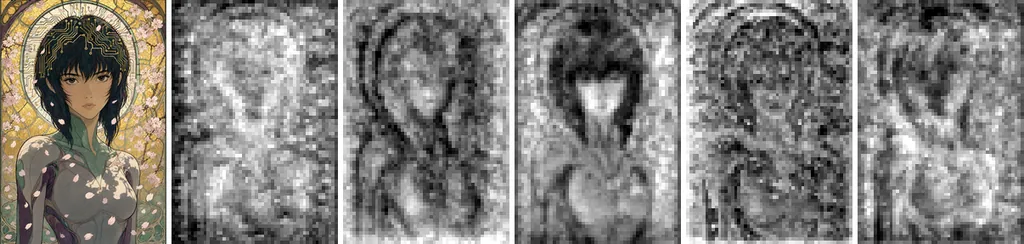
Chaque position du latent est un token pour le transformeur : une image de 1 mégapixel fait donc 3 952 tokens, et une image de 4 mégapixels 15 808. Cette grille n’est pas plus grossière que celle de Stable Diffusion 3 ou du premier Qwen-Image, qui regroupent leur latent compressé 8 fois en blocs de 2 × 2 avant le transformeur. Ce que change la 2.1, c’est que le VAE fait lui-même ce regroupement, en 64 canaux. Le coût de l’attention croît avec le carré du nombre de tokens, c’est pourquoi 4 mégapixels coûtent bien plus que quatre fois 1 mégapixel.
Le flow matching à la place de la prédiction du bruit
Stable Diffusion 1.5 et SDXL ont été entraînés à prédire le bruit ajouté à une image. Qwen-Image, comme Stable Diffusion 3 et FLUX, est entraîné par flow matching. Le réseau prédit la direction qui mène du latent bruité au latent propre, en ligne droite. Le sampler suit ensuite cette direction par étapes d’Euler. Le dépôt nomme ce scheduler : flow matching avec étapes d’Euler discrètes et décalage (shift) dynamique. Le rapport du premier Qwen-Image décrit l’objectif, une cible de vitesse le long de trajectoires rectilignes, que le scheduler de la 2.1 laisse supposer inchangé.
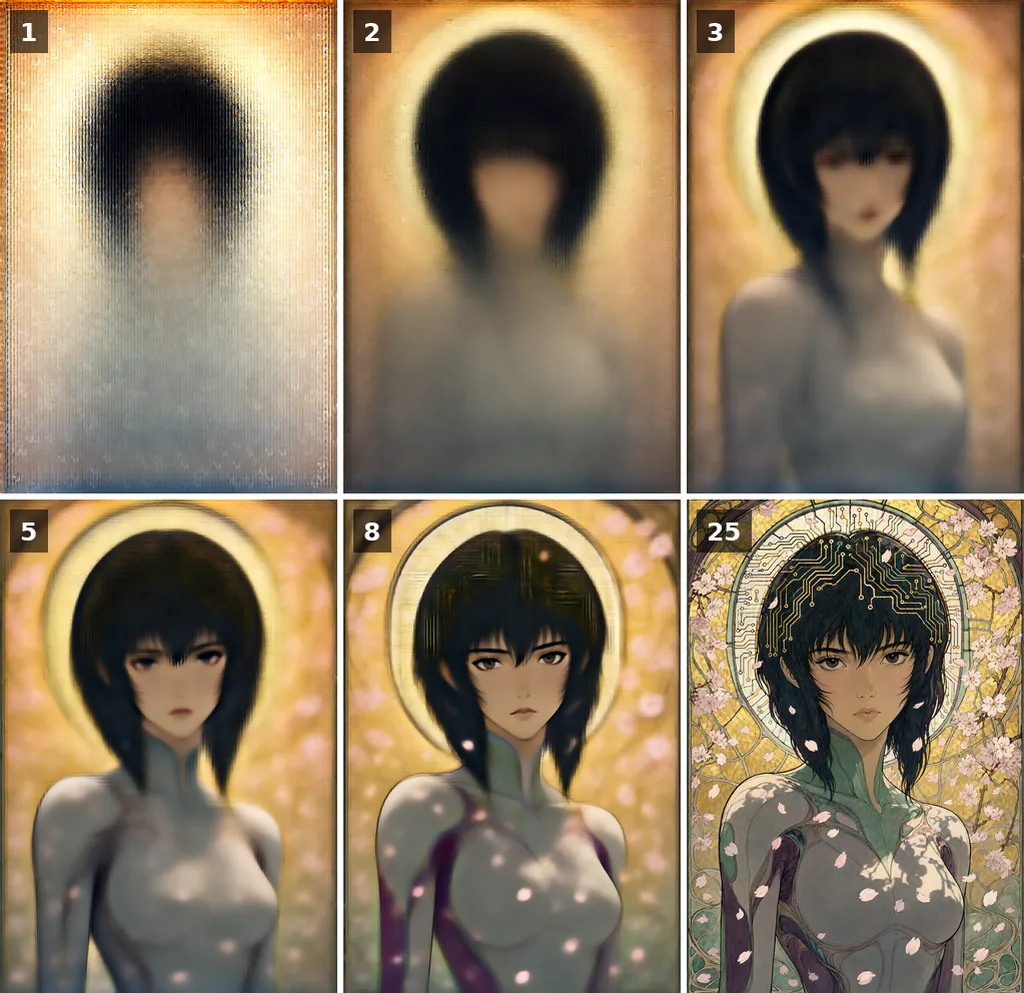
La figure ci-dessous montre à quoi ressemble, en cours de route, l’estimation que le modèle fait de l’image finale. La composition est fixée dès les premières étapes et le détail arrive ensuite. Cet ordre, du grossier au fin, est commun à tous les modèles de diffusion ; le flow matching change surtout l’espacement des étapes, et c’est ce que règle le décalage dynamique.
Côte à côte
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Encodeur de texte | CLIP ViT-L et OpenCLIP bigG | Deux encodeurs CLIP et T5-XXL | Qwen3-VL 8B, un modèle vision-langage |
| Débruiteur | U-Net, 2,6 milliards de paramètres | MMDiT à double flux, 8 milliards | Transformeur de diffusion à flux unique, 7 milliards, 32 couches |
| Latent | 4 canaux, compression 8× | 16 canaux, 8× | 64 canaux, 16×, avec alpha |
| Objectif d’entraînement | Prédiction du bruit | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Taille native | 1024 px | 1024 px | 2048 px |
| Retouche | Modèle d’inpainting tiers | Pas de modèle de retouche officiel, ControlNets seulement | Même checkpoint, jusqu’à 10 images de référence |
| Licence | OpenRAIL++-M | Community License | Qwen Research License |
Rien de tout cela ne change la façon de piloter le modèle. Guidance, étapes, seed et taille se comportent comme dans n’importe quel modèle de diffusion ; seuls les nombres qui marchent le mieux diffèrent, et le guide des réglages les mesure.
Les versions, de Qwen-Image à la 2.1
La numérotation est déroutante parce qu’elle suit l’architecture, pas le canal de distribution. Qwen-Image 2.0, annoncé en février 2026 et jamais publié sous forme de poids, a introduit la conception plus légère que la 2.1 livre aujourd’hui ouvertement. Qwen-Image 3.0, annoncé en juillet 2026, est un modèle phare plus gros, servi uniquement par l’API d’Alibaba. Qwen n’a pas expliqué ce schéma ; les dates ci-dessous viennent des dépôts du projet et, pour la 3.0, de l’annonce de Qwen.
| Version | Date | Ce que c’est | Poids |
|---|---|---|---|
| Qwen-Image | 4 août 2025 | MMDiT à double flux de 20 milliards de paramètres avec un encodeur Qwen2.5-VL 7B ; texte vers image | Ouverts, Apache 2.0 |
| Qwen-Image-Edit, puis Edit-2509 et Edit-2511 | Août à décembre 2025 | Modèles de retouche sur la même base ; plusieurs images de référence à partir de 2509 ; un modèle RGBA par calques, Qwen-Image-Layered, en décembre | Ouverts, Apache 2.0 |
| Qwen-Image-2512 | 31 décembre 2025 | Dernière version texte vers image de la lignée à 20 milliards | Ouverts, Apache 2.0 |
| Qwen-Image 2.0 | 10 février 2026 | La conception dont hérite la 2.1 : encodeur Qwen3-VL, VAE à 64 canaux, 2K natif, consignes jusqu’à 1 000 tokens ; rapport technique en mai 2026 | Non publiés |
| Qwen-Image 3.0 | 21 juillet 2026 | Modèle phare derrière l’API d’Alibaba : prompts jusqu’à 4 500 tokens, infographies et storyboards rendus en une passe | API seulement |
| Qwen-Image 2.1 | 20 septembre 2026 | Transformeur à flux unique de 7 milliards de paramètres avec un encodeur Qwen3-VL 8B ; génération et retouche dans un seul checkpoint, RGBA, 2K | Ouverts, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 octobre 2026 | 2.1 distillée, 8 étapes | Ouverts, Qwen Research License |
Sur une page de téléchargement, « Qwen-Image » sans numéro désigne donc le modèle de 20 milliards de 2025, toujours disponible avec ses mises à jour 2512 et Edit. Le modèle ouvert actuel est la 2.1, et la 3.0 est le modèle derrière le service payant d’Alibaba. 2.1 et 3.0 partagent une lignée, pas leurs poids.
La licence de Qwen-Image : poids ouverts, recherche seulement
Le premier Qwen-Image et ses modèles de retouche étaient sous Apache 2.0 : libres pour tout, usage commercial compris. Qwen-Image 2.1 et son Turbo sont sous la Qwen Research License Agreement. Les poids peuvent être téléchargés, étudiés, exécutés et fine-tunés, mais pour la recherche et l’évaluation seulement. Tout usage commercial exige une licence séparée auprès de Qwen.
Cela place la 2.1 ailleurs que Stable Diffusion, dont les licences 1.5 et SDXL autorisent l’usage commercial avec une liste d’usages interdits et dont la licence 3.5 l’autorise en dessous d’un million de dollars de chiffre d’affaires annuel, et que FLUX 3 Klein, libre pour un usage commercial en dessous de cinq millions. Pour un étudiant ou un laboratoire, rien ne change. Pour un studio, l’API payante ou une licence commerciale demandée à Qwen sont les voies qui restent ouvertes.
Essayer Qwen-Image et aller plus loin
Le plus rapide est la page Qwen-Image 2.1 gratuite de ce site : sans compte, génération et retouche avec images de référence, la file d’attente affichée en direct.
Pour le faire tourner chez vous, ComfyUI prend le modèle en charge nativement. Trois fichiers réempaquetés par Comfy-Org vont dans les dossiers habituels : le modèle de diffusion, l’encodeur de texte Qwen3-VL et le VAE, en versions int8 pour une carte de 16 Go. Le guide des réglages couvre le graphe, la structure du prompt, la guidance et les tailles mesurées sur exactement cette carte, plus le Turbo et le Turbo guidé.
Pour les principes communs à tous ces modèles, bruit, espace latent, guidance et seed, lisez Qu’est-ce que Stable Diffusion ? ; les explications se transposent, seuls les nombres changent.