Kısaca Qwen-Image nedir?
Qwen-Image, Alibaba’nın bulut biriminin model ailesi Qwen’in görsel üretim koludur. Ağustos 2025’te 20 milyar parametreli bir model olarak, Apache 2.0 lisansıyla ve bir teknik raporla geldi. Yazıyla öne çıktı. Paragraflar, tabelalar ve etiketler okunaklı çıkıyordu; İngilizcede ve özellikle Çincede. Oysa Stable Diffusion 1.5 ile SDXL orada karalama üretiyor, 2024’ün modelleri en iyi ihtimalle birkaç İngilizce kelimeyi tutturuyordu.
Güncel açık sürüm, 20 Eylül 2026’da yayımlanan Qwen-Image 2.1. Daha küçük ve daha hızlı bir model: görsel üretici için 7 milyar parametre, artı 8 milyar parametreli bir görsel-dil kodlayıcı. Tek checkpoint iki iş yapar. Metinden görsel üretir ve mevcut bir görseli bir cümle ile en fazla on referans görselden yola çıkarak düzenler. Doğal 2K ve gerçek şeffaf görseller verir. Lisansı artık Apache değil: yalnızca araştırma ve değerlendirme.
Stable Diffusion ve FLUX gibi o da ComfyUI’da, tüketici sınıfı bir ekran kartında çalışan bir difüzyon modelidir ve aynı türden promptları okur. Fark içeride; nasıl çalıştığını anlatan bölüm de bunu açıklıyor.
Qwen-Image 2.1 neler yapabilir?
Doğal 2K’da metinden görsel. Model 2048 × 2048 kareleri, 3:2 için 2528 × 1696’yı ve 16:9 için 2752 × 1536’yı doğrudan, upscaler olmadan üretir. Promptu bir metin olarak okur; dolayısıyla cümleler, edatlar ve yerleşim talimatları işe yarar, tırnak içindeki kelimeler de yazıldığı gibi görünür: “a banner above the door reads ‘OPEN ALL NIGHT’” ayarlar rehberinin test promptlarında birebir çıkar. Ayarlar rehberi en iyi çalışan prompt yapısını ve ölçülen ayarları verir.
Aynı checkpoint ile düzenleme. Ona bir görsel ve bir cümle verin, görseli değiştirir: bir nesneyi değiştirir, bir sahnenin stilini yeniler, yazı ekler. En fazla on referans görsel verin, bunları birleştirir; bir karakteri ya da ürünü kareler arasında tutarlı tutar. Bölgeler bir maskeyle ya da elle çizilmiş bir daireyle gösterilebilir. Yerel düzenlemeler için ayrı bir inpainting checkpoint’i gerekmez: aynı model bölgeyi ipucu olarak alır.
Şeffaf çıktı. Şeffaf arka planlı bir RGBA görsel isteyin, model kesip çıkarılmış değil gerçek bir alfa kanalı üretir: VAE üç yerine dört piksel kanalını kodlar ve çözer. Logolar, çıkartmalar ve katmanlı öğeler yerleştirmeye hazır çıkar.
Prompt yeniden yazma. Qwen, kısa bir promptu üreticinin tercih ettiği ayrıntılı biçime genişleten iki yardımcı model sunar; bunlar Qwen3.5-VL 9B ince ayarlarıdır, biri üretim, biri düzenleme için. ComfyUI bunları şablonlarında varsayılan olarak kapalı bir seçenek olarak sunar; zorunlu değillerdir.
Hız. 16 GB’lık tüketici sınıfı bir kartta int8 ağırlıklar, ayarlar rehberinin kalite ayarlarıyla 1 megapiksellik bir görsel için yaklaşık 40 saniye, 4 megapiksel için dört ila beş dakika sürer. 9 Ekim 2026’da yayımlanan damıtılmış Turbo checkpoint’i 8 adımda üretir; 4 megapikselde yaklaşık yedi kat daha hızlıdır, bedeli ise teknik: çizimler, nakış ve kağıt kesme fotoğrafa doğru kayar.
Qwen-Image vs Stable Diffusion: nasıl çalışır?
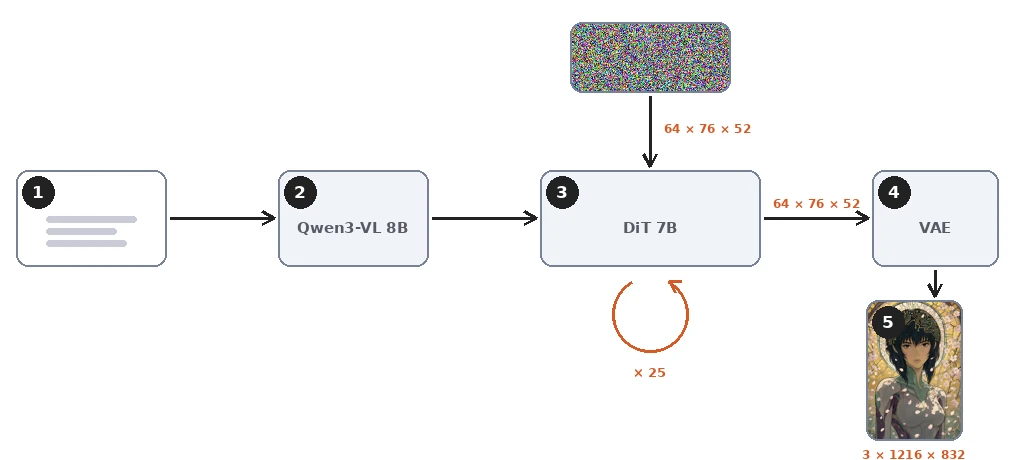
Qwen-Image 2.1 bir difüzyon modelidir; dolayısıyla Stable Diffusion rehberinde anlatılan mekanik burada da geçerlidir. Bir metin kodlayıcı promptu okur. Bir gürültü giderici, sıkıştırılmış bir latent üzerinde belirli sayıda adım boyunca çalışır. Bir kod çözücü latent’i piksellere çevirir. Farklı olan, bu üç parçanın her biri için yapılan seçimdir. Aşağıdaki bilgiler modelin deposundan geliyor; Qwen 2.1 için teknik rapor yayımlamadı.
CLIP yerine bir görsel-dil modeli
Stable Diffusion 1.5 ve SDXL promptu CLIP ile okur; CLIP, kısa açıklama metinlerini görsellerle eşleştirmek için eğitilmiş bir ağdır. Qwen-Image 2.1 ise Qwen3-VL 8B ile okur: sekiz milyar parametreli, görsel üreticinin kendisinden daha büyük, tam teşekküllü bir görsel-dil modeli. Düzenlemede referans görselleri de aynı kodlayıcı okur. Ayarlar rehberinin prompt yapısı bu yüzden işe yarar. Cümleler, edatlar, tırnak içindeki yazı ve yerleşim talimatları tam da bir dil modelinin çözümlemek için yapıldığı şeylerdir. Bir CLIP kodlayıcı bunları bir kavram yığınına indirgeme eğilimindedir.
U-Net yerine tek akışlı bir transformer
Gürültü giderici, 32 katmanlı ve 7 milyar parametreli bir diffusion transformer. SDXL bir U-Net kullanır: aralarında dikkat katmanları bulunan evrişim blokları. Stable Diffusion 3 de bir transformer’a, MMDiT’ye geçti; orada metin ve görsel token’ları ayrı ağırlıklarla iki akışta ilerler ve yalnızca her katmanın dikkat kısmında buluşur. Qwen-Image 2.1 bir adım daha ileri gider: metin ve görsel token’ları tek bir dizi oluşturur ve aynı ağırlıklardan geçer; “tek akışlı” tam da bu demektir. 2025’in ilk Qwen-Image’ı 20 milyar parametreli çift akışlı bir MMDiT idi; 2.1 bunun yaklaşık üçte biri boyutunda.
Dikkat mekanizmasının iki ayrıntısı pratikte önemlidir. Metin token’ları bir dil modelindeki gibi nedensel okunur; referans ya da üretilen her görsel, tüm token’ları birbirini gören tek bir bloktur. Sıra şöyle: önce prompt, sonra referans görseller, en sonda üretilen görsel; hiçbir token kendinden sonra gelene bakmaz. Böylece prompt ve referans görseller üretilmekte olan görseli hiç görmez; hesaplamanın onlara ait kısmı, yani önek, her adımda aynıdır: bir kez hesaplanır ve gürültü giderme adımları boyunca önbellekte tutulur. ComfyUI’daki QwenImage21Cache düğümü yalnızca bu önbelleğin nerede, hangi hassasiyette tutulacağını ya da hiç kullanılıp kullanılmayacağını seçer.
On altı kat sıkıştırılmış, 64 kanallı bir latent
Stable Diffusion’ın VAE’si görseli her kenarda sekiz kat küçülterek 4 kanala indirir; 3. sürümde 16 kanala. Qwen-Image 2.1’in VAE’si ise her kenarda on altı kat küçülterek 64 kanala indirir. Ayrıca üç yerine dört piksel kanalını, kırmızı, yeşil, mavi ve alfayı kodlar ve çözer; modelin aynı 64 kanallı latent’ten gerçek RGBA görseller vermesi bu sayededir. 832 × 1216’lık bir görsel için latent 52 × 76’lık 64 kanaldır: 3 milyon piksel değeri için yaklaşık 253.000 sayı, on iki kat daha az.
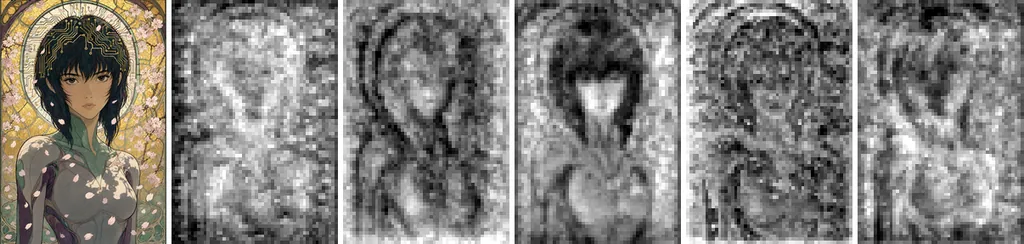
Her latent konumu transformer için bir token’dır; dolayısıyla 1 megapiksellik bir görsel 3.952 token, 4 megapiksellik bir görsel 15.808 token’dır. Bu ızgara Stable Diffusion 3’ünkinden ya da ilk Qwen-Image’ınkinden daha kaba değildir; onlar 8 kat sıkıştırılmış latent’lerini transformer’dan önce 2 × 2’lik yamalar halinde gruplar. 2.1’in değiştirdiği şey, bu gruplamayı VAE’nin kendisinin 64 kanalda yapmasıdır. Dikkatin maliyeti token sayısının karesiyle büyür; 4 megapikselin 1 megapikselin dört katından çok daha pahalı olması bundandır.
Gürültü tahmini yerine flow matching
Stable Diffusion 1.5 ve SDXL, görsele eklenen gürültüyü tahmin etmek için eğitildi. Qwen-Image ise Stable Diffusion 3 ve FLUX gibi flow matching (akış eşleme) ile eğitilir. Ağ, gürültülü latent’ten temiz olana giden yönü düz bir çizgi boyunca tahmin eder. Örnekleyici de bu yönü Euler adımlarıyla izler. Depo bu zamanlayıcıyı adıyla anar: ayrık Euler adımları ve dinamik shift ile flow matching. İlk Qwen-Image raporu hedefi, düz yollar boyunca bir hız hedefi olarak tanımlar; 2.1’in zamanlayıcısı bunun değişmediğine işaret eder.
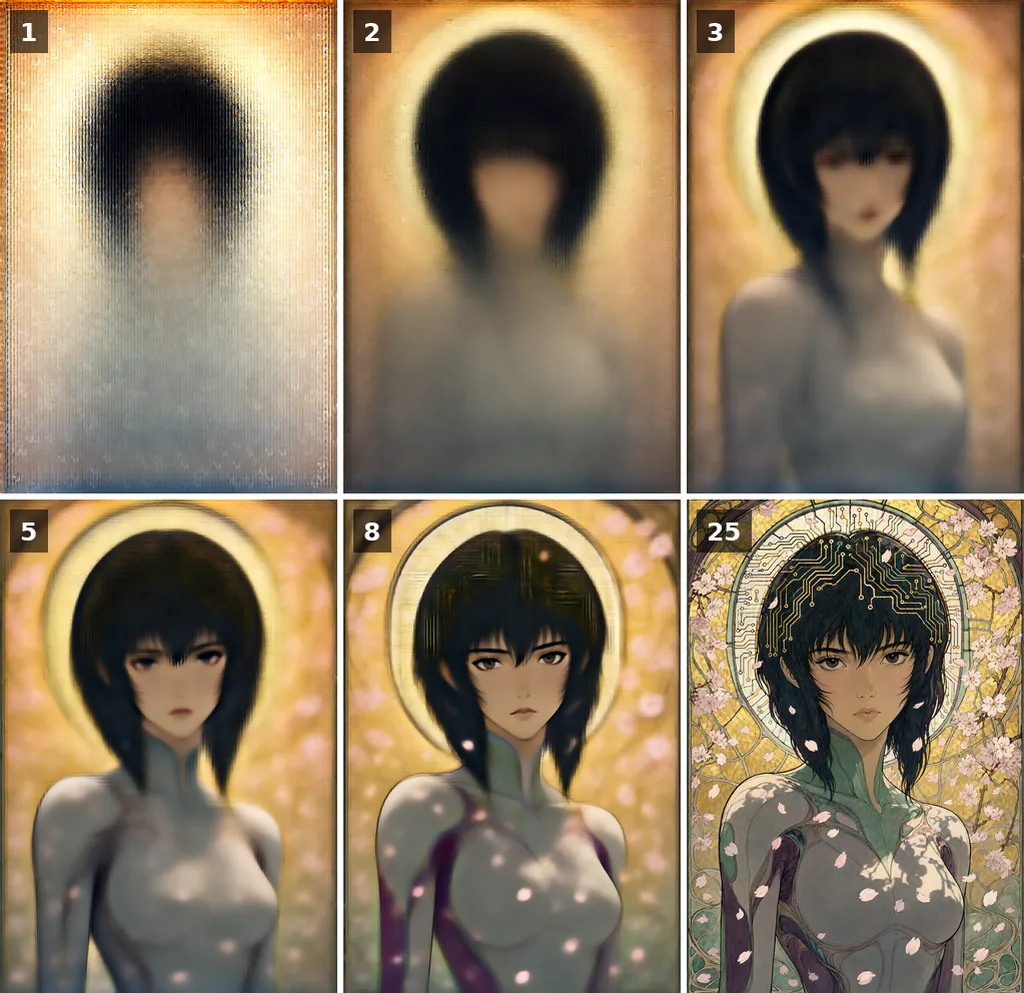
Aşağıdaki şekil, modelin bitmiş görsele ilişkin tahmininin yol boyunca nasıl göründüğünü gösterir. Kompozisyon ilk adımlarda oturur, ayrıntı sonradan gelir. Kabadan inceye giden bu sıra tüm difüzyon modellerinde ortaktır; flow matching esas olarak adımların nasıl aralıklandığını değiştirir, dinamik shift’in ayarladığı da budur.
Yan yana
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Metin kodlayıcı | CLIP ViT-L ve OpenCLIP bigG | İki CLIP kodlayıcı ve T5-XXL | Qwen3-VL 8B, bir görsel-dil modeli |
| Gürültü giderici | U-Net, 2.6 milyar parametre | Çift akışlı MMDiT, 8 milyar | Tek akışlı diffusion transformer, 7 milyar, 32 katman |
| Latent | 4 kanal, 8× sıkıştırma | 16 kanal, 8× | 64 kanal, 16×, alfa ile |
| Eğitim hedefi | Gürültü tahmini | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Doğal boyut | 1024 px | 1024 px | 2048 px |
| Düzenleme | Üçüncü taraf inpainting modeli | Resmi düzenleme modeli yok, yalnızca ControlNet’ler | Aynı checkpoint, en fazla 10 referans görsel |
| Lisans | OpenRAIL++-M | Community License | Qwen Research License |
Bunların hiçbiri modelin nasıl kullanıldığını değiştirmez. Guidance, adım, seed ve boyut her difüzyon modelindeki gibi davranır; yalnızca en iyi çalışan sayılar farklıdır ve bunları ayarlar rehberi ölçer.
Sürümler: Qwen-Image’dan 2.1’e
Numaralandırma kafa karıştırıcı, çünkü yayın kanalını değil mimariyi izliyor. Şubat 2026’da duyurulan ve ağırlıkları hiç yayımlanmayan Qwen-Image 2.0, 2.1’in bugün açık olarak sunduğu daha hafif tasarımı getirdi. Temmuz 2026’da duyurulan Qwen-Image 3.0 ise yalnızca Alibaba’nın API’si üzerinden sunulan daha büyük bir amiral gemisi. Qwen bu düzeni açıklamadı; aşağıdaki tarihler proje depolarından, 3.0 içinse Qwen’in duyurusundan alındı.
| Sürüm | Tarih | Nedir | Ağırlıklar |
|---|---|---|---|
| Qwen-Image | 4 Ağustos 2025 | Qwen2.5-VL 7B kodlayıcılı, 20 milyar parametreli çift akışlı MMDiT; metinden görsel | Açık, Apache 2.0 |
| Qwen-Image-Edit, ardından Edit-2509 ve Edit-2511 | Ağustos–Aralık 2025 | Aynı taban üzerinde düzenleme modelleri; 2509’dan itibaren birden çok referans görsel; Aralık’ta katmanlı bir RGBA modeli, Qwen-Image-Layered | Açık, Apache 2.0 |
| Qwen-Image-2512 | 31 Aralık 2025 | 20 milyarlık hattın son metinden görsel sürümü | Açık, Apache 2.0 |
| Qwen-Image 2.0 | 10 Şubat 2026 | 2.1’in devraldığı tasarım: Qwen3-VL kodlayıcı, 64 kanallı VAE, doğal 2K, 1.000 token’a kadar talimat; Mayıs 2026’da teknik rapor | Yayımlanmadı |
| Qwen-Image 3.0 | 21 Temmuz 2026 | Alibaba’nın API’sinin arkasındaki amiral gemisi: 4.500 token’a kadar prompt, tek geçişte üretilen infografikler ve storyboard’lar | Yalnızca API |
| Qwen-Image 2.1 | 20 Eylül 2026 | Qwen3-VL 8B kodlayıcılı, 7 milyar parametreli tek akışlı transformer; tek checkpoint’te üretim ve düzenleme, RGBA, 2K | Açık, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 Ekim 2026 | Damıtılmış 2.1, 8 adım | Açık, Qwen Research License |
Yani bir indirme sayfasında numarasız “Qwen-Image”, 2025’in 20 milyarlık modelidir ve 2512 ile Edit güncellemeleriyle hâlâ erişilebilir. Güncel açık model 2.1; 3.0 ise Alibaba’nın ücretli hizmetinin arkasındaki model. 2.1 ile 3.0 aynı soydan gelir ama ağırlıkları ortak değildir.
Qwen-Image lisansı: açık ağırlıklar, yalnızca araştırma
İlk Qwen-Image ve düzenleme modelleri Apache 2.0 idi: ticari kullanım dahil her şey için serbest. Qwen-Image 2.1 ve Turbo’su ise Qwen Research License Agreement altında. Ağırlıklar indirilebilir, incelenebilir, çalıştırılabilir ve ince ayar yapılabilir; ama yalnızca araştırma ve değerlendirme için. Her türlü ticari kullanım Qwen’den alınacak ayrı bir lisans gerektirir.
Bu, 2.1’i Stable Diffusion’dan farklı bir yere koyar: 1.5 ve SDXL lisansları yasak kullanımlar listesiyle ticari kullanıma izin verir, 3.5 lisansı yıllık bir milyon doların altındaki gelirde izin verir. FLUX 3 Klein de beş milyonun altında ticari kullanıma serbesttir. Bir öğrenci ya da laboratuvar için hiçbir şey değişmez. Bir stüdyo içinse açık kalan yollar ücretli API ya da Qwen’den talep edilecek ticari lisanstır.
Qwen-Image’ı denemek ve daha ileri gitmek
En hızlı yol bu sitenin ücretsiz Qwen-Image 2.1 sayfası: hesap gerekmez, referans görsellerle üretim ve düzenleme, kuyruk canlı gösterilir.
Evde çalıştırmak için: ComfyUI modeli yerleşik olarak destekler. Comfy-Org’un yeniden paketlemesinden üç dosya her zamanki klasörlere gider: diffusion modeli, Qwen3-VL metin kodlayıcı ve VAE; 16 GB’lık bir kart için int8 sürümleri. Ayarlar rehberi düğüm grafını, prompt yapısını, guidance’ı ve tam olarak o kartta ölçülen boyutları, artı Turbo ile yönlendirilmiş Turbo’yu anlatır.
Tüm bu modellerin paylaştığı ilkeler için, gürültü, latent uzay, guidance ve seed, Stable Diffusion nedir? rehberini okuyun; açıklamalar burada da geçerlidir, yalnızca sayılar değişir.