Cos'è Qwen-Image, in breve
Qwen-Image è la linea di generazione di immagini di Qwen, la famiglia di modelli della divisione cloud di Alibaba. È arrivata ad agosto 2025 con un modello da 20 miliardi di parametri sotto licenza Apache 2.0, accompagnato da un rapporto tecnico. Si è fatta notare per il testo. Paragrafi, insegne ed etichette uscivano leggibili, in inglese e soprattutto in cinese, dove Stable Diffusion 1.5 e SDXL producevano scarabocchi e i modelli del 2024 riuscivano al massimo a scrivere qualche parola in inglese.
La versione aperta attuale è Qwen-Image 2.1, pubblicata il 20 settembre 2026. È un modello più piccolo e più veloce: 7 miliardi di parametri per il generatore di immagini, più un codificatore visione-linguaggio da 8 miliardi. Un solo checkpoint fa due lavori. Genera un'immagine dal testo, e modifica un'immagine esistente a partire da una frase e fino a dieci immagini di riferimento. Produce 2K nativo e immagini trasparenti vere. La licenza non è più Apache: solo ricerca e valutazione.
Come Stable Diffusion e FLUX, è un modello di diffusione che gira in ComfyUI su una scheda grafica consumer, e legge lo stesso tipo di prompt. La differenza sta dentro, ed è ciò che spiega la sezione su come funziona.
Cosa sa fare Qwen-Image 2.1
Da testo a immagine in 2K nativo. Il modello rende direttamente quadrati da 2048 × 2048, 2528 × 1696 in 3:2 e 2752 × 1536 in 16:9, senza ingrandimento. Legge il prompt come un testo, quindi frasi, preposizioni e istruzioni di composizione funzionano, e le parole tra virgolette compaiono come sono scritte: “a banner above the door reads ‘OPEN ALL NIGHT’” esce lettera per lettera sui prompt di prova della guida alle impostazioni. La guida alle impostazioni dà la struttura di prompt che funziona meglio e le impostazioni misurate.
Modifica con lo stesso checkpoint. Dagli un'immagine e una frase e cambia l'immagine: sostituire un oggetto, cambiare stile a una scena, aggiungere testo. Dagli fino a dieci immagini di riferimento e le compone, tenendo coerente un personaggio o un prodotto da un'inquadratura all'altra. Le regioni si possono indicare con una maschera o un cerchio disegnato. Non serve un checkpoint di inpainting separato per i ritocchi locali: lo stesso modello prende la regione come indicazione.
Uscita trasparente. Chiedi un'immagine RGBA con sfondo trasparente e il modello produce un vero canale alfa, non un ritaglio: il VAE codifica e decodifica quattro canali di pixel invece di tre. Loghi, sticker e risorse a livelli escono pronti da piazzare.
Riscrittura del prompt. Qwen distribuisce due modelli di accompagnamento, fine-tune di Qwen3.5-VL 9B, che espandono un prompt breve nella forma dettagliata che il generatore preferisce, uno per la generazione e uno per la modifica. ComfyUI li propone come opzione nei suoi template, disattivati di default; non sono necessari.
Velocità. Su una scheda consumer da 16 GB i pesi int8 impiegano circa 40 secondi per un'immagine da 1 megapixel e da quattro a cinque minuti per 4 megapixel con le impostazioni di qualità della guida alle impostazioni. Un checkpoint distillato, Turbo, uscito il 9 ottobre 2026, rende in 8 passi, circa sette volte più veloce a 4 megapixel, al prezzo della tecnica: disegni, ricami e carta ritagliata scivolano verso la fotografia.
Qwen-Image vs Stable Diffusion: come funziona
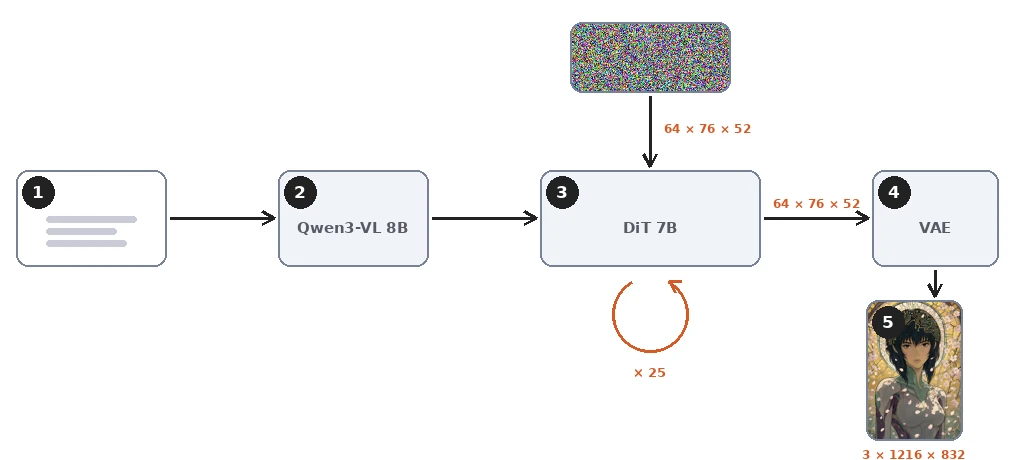
Qwen-Image 2.1 è un modello di diffusione, quindi la meccanica spiegata nella guida a Stable Diffusion vale anche qui. Un codificatore di testo legge il prompt. Un denoiser lavora su un latente compresso per un certo numero di passi. Un decodificatore trasforma il latente in pixel. Ciò che cambia è la scelta fatta per ciascuna delle tre parti. Il repository del modello fornisce i dati qui sotto; Qwen non ha pubblicato un rapporto tecnico per la 2.1.
Un modello visione-linguaggio al posto di CLIP
Stable Diffusion 1.5 e SDXL leggono il prompt con CLIP, una rete addestrata ad abbinare brevi didascalie alle immagini. Qwen-Image 2.1 lo legge con Qwen3-VL 8B, un modello visione-linguaggio completo da otto miliardi di parametri, più del generatore di immagini stesso. Lo stesso codificatore legge le immagini di riferimento nella modifica. È per questo che la struttura di prompt della guida alle impostazioni funziona. Frasi, preposizioni, testo tra virgolette e istruzioni di composizione sono esattamente ciò che un modello linguistico è fatto per analizzare. Un codificatore CLIP tende ad appiattirle in un insieme di concetti alla rinfusa.
Un transformer a flusso singolo al posto di una U-Net
Il denoiser è un transformer di diffusione da 32 strati e 7 miliardi di parametri. SDXL usa una U-Net, blocchi di convoluzione con strati di attenzione in mezzo. Anche Stable Diffusion 3 è passato a un transformer, l'MMDiT, in cui i token di testo e di immagine viaggiano in due flussi con pesi separati e si incontrano solo nell'attenzione di ogni strato. Qwen-Image 2.1 fa un passo in più: i token di testo e di immagine formano un'unica sequenza e passano attraverso gli stessi pesi, ed è questo che significa «flusso singolo» (single-stream). Il primo Qwen-Image del 2025 era un MMDiT a doppio flusso da 20 miliardi di parametri; la 2.1 è circa un terzo di quella dimensione.
Due dettagli della sua attenzione contano in pratica. I token di testo vengono letti in modo causale, come in un modello linguistico, e ogni immagine, di riferimento o generata, è un blocco i cui token si vedono tutti tra loro. L'ordine è prima il prompt, poi le immagini di riferimento, per ultima l'immagine generata, e un token non guarda mai ciò che viene dopo. Quindi il prompt e le immagini di riferimento non vedono mai l'immagine in corso di generazione, e la parte di calcolo che spetta a loro, il prefisso, è identica a ogni passo: viene calcolata una volta e tenuta in cache per tutti i passi di denoising. Il nodo QwenImage21Cache di ComfyUI sceglie solo dove vive quella cache, in che precisione, o se viene usata.
Un latente a 64 canali, compresso sedici volte
Il VAE di Stable Diffusion riduce un'immagine di un fattore otto su ogni lato in 4 canali, 16 nella versione 3. Il VAE di Qwen-Image 2.1 la riduce di sedici volte su ogni lato, in 64 canali. Codifica e decodifica anche quattro canali di pixel, rosso, verde, blu e alfa, invece di tre, ed è così che il modello produce vere immagini RGBA dallo stesso latente a 64 canali. Per un'immagine da 832 × 1216 il latente misura 64 canali da 52 × 76: circa 253.000 numeri per 3 milioni di valori di pixel, dodici volte meno.
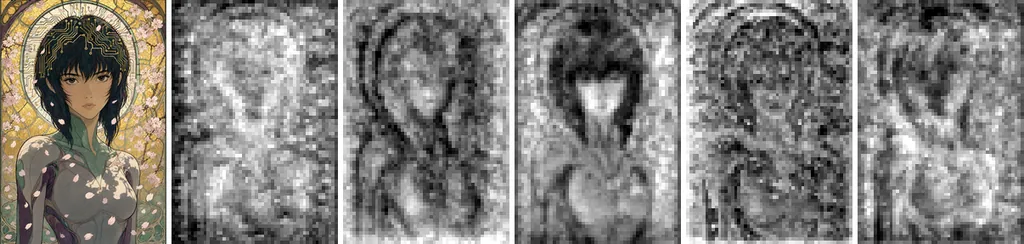
Ogni posizione del latente è un token per il transformer, quindi un'immagine da 1 megapixel sono 3.952 token e una da 4 megapixel 15.808. Quella griglia non è più grossolana di quella di Stable Diffusion 3 o del primo Qwen-Image, che raggruppano il loro latente compresso 8 volte in blocchi di 2 × 2 prima del transformer. Ciò che la 2.1 cambia è che il VAE fa da solo quel raggruppamento, in 64 canali. Il costo dell'attenzione cresce con il quadrato del numero di token, ed è per questo che 4 megapixel costano molto più di quattro volte 1 megapixel.
Flow matching al posto della predizione del rumore
Stable Diffusion 1.5 e SDXL sono stati addestrati a predire il rumore aggiunto a un'immagine. Qwen-Image, come Stable Diffusion 3 e FLUX, è addestrato con il flow matching. La rete predice la direzione che porta dal latente rumoroso a quello pulito, lungo una linea retta. Il sampler segue poi quella direzione con passi di Eulero. Il repository nomina quello scheduler: flow matching con passi discreti di Eulero e uno shift dinamico. Il rapporto del primo Qwen-Image descrive l'obiettivo, una velocità target lungo traiettorie rettilinee, che lo scheduler della 2.1 lascia intendere invariato.
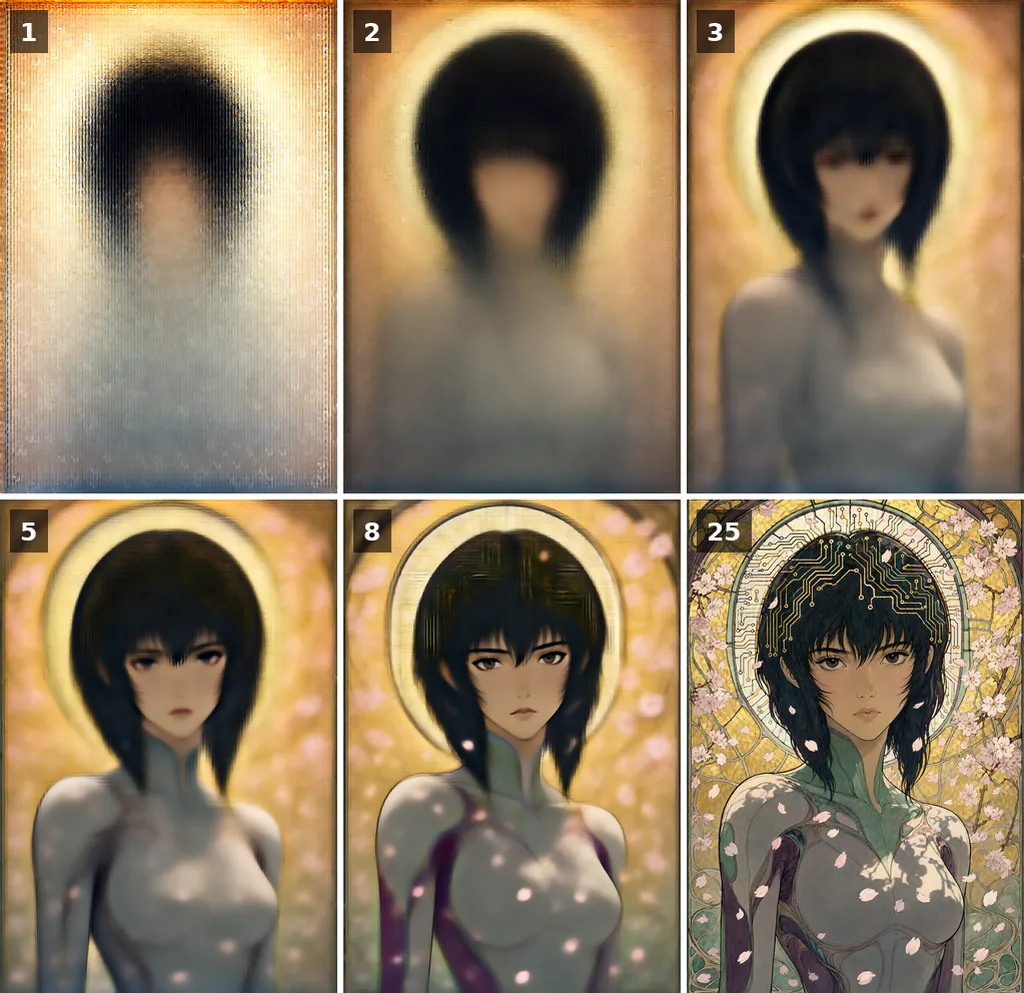
La figura qui sotto mostra che aspetto ha, strada facendo, la stima che il modello fa dell'immagine finita. La composizione si fissa nei primi passi e il dettaglio arriva dopo. Quest'ordine, dal grossolano al fine, è comune a tutti i modelli di diffusione; il flow matching cambia soprattutto la spaziatura dei passi, ed è ciò che lo shift dinamico regola.
Fianco a fianco
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Codificatore di testo | CLIP ViT-L e OpenCLIP bigG | Due codificatori CLIP e T5-XXL | Qwen3-VL 8B, un modello visione-linguaggio |
| Denoiser | U-Net, 2,6 miliardi di parametri | MMDiT a doppio flusso, 8 miliardi | Transformer di diffusione a flusso singolo, 7 miliardi, 32 strati |
| Latente | 4 canali, compressione 8× | 16 canali, 8× | 64 canali, 16×, con alfa |
| Obiettivo di addestramento | Predizione del rumore | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Dimensione nativa | 1024 px | 1024 px | 2048 px |
| Modifica | Modello di inpainting di terze parti | Nessun modello di modifica ufficiale, solo ControlNet | Stesso checkpoint, fino a 10 immagini di riferimento |
| Licenza | OpenRAIL++-M | Community License | Qwen Research License |
Niente di tutto questo cambia il modo di guidare il modello. Guidance, passi, seed e dimensione si comportano come in qualunque modello di diffusione; cambiano solo i numeri che funzionano meglio, e la guida alle impostazioni li misura.
Le versioni, da Qwen-Image alla 2.1
La numerazione confonde perché segue l'architettura, non il canale di rilascio. Qwen-Image 2.0, annunciato a febbraio 2026 e mai pubblicato come pesi, ha introdotto il design più leggero che la 2.1 distribuisce ora apertamente. Qwen-Image 3.0, annunciato a luglio 2026, è un'ammiraglia più grande, servita solo attraverso l'API di Alibaba. Qwen non ha spiegato lo schema; le date qui sotto vengono dai repository del progetto e, per la 3.0, dall'annuncio di Qwen.
| Versione | Data | Cos'è | Pesi |
|---|---|---|---|
| Qwen-Image | 4 agosto 2025 | MMDiT a doppio flusso da 20 miliardi di parametri con un codificatore Qwen2.5-VL 7B; da testo a immagine | Aperti, Apache 2.0 |
| Qwen-Image-Edit, poi Edit-2509 ed Edit-2511 | Da agosto a dicembre 2025 | Modelli di modifica sulla stessa base; più immagini di riferimento dalla 2509; un modello RGBA a livelli, Qwen-Image-Layered, a dicembre | Aperti, Apache 2.0 |
| Qwen-Image-2512 | 31 dicembre 2025 | Ultima versione da testo a immagine della linea da 20 miliardi | Aperti, Apache 2.0 |
| Qwen-Image 2.0 | 10 febbraio 2026 | Il design che la 2.1 eredita: codificatore Qwen3-VL, VAE a 64 canali, 2K nativo, istruzioni fino a 1.000 token; rapporto tecnico a maggio 2026 | Non pubblicati |
| Qwen-Image 3.0 | 21 luglio 2026 | Ammiraglia dietro l'API di Alibaba: prompt fino a 4.500 token, infografiche e storyboard resi in un solo passaggio | Solo API |
| Qwen-Image 2.1 | 20 settembre 2026 | Transformer a flusso singolo da 7 miliardi di parametri con un codificatore Qwen3-VL 8B; generazione e modifica in un solo checkpoint, RGBA, 2K | Aperti, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 ottobre 2026 | 2.1 distillata, 8 passi | Aperti, Qwen Research License |
Quindi, in una pagina di download, «Qwen-Image» senza numero è il modello da 20 miliardi del 2025, ancora disponibile con i suoi aggiornamenti 2512 ed Edit. Il modello aperto attuale è la 2.1, e la 3.0 è il modello dietro il servizio a pagamento di Alibaba. La 2.1 e la 3.0 condividono la discendenza, non i pesi.
La licenza di Qwen-Image: pesi aperti, solo ricerca
Il primo Qwen-Image e i suoi modelli di modifica erano Apache 2.0: liberi per qualunque uso, commerciale compreso. Qwen-Image 2.1 e il suo Turbo sono sotto il Qwen Research License Agreement. I pesi si possono scaricare, studiare, eseguire e sottoporre a fine-tune, ma solo per ricerca e valutazione. Qualunque uso commerciale richiede una licenza separata da Qwen.
Questo colloca la 2.1 in una posizione diversa da Stable Diffusion, le cui licenze 1.5 e SDXL consentono l'uso commerciale con un elenco di usi vietati e la cui licenza 3.5 lo consente sotto un milione di dollari di ricavi annui, e da FLUX 3 Klein, libero per uso commerciale sotto i cinque milioni. Per uno studente o un laboratorio non cambia niente. Per uno studio, l'API a pagamento o una licenza commerciale richiesta a Qwen sono le strade che restano aperte.
Provare Qwen-Image e andare oltre
La via più rapida è la pagina gratuita di Qwen-Image 2.1 di questo sito: senza account, generazione e modifica con immagini di riferimento, la coda mostrata in diretta.
Per farlo girare a casa, ComfyUI supporta il modello nativamente. Tre file ripacchettizzati da Comfy-Org vanno nelle cartelle consuete: il modello di diffusione, il codificatore di testo Qwen3-VL e il VAE, in versione int8 per una scheda da 16 GB. La guida alle impostazioni copre il grafo, la struttura del prompt, la guidance e le dimensioni misurate esattamente su quella scheda, più il Turbo e il Turbo guidato.
Per i principi comuni a tutti questi modelli, rumore, spazio latente, guidance e seed, leggi Cos'è Stable Diffusion?; le spiegazioni valgono anche qui, cambiano solo i numeri.