Qwen-Image 是什么,简而言之
Qwen-Image 是通义千问(Qwen)的图像生成产品线,Qwen 是阿里巴巴云计算部门的模型家族。它在 2025 年 8 月问世,是一个 20B 参数的模型,采用 Apache 2.0 许可证,并附有一份技术报告。它的突出之处是文字。段落、招牌和标签都清晰可读,英文如此,中文更是如此。而 Stable Diffusion 1.5 和 SDXL 只能画出歪歪扭扭的笔画,2024 年的模型顶多写对几个英文单词。
当前的开放版本是 Qwen-Image 2.1,发布于 2026 年 9 月 20 日。它更小、更快:图像生成器 7B 参数,外加一个 8B 参数的视觉语言编码器。一个检查点做两件事。它从文字生成图像,也能用一句话加最多十张参考图来编辑现有图片。它直接输出原生 2K 和真正的透明图。许可证不再是 Apache:仅限研究和评估。
和 Stable Diffusion、FLUX 一样,它是扩散模型,在消费级显卡上通过 ComfyUI 运行,读的也是同一类提示词。不同之处在内部,这正是工作原理那一节要讲的。
Qwen-Image 2.1 能做什么
原生 2K 文生图。模型直接渲染 2048 × 2048 的正方形、3:2 的 2528 × 1696 和 16:9 的 2752 × 1536,不用放大模型。它把提示词当作一段文字来读,所以句子、介词和版面指令都有效,引号里的词会原样出现:在参数指南的测试提示词里,“a banner above the door reads ‘OPEN ALL NIGHT’” 就按原文写了出来。参数指南给出了最有效的提示词结构和实测参数。
用同一个检查点编辑。给它一张图和一句话,它就改图:替换物体、改变场景风格、加文字。给它最多十张参考图,它会把它们组合起来,让角色或产品在多张图之间保持一致。可以用蒙版或手画的圈指定区域。局部编辑不需要单独的局部重绘检查点:同一个模型把这块区域当作线索。
透明输出。要求一张透明背景的 RGBA 图,模型会生成真正的 Alpha 通道,而不是抠图:VAE 编码和解码的是四个像素通道,而不是三个。Logo、贴纸和分层素材出来就能直接用。
提示词改写。Qwen 附带两个配套模型,都是 Qwen3.5-VL 9B 的微调版,能把简短的提示词扩写成生成器偏好的详细形式,一个用于生成,一个用于编辑。ComfyUI 在模板里把它们作为选项提供,默认关闭;它们不是必需的。
速度。在一张 16 GB 的消费级显卡上,用参数指南的画质设置,int8 权重生成一张 1 MP(百万像素)的图约需 40 秒,4 MP 需要四到五分钟。2026 年 10 月 9 日发布的蒸馏版 Turbo 检查点只需 8 步,在 4 MP 下快了约七倍,代价是媒介感:素描、刺绣和剪纸会向照片漂移。
Qwen-Image 与 Stable Diffusion 的区别:工作原理
Qwen-Image 2.1 是扩散模型,所以 Stable Diffusion 指南里讲的机制同样适用。文本编码器读提示词。去噪器在压缩的潜在表示上工作若干步。解码器把潜在表示变成像素。不同的是这三个部件各自的选择。下面的事实来自模型仓库;Qwen 没有为 2.1 发布技术报告。
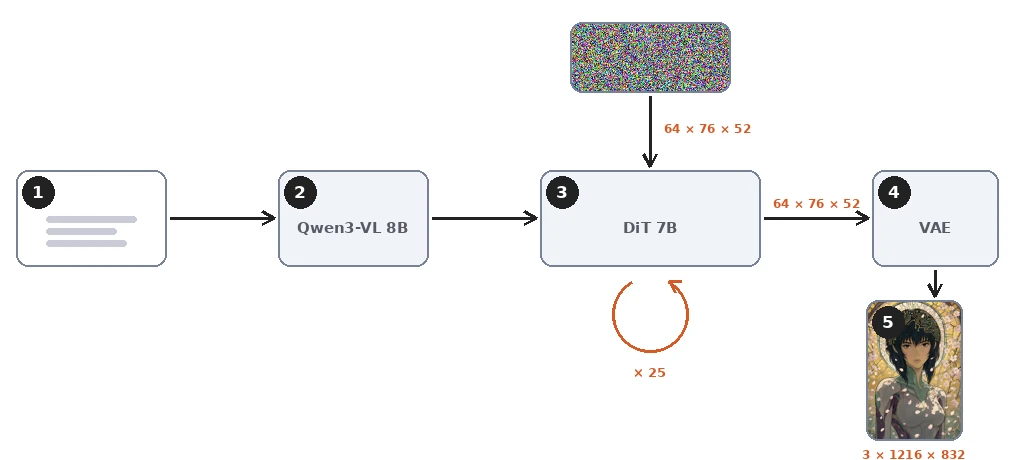
用视觉语言模型代替 CLIP
Stable Diffusion 1.5 和 SDXL 用 CLIP 读提示词,那是一个训练来把简短的图片说明和图像配对的网络。Qwen-Image 2.1 用 Qwen3-VL 8B 来读,一个拥有 80 亿参数的完整视觉语言模型,比图像生成器本身还多。编辑时,同一个编码器也读参考图。这就是参数指南的提示词结构之所以有效的原因。句子、介词、引号里的文字和版面指令,正是语言模型生来要解析的东西。CLIP 编码器往往把它们压扁成一堆概念。
用单流 Transformer 代替 U-Net
去噪器是一个 32 层、7B 参数的扩散 Transformer。SDXL 用的是 U-Net,卷积块之间夹着注意力层。Stable Diffusion 3 也转向了 Transformer,即 MMDiT,其中文本 token 和图像 token 走两条权重各自独立的流,只在每一层的注意力里相遇。Qwen-Image 2.1 再进一步:文本 token 和图像 token 组成一个序列,经过同一套权重,这就是“单流”的意思。2025 年的第一代 Qwen-Image 是一个 20B 参数的双流 MMDiT;2.1 大约只有它的三分之一。
它的注意力有两个细节在实践中很重要。文本 token 像在语言模型里一样按因果顺序读取,而每张图像,无论参考图还是生成图,都是一个块,块内的 token 彼此可见。顺序是先提示词,再参考图,最后生成图,一个 token 永远不看排在它后面的东西。于是提示词和参考图从不看到正在生成的图像,属于它们的那部分计算,即前缀,在每一步都完全相同:只算一次,然后在各个去噪步之间缓存。ComfyUI 的 QwenImage21Cache 节点只决定这份缓存放在哪里、用什么精度,或者是否使用。
一个 64 通道、压缩十六倍的潜在表示
Stable Diffusion 的 VAE 把图像每边缩小八倍,压成 4 个通道,第 3 版是 16 个。Qwen-Image 2.1 的 VAE 每边缩小十六倍,压成 64 个通道。它编码和解码的也是四个像素通道,红、绿、蓝和 Alpha,而不是三个,模型就是这样从同一个 64 通道潜在表示输出真正的 RGBA 图像的。一张 832 × 1216 的图像,潜在表示是 64 个通道、每个 52 × 76:约 253,000 个数字,而像素值约有 3,000,000 个,前者只有后者的十二分之一。
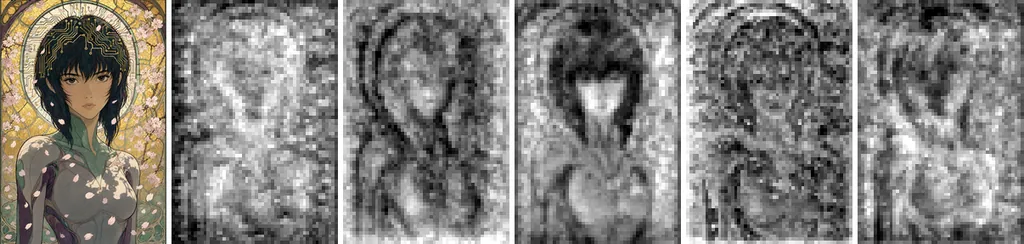
潜在表示的每个位置就是 Transformer 的一个 token,所以一张 1 MP 的图是 3,952 个 token,4 MP 则是 15,808 个。这个网格并不比 Stable Diffusion 3 或第一代 Qwen-Image 的更粗,它们在进 Transformer 之前把 8 倍压缩的潜在表示再合并成 2 × 2 的图块。2.1 的改变在于,这一步合并由 VAE 自己完成,压进 64 个通道。注意力的开销随 token 数的平方增长,这就是 4 MP 的开销远不止 1 MP 四倍的原因。
用流匹配代替噪声预测
Stable Diffusion 1.5 和 SDXL 的训练目标是预测加到图像上的噪声。Qwen-Image 和 Stable Diffusion 3、FLUX 一样,用流匹配训练。网络预测的是从带噪潜在表示指向干净潜在表示的方向,沿一条直线。采样器随后用 Euler 步沿着这个方向前进。模型仓库写明了这个调度器:流匹配,Euler 离散步,带动态 shift。第一代 Qwen-Image 的报告描述了训练目标,沿直线路径的速度目标;从 2.1 的调度器看,这一点没有变。
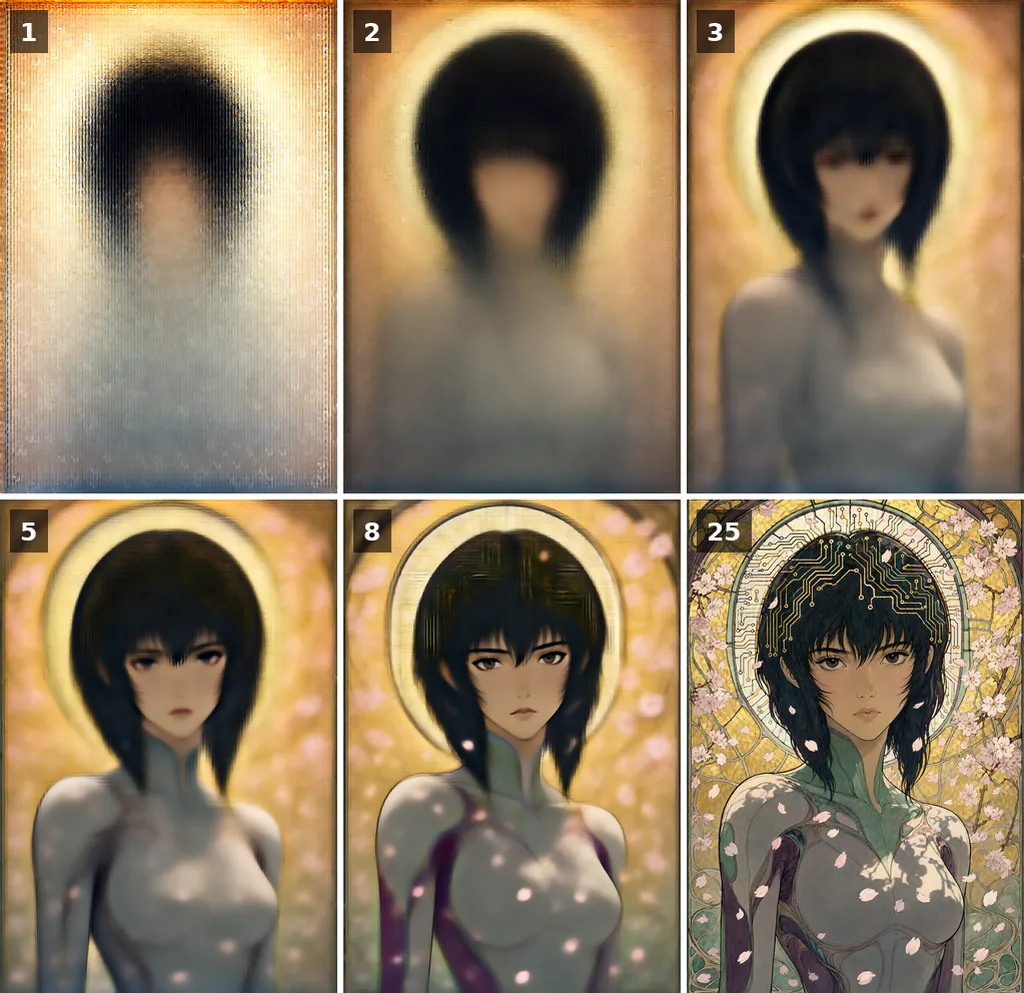
下图展示了模型沿途对成品图像的估计是什么样子。构图在最初几步就定了,细节后来才到。这种由粗到细的顺序是所有扩散模型共有的;流匹配主要改变的是各步的间距,动态 shift 调的就是这个。
并排对比
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| 文本编码器 | CLIP ViT-L 和 OpenCLIP bigG | 两个 CLIP 编码器和 T5-XXL | Qwen3-VL 8B,视觉语言模型 |
| 去噪器 | U-Net,2.6B 参数 | 双流 MMDiT,8B | 单流扩散 Transformer,7B,32 层 |
| 潜在表示 | 4 个通道,8× 压缩 | 16 个通道,8× | 64 个通道,16×,含 Alpha |
| 训练目标 | 噪声预测 | 流匹配(rectified flow) | 流匹配(rectified flow) |
| 原生尺寸 | 1024 px | 1024 px | 2048 px |
| 编辑 | 第三方局部重绘模型 | 没有官方编辑模型,只有 ControlNet | 同一个检查点,最多 10 张参考图 |
| 许可证 | OpenRAIL++-M | Community License | Qwen Research License |
这一切都不改变模型的用法。引导系数、步数、种子和尺寸的表现与任何扩散模型一样;只有最有效的数值不同,而参数指南把它们一一测了出来。
各个版本:从 Qwen-Image 到 2.1
版本号容易让人糊涂,因为它跟的是架构,不是发布渠道。Qwen-Image 2.0 于 2026 年 2 月宣布,从未以权重形式发布,它引入了 2.1 如今开放出来的轻量设计。Qwen-Image 3.0 于 2026 年 7 月宣布,是更大的旗舰模型,只通过阿里巴巴的 API 提供。Qwen 没有解释这套编号;下面的日期来自项目仓库,3.0 的日期来自 Qwen 的公告。
| 版本 | 日期 | 是什么 | 权重 |
|---|---|---|---|
| Qwen-Image | 2025 年 8 月 4 日 | 20B 参数的双流 MMDiT,搭配 Qwen2.5-VL 7B 编码器;文生图 | 开放,Apache 2.0 |
| Qwen-Image-Edit,之后是 Edit-2509 和 Edit-2511 | 2025 年 8 月至 12 月 | 基于同一底座的编辑模型;从 2509 起支持多张参考图;12 月推出分层 RGBA 模型 Qwen-Image-Layered | 开放,Apache 2.0 |
| Qwen-Image-2512 | 2025 年 12 月 31 日 | 20B 产品线的最后一个文生图版本 | 开放,Apache 2.0 |
| Qwen-Image 2.0 | 2026 年 2 月 10 日 | 2.1 继承的设计:Qwen3-VL 编码器、64 通道 VAE、原生 2K、最长 1,000 个 token 的指令;技术报告于 2026 年 5 月发布 | 未发布 |
| Qwen-Image 3.0 | 2026 年 7 月 21 日 | 阿里巴巴 API 背后的旗舰:提示词最长 4,500 个 token,一次生成信息图和分镜 | 仅 API |
| Qwen-Image 2.1 | 2026 年 9 月 20 日 | 7B 参数的单流 Transformer,搭配 Qwen3-VL 8B 编码器;生成和编辑用同一个检查点,RGBA,2K | 开放,Qwen Research License |
| Qwen-Image 2.1 Turbo | 2026 年 10 月 9 日 | 2.1 的蒸馏版,8 步 | 开放,Qwen Research License |
所以在下载页面上,不带数字的“Qwen-Image”是 2025 年的 20B 模型,连同它的 2512 和 Edit 更新至今仍可下载。当前的开放模型是 2.1,而 3.0 是阿里巴巴付费服务背后的模型。2.1 和 3.0 同出一脉,但权重并不相同。
Qwen-Image 的许可证:开放权重,仅限研究
第一代 Qwen-Image 及其编辑模型是 Apache 2.0:什么用途都免费,包括商用。Qwen-Image 2.1 及其 Turbo 采用 Qwen Research License Agreement。权重可以下载、研究、运行和微调,但仅限研究和评估。任何商业用途都需要向 Qwen 另行申请许可。
这让 2.1 的处境与 Stable Diffusion 不同:后者的 1.5 和 SDXL 许可证允许商用,附带一份禁止用途清单,3.5 许可证允许年收入一百万美元以下的商用;也与 FLUX 3 Klein 不同,它在五百万美元以下可免费商用。对学生或实验室来说,什么都没变。对工作室来说,还开着的路是付费 API,或者向 Qwen 申请商业许可。
试用 Qwen-Image,以及更进一步
最快的办法是本站的免费 Qwen-Image 2.1 页面:不用账号,支持生成和带参考图的编辑,队列实时显示。
想在自己电脑上运行,ComfyUI 原生支持这个模型。从 Comfy-Org 的重新打包版本取三个文件,放进平常的文件夹:扩散模型、Qwen3-VL 文本编码器和 VAE,16 GB 显卡用 int8 版本。参数指南讲了工作流图、提示词结构、引导系数,以及正是在这张显卡上实测的尺寸,还有 Turbo 和带引导的 Turbo。
至于这些模型共有的原理,噪声、潜在空间、引导系数和种子,请读什么是 Stable Diffusion?;那里的解释同样适用,变的只是数字。