Що таке Qwen-Image, коротко
Qwen-Image — це лінійка генерації зображень у Qwen, сімействі моделей хмарного підрозділу Alibaba. Вона з’явилася в серпні 2025 року як модель на 20 мільярдів параметрів під ліцензією Apache 2.0, з технічним звітом. Вирізняв її текст. Абзаци, вивіски й етикетки виходили розбірливими, англійською і насамперед китайською, там, де Stable Diffusion 1.5 і SDXL малювали карлючки, а моделі 2024 року давали щонайбільше кілька англійських слів.
Поточний відкритий реліз — Qwen-Image 2.1, опублікований 20 вересня 2026 року. Це менша і швидша модель: 7 мільярдів параметрів у генераторі зображень плюс візуально-мовний енкодер на 8 мільярдів параметрів. Один чекпойнт виконує дві роботи. Він генерує зображення з тексту й редагує наявну картинку за реченням і щонайбільше десятьма референсними зображеннями. Він видає нативне 2K і справді прозорі зображення. Його ліцензія вже не Apache: лише дослідження та оцінювання.
Як Stable Diffusion і FLUX, це дифузійна модель, яка працює в ComfyUI на споживчій відеокарті й читає той самий тип промпту. Відмінності всередині, і саме їх пояснює розділ про те, як вона працює.
Що вміє Qwen-Image 2.1
Text-to-image в нативному 2K. Модель рендерить квадрати 2048 × 2048, 2528 × 1696 у 3:2 і 2752 × 1536 у 16:9 напряму, без апскейлера. Вона читає промпт як текст, тож речення, прийменники та вказівки щодо розташування працюють, а слова в лапках з’являються так, як написані: “a banner above the door reads ‘OPEN ALL NIGHT’” виходить дослівно на тестових промптах посібника з налаштувань. Посібник з налаштувань дає структуру промпту, яка працює найкраще, і виміряні налаштування.
Редагування тим самим чекпойнтом. Дайте їй картинку й речення — і вона змінить картинку: замінить об’єкт, перестилізує сцену, додасть текст. Дайте їй до десяти референсних зображень — і вона скомпонує їх, зберігаючи персонажа чи продукт однаковими від кадру до кадру. Ділянки можна вказати маскою або намальованим колом. Для локальних правок окремий чекпойнт inpainting не потрібен: та сама модель сприймає ділянку як підказку.
Прозорий результат. Попросіть зображення RGBA з прозорим фоном — і модель видасть справжній альфа-канал, а не вирізку: VAE кодує й декодує чотири канали пікселів замість трьох. Логотипи, стікери й шарові ресурси виходять готовими до вставлення.
Переписування промпту. Qwen постачає дві супутні моделі, донавчені Qwen3.5-VL 9B, які розгортають короткий промпт у детальну форму, яку генератор любить більше: одна для генерації, одна для редагування. ComfyUI пропонує їх у своїх шаблонах як опцію, вимкнену за замовчуванням; вони не обов’язкові.
Швидкість. На споживчій карті з 16 ГБ ваги int8 витрачають близько 40 секунд на зображення в 1 мегапіксель і чотири-п’ять хвилин на 4 мегапікселі за налаштуваннями якості з посібника з налаштувань. Дистильований чекпойнт Turbo, випущений 9 жовтня 2026 року, рендерить за 8 кроків, приблизно всемеро швидше на 4 мегапікселях, ціною техніки: малюнки, вишивка й витинанки з паперу дрейфують у бік фотографії.
Qwen-Image vs Stable Diffusion: як вона працює
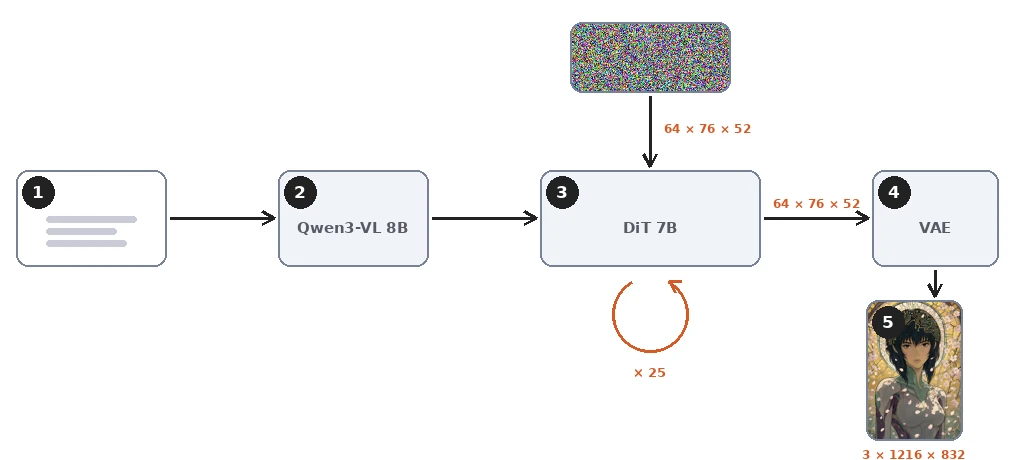
Qwen-Image 2.1 — дифузійна модель, тож механіка, пояснена в посібнику про Stable Diffusion, діє і тут. Текстовий енкодер читає промпт. Знешумлювач працює зі стиснутим латентом певну кількість кроків. Декодер перетворює латент на пікселі. Відрізняється вибір, зроблений для кожної з трьох частин. Репозиторій моделі дає наведені нижче факти; технічного звіту для 2.1 Qwen не публікувала.
Візуально-мовна модель замість CLIP
Stable Diffusion 1.5 і SDXL читають промпт через CLIP, мережу, навчену зіставляти короткі підписи із зображеннями. Qwen-Image 2.1 читає його через Qwen3-VL 8B, повноцінну візуально-мовну модель на вісім мільярдів параметрів, більшу за сам генератор зображень. Той самий енкодер читає референсні зображення під час редагування. Ось чому працює структура промпту з посібника з налаштувань. Речення, прийменники, текст у лапках і вказівки щодо розташування — саме те, що мовна модель створена розбирати. Енкодер CLIP зазвичай сплющує їх у мішок понять.
Однопотоковий трансформер замість U-Net
Знешумлювач — це дифузійний трансформер із 32 шарів і 7 мільярдів параметрів. SDXL використовує U-Net, згорткові блоки з шарами уваги між ними. Stable Diffusion 3 теж перейшов на трансформер, MMDiT, у якому токени тексту й зображення йдуть двома потоками з окремими вагами і зустрічаються лише в увазі кожного шару. Qwen-Image 2.1 іде на крок далі: токени тексту й зображення утворюють одну послідовність і проходять через ті самі ваги — саме це означає «однопотоковий». Перша Qwen-Image 2025 року була двопотоковим MMDiT на 20 мільярдів параметрів; 2.1 приблизно втричі менша.
Дві деталі її уваги важливі на практиці. Токени тексту читаються каузально, як у мовній моделі, а кожне зображення, референсне чи згенероване, — це один блок, у якому всі токени бачать одне одного. Порядок такий: спершу промпт, потім референсні зображення, наприкінці згенероване зображення, і токен ніколи не дивиться на те, що йде після нього. Тож промпт і референсні зображення ніколи не бачать зображення, яке генерується, а частина обчислень, що належить їм, префікс, однакова на кожному кроці: її обчислюють один раз і кешують на всі кроки знешумлення. Вузол QwenImage21Cache у ComfyUI лише вибирає, де живе цей кеш, у якій точності й чи використовується він узагалі.
Латент із 64 каналами, стиснутий у шістнадцять разів
VAE Stable Diffusion стискає зображення увосьмеро по кожній стороні в 4 канали, 16 у версії 3. VAE Qwen-Image 2.1 стискає його в шістнадцять разів по кожній стороні, у 64 канали. Він також кодує й декодує чотири канали пікселів, червоний, зелений, синій і альфа, замість трьох, і саме так модель видає справжні зображення RGBA з того самого латенту на 64 канали. Для зображення 832 × 1216 латент має 64 канали по 52 × 76: близько 253 000 чисел на 3 мільйони значень пікселів, у дванадцять разів менше.
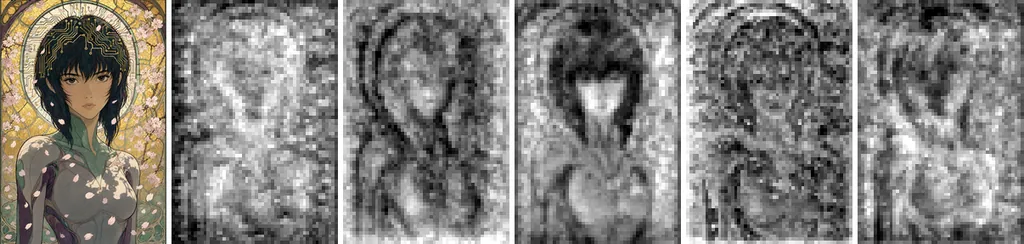
Кожна позиція латенту — один токен для трансформера, тож зображення в 1 мегапіксель — це 3 952 токени, а в 4 мегапікселі — 15 808. Ця сітка не грубша, ніж у Stable Diffusion 3 чи в першої Qwen-Image, які групують свій латент зі стисненням 8× у ділянки 2 × 2 перед трансформером. Що змінює 2.1 — це те, що VAE робить це групування сам, у 64 каналах. Вартість уваги зростає як квадрат кількості токенів, ось чому 4 мегапікселі коштують набагато більше, ніж чотири рази по 1 мегапікселю.
Flow matching замість передбачення шуму
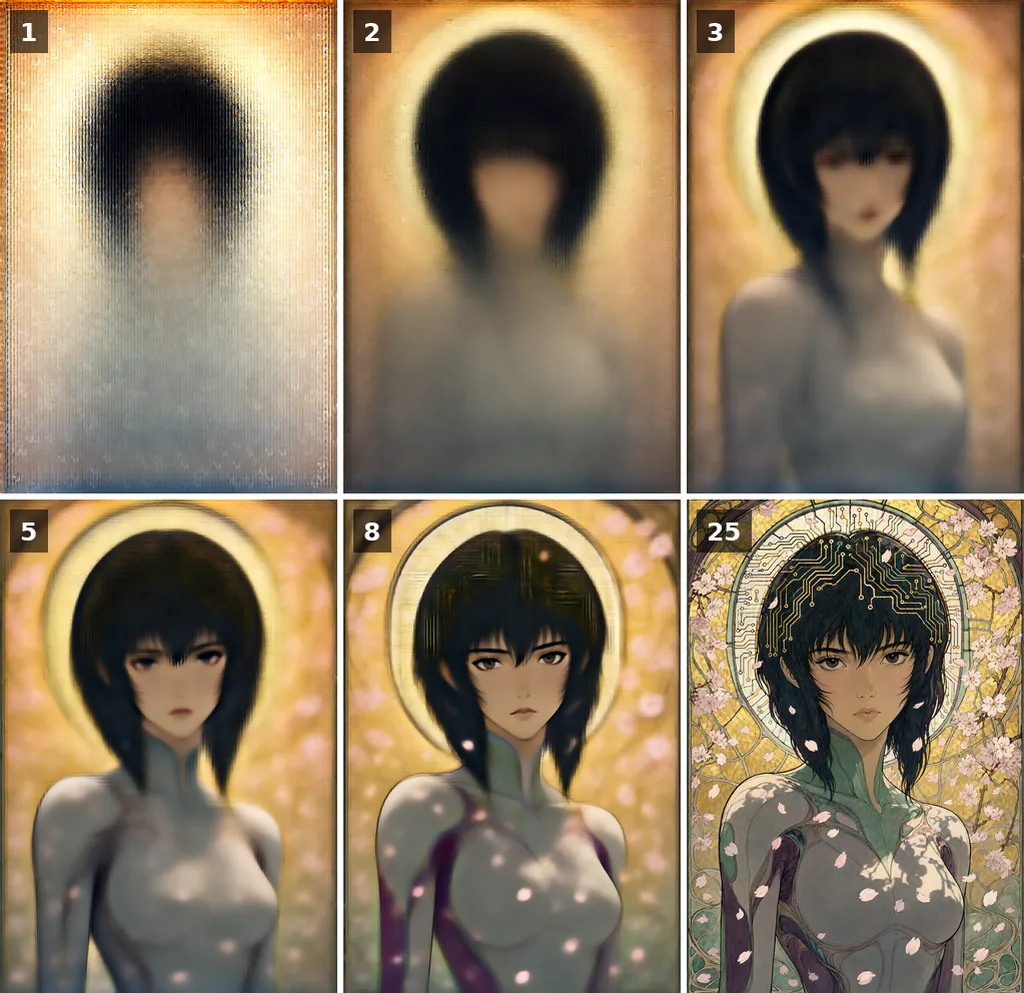
Stable Diffusion 1.5 і SDXL навчали передбачати шум, доданий до зображення. Qwen-Image, як і Stable Diffusion 3 та FLUX, навчена методом flow matching. Мережа передбачає напрямок від зашумленого латенту до чистого, уздовж прямої. Потім семплер іде в цьому напрямку кроками Ейлера. Репозиторій називає цей планувальник: flow matching із дискретними кроками Ейлера і динамічним зсувом (shift). Перший звіт про Qwen-Image описує ціль навчання, швидкість уздовж прямих траєкторій, і планувальник 2.1 дає зрозуміти, що вона не змінилася.
Ілюстрація нижче показує, як дорогою виглядає оцінка моделлю готового зображення. Композиція фіксується на перших кроках, а деталі приходять пізніше. Цей порядок, від грубого до тонкого, спільний для всіх дифузійних моделей; flow matching змінює головно те, як розподілені кроки, і саме це налаштовує динамічний зсув.
Порівняльна таблиця
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Текстовий енкодер | CLIP ViT-L і OpenCLIP bigG | Два енкодери CLIP і T5-XXL | Qwen3-VL 8B, візуально-мовна модель |
| Знешумлювач | U-Net, 2,6 мільярда параметрів | Двопотоковий MMDiT, 8 мільярдів | Однопотоковий дифузійний трансформер, 7 мільярдів, 32 шари |
| Латент | 4 канали, стиснення 8× | 16 каналів, 8× | 64 канали, 16×, з альфа |
| Ціль навчання | Передбачення шуму | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Нативний розмір | 1024 px | 1024 px | 2048 px |
| Редагування | Стороння модель inpainting | Офіційної моделі редагування немає, лише ControlNet | Той самий чекпойнт, до 10 референсних зображень |
| Ліцензія | OpenRAIL++-M | Community License | Qwen Research License |
Ніщо з цього не змінює того, як моделлю керують. Guidance, кроки, seed і розмір поводяться як у будь-якій дифузійній моделі; різняться лише числа, які працюють найкраще, і посібник з налаштувань їх вимірює.
Версії: від Qwen-Image до 2.1
Нумерація заплутана, бо йде за архітектурою, а не за каналом випуску. Qwen-Image 2.0, анонсована в лютому 2026 року й так і не випущена як ваги, запровадила легшу конструкцію, яку 2.1 тепер постачає відкрито. Qwen-Image 3.0, анонсована в липні 2026 року, — більший флагман, доступний лише через API Alibaba. Qwen цієї схеми не пояснювала; дати нижче взято з репозиторіїв проєкту, а для 3.0 — з анонсу Qwen.
| Реліз | Дата | Що це | Ваги |
|---|---|---|---|
| Qwen-Image | 4 серпня 2025 | Двопотоковий MMDiT на 20 мільярдів параметрів з енкодером Qwen2.5-VL 7B; text-to-image | Відкриті, Apache 2.0 |
| Qwen-Image-Edit, потім Edit-2509 і Edit-2511 | Із серпня по грудень 2025 | Моделі редагування на тій самій базі; кілька референсних зображень починаючи з 2509; шарова модель RGBA, Qwen-Image-Layered, у грудні | Відкриті, Apache 2.0 |
| Qwen-Image-2512 | 31 грудня 2025 | Останній text-to-image реліз 20-мільярдної лінійки | Відкриті, Apache 2.0 |
| Qwen-Image 2.0 | 10 лютого 2026 | Конструкція, яку успадковує 2.1: енкодер Qwen3-VL, VAE на 64 канали, нативне 2K, інструкції до 1 000 токенів; технічний звіт у травні 2026 | Не опубліковані |
| Qwen-Image 3.0 | 21 липня 2026 | Флагман, доступний лише через API Alibaba: промпти до 4 500 токенів, інфографіка та розкадровки за один прохід | Лише API |
| Qwen-Image 2.1 | 20 вересня 2026 | Однопотоковий трансформер на 7 мільярдів параметрів з енкодером Qwen3-VL 8B; генерація та редагування в одному чекпойнті, RGBA, 2K | Відкриті, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 жовтня 2026 | Дистильована 2.1, 8 кроків | Відкриті, Qwen Research License |
Тож на сторінці завантаження «Qwen-Image» без номера — це 20-мільярдна модель 2025 року, досі доступна з оновленнями 2512 і Edit. Поточна відкрита модель — 2.1, а 3.0 — модель, що стоїть за платним сервісом Alibaba. 2.1 і 3.0 мають спільний родовід, але не спільні ваги.
Ліцензія Qwen-Image: відкриті ваги, лише для досліджень
Перша Qwen-Image та її моделі редагування були під Apache 2.0: вільні для будь-чого, включно з комерційним використанням. Qwen-Image 2.1 і її Turbo поширюються за Qwen Research License Agreement. Ваги можна завантажувати, вивчати, запускати й донавчати, але лише для досліджень та оцінювання. Будь-яке комерційне використання потребує окремої ліцензії від Qwen.
Це ставить 2.1 в інше становище, ніж Stable Diffusion, чиї ліцензії 1.5 і SDXL дозволяють комерційне використання зі списком заборонених застосувань, а ліцензія 3.5 дозволяє його до одного мільйона доларів річного доходу, і ніж FLUX 3 Klein, безкоштовний для комерційного використання до п’яти мільйонів. Для студента чи лабораторії нічого не змінюється. Для студії відкритими лишаються два шляхи: платний API або комерційна ліцензія, яку запитують у Qwen.
Як спробувати Qwen-Image і куди далі
Найшвидший спосіб — безкоштовна сторінка Qwen-Image 2.1 на цьому сайті: без облікового запису, генерація та редагування з референсними зображеннями, черга показується наживо.
Щоб запустити її вдома, ComfyUI підтримує модель нативно. Три файли з перепакування Comfy-Org кладуть у звичні теки: дифузійна модель, текстовий енкодер Qwen3-VL і VAE, версії int8 для карти з 16 ГБ. Посібник з налаштувань описує граф, структуру промпту, guidance і розміри, виміряні саме на цій карті, а також Turbo і керований Turbo.
Про принципи, спільні для всіх цих моделей, шум, латентний простір, guidance і seed, читайте посібник Що таке Stable Diffusion?; пояснення переносяться, змінюються лише числа.