Qwen-Image とは、一言で
Qwen-Image は、アリババのクラウド部門が手がけるモデルファミリー Qwen の画像生成ラインです。2025年8月に、Apache 2.0 ライセンスの 20B パラメータのモデルとして、技術報告とともに登場しました。際立っていたのは文字です。段落、看板、ラベルが読める形で出てきました。英語でも、とりわけ中国語でもです。Stable Diffusion 1.5 や SDXL では文字は模様になり、2024年のモデルでも英単語が数語出れば良い方でした。
現行のオープン版は、2026年9月20日に公開された Qwen-Image 2.1 です。より小さく速いモデルで、画像生成部は 7B パラメータ、これに 8B パラメータの視覚言語エンコーダが付きます。一つのチェックポイントが二つの仕事をこなします。テキストから画像を生成し、既存の画像を一文と最大10枚の参照画像で編集します。ネイティブ 2K と本物の透明画像を出力します。ライセンスはもう Apache ではなく、研究と評価のみです。
Stable Diffusion や FLUX と同じく、民生用グラフィックカードの ComfyUI で動く拡散モデルで、同じ種類のプロンプトを読みます。違いは内部にあります。それを説明するのが「仕組み」のセクションです。
Qwen-Image 2.1 にできること
ネイティブ 2K のテキストから画像。2048 × 2048 の正方形、3:2 の 2528 × 1696、16:9 の 2752 × 1536 を、アップスケーラーなしで直接描きます。プロンプトを文章として読むので、文、前置詞、レイアウトの指示が効き、引用符で囲んだ語はそのまま現れます。“a banner above the door reads ‘OPEN ALL NIGHT’” は、設定ガイドのテストプロンプトで書いたとおりに出ました。設定ガイドには、最も効くプロンプトの型と計測した設定があります。
同じチェックポイントで編集。画像と一文を渡せば、画像を変えます。物の置き換え、場面のスタイル変更、文字の追加。最大10枚の参照画像を渡せば、それらを組み合わせ、キャラクターや製品をショット間で一貫させます。領域はマスクや描いた円で指せます。局所的な編集に別のインペインティング用チェックポイントは要りません。同じモデルが領域をヒントとして受け取ります。
透明画像の出力。透明な背景の RGBA 画像を求めると、切り抜きではなく本物のアルファチャンネルを生成します。VAE が三つではなく四つのピクセルチャンネルをエンコード・デコードするからです。ロゴ、ステッカー、レイヤー素材が、そのまま置ける形で出てきます。
プロンプトの書き換え。Qwen は、短いプロンプトを生成器が好む詳細な形に展開する補助モデルを二つ出しています。Qwen3.5-VL 9B のファインチューンで、生成用と編集用です。ComfyUI のテンプレートではオプションとして用意され、既定ではオフです。必須ではありません。
速度。16 GB の民生用カードでは、int8 ウェイトで 1 メガピクセルの画像に約40秒、4 メガピクセルには、設定ガイドの画質設定で四〜五分かかります。2026年10月9日に公開された蒸留版の Turbo チェックポイントは 8 ステップで描き、4 メガピクセルで約七倍速くなります。代償は技法です。素描、刺繍、切り絵が写真の方へ寄ります。
Qwen-Image と Stable Diffusion の違い:仕組み
Qwen-Image 2.1 は拡散モデルなので、Stable Diffusion のガイドで説明した仕組みがそのまま当てはまります。テキストエンコーダがプロンプトを読みます。ノイズ除去器が、圧縮された潜在表現に対して何ステップか作業します。デコーダが潜在表現をピクセルに戻します。違うのは、この三つの部品それぞれで選ばれたものです。以下の事実はモデルのリポジトリによります。Qwen は 2.1 の技術報告を公開していません。
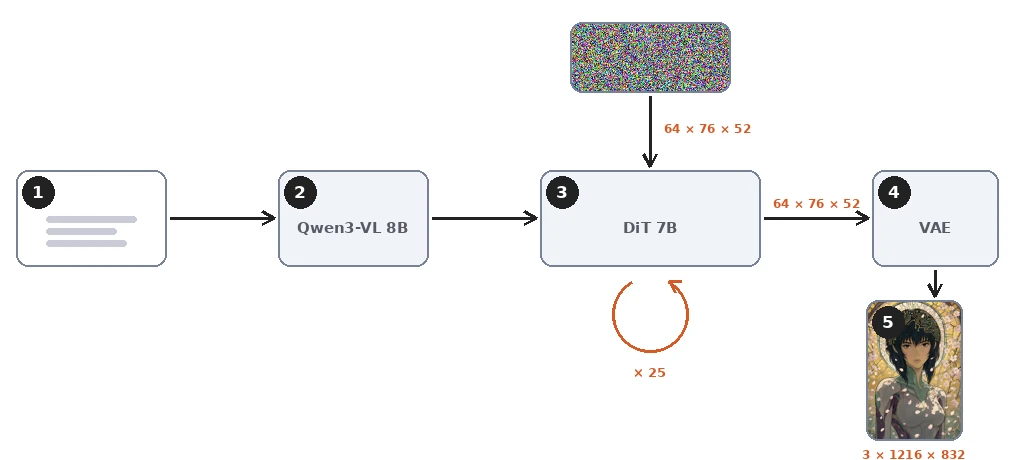
CLIP の代わりに視覚言語モデル
Stable Diffusion 1.5 と SDXL は、短いキャプションと画像を対応づけるよう訓練されたネットワーク、CLIP でプロンプトを読みます。Qwen-Image 2.1 は Qwen3-VL 8B で読みます。本格的な視覚言語モデルで、パラメータ数は画像生成部そのものより多いです。編集では同じエンコーダが参照画像も読みます。設定ガイドのプロンプトの型が効くのはそのためです。文、前置詞、引用符の中の文字、レイアウトの指示は、言語モデルがまさに解析するために作られたものです。CLIP エンコーダはそれらを概念の寄せ集めに押しつぶしがちです。
U-Net の代わりにシングルストリームのトランスフォーマー
ノイズ除去器は 32 層、7B パラメータの拡散トランスフォーマーです。SDXL は U-Net、つまり畳み込みブロックの間にアテンション層を挟んだ構造を使います。Stable Diffusion 3 もトランスフォーマー MMDiT に移りましたが、そこではテキストのトークンと画像のトークンが別々の重みを持つ二つのストリームを進み、各層のアテンションでだけ出会います。Qwen-Image 2.1 はもう一歩進めます。テキストと画像のトークンが一つの列になり、同じ重みを通ります。「シングルストリーム」とはそういう意味です。2025年の最初の Qwen-Image は 20B パラメータのダブルストリーム MMDiT でした。2.1 はそのおよそ三分の一の大きさです。
そのアテンションには、実用上重要な点が二つあります。テキストのトークンは言語モデルと同じく因果的に読まれます。そして参照画像でも生成画像でも、各画像はトークン同士がすべて互いを見る一つのブロックです。順序はプロンプト、参照画像、生成画像の順で、トークンは自分より後ろを決して見ません。つまりプロンプトと参照画像は生成中の画像を見ることがなく、それらに属する計算の部分、プレフィックスは、どのステップでも同一です。一度だけ計算され、ノイズ除去のステップをまたいでキャッシュされます。ComfyUI の QwenImage21Cache ノードが選ぶのは、そのキャッシュをどこに、どの精度で置くか、あるいはまったく使わないか、だけです。
十六倍に圧縮された 64 チャンネルの潜在表現
Stable Diffusion の VAE は、画像を各辺八分の一に縮めて 4 チャンネルにします。バージョン 3 では 16 チャンネルです。Qwen-Image 2.1 の VAE は各辺十六分の一に縮めて 64 チャンネルにします。さらに、赤、緑、青にアルファを加えた四つのピクセルチャンネルをエンコード・デコードします。同じ 64 チャンネルの潜在表現から本物の RGBA 画像を出せるのはそのためです。832 × 1216 の画像なら、潜在表現は 52 × 76 の 64 チャンネルで、約 253,000 個の数値です。ピクセル値は 3 チャンネルで約 300 万個ありますから、十二分の一です。
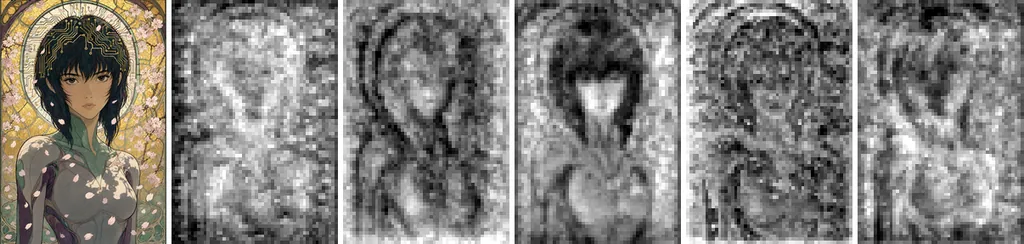
潜在表現の各位置がトランスフォーマーの一トークンなので、1 メガピクセルの画像は 3,952 トークン、4 メガピクセルなら 15,808 トークンです。このグリッドは、Stable Diffusion 3 や最初の Qwen-Image より粗いわけではありません。それらは 8 倍圧縮の潜在表現を、トランスフォーマーの前に 2 × 2 のパッチにまとめます。2.1 が変えたのは、そのまとめを VAE 自身が 64 チャンネルで行う点です。アテンションの計算量はトークン数の二乗で増えるため、4 メガピクセルのコストは 1 メガピクセルの四倍をはるかに超えます。
ノイズ予測の代わりにフローマッチング
Stable Diffusion 1.5 と SDXL は、画像に加えられたノイズを予測するよう訓練されました。Qwen-Image は Stable Diffusion 3 や FLUX と同じく、フローマッチングで訓練されています。ネットワークは、ノイズの乗った潜在表現からきれいな潜在表現へ向かう方向を、直線に沿って予測します。サンプラーはその方向にオイラー法のステップで進みます。リポジトリはそのスケジューラーを、オイラー離散ステップと動的シフトを使うフローマッチングと記しています。最初の Qwen-Image の報告は目的関数を直線経路に沿った速度ターゲットとして説明しており、2.1 のスケジューラーからすると、それは変わっていないと考えられます。
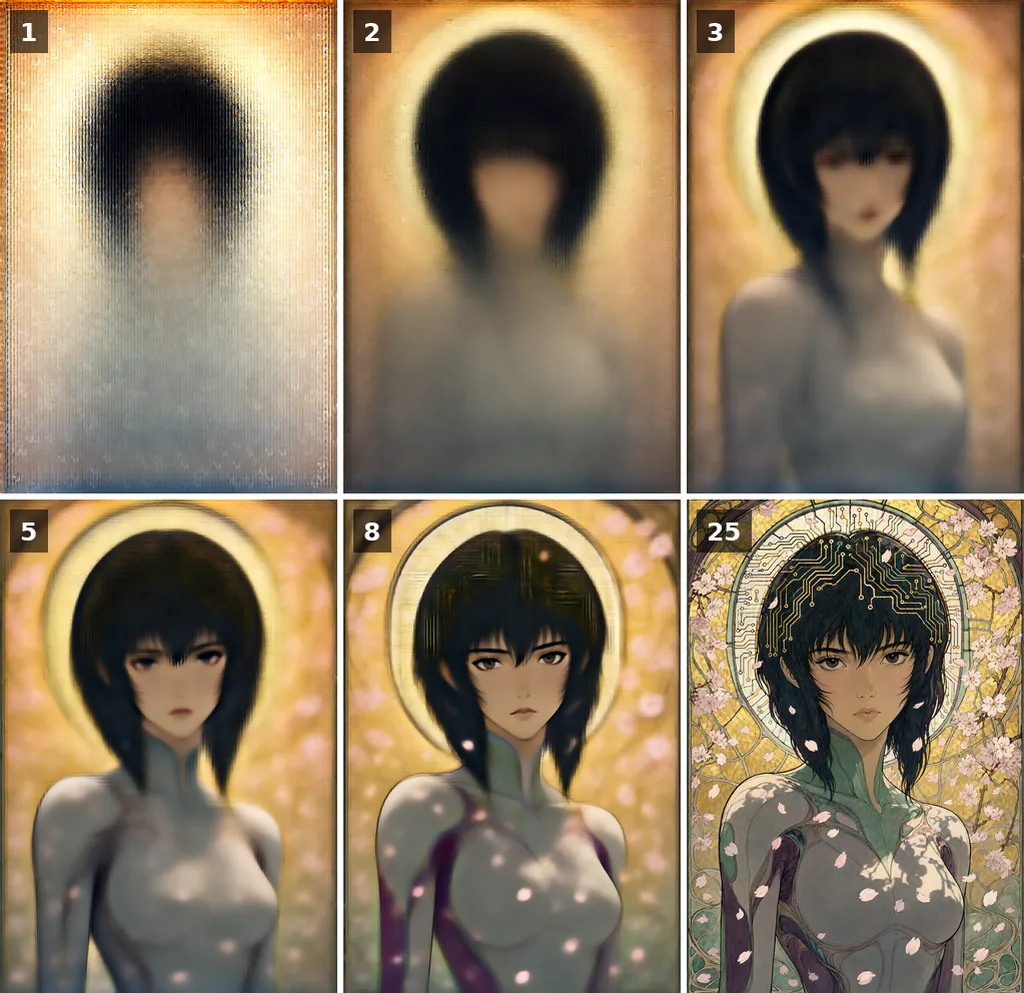
下の図は、生成の途中でモデルが推定する完成画像がどう見えるかを示します。構図は最初の数ステップで決まり、細部は後から来ます。この粗から密への順序はすべての拡散モデルに共通で、フローマッチングが主に変えるのはステップの間隔です。動的シフトが調整するのはそこです。
並べて比較
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| テキストエンコーダ | CLIP ViT-L と OpenCLIP bigG | CLIP エンコーダ二つと T5-XXL | Qwen3-VL 8B、視覚言語モデル |
| ノイズ除去器 | U-Net、2.6B パラメータ | ダブルストリーム MMDiT、8B | シングルストリーム拡散トランスフォーマー、7B、32 層 |
| 潜在表現 | 4 チャンネル、8 倍圧縮 | 16 チャンネル、8 倍 | 64 チャンネル、16 倍、アルファ付き |
| 訓練の目的 | ノイズ予測 | フローマッチング(rectified flow) | フローマッチング(rectified flow) |
| ネイティブサイズ | 1024 px | 1024 px | 2048 px |
| 編集 | サードパーティのインペインティングモデル | 公式の編集モデルなし、ControlNet のみ | 同じチェックポイント、最大 10 枚の参照画像 |
| ライセンス | OpenRAIL++-M | Community License | Qwen Research License |
どれも、モデルの操作方法を変えるものではありません。ガイダンス、ステップ、シード、サイズは他の拡散モデルと同じように振る舞います。違うのは最も効く数値だけで、それを設定ガイドが計測しています。
バージョン:Qwen-Image から 2.1 まで
番号が紛らわしいのは、公開の経路ではなくアーキテクチャに従っているからです。2026年2月に発表され、ウェイトとしては一度も公開されなかった Qwen-Image 2.0 が、2.1 が今オープンに出している軽量設計を導入しました。2026年7月に発表された Qwen-Image 3.0 は、より大きなフラッグシップで、アリババの API 経由でのみ提供されます。Qwen はこの体系を説明していません。下の日付はプロジェクトのリポジトリから、3.0 については Qwen の発表から取りました。
| リリース | 日付 | 内容 | ウェイト |
|---|---|---|---|
| Qwen-Image | 2025年8月4日 | Qwen2.5-VL 7B エンコーダ付きの 20B パラメータのダブルストリーム MMDiT。テキストから画像 | 公開、Apache 2.0 |
| Qwen-Image-Edit、続いて Edit-2509 と Edit-2511 | 2025年8月〜12月 | 同じベースの編集モデル。2509 から複数の参照画像に対応。12月にはレイヤー付き RGBA モデル Qwen-Image-Layered | 公開、Apache 2.0 |
| Qwen-Image-2512 | 2025年12月31日 | 20B 系統の最後の text-to-image リリース | 公開、Apache 2.0 |
| Qwen-Image 2.0 | 2026年2月10日 | 2.1 が受け継ぐ設計。Qwen3-VL エンコーダ、64 チャンネルの VAE、ネイティブ 2K、最大 1,000 トークンの指示。技術報告は 2026年5月 | 未公開 |
| Qwen-Image 3.0 | 2026年7月21日 | アリババの API の背後にあるフラッグシップ。最大 4,500 トークンのプロンプト、インフォグラフィックと絵コンテを一度で描画 | API のみ |
| Qwen-Image 2.1 | 2026年9月20日 | Qwen3-VL 8B エンコーダ付きの 7B パラメータのシングルストリームトランスフォーマー。生成と編集を一つのチェックポイントで、RGBA、2K | 公開、Qwen Research License |
| Qwen-Image 2.1 Turbo | 2026年10月9日 | 2.1 の蒸留版、8 ステップ | 公開、Qwen Research License |
つまりダウンロードページで番号のない「Qwen-Image」は 2025年の 20B モデルで、2512 と Edit の更新版とともに今も入手できます。現在のオープンモデルは 2.1 で、3.0 はアリババの有料サービスの背後にあるモデルです。2.1 と 3.0 は系譜を共有しますが、ウェイトは共有しません。
Qwen-Image のライセンス:オープンウェイト、ただし研究のみ
最初の Qwen-Image とその編集モデルは Apache 2.0 でした。商用利用を含め、何にでも自由に使えます。Qwen-Image 2.1 とその Turbo は Qwen Research License Agreement の下にあります。ウェイトはダウンロードし、研究し、実行し、ファインチューンできますが、研究と評価に限られます。商用利用には Qwen から別途ライセンスを得る必要があります。
これで 2.1 は Stable Diffusion とは違う位置に置かれます。Stable Diffusion の 1.5 と SDXL のライセンスは、禁止用途のリスト付きで商用利用を認めます。3.5 のライセンスは年間収益が百万ドル未満なら認めます。FLUX 3 Klein も五百万ドル未満なら商用利用が無料です。学生や研究室にとっては何も変わりません。スタジオにとって残る道は、有料 API か、Qwen に申請する商用ライセンスです。
Qwen-Image を試す、そしてその先へ
いちばん手軽なのは、このサイトの無料の Qwen-Image 2.1 ページです。アカウント不要で、生成も参照画像付きの編集もでき、待ち行列がリアルタイムで表示されます。
自宅で動かすなら、ComfyUI がこのモデルにネイティブ対応しています。Comfy-Org の再パッケージ版から三つのファイルを、いつものフォルダに入れます。拡散モデル、Qwen3-VL テキストエンコーダ、VAE で、16 GB のカード向けには int8 版です。設定ガイドでは、グラフ、プロンプトの型、ガイダンス、まさにそのカードで計測したサイズ、さらに Turbo とガイド付き Turbo を扱っています。
これらのモデルすべてに共通する原理、ノイズ、潜在空間、ガイダンス、シードについては、Stable Diffusion とは?を読んでください。説明はそのまま当てはまり、変わるのは数字だけです。