Hvad er Qwen-Image, kort fortalt
Qwen-Image er billedgenereringslinjen i Qwen, modelfamilien fra Alibabas cloud-division. Den udkom i august 2025 som en model med 20 milliarder parametre under Apache 2.0-licensen, med en teknisk rapport. Den skilte sig ud på sin tekst. Afsnit, skilte og etiketter kom læseligt ud, på engelsk og især på kinesisk, hvor Stable Diffusion 1.5 og SDXL lavede kruseduller, og modellerne fra 2024 i bedste fald klarede et par engelske ord.
Den aktuelle åbne udgave er Qwen-Image 2.1, udgivet den 20. september 2026. Det er en mindre og hurtigere model: 7 milliarder parametre til billedgeneratoren plus en vision-language-encoder på 8 milliarder parametre. Ét checkpoint klarer to opgaver. Den genererer et billede ud fra tekst, og den redigerer et eksisterende billede ud fra en sætning og op til ti referencebilleder. Den leverer native 2K og ægte gennemsigtige billeder. Licensen er ikke længere Apache: kun forskning og evaluering.
Ligesom Stable Diffusion og FLUX er den en diffusionsmodel, der kører i ComfyUI på et almindeligt grafikkort, og den læser samme slags prompt. Forskellen sidder indeni, og det er den, afsnittet om, hvordan den virker, forklarer.
Hvad Qwen-Image 2.1 kan
Tekst-til-billede i native 2K. Modellen gengiver kvadrater på 2048 × 2048, 2528 × 1696 i 3:2 og 2752 × 1536 i 16:9 direkte, uden opskalering. Den læser prompten som en tekst, så sætninger, forholdsord og layoutanvisninger virker, og ord i anførselstegn kommer ud, som de er skrevet: “a banner above the door reads ‘OPEN ALL NIGHT’” kommer ud præcis sådan i testprompterne fra guiden til indstillingerne. Guiden til indstillingerne giver den promptform, der virker bedst, og de målte indstillinger.
Redigering med samme checkpoint. Giv den et billede og en sætning, og den ændrer billedet: udskift et objekt, giv en scene en ny stil, tilføj tekst. Giv den op til ti referencebilleder, og den sætter dem sammen og holder en figur eller et produkt ens fra billede til billede. Områder kan udpeges med en maske eller en tegnet cirkel. Lokale rettelser kræver ikke et separat inpainting-checkpoint: samme model tager området som et hint.
Gennemsigtigt output. Bed om et RGBA-billede med gennemsigtig baggrund, og modellen laver en ægte alfakanal, ikke en fritlægning: VAE'en koder og afkoder fire pixelkanaler i stedet for tre. Logoer, stickers og assets i lag kommer ud klar til at blive placeret.
Omskrivning af prompten. Qwen leverer to hjælpemodeller med, finjusteringer af Qwen3.5-VL 9B, som folder en kort prompt ud til den detaljerede form, generatoren foretrækker, én til generering og én til redigering. ComfyUI tilbyder dem som en mulighed i sine skabeloner, slået fra som standard; de er ikke nødvendige.
Hastighed. På et almindeligt kort med 16 GB tager int8-vægtene cirka 40 sekunder om et billede på 1 megapixel og fire til fem minutter om 4 megapixel med kvalitetsindstillingerne fra guiden til indstillingerne. Et destilleret Turbo-checkpoint, udgivet den 9. oktober 2026, gengiver i 8 steps, cirka syv gange hurtigere ved 4 megapixel, på bekostning af mediet: tegninger, broderi og papirklip driver mod fotografier.
Qwen-Image vs Stable Diffusion: hvordan den virker
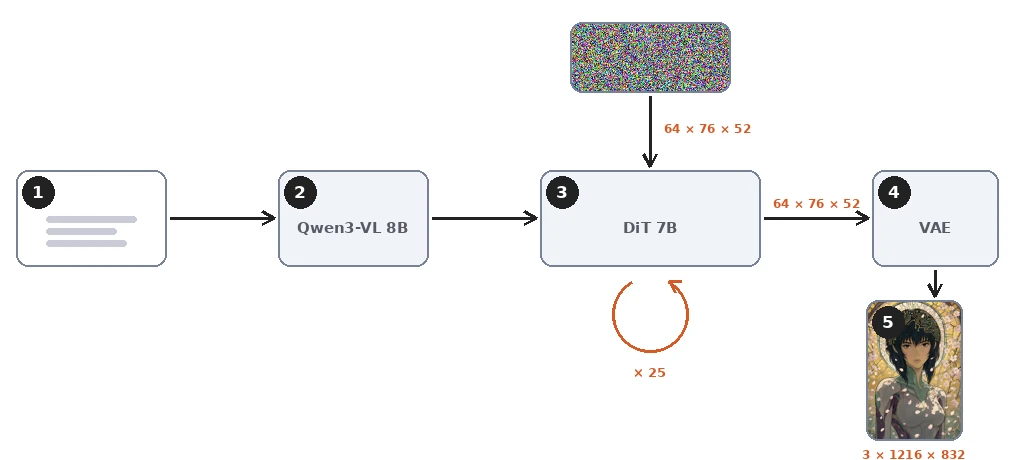
Qwen-Image 2.1 er en diffusionsmodel, så mekanikken fra guiden til Stable Diffusion gælder også her. En tekst-encoder læser prompten. En denoiser arbejder på en komprimeret latent over et antal steps. En decoder laver latenten om til pixels. Det, der er anderledes, er valget for hver af de tre dele. Modellens repository giver fakta nedenfor; Qwen har ikke udgivet en teknisk rapport om 2.1.
En vision-language-model i stedet for CLIP
Stable Diffusion 1.5 og SDXL læser prompten med CLIP, et netværk trænet til at matche korte billedtekster med billeder. Qwen-Image 2.1 læser den med Qwen3-VL 8B, en fuld vision-language-model med otte milliarder parametre, flere end selve billedgeneratoren. Samme encoder læser referencebillederne ved redigering. Det er derfor, promptformen fra guiden til indstillingerne virker. Sætninger, forholdsord, tekst i anførselstegn og layoutanvisninger er præcis det, en sprogmodel er bygget til at forstå. En CLIP-encoder har en tendens til at klemme dem sammen til en løs samling af begreber.
En single-stream transformer i stedet for et U-Net
Denoiseren er en diffusion transformer med 32 lag og 7 milliarder parametre. SDXL bruger et U-Net, foldningsblokke med attention-lag imellem. Stable Diffusion 3 gik også over til en transformer, MMDiT, hvor tekst- og billedtokens løber i to strømme med hver deres vægte og kun mødes i attention i hvert lag. Qwen-Image 2.1 går et skridt videre: tekst- og billedtokens udgør én sekvens og går gennem de samme vægte, og det er det, "single-stream" betyder. Den første Qwen-Image fra 2025 var en double-stream MMDiT med 20 milliarder parametre; 2.1 er cirka en tredjedel af den størrelse.
To detaljer i dens attention betyder noget i praksis. Teksttokens læses kausalt, som i en sprogmodel, og hvert billede, reference eller genereret, er én blok, hvor alle tokens ser hinanden. Rækkefølgen er prompten først, referencebillederne dernæst, det genererede billede sidst, og et token kigger aldrig på det, der kommer efter det. Prompten og referencebillederne ser altså aldrig det billede, der er ved at blive genereret, og den del af beregningen, der hører til dem, præfikset, er identisk i hvert step: den beregnes én gang og caches på tværs af denoising-steps. ComfyUI's QwenImage21Cache-node vælger kun, hvor den cache ligger, i hvilken præcision, eller om den overhovedet bruges.
En latent med 64 kanaler, komprimeret seksten gange
Stable Diffusions VAE skrumper et billede med en faktor otte på hver led ned til 4 kanaler, 16 i version 3. Qwen-Image 2.1's VAE skrumper det med seksten på hver led, ned til 64 kanaler. Den koder og afkoder også fire pixelkanaler, rød, grøn, blå og alfa, i stedet for tre, og det er sådan, modellen leverer ægte RGBA-billeder fra den samme latent med 64 kanaler. For et billede på 832 × 1216 måler latenten 64 kanaler på 52 × 76: cirka 253.000 tal for 3 millioner pixelværdier, tolv gange færre.
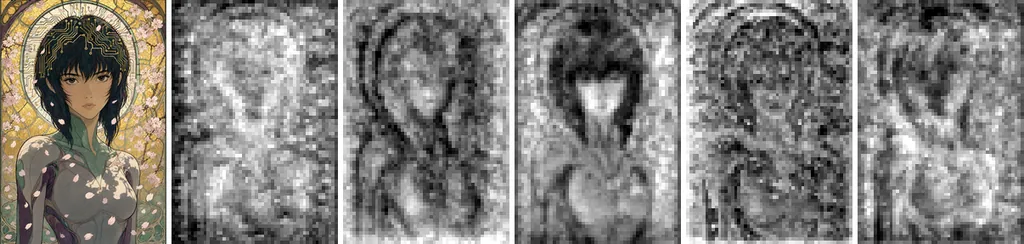
Hver position i latenten er ét token for transformeren, så et billede på 1 megapixel er 3.952 tokens og et på 4 megapixel 15.808. Det gitter er ikke grovere end det i Stable Diffusion 3 eller i den første Qwen-Image, som samler deres 8-dobbelt komprimerede latent i patches på 2 × 2 før transformeren. Det, 2.1 ændrer, er, at VAE'en selv laver den samling, i 64 kanaler. Prisen for attention vokser med kvadratet på antallet af tokens, og det er derfor, 4 megapixel koster langt mere end fire gange 1 megapixel.
Flow matching i stedet for støjforudsigelse
Stable Diffusion 1.5 og SDXL blev trænet til at forudsige den støj, der var lagt på et billede. Qwen-Image er, ligesom Stable Diffusion 3 og FLUX, trænet med flow matching. Netværket forudsiger retningen fra den støjfyldte latent mod den rene, langs en lige linje. Sampleren følger så den retning med Euler-steps. Repositoryet nævner den scheduler: flow matching med diskrete Euler-steps og et dynamisk shift. Den første Qwen-Image-rapport beskriver træningsmålet, et hastighedsmål langs lige baner, og 2.1's scheduler tyder på, at det er uændret.
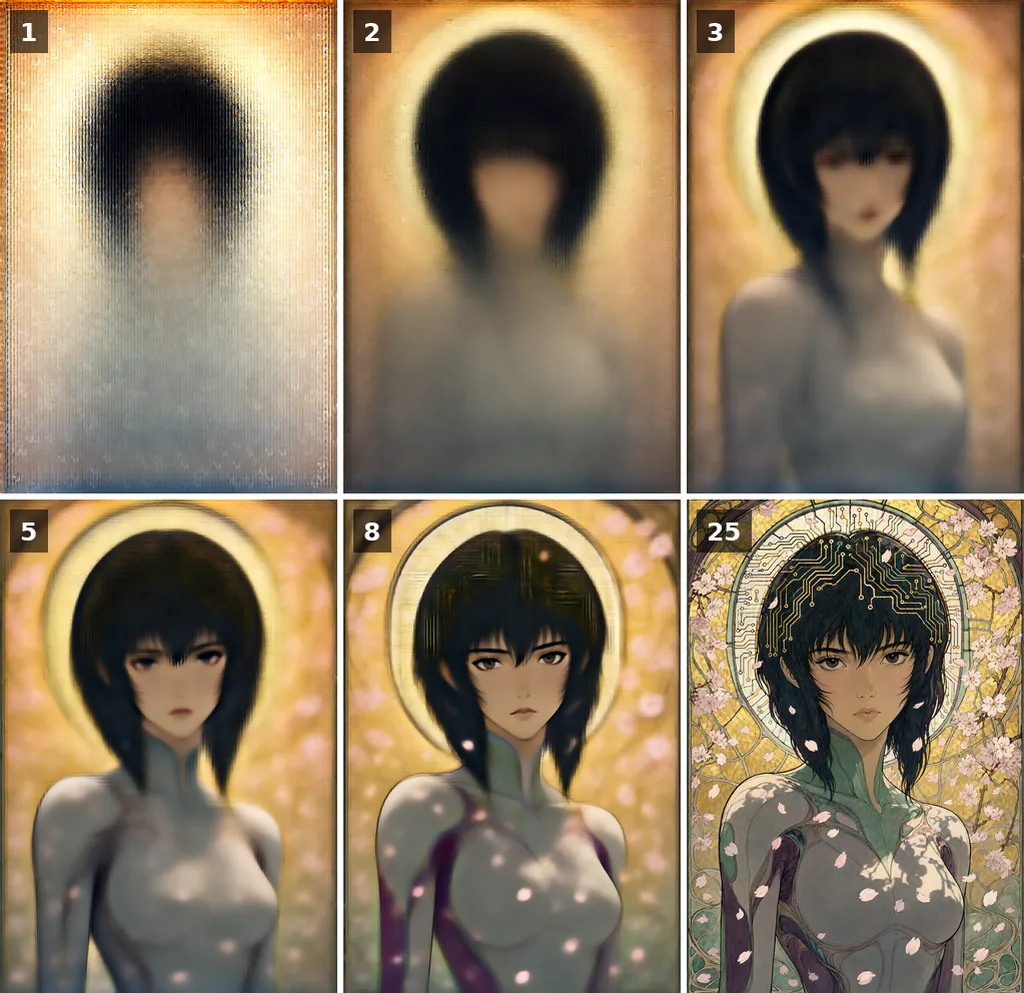
Figuren nedenfor viser, hvordan modellens bud på det færdige billede ser ud undervejs. Kompositionen ligger fast i de første steps, og detaljerne kommer senere. Den rækkefølge fra groft til fint er fælles for alle diffusionsmodeller; flow matching ændrer først og fremmest, hvordan de enkelte steps er fordelt, og det er det, det dynamiske shift justerer.
Side om side
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Tekst-encoder | CLIP ViT-L og OpenCLIP bigG | To CLIP-encodere og T5-XXL | Qwen3-VL 8B, en vision-language-model |
| Denoiser | U-Net, 2,6 milliarder parametre | Double-stream MMDiT, 8 milliarder | Single-stream diffusion transformer, 7 milliarder, 32 lag |
| Latent | 4 kanaler, 8× komprimering | 16 kanaler, 8× | 64 kanaler, 16×, med alfa |
| Træningsmål | Støjforudsigelse | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Native størrelse | 1024 px | 1024 px | 2048 px |
| Redigering | Inpainting-model fra tredjepart | Ingen officiel redigeringsmodel, kun ControlNets | Samme checkpoint, op til 10 referencebilleder |
| Licens | OpenRAIL++-M | Community License | Qwen Research License |
Intet af det ændrer, hvordan modellen styres. Guidance, steps, seed og størrelse opfører sig som i enhver diffusionsmodel; kun de tal, der virker bedst, er anderledes, og guiden til indstillingerne måler dem.
Versionerne, fra Qwen-Image til 2.1
Nummereringen er forvirrende, fordi den følger arkitekturen, ikke udgivelseskanalen. Qwen-Image 2.0, annonceret i februar 2026 og aldrig udgivet som vægte, indførte det lettere design, som 2.1 nu leverer åbent. Qwen-Image 3.0, annonceret i juli 2026, er et større flagskib, der kun udbydes gennem Alibabas API. Qwen har ikke forklaret systemet; datoerne nedenfor kommer fra projektets repositories og, for 3.0, fra Qwens annoncering.
| Udgivelse | Dato | Hvad den er | Vægte |
|---|---|---|---|
| Qwen-Image | 4. august 2025 | Double-stream MMDiT med 20 milliarder parametre og en Qwen2.5-VL 7B-encoder; tekst-til-billede | Åbne, Apache 2.0 |
| Qwen-Image-Edit, dernæst Edit-2509 og Edit-2511 | August til december 2025 | Redigeringsmodeller på samme basis; flere referencebilleder fra 2509; en RGBA-model i lag, Qwen-Image-Layered, i december | Åbne, Apache 2.0 |
| Qwen-Image-2512 | 31. december 2025 | Sidste tekst-til-billede-udgivelse i linjen på 20 milliarder | Åbne, Apache 2.0 |
| Qwen-Image 2.0 | 10. februar 2026 | Det design, 2.1 arver: Qwen3-VL-encoder, VAE med 64 kanaler, native 2K, instruktioner på op til 1.000 tokens; teknisk rapport i maj 2026 | Ikke udgivet |
| Qwen-Image 3.0 | 21. juli 2026 | Flagskib bag Alibabas API: prompts på op til 4.500 tokens, infografikker og storyboards gengivet i én omgang | Kun API |
| Qwen-Image 2.1 | 20. september 2026 | Single-stream transformer med 7 milliarder parametre og en Qwen3-VL 8B-encoder; generering og redigering i ét checkpoint, RGBA, 2K | Åbne, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9. oktober 2026 | Destilleret 2.1, 8 steps | Åbne, Qwen Research License |
På en downloadside er "Qwen-Image" uden nummer altså modellen på 20 milliarder fra 2025, stadig tilgængelig med sine 2512- og Edit-opdateringer. Den aktuelle åbne model er 2.1, og 3.0 er modellen bag Alibabas betalte tjeneste. 2.1 og 3.0 deler en afstamning, men ikke deres vægte.
Qwen-Image-licensen: åbne vægte, kun til forskning
Den første Qwen-Image og dens redigeringsmodeller var Apache 2.0: fri til alt, kommerciel brug inklusive. Qwen-Image 2.1 og dens Turbo er under Qwen Research License Agreement. Vægtene må hentes, studeres, køres og finjusteres, men kun til forskning og evaluering. Enhver kommerciel brug kræver en særskilt licens fra Qwen.
Det placerer 2.1 et andet sted end Stable Diffusion, hvis licenser til 1.5 og SDXL tillader kommerciel brug med en liste over forbudte anvendelser, og hvis 3.5-licens tillader den under en million dollars i årlig omsætning, og end FLUX 3 Klein, fri til kommerciel brug under fem millioner. For en studerende eller et laboratorium ændrer intet sig. For et studie er den betalte API eller en kommerciel licens søgt hos Qwen de veje, der står åbne.
Prøv Qwen-Image, og kom videre
Den hurtigste vej er den gratis Qwen-Image 2.1-side på dette site: ingen konto, generering og redigering med referencebilleder, og køen vises live.
Vil du køre den derhjemme, understøtter ComfyUI modellen native. Tre filer fra Comfy-Orgs ompakning skal i de sædvanlige mapper: diffusionsmodellen, Qwen3-VL-tekst-encoderen og VAE'en, i int8-udgaver til et kort med 16 GB. Guiden til indstillingerne dækker grafen, promptformen, guidance og de størrelser, der er målt på præcis det kort, plus Turbo og Turbo med guidance.
For de principper, alle disse modeller deler, støj, latent rum, guidance og seed, så læs Hvad er Stable Diffusion?; forklaringerne gælder stadig, kun tallene ændrer sig.