Qué es Qwen-Image, en pocas palabras
Qwen-Image es la línea de generación de imágenes de Qwen, la familia de modelos de la división de nube de Alibaba. Llegó en agosto de 2025 como un modelo de 20 mil millones de parámetros bajo licencia Apache 2.0, con un informe técnico. Destacó por el texto. Los párrafos, los rótulos y las etiquetas salían legibles, en inglés y sobre todo en chino, donde Stable Diffusion 1.5 y SDXL producían garabatos y los modelos de 2024 lograban, como mucho, unas pocas palabras en inglés.
La versión abierta actual es Qwen-Image 2.1, publicada el 20 de septiembre de 2026. Es un modelo más pequeño y más rápido: 7 mil millones de parámetros para el generador de imágenes, más un codificador de visión y lenguaje de 8 mil millones. Un solo checkpoint hace dos trabajos. Genera una imagen a partir de un texto, y edita una imagen existente a partir de una frase y hasta diez imágenes de referencia. Produce 2K nativo e imágenes transparentes de verdad. Su licencia ya no es Apache: solo investigación y evaluación.
Como Stable Diffusion y FLUX, es un modelo de difusión que funciona en ComfyUI con una tarjeta gráfica de consumo, y lee el mismo tipo de prompt. La diferencia está por dentro, y eso es lo que explica la sección sobre cómo funciona.
Qué puede hacer Qwen-Image 2.1
Texto a imagen en 2K nativo. El modelo renderiza directamente cuadrados de 2048 × 2048, 2528 × 1696 en 3:2 y 2752 × 1536 en 16:9, sin escalado. Lee el prompt como un texto, así que las frases, las preposiciones y las instrucciones de composición funcionan, y las palabras entrecomilladas aparecen tal cual: “a banner above the door reads ‘OPEN ALL NIGHT’” sale escrito letra por letra en los prompts de prueba de la guía de ajustes. La guía de ajustes da la estructura de prompt que mejor funciona y los ajustes medidos.
Edición con el mismo checkpoint. Dale una imagen y una frase y el modelo la cambia: sustituir un objeto, cambiar el estilo de una escena, añadir texto. Dale hasta diez imágenes de referencia y las compone, manteniendo un personaje o un producto coherente entre tomas. Las regiones se pueden señalar con una máscara o un círculo dibujado. No hace falta un checkpoint de inpainting aparte para los retoques locales: el mismo modelo toma la región como pista.
Salida transparente. Pide una imagen RGBA con fondo transparente y el modelo produce un canal alfa real, no un recorte: el VAE codifica y decodifica cuatro canales de píxel en lugar de tres. Logotipos, pegatinas y recursos por capas salen listos para colocar.
Reescritura del prompt. Qwen distribuye dos modelos complementarios, fine-tunes de Qwen3.5-VL 9B, que expanden un prompt corto a la forma detallada que prefiere el generador, uno para generar y otro para editar. ComfyUI los ofrece como opción en sus plantillas, desactivados por defecto; no son necesarios.
Velocidad. En una tarjeta de consumo de 16 GB, los pesos int8 tardan unos 40 segundos en una imagen de 1 megapíxel y de cuatro a cinco minutos en 4 megapíxeles con los ajustes de calidad de la guía de ajustes. Un checkpoint destilado, Turbo, publicado el 9 de octubre de 2026, renderiza en 8 pasos, unas siete veces más rápido a 4 megapíxeles, a costa del medio: dibujos, bordados y papel recortado derivan hacia la fotografía.
Qwen-Image vs Stable Diffusion: cómo funciona
Qwen-Image 2.1 es un modelo de difusión, así que la mecánica explicada en la guía de Stable Diffusion se aplica. Un codificador de texto lee el prompt. Un eliminador de ruido trabaja sobre un latente comprimido durante un número de pasos. Un decodificador convierte el latente en píxeles. Lo que cambia es la elección hecha para cada una de las tres partes. El repositorio del modelo da los datos de abajo; Qwen no ha publicado un informe técnico de la 2.1.
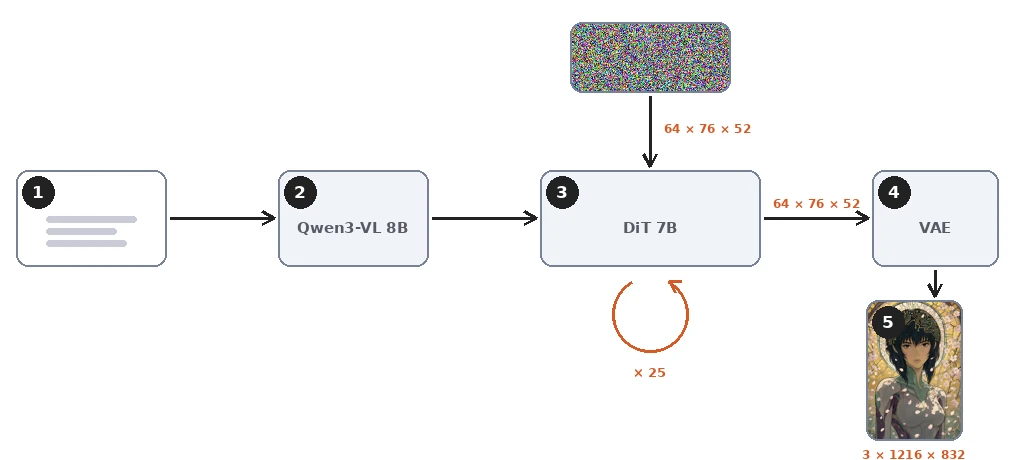
Un modelo de visión y lenguaje en lugar de CLIP
Stable Diffusion 1.5 y SDXL leen el prompt con CLIP, una red entrenada para emparejar descripciones cortas con imágenes. Qwen-Image 2.1 lo lee con Qwen3-VL 8B, un modelo completo de visión y lenguaje con ocho mil millones de parámetros, más que el propio generador de imágenes. El mismo codificador lee las imágenes de referencia al editar. Por eso funciona la estructura de prompt de la guía de ajustes. Frases, preposiciones, texto entrecomillado e instrucciones de composición son justo lo que un modelo de lenguaje está hecho para analizar. Un codificador CLIP tiende a aplanarlas en una bolsa de conceptos.
Un transformador de flujo único en lugar de una U-Net
El eliminador de ruido es un transformador de difusión de 32 capas y 7 mil millones de parámetros. SDXL usa una U-Net, bloques de convolución con capas de atención entre ellos. Stable Diffusion 3 también pasó a un transformador, el MMDiT, en el que los tokens de texto y de imagen viajan en dos flujos con pesos separados y solo se encuentran en la atención de cada capa. Qwen-Image 2.1 va un paso más allá: los tokens de texto y de imagen forman una sola secuencia y pasan por los mismos pesos, que es lo que significa «flujo único» (single-stream). El primer Qwen-Image de 2025 era un MMDiT de doble flujo con 20 mil millones de parámetros; la 2.1 tiene cerca de un tercio de ese tamaño.
Dos detalles de su atención importan en la práctica. Los tokens de texto se leen de forma causal, como en un modelo de lenguaje, y cada imagen, de referencia o generada, es un bloque cuyos tokens se ven todos entre sí. El orden es primero el prompt, después las imágenes de referencia, al final la imagen generada, y un token nunca mira lo que viene después. Así que el prompt y las imágenes de referencia nunca ven la imagen que se está generando, y la parte del cálculo que les corresponde, el prefijo, es idéntica en cada paso: se calcula una vez y se guarda en caché durante los pasos de eliminación de ruido. El nodo QwenImage21Cache de ComfyUI solo elige dónde vive esa caché, con qué precisión, o si se usa.
Un latente de 64 canales, comprimido dieciséis veces
El VAE de Stable Diffusion reduce una imagen por un factor de ocho en cada lado en 4 canales, 16 en la versión 3. El VAE de Qwen-Image 2.1 la reduce dieciséis veces en cada lado, en 64 canales. También codifica y decodifica cuatro canales de píxel, rojo, verde, azul y alfa, en lugar de tres, y así es como el modelo produce imágenes RGBA reales desde el mismo latente de 64 canales. Para una imagen de 832 × 1216 el latente mide 64 canales de 52 × 76: unos 253.000 números para 3 millones de valores de píxel, doce veces menos.
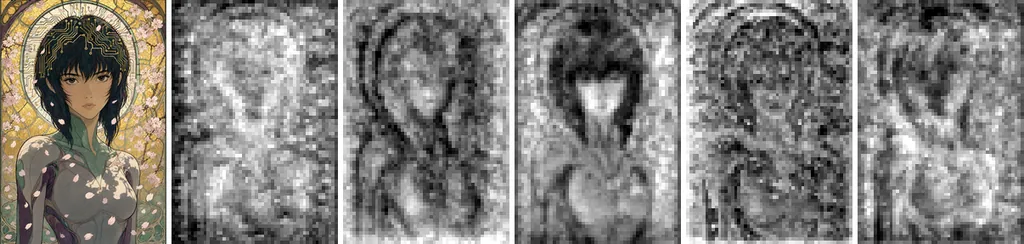
Cada posición del latente es un token para el transformador, así que una imagen de 1 megapíxel son 3.952 tokens y una de 4 megapíxeles, 15.808. Esa cuadrícula no es más gruesa que la de Stable Diffusion 3 o la del primer Qwen-Image, que agrupan su latente comprimido 8 veces en parches de 2 × 2 antes del transformador. Lo que cambia la 2.1 es que el VAE hace ese agrupamiento él mismo, en 64 canales. El coste de la atención crece con el cuadrado del número de tokens, y por eso 4 megapíxeles cuestan mucho más que cuatro veces 1 megapíxel.
Flow matching en lugar de predicción de ruido
Stable Diffusion 1.5 y SDXL se entrenaron para predecir el ruido añadido a una imagen. Qwen-Image, como Stable Diffusion 3 y FLUX, se entrena con flow matching. La red predice la dirección que va del latente con ruido al latente limpio, en línea recta. El sampler sigue después esa dirección con pasos de Euler. El repositorio nombra ese scheduler: flow matching con pasos discretos de Euler y un shift dinámico. El informe del primer Qwen-Image describe el objetivo de entrenamiento, una velocidad a lo largo de trayectorias rectas, y el scheduler de la 2.1 da a entender que no ha cambiado.
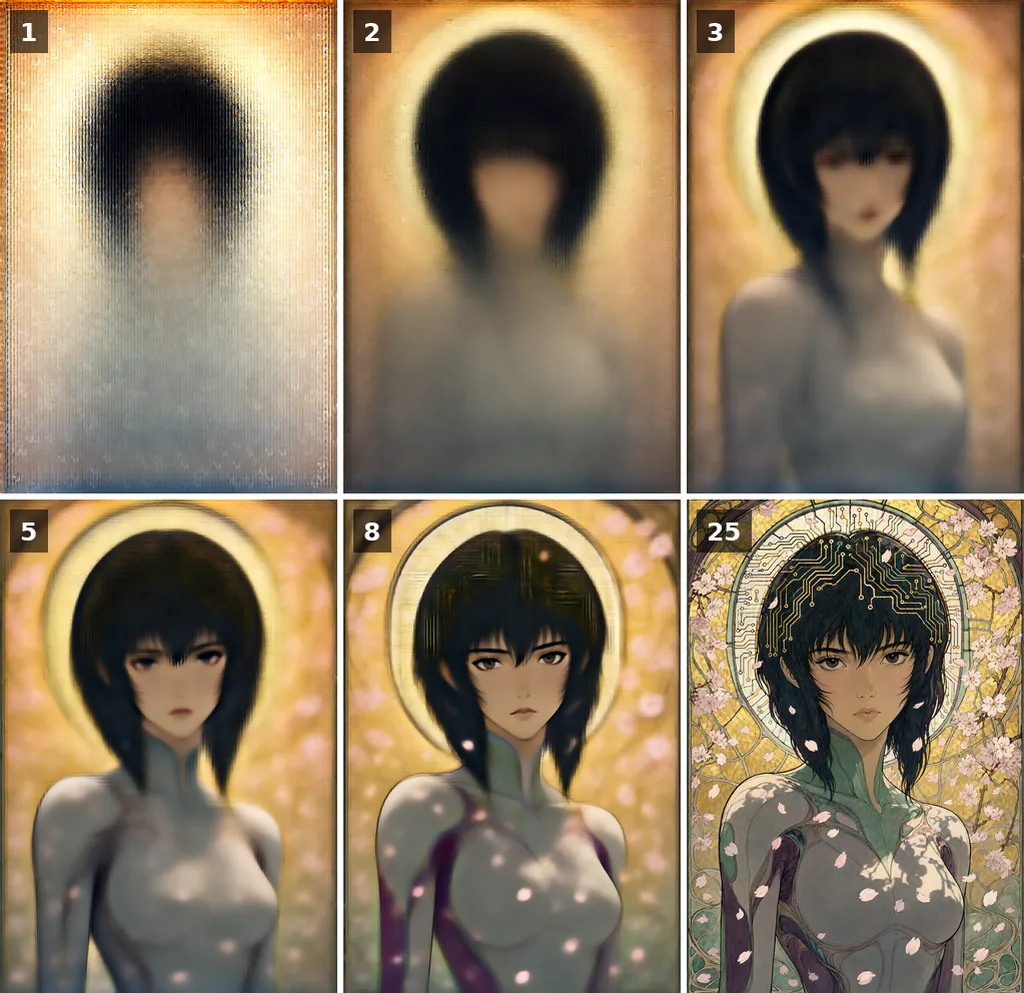
La figura de abajo muestra qué aspecto tiene por el camino la estimación que hace el modelo de la imagen terminada. La composición queda fijada en los primeros pasos y el detalle llega después. Este orden, de lo grueso a lo fino, es común a todos los modelos de difusión; el flow matching cambia sobre todo cómo se espacian los pasos, que es lo que ajusta el shift dinámico.
Lado a lado
| Stable Diffusion XL | Stable Diffusion 3.5 Large | Qwen-Image 2.1 | |
|---|---|---|---|
| Codificador de texto | CLIP ViT-L y OpenCLIP bigG | Dos codificadores CLIP y T5-XXL | Qwen3-VL 8B, un modelo de visión y lenguaje |
| Eliminador de ruido | U-Net, 2,6 mil millones de parámetros | MMDiT de doble flujo, 8 mil millones | Transformador de difusión de flujo único, 7 mil millones, 32 capas |
| Latente | 4 canales, compresión 8× | 16 canales, 8× | 64 canales, 16×, con alfa |
| Objetivo de entrenamiento | Predicción de ruido | Flow matching (rectified flow) | Flow matching (rectified flow) |
| Tamaño nativo | 1024 px | 1024 px | 2048 px |
| Edición | Modelo de inpainting de terceros | Sin modelo de edición oficial, solo ControlNets | Mismo checkpoint, hasta 10 imágenes de referencia |
| Licencia | OpenRAIL++-M | Community License | Qwen Research License |
Nada de esto cambia cómo se maneja el modelo. Guidance, pasos, seed y tamaño se comportan como en cualquier modelo de difusión; solo difieren los números que mejor funcionan, y la guía de ajustes los mide.
Las versiones, de Qwen-Image a la 2.1
La numeración confunde porque sigue la arquitectura, no el canal de publicación. Qwen-Image 2.0, anunciado en febrero de 2026 y nunca publicado como pesos, introdujo el diseño más ligero que la 2.1 distribuye ahora en abierto. Qwen-Image 3.0, anunciado en julio de 2026, es un buque insignia más grande, servido solo a través de la API de Alibaba. Qwen no ha explicado el esquema; las fechas de abajo vienen de los repositorios del proyecto y, para la 3.0, del anuncio de Qwen.
| Versión | Fecha | Qué es | Pesos |
|---|---|---|---|
| Qwen-Image | 4 de agosto de 2025 | MMDiT de doble flujo de 20 mil millones de parámetros con un codificador Qwen2.5-VL 7B; texto a imagen | Abiertos, Apache 2.0 |
| Qwen-Image-Edit, después Edit-2509 y Edit-2511 | De agosto a diciembre de 2025 | Modelos de edición sobre la misma base; varias imágenes de referencia desde 2509; un modelo RGBA por capas, Qwen-Image-Layered, en diciembre | Abiertos, Apache 2.0 |
| Qwen-Image-2512 | 31 de diciembre de 2025 | Última versión texto a imagen de la línea de 20 mil millones | Abiertos, Apache 2.0 |
| Qwen-Image 2.0 | 10 de febrero de 2026 | El diseño que hereda la 2.1: codificador Qwen3-VL, VAE de 64 canales, 2K nativo, instrucciones de hasta 1.000 tokens; informe técnico en mayo de 2026 | No publicados |
| Qwen-Image 3.0 | 21 de julio de 2026 | Buque insignia detrás de la API de Alibaba: prompts de hasta 4.500 tokens, infografías y storyboards renderizados en una sola pasada | Solo API |
| Qwen-Image 2.1 | 20 de septiembre de 2026 | Transformador de flujo único de 7 mil millones de parámetros con un codificador Qwen3-VL 8B; generación y edición en un solo checkpoint, RGBA, 2K | Abiertos, Qwen Research License |
| Qwen-Image 2.1 Turbo | 9 de octubre de 2026 | 2.1 destilado, 8 pasos | Abiertos, Qwen Research License |
Así que en una página de descarga, «Qwen-Image» sin número es el modelo de 20 mil millones de 2025, todavía disponible con sus actualizaciones 2512 y Edit. El modelo abierto actual es la 2.1, y la 3.0 es el modelo que hay detrás del servicio de pago de Alibaba. La 2.1 y la 3.0 comparten linaje, pero no sus pesos.
La licencia de Qwen-Image: pesos abiertos, solo investigación
El primer Qwen-Image y sus modelos de edición eran Apache 2.0: libres para cualquier cosa, uso comercial incluido. Qwen-Image 2.1 y su Turbo están bajo el Qwen Research License Agreement. Los pesos se pueden descargar, estudiar, ejecutar y hacerles fine-tuning, pero solo para investigación y evaluación. Cualquier uso comercial necesita una licencia aparte de Qwen.
Eso sitúa a la 2.1 en un lugar distinto al de Stable Diffusion, cuyas licencias 1.5 y SDXL permiten el uso comercial con una lista de usos prohibidos y cuya licencia 3.5 lo permite por debajo de un millón de dólares de ingresos anuales, y al de FLUX 3 Klein, libre para uso comercial por debajo de cinco millones. Para un estudiante o un laboratorio, nada cambia. Para un estudio, la API de pago o una licencia comercial solicitada a Qwen son las vías que quedan abiertas.
Probar Qwen-Image e ir más allá
Lo más rápido es la página gratuita de Qwen-Image 2.1 de este sitio: sin cuenta, generación y edición con imágenes de referencia, la cola a la vista en directo.
Para ejecutarlo en casa, ComfyUI admite el modelo de forma nativa. Tres archivos del reempaquetado de Comfy-Org van en las carpetas habituales: el modelo de difusión, el codificador de texto Qwen3-VL y el VAE, en versiones int8 para una tarjeta de 16 GB. La guía de ajustes cubre el grafo, la estructura del prompt, la guidance y los tamaños que se midieron exactamente en esa tarjeta, además del Turbo y el Turbo guiado.
Para los principios que comparten todos estos modelos, ruido, espacio latente, guidance y seed, lee ¿Qué es Stable Diffusion?; las explicaciones se trasladan, solo cambian los números.