Stable Diffusion en pocas palabras
Stable Diffusion es un modelo de difusión latente (LDM) de código abierto: una red neuronal entrenada para convertir ruido aleatorio en una imagen, poco a poco, guiada por un texto. Lo creó el grupo CompVis de la Universidad Ludwig Maximilian de Múnich junto con Runway, y se entrenó con la potencia de cálculo de Stability AI sobre imágenes recopiladas por la organización sin ánimo de lucro LAION. El método procede del artículo High-Resolution Image Synthesis with Latent Diffusion Models (Rombach y colaboradores, CVPR 2022).
Los pesos se publicaron el 22 de agosto de 2022. Eso fue lo que lo cambió todo. DALL-E 2 y Midjourney ya existían, pero detrás de listas de espera y créditos, en los servidores de otros. Stable Diffusion era un archivo de 4 GB que funcionaba en una tarjeta gráfica con 8 GB de memoria, sin cuenta y con un filtro de seguridad que se podía desactivar.
En cuestión de semanas llegaron las interfaces web y el inpainting, después los fine-tunes, los LoRA y ControlNet. Cuatro años más tarde, el nombre significa dos cosas. En sentido estricto, la familia de modelos de la 1.4 a la 3.5. En sentido amplio, toda la práctica de ejecutar modelos de imagen en tu propia máquina.
Lo que sigue explica la máquina en sí, con el vocabulario que encontrarás en todas las interfaces: espacio latente, VAE, U-Net, CLIP, sampler, escala de guidance, seed. No hace falta ninguna fórmula, pero unos cuantos números ayudan.
¿Cómo funciona Stable Diffusion? Tres redes y un bucle
Stable Diffusion no es una red, sino tres, ejecutadas una detrás de otra.
- Un codificador de texto lee el prompt y lo convierte en una lista de números. En Stable Diffusion 1.5 son 77 tokens, cada uno descrito por 768 números; 2.048 en SDXL, que ejecuta dos codificadores.
- Un eliminador de ruido, una U-Net en las versiones 1 a XL y un transformador (MMDiT) a partir de la versión 3, parte de un bloque de ruido aleatorio y lo limpia en 20 a 30 pasos, consultando los números del texto en cada paso. No trabaja sobre píxeles, sino sobre una versión compacta de la imagen, el latente, que vive en lo que se llama el espacio latente: 4 × 64 × 64 números para una imagen de 512 píxeles, 4 × 128 × 128 para los 1024 píxeles de SDXL.
- Un decodificador convierte ese latente en los valores finales de los píxeles, rojo, verde y azul: 3 × 512 × 512, o 3 × 1024 × 1024 en SDXL.
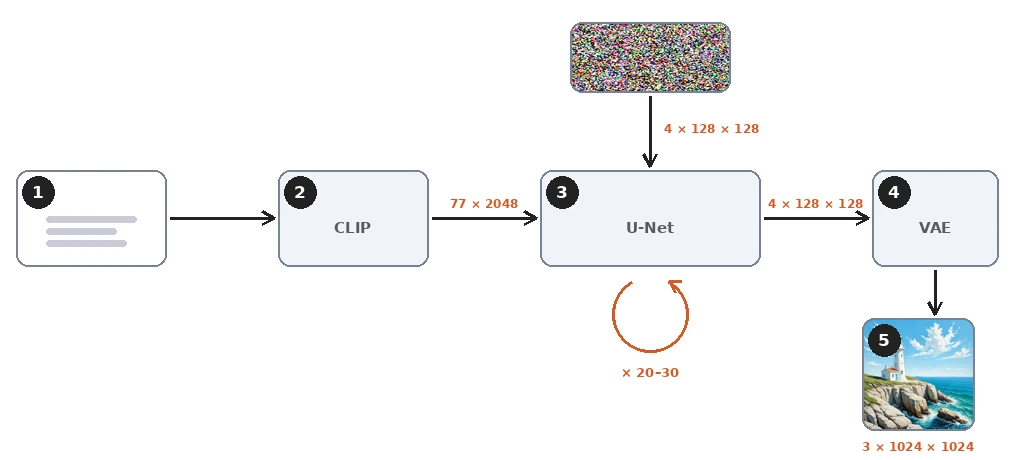
Por el camino no se busca ni se copia nada. No hay ninguna base de datos de imágenes dentro del archivo. Los 2 a 16 GB de pesos contienen lo que la red aprendió sobre cómo encajan descripciones e imágenes, y cada resultado se calcula a partir del ruido. La red aún puede memorizar imágenes que aparecieron muchas veces en el entrenamiento, y algunos investigadores han extraído unos cientos, pero es la excepción.
¿Qué es un modelo de difusión? Aprender a quitar el ruido
El proceso directo: añadir ruido
La idea de la difusión es fácil de enunciar. Toma una foto con su descripción. Añádele una cantidad medida de ruido aleatorio. Pide a una red que adivine qué ruido se ha añadido, conociendo la descripción. Compara su respuesta con la verdad y corrige un poco la red.
Añadir el ruido es el proceso directo. Sigue un programa fijo de mil niveles, desde un grano tenue en el nivel 50 hasta pura nieve en el nivel 999. La red nunca ve el programa completo; solo ve una imagen con ruido en un nivel, una cada vez.
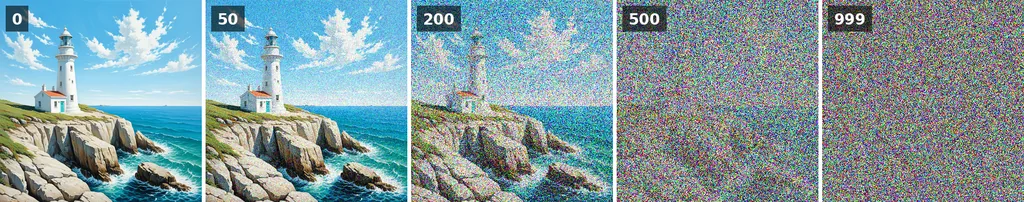
Haz eso con miles de millones de ejemplos y el resultado es un predictor de ruido: dada una imagen con ruido, su nivel de ruido y un texto, dice cuál es probablemente el ruido. El objetivo de entrenamiento es solo la diferencia entre el ruido predicho y el real. Entrenar Stable Diffusion 1 llevó unas 150.000 horas en GPU A100 de centro de datos, según su ficha de modelo.
El proceso inverso: el predictor de ruido en acción
La generación repite la lección al revés. Ese es el proceso inverso. Parte de ruido puro, que elige la seed. Pregunta al predictor cuál es el ruido, quita una fracción, vuelve a preguntar. DDPM, el artículo de 2020 que hizo viable la difusión, lo hacía en mil pasos pequeños.
El sampler, llamado también scheduler en algunas interfaces, es la regla que decide el tamaño de cada paso y si se añade de nuevo un poco de ruido fresco. Los mejores samplers, DDIM, Euler y la familia DPM++, dan pasos más grandes por el mismo camino, y por eso hoy bastan 20 a 30 pasos.
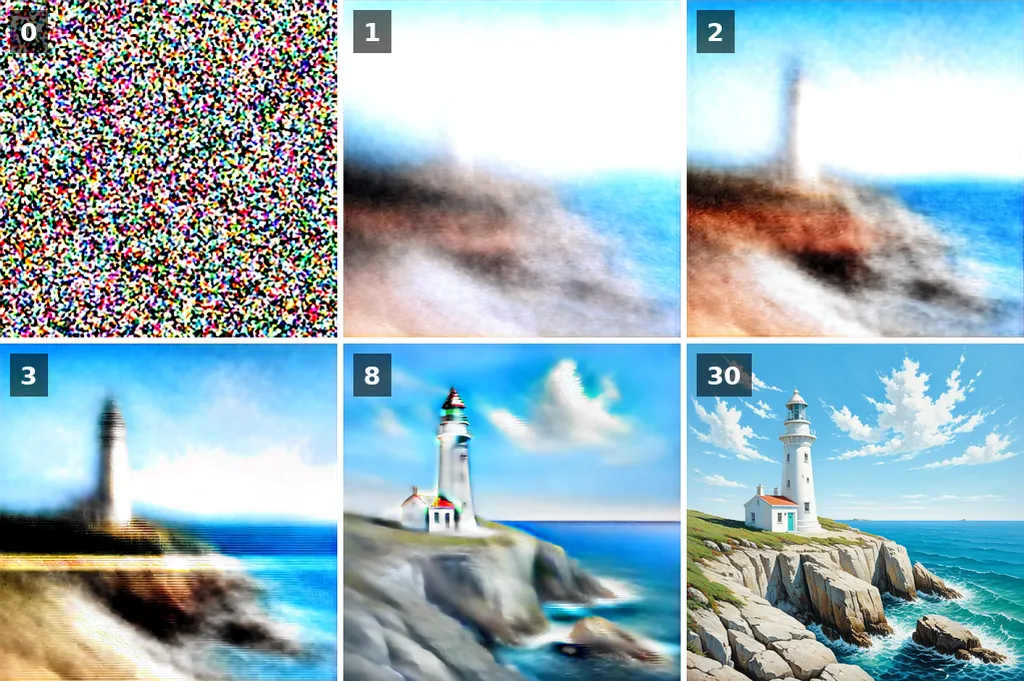
La figura muestra lo que conviene recordar. En cada paso el modelo tiene una estimación de la imagen terminada, y esa estimación se asienta pronto. Los dos o tres primeros pasos, cuando el ruido todavía es denso, fijan la composición: dónde está el horizonte, dónde se levanta el faro, cuánto cielo hay. Los pasos posteriores refinan la textura y los detalles pequeños.
El control deslizante de abajo recorre las treinta estimaciones del mismo render.
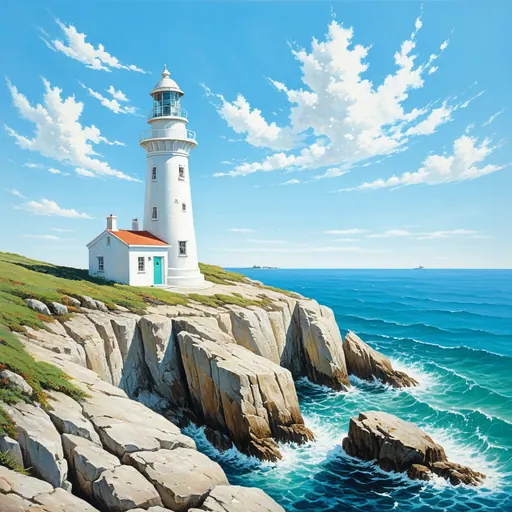
De ahí salen dos consecuencias prácticas. Cambiar el número de pasos cambia los detalles y a veces la composición, porque los primeros pasos caen en otros valores; no se limita a hacer más nítida la misma imagen. Y la misma seed con otro tamaño de imagen parte de otro bloque de ruido, así que también da otra imagen. Elige primero el tamaño y luego busca una seed.
Difusión latente: el truco del VAE que lo hace caber en una tarjeta gráfica de juego
Los primeros modelos de difusión trabajaban sobre píxeles. Una imagen de 512 × 512 son 786.432 números, y el predictor tenía que leerlos y escribirlos todos en cada uno de sus pasos. Los modelos de píxeles como DALL-E 2 e Imagen lo sorteaban difundiendo a 64 píxeles y añadiendo redes de escalado, y de todos modos nunca se publicaron.
Stable Diffusion añade un autocodificador variacional, el VAE. Su codificador comprime la imagen por un factor de ocho en cada lado en cuatro canales: 4 × 64 × 64, es decir, 16.384 números, 48 veces menos. La difusión se desarrolla por completo en ese espacio comprimido, el espacio latente. Solo al final el decodificador del VAE expande el resultado a píxeles.

El latente no es una imagen pequeña. Sus cuatro canales son un código que el decodificador sabe leer, y ningún canal por sí solo se parece del todo a la imagen. Pero la disposición sobrevive a la compresión, y eso es lo que permite al eliminador de ruido decidir la composición en un espacio tan pequeño.
Por eso también la elección del VAE importa para el color y el detalle fino: cada número del latente representa un bloque de 8 × 8 píxeles, y el decodificador inventa lo que hay dentro del bloque. Stable Diffusion 3 pasó a un latente de 16 canales exactamente por esa razón, y con ello mejoraron el detalle fino y el texto pequeño.
CLIP y atención cruzada: cómo el texto dirige la imagen
Tres piezas convierten las palabras en una dirección para el eliminador de ruido.
Tokenizador y codificador de texto: cómo lee CLIP un prompt
El tokenizador corta el prompt en tokens, palabras comunes enteras o fragmentos de las más raras. Stable Diffusion 1.5 y SDXL leen como máximo 77 tokens, dos de ellos marcadores de inicio y fin, unas 50 a 60 palabras en inglés. Más allá, el texto se corta, salvo que la interfaz lo reparta en varias pasadas. Pon al principio lo que más importa.
El codificador de texto de 1.5 es CLIP, una red que OpenAI entrenó con 400 millones de pares de imágenes y descripciones, con una sola tarea: acercar los números que describen una descripción a los números que describen su imagen. Tras ese entrenamiento, los números de «lighthouse» ya llevan consigo el aspecto de un faro. SDXL ejecuta dos codificadores de ese tipo en paralelo, el segundo un reentrenamiento abierto de LAION con dos mil millones de pares. Stable Diffusion 3 añade un tercero, T5, que lee frases enteras.
Atención cruzada dentro de la U-Net
La atención cruzada (cross-attention) es donde el texto se encuentra con la imagen. La U-Net es una pila de bloques de convolución que reducen el latente y luego lo vuelven a ampliar, con conexiones de salto entre los tamaños correspondientes. Entre esos bloques hay capas de atención. En cada paso, cada región del latente mira los 77 vectores de tokens y sopesa cuáles le conciernen. La región del cielo atiende a «sunset» y «clouds», la roca a «cliff». Por eso el orden de las palabras, la repetición y la sintaxis de pesos de las interfaces tienen efecto, y por eso una palabra de estilo al principio tiñe toda la imagen.
Es también el límite de las primeras versiones. CLIP aprendió de textos alternativos cortos, así que entiende bien las listas de sujetos y estilos y mal las relaciones entre ellos. «A red cube on a blue sphere» sale a menudo invertido en 1.5. La guía del prompt muestra lo que funciona de forma fiable.
Escala de guidance (CFG), prompt negativo y seed: los tres ajustes
Tres ajustes aparecen en todas las interfaces de Stable Diffusion. Se corresponden directamente con la maquinaria descrita arriba.
La escala de guidance, o CFG, abrevia la guía sin clasificador (classifier-free guidance): es la que decide con cuánta fuerza se impone el texto. En cada paso el eliminador de ruido hace en realidad dos predicciones: una con el prompt y otra con un prompt vacío. La diferencia entre las dos es la dirección que marca el prompt. La predicción final es la vacía más esa diferencia multiplicada por la escala de guidance. En 1 se usa la predicción con prompt tal cual, sin empuje: la imagen sigue el texto de lejos, con colores apagados y un cielo gris donde el prompt pedía uno azul. Entre 5 y 8, más o menos, sigue el prompt de cerca con colores naturales. Por encima de 12 el contraste se endurece, los colores se saturan y las pinceladas se vuelven ásperas.
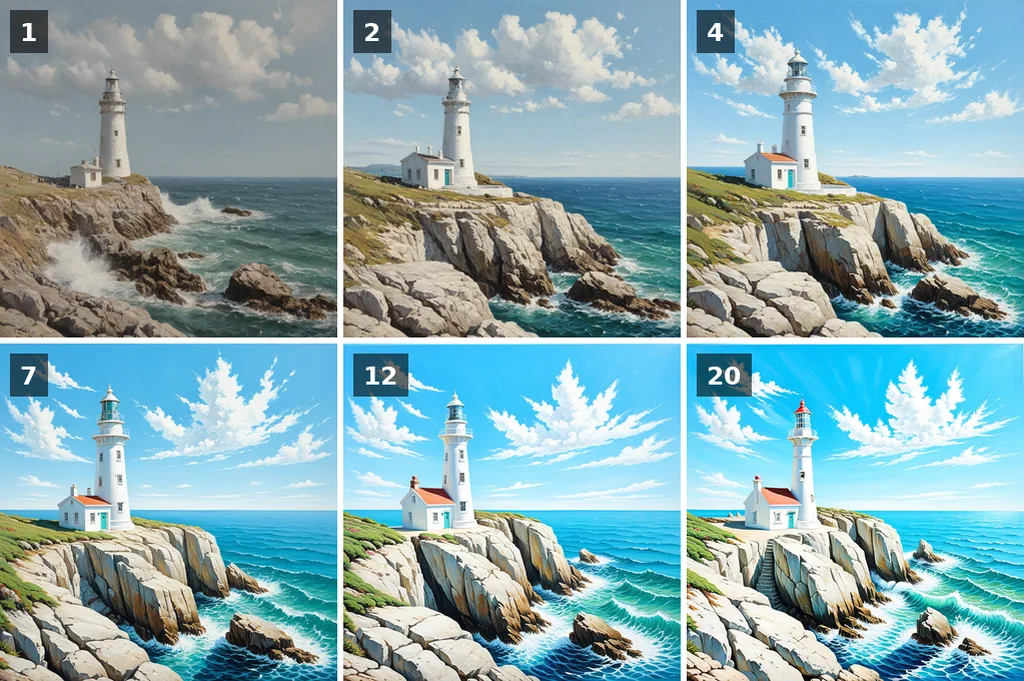
El prompt negativo sustituye al prompt vacío de esa segunda predicción. En vez de no leer nada, la segunda pasada lee «blurry, text, watermark», y la guidance empuja en dirección contraria. No cuesta nada extra, porque la segunda pasada se ejecuta de todos modos, y solo funciona cuando la guidance está por encima de 1. La guía del prompt negativo da listas que funcionan.
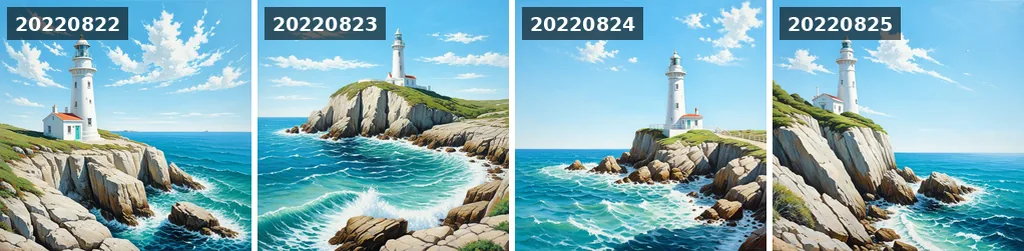
La seed es el número que genera el ruido inicial. Misma seed, mismo prompt, mismos ajustes y mismo modelo dan la misma imagen, píxel a píxel, con el mismo software y el mismo hardware; otra interfaz u otra tarjeta genera el ruido de otra manera. Cambia la seed y cambia la composición, porque los primeros pasos leen otro bloque de ruido. Cambia una palabra del prompt y conserva la seed, y casi toda la imagen suele mantenerse. Así es como se afina un prompt.
De la U-Net al transformador: las versiones de la 1.5 a la 3.5
Seis generaciones principales aparecieron en dos años, las dos primeras de CompVis y Runway, el resto de Stability AI. Cada una cambió al menos una de las tres redes.
| Versión | Fecha | Eliminador de ruido | Codificadores de texto | Tamaño nativo |
|---|---|---|---|---|
| 1.4 y 1.5 | Agosto y octubre de 2022 | U-Net, 860 millones de parámetros | CLIP ViT-L | 512 px |
| 2.0 y 2.1 | Noviembre y diciembre de 2022 | U-Net del mismo diseño, reentrenada desde cero | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Julio de 2023 | U-Net, 2,6 mil millones, más un refiner | CLIP ViT-L y OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Noviembre de 2023 | SDXL destilado a entre 1 y 4 pasos | Los mismos que SDXL | 512 px |
| 3 Medium | Junio de 2024 | Transformador de difusión (MMDiT), 2 mil millones | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Octubre de 2024 | MMDiT, 8 mil millones; Medium 2,5 mil millones | Los mismos tres | 1024 px |
1.5 sigue siendo uno de los modelos más reentrenados que existen, con decenas de miles de checkpoints y LoRA de la comunidad, y todavía funciona con 4 GB de memoria de vídeo. SDXL es el caballo de batalla: mejores manos, caras y composición, y salida nativa a 1024 píxeles. 3 y 3.5 sustituyeron la U-Net por un transformador que trata juntos los tokens de texto y de imagen, que es lo que por fin hizo posible el texto legible en las imágenes: pon las palabras entre comillas en el prompt. La comparativa SDXL contra Stable Diffusion 3 muestra los mismos prompts en ambos.
Las licencias también cambiaron. 1.5 está bajo la licencia CreativeML OpenRAIL-M y SDXL bajo OpenRAIL++-M, ambas libres para uso comercial con una lista de usos prohibidos. Los modelos 3.x están bajo la Stability AI Community License, gratuita por debajo de un millón de dólares de ingresos anuales.
Qué se puede hacer con él: image-to-image, inpainting, ControlNet, LoRA
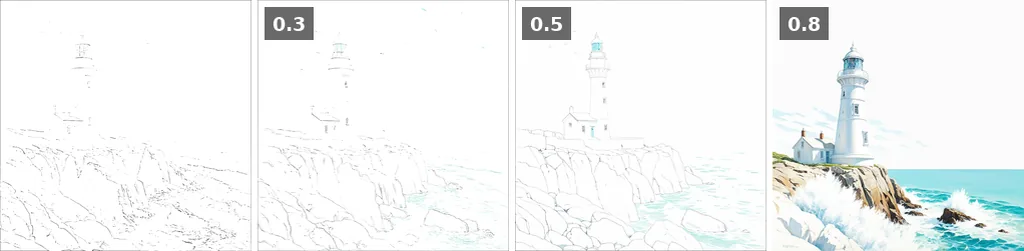
El texto a imagen es solo el principio, porque cada pieza del pipeline se puede reutilizar. Codifica un boceto en un latente, añade solo parte del ruido y elimina el ruido desde ahí, y tienes image-to-image, img2img en las interfaces: el ajuste de fuerza (strength), o denoise, es cuánto ruido añades. La idea viene de SDEdit. Enmascara una región del latente y tienes inpainting, u outpainting cuando la máscara queda fuera del encuadre. Añade una pequeña red auxiliar que lee una pose, un mapa de profundidad o unos bordes, y tienes ControlNet. Entrena unos pocos millones de pesos adicionales con veinte fotos y tienes un LoRA que enseña al modelo una cara o un estilo. Modelos de superresolución dedicados se encargan del escalado.
Para ejecutarlo tú mismo, basta una tarjeta NVIDIA reciente con 6 GB de memoria de vídeo (VRAM) para 1.5 y 8 GB para SDXL. Las tarjetas AMD funcionan a través de ROCm, Apple Silicon a través del backend MPS. La guía de instalación cubre las tres interfaces principales. Sin tarjeta, las herramientas de este sitio no necesitan ningún hardware: Stable Diffusion XL y Stable Diffusion 1.5 se ejecutan en la GPU del propio sitio con la cola mostrada en directo, los prompts documentados muestran qué hace cada ajuste, y 1.731 estilos de artistas muestran lo que el modelo aprendió sobre los pintores.
Stable Diffusion vs Midjourney vs DALL-E
Frente a Midjourney y los modelos de imagen de OpenAI, la diferencia no está en la calidad sino en el control. Los pesos son públicos y el modelo se ejecuta en local: tus imágenes se quedan en tu disco, tú eliges el modelo, tú fijas la seed y puedes cambiar cualquier componente. A cambio te pide más. Midjourney pide una frase y devuelve una imagen pulida; Stable Diffusion pide un modelo, un prompt, un prompt negativo y una escala de guidance, y te da exactamente lo que has configurado.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Pesos | Públicos, descargables | Cerrados | Cerrados |
| Funciona en tu ordenador | Sí, 6 a 8 GB de VRAM | No | No |
| Precio | Gratis en local; herramientas gratuitas en línea | Suscripción | Suscripción o por imagen |
| Control | Seed, modelo, LoRA, ControlNet, inpainting, cada ajuste | Parámetros y referencias de estilo | Conversación |
| Fine-tuning | Sí, por cualquiera | No | No |
| Texto en las imágenes | Flojo antes de la 3, bueno desde la 3.5 | Bueno desde la v6 | Muy bueno |
El mismo principio de difusión mueve hoy modelos de otros laboratorios, con otros codificadores y otras licencias: FLUX de Black Forest Labs, fundado por los autores originales de Stable Diffusion, y Qwen-Image de Alibaba. Se ejecutan en las mismas interfaces, con las mismas seeds, pasos y samplers, así que casi todo lo de esta página sirve para ellos. Su guidance funciona de otra manera, FLUX dev no tiene prompt negativo, y prefieren frases completas a listas de palabras clave.
Fuentes, y cómo reutilizar las figuras
Las fuentes primarias, en el orden en que la página las encuentra:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: el artículo de Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: los procesos directo e inverso y el programa de mil pasos.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho y Salimans, 2022: la escala de guidance.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, y Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL y Stable Diffusion 3.
Reutilizar las figuras. Los renders y diagramas de esta página se publican bajo CC BY 4.0: reutilízalos en un curso, una charla o un artículo con un enlace a esta página. Todos los renders usan Stable Diffusion XL, euler, 30 pasos, CFG 6, seed 20220822, el prompt de abajo y el prompt negativo «text, watermark, signature, blurry, low quality, storm, dark clouds, sunset».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesPara citar esta página.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion