Stable Diffusion en bref
Stable Diffusion est un modèle de diffusion latente (LDM) open source : un réseau de neurones entraîné à transformer un bruit aléatoire en image, petit à petit, guidé par un texte. Il a été conçu par le groupe CompVis de l’université Ludwig-Maximilian de Munich avec Runway, et entraîné avec la puissance de calcul de Stability AI sur des images collectées par l’association LAION. La méthode vient de l’article High-Resolution Image Synthesis with Latent Diffusion Models (Rombach et ses collègues, CVPR 2022).
Les poids ont été publiés le 22 août 2022. C’est ce qui a tout changé. DALL-E 2 et Midjourney existaient, mais derrière des listes d’attente et des crédits, sur les serveurs de quelqu’un d’autre. Stable Diffusion était un fichier de 4 Go qui tournait sur une carte graphique de 8 Go de mémoire, sans compte, avec un filtre de sécurité que l’on pouvait désactiver.
En quelques semaines sont arrivés les interfaces web et l’inpainting, puis les fine-tunes, les LoRA et ControlNet. Quatre ans plus tard, le nom désigne deux choses. Au sens strict, la famille de modèles de 1.4 à 3.5. Au sens large, toute la pratique qui consiste à faire tourner des modèles d’image sur sa propre machine.
Ce qui suit explique la machine elle-même, avec le vocabulaire que vous rencontrerez dans toutes les interfaces : espace latent, VAE, U-Net, CLIP, sampler, échelle de guidance, seed. Aucune formule n’est nécessaire, mais quelques chiffres aident.
Comment fonctionne Stable Diffusion ? Trois réseaux et une boucle
Stable Diffusion n’est pas un réseau mais trois, exécutés l’un après l’autre.
- Un encodeur de texte lit le prompt et le transforme en une liste de nombres. Dans Stable Diffusion 1.5, ce sont 77 tokens, décrits chacun par 768 nombres ; 2 048 dans SDXL, qui fait tourner deux encodeurs.
- Un débruiteur, un U-Net dans les versions 1 à XL et un transformeur (MMDiT) à partir de la version 3, part d’un bloc de bruit aléatoire et le nettoie en 20 à 30 étapes, en consultant les nombres du texte à chaque étape. Il ne travaille pas sur des pixels mais sur une version compacte de l’image, le latent, qui vit dans ce qu’on appelle l’espace latent : 4 × 64 × 64 nombres pour une image de 512 pixels, 4 × 128 × 128 pour les 1024 pixels de SDXL.
- Un décodeur transforme ce latent en valeurs de pixels finales, rouge, vert et bleu : 3 × 512 × 512, ou 3 × 1024 × 1024 pour SDXL.
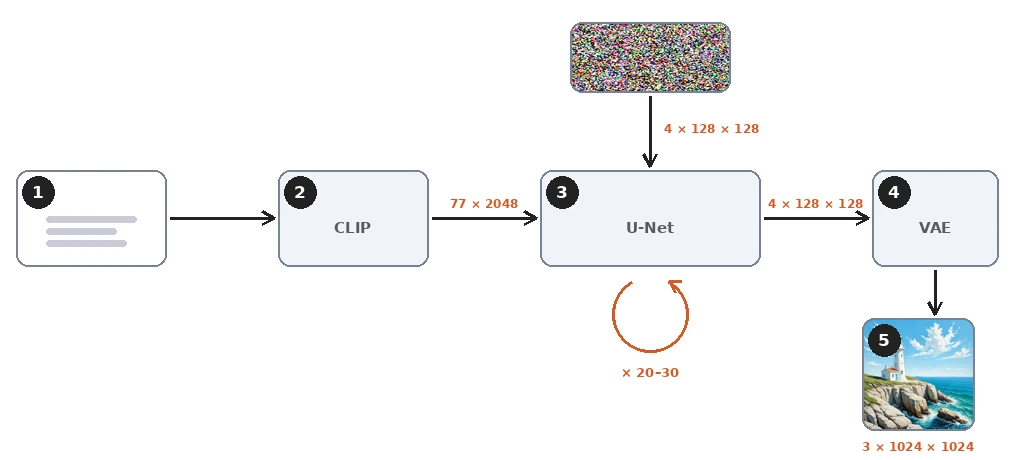
Rien n’est cherché ni copié en chemin. Il n’y a pas de base de données d’images dans le fichier. Les 2 à 16 Go de poids contiennent ce que le réseau a appris sur la façon dont légendes et images vont ensemble, et chaque sortie est calculée à partir du bruit. Le réseau peut tout de même mémoriser des images apparues de nombreuses fois à l’entraînement, et des chercheurs en ont extrait quelques centaines, mais c’est l’exception.
Qu’est-ce qu’un modèle de diffusion ? Apprendre à retirer le bruit
Le processus direct : ajouter du bruit
L’idée de la diffusion est simple à énoncer. Prenez une photo avec sa légende. Ajoutez-lui une quantité mesurée de bruit aléatoire. Demandez à un réseau de deviner quel bruit a été ajouté, en connaissant la légende. Comparez sa réponse à la vérité et corrigez un peu le réseau.
Ajouter le bruit, c’est le processus direct. Il suit un programme fixe de mille niveaux, d’un grain léger au niveau 50 à de la neige pure au niveau 999. Le réseau ne voit jamais le programme se dérouler ; il ne voit qu’une image bruitée à un niveau donné, une à la fois.
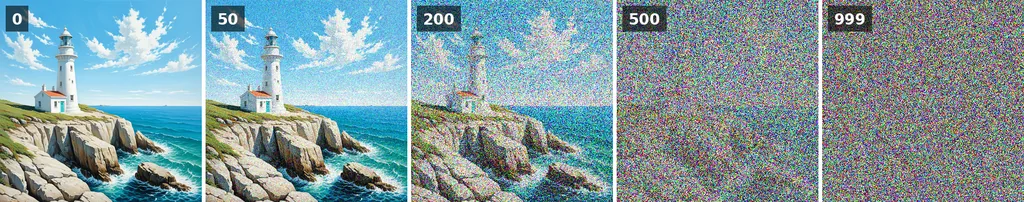
Faites cela sur des milliards d’exemples et le résultat est un prédicteur de bruit : à partir d’une image bruitée, de son niveau de bruit et d’un texte, il dit quel est probablement le bruit. L’objectif d’entraînement est simplement l’écart entre le bruit prédit et le bruit réel. L’entraînement de Stable Diffusion 1 a demandé environ 150 000 heures de GPU A100 de centre de données, selon sa fiche de modèle.
Le processus inverse : le prédicteur de bruit à l’œuvre
La génération rejoue la leçon à l’envers. C’est le processus inverse. Partez d’un bruit pur, que la seed choisit. Demandez au prédicteur quel est le bruit, retirez-en une fraction, redemandez. DDPM, l’article de 2020 qui a rendu la diffusion utilisable en pratique, le faisait en mille petites étapes.
Le sampler, aussi appelé scheduler dans certaines interfaces, est la règle qui décide de la taille de chaque étape et de l’ajout ou non d’un peu de bruit frais. Les meilleurs samplers, DDIM, Euler et la famille DPM++, font de plus grands pas le long du même chemin, et c’est pourquoi 20 à 30 étapes suffisent aujourd’hui.
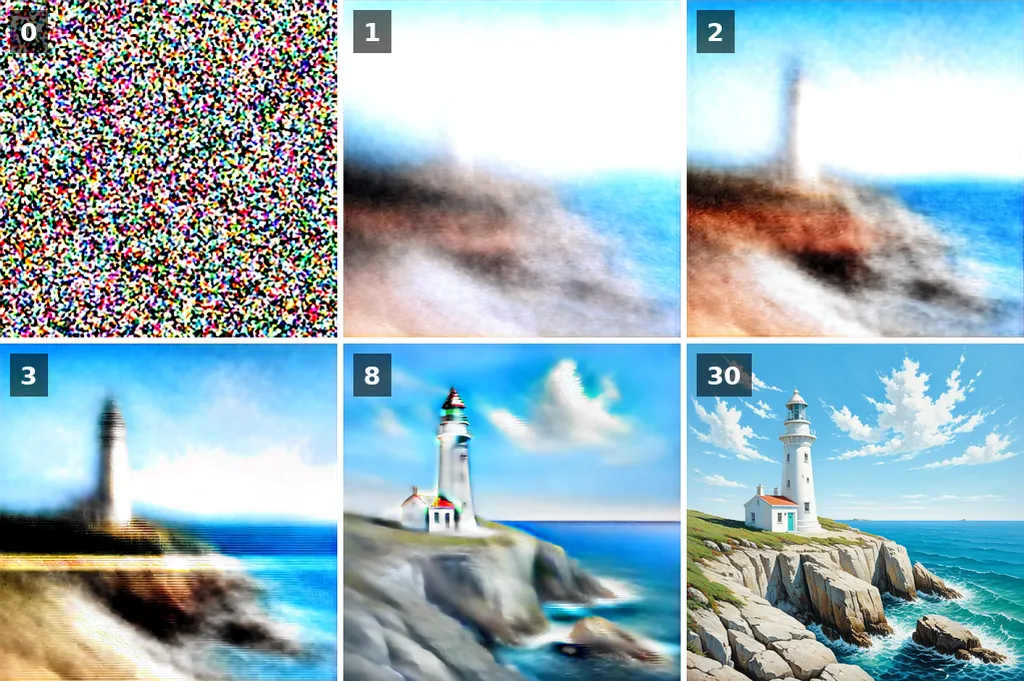
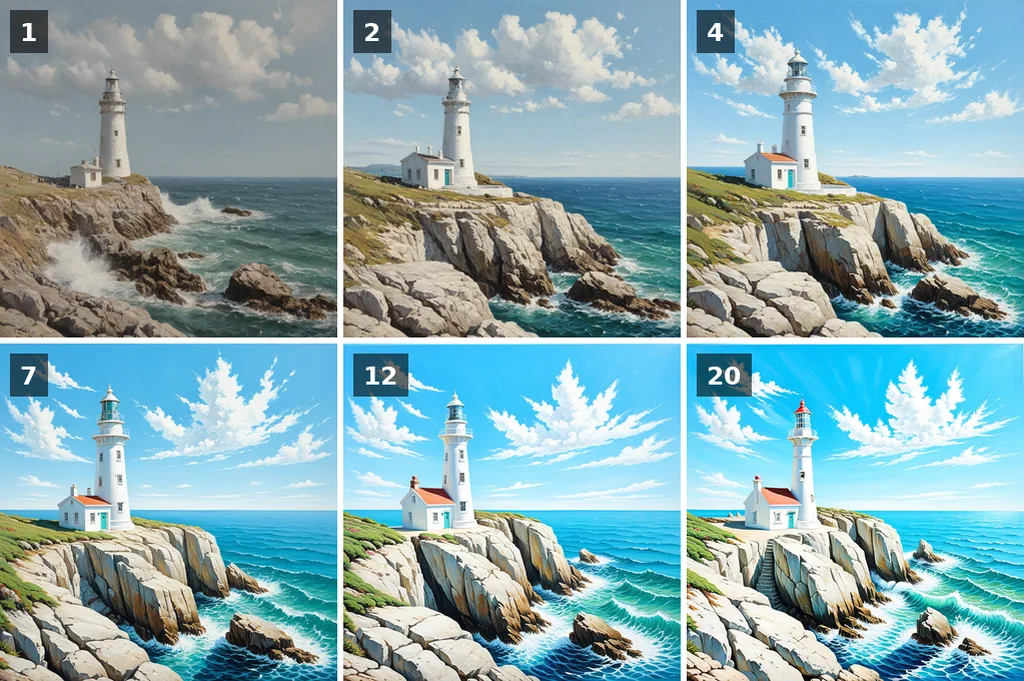
La figure montre ce qu’il faut retenir. À chaque étape, le modèle tient une estimation de l’image finale, et cette estimation se fixe tôt. Les deux ou trois premières étapes, quand le bruit est encore lourd, fixent la composition : où est l’horizon, où se dresse le phare, quelle place prend le ciel. Les étapes suivantes affinent la texture et les petits détails.
Le curseur ci-dessous parcourt les trente estimations du même rendu.
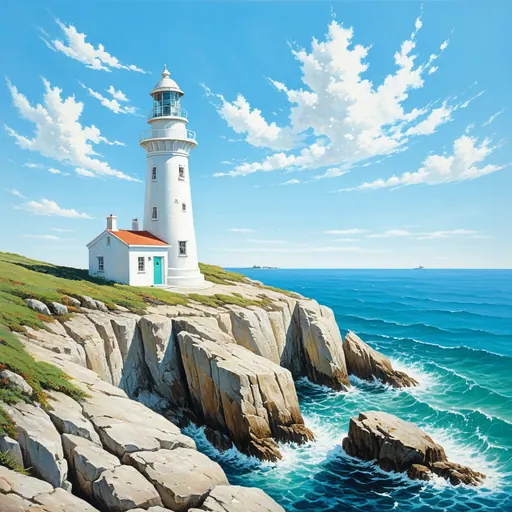
Deux conséquences pratiques en découlent. Changer le nombre d’étapes change les détails et parfois la composition, parce que les premières étapes tombent sur d’autres valeurs ; cela ne se contente pas de rendre la même image plus nette. Et la même seed à une autre taille d’image part d’un autre bloc de bruit, donc elle donne aussi une autre image. Choisissez d’abord la taille, puis cherchez une seed.
Diffusion latente : l’astuce du VAE qui le fait tenir sur une carte de joueur
Les premiers modèles de diffusion travaillaient sur les pixels. Une image de 512 × 512, c’est 786 432 nombres, et le prédicteur devait les lire et les écrire tous à chacune de ses étapes. Les modèles en pixels comme DALL-E 2 et Imagen contournaient le problème en diffusant à 64 pixels puis en ajoutant des réseaux d’agrandissement, et ils n’ont de toute façon jamais été publiés.
Stable Diffusion ajoute un auto-encodeur variationnel, le VAE. Son encodeur compresse l’image d’un facteur huit de chaque côté en quatre canaux : 4 × 64 × 64, soit 16 384 nombres, 48 fois moins. La diffusion se déroule entièrement dans cet espace compressé, l’espace latent. Ce n’est qu’à la toute fin que le décodeur du VAE déploie le résultat en pixels.

Le latent n’est pas une petite image. Ses quatre canaux sont un code que le décodeur sait lire, et aucun canal pris seul ne ressemble vraiment à l’image. Mais l’agencement survit à la compression, et c’est ce qui permet au débruiteur de décider la composition dans un espace aussi réduit.
C’est aussi pourquoi le choix du VAE compte pour les couleurs et les détails fins : chaque nombre du latent représente un carré de 8 × 8 pixels, et le décodeur invente ce qui se trouve à l’intérieur. Stable Diffusion 3 est passé à un latent de 16 canaux exactement pour cette raison, et les détails fins et les petits textes s’en sont trouvés améliorés.
CLIP et attention croisée : comment le texte guide l’image
Trois pièces transforment des mots en une direction pour le débruiteur.
Tokenizer et encodeur de texte : comment CLIP lit un prompt
Le tokenizer découpe le prompt en tokens, des mots courants entiers ou des fragments de mots plus rares. Stable Diffusion 1.5 et SDXL lisent au plus 77 tokens, dont deux marqueurs de début et de fin, soit environ 50 à 60 mots anglais. Au-delà, le texte est coupé, sauf si l’interface le répartit en plusieurs passes. Mettez ce qui compte le plus au début.
L’encodeur de texte de 1.5 est CLIP, un réseau qu’OpenAI a entraîné sur 400 millions de paires d’images et de légendes, avec une seule tâche : rapprocher les nombres qui décrivent une légende des nombres qui décrivent son image. Après cet entraînement, les nombres de « lighthouse » portent déjà ce à quoi ressemble un phare. SDXL fait tourner deux encodeurs de ce type côte à côte, le second étant un ré-entraînement ouvert par LAION sur deux milliards de paires. Stable Diffusion 3 en ajoute un troisième, T5, qui lit des phrases entières.
L’attention croisée dans l’U-Net
L’attention croisée (cross-attention) est l’endroit où le texte rencontre l’image. L’U-Net est une pile de blocs de convolution qui réduisent le latent puis le ré-agrandissent, avec des connexions de saut (skip connections) entre les tailles correspondantes. Entre ces blocs se trouvent des couches d’attention. À chaque étape, chaque région du latent regarde les 77 vecteurs de tokens et pèse lesquels la concernent. La région du ciel s’intéresse à « sunset » et « clouds », le rocher à « cliff ». C’est pourquoi l’ordre des mots, la répétition et la syntaxe de pondération des interfaces ont un effet, et pourquoi un mot de style placé au début colore toute l’image.
C’est aussi la limite des premières versions. CLIP a appris sur de courts textes alternatifs, il comprend donc bien les listes de sujets et de styles, et mal les relations entre eux. « A red cube on a blue sphere » ressort souvent inversé dans 1.5. Le guide du prompt montre ce qui marche de façon fiable.
Échelle de guidance (CFG), prompt négatif et seed : les trois réglages
Trois réglages apparaissent dans toutes les interfaces de Stable Diffusion. Ils correspondent directement à la mécanique décrite plus haut.
L’échelle de guidance, ou CFG, abrège la guidance sans classifieur (classifier-free guidance) : c’est elle qui décide avec quelle force le texte est imposé. À chaque étape, le débruiteur fait en réalité deux prédictions : une avec le prompt et une avec un prompt vide. La différence entre les deux est la direction que donne le prompt. La prédiction finale est la prédiction vide plus cette différence multipliée par l’échelle de guidance. À 1, la prédiction avec prompt est utilisée telle quelle, sans poussée : l’image suit le texte de loin, avec des couleurs ternes et un ciel gris là où le prompt demandait du bleu. Entre 5 et 8 environ, elle suit le prompt de près avec des couleurs naturelles. Au-delà de 12, le contraste se durcit, les couleurs saturent et les touches deviennent brutales.
Le prompt négatif remplace le prompt vide de cette seconde prédiction. Au lieu de ne rien lire, la seconde passe lit « blurry, text, watermark », et la guidance pousse dans la direction opposée. Cela ne coûte rien de plus, puisque la seconde passe tourne de toute façon, et cela ne fonctionne que si la guidance est supérieure à 1. Le guide du prompt négatif donne des listes qui marchent.
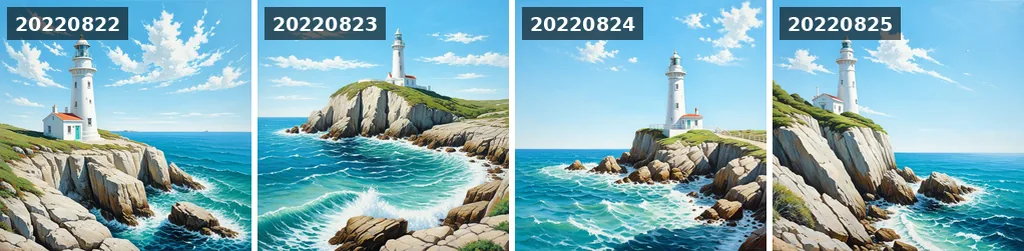
La seed est le nombre qui génère le bruit de départ. Même seed, même prompt, mêmes réglages et même modèle donnent la même image, au pixel près, sur le même logiciel et le même matériel ; une autre interface ou une autre carte tire le bruit différemment. Changez la seed et la composition change, puisque les premières étapes lisent un autre bloc de bruit. Changez un mot du prompt en gardant la seed, et l’essentiel de l’image tient en général. C’est ainsi qu’on affine un prompt.
De l’U-Net au transformeur : les versions de 1.5 à 3.5
Six générations principales sont parues en deux ans, les deux premières de CompVis et Runway, les autres de Stability AI. Chacune a changé au moins l’un des trois réseaux.
| Version | Date | Débruiteur | Encodeurs de texte | Taille native |
|---|---|---|---|---|
| 1.4 et 1.5 | Août et octobre 2022 | U-Net, 860 millions de paramètres | CLIP ViT-L | 512 px |
| 2.0 et 2.1 | Novembre et décembre 2022 | U-Net de même architecture, ré-entraîné de zéro | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Juillet 2023 | U-Net, 2,6 milliards, plus un refiner | CLIP ViT-L et OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Novembre 2023 | SDXL distillé en 1 à 4 étapes | Comme SDXL | 512 px |
| 3 Medium | Juin 2024 | Transformeur de diffusion (MMDiT), 2 milliards | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Octobre 2024 | MMDiT, 8 milliards ; Medium 2,5 milliards | Les trois mêmes | 1024 px |
1.5 reste l’un des modèles les plus ré-entraînés qui existent, avec des dizaines de milliers de checkpoints et de LoRA communautaires, et il tourne toujours avec 4 Go de mémoire vidéo. SDXL est le cheval de bataille : de meilleures mains, de meilleurs visages, une meilleure composition, et une sortie native en 1024 pixels. 3 et 3.5 ont remplacé l’U-Net par un transformeur qui traite ensemble les tokens de texte et d’image, ce qui a enfin rendu possible du texte lisible dans les images : mettez les mots entre guillemets dans le prompt. Le comparatif SDXL contre Stable Diffusion 3 montre les mêmes prompts sur les deux.
Les licences ont changé aussi. 1.5 est sous licence CreativeML OpenRAIL-M et SDXL sous OpenRAIL++-M, toutes deux libres pour un usage commercial avec une liste d’usages interdits. Les modèles 3.x sont sous la Stability AI Community License, gratuite en dessous d’un million de dollars de revenus annuels.
Ce qu’on peut en faire : image-to-image, inpainting, ControlNet, LoRA
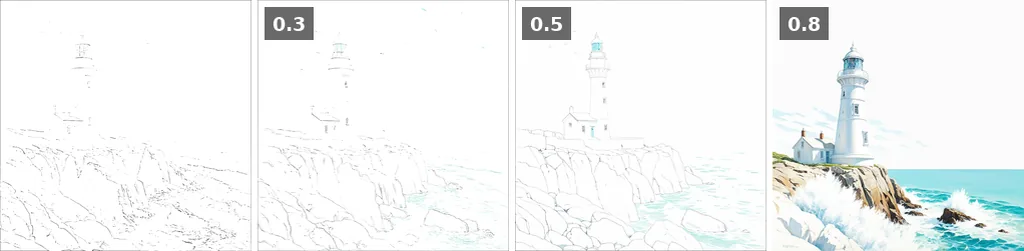
Le texte vers image n’est que le début, parce que chaque pièce du pipeline peut être réutilisée. Encodez un croquis en latent, n’ajoutez qu’une partie du bruit et débruitez à partir de là, et vous avez l’image-to-image, img2img dans les interfaces : le réglage de force (strength), ou denoise, est la quantité de bruit que vous ajoutez. L’idée vient de SDEdit. Masquez une région du latent et vous avez l’inpainting, ou l’outpainting quand le masque est hors du cadre. Ajoutez un petit réseau annexe qui lit une pose, une carte de profondeur ou des contours, et vous avez ControlNet. Entraînez quelques millions de poids supplémentaires sur vingt photos et vous avez un LoRA qui apprend au modèle un visage ou un style. Des modèles de super-résolution dédiés se chargent de l’agrandissement.
Pour le faire tourner vous-même, une carte NVIDIA récente avec 6 Go de mémoire vidéo (VRAM) suffit pour 1.5, et 8 Go pour SDXL. Les cartes AMD fonctionnent via ROCm, les puces Apple Silicon via le backend MPS. Le guide d’installation couvre les trois interfaces principales. Sans carte, les outils de ce site ne demandent aucun matériel : Stable Diffusion XL et Stable Diffusion 1.5 tournent sur le GPU du site avec la file d’attente affichée en direct, les prompts documentés montrent ce que fait chaque réglage, et 1 731 styles d’artistes montrent ce que le modèle a appris des peintres.
Stable Diffusion vs Midjourney vs DALL-E
Face à Midjourney et aux modèles d’image d’OpenAI, la différence n’est pas la qualité mais le contrôle. Les poids sont publics et le modèle tourne en local : vos images restent sur votre disque, vous choisissez le modèle, vous fixez la seed et vous pouvez changer n’importe quel composant. En échange, il vous en demande davantage. Midjourney demande une phrase et rend une image léchée ; Stable Diffusion demande un modèle, un prompt, un prompt négatif et une échelle de guidance, et vous donne exactement ce que vous avez réglé.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Poids | Publics, téléchargeables | Fermés | Fermés |
| Tourne sur votre ordinateur | Oui, 6 à 8 Go de VRAM | Non | Non |
| Prix | Gratuit en local ; outils gratuits en ligne | Abonnement | Abonnement ou à l’image |
| Contrôle | Seed, modèle, LoRA, ControlNet, inpainting, chaque réglage | Paramètres et références de style | Conversation |
| Fine-tuning | Oui, par n’importe qui | Non | Non |
| Texte dans les images | Faible avant 3, bon à partir de 3.5 | Bon depuis la v6 | Très bon |
Le même principe de diffusion alimente aujourd’hui des modèles d’autres laboratoires, avec d’autres encodeurs et d’autres licences : FLUX de Black Forest Labs, fondé par les auteurs originaux de Stable Diffusion, et Qwen-Image d’Alibaba. Ils tournent dans les mêmes interfaces, avec les mêmes seeds, étapes et samplers, donc l’essentiel de cette page s’y applique. Leur guidance fonctionne différemment, FLUX dev n’a pas de prompt négatif, et ils préfèrent les phrases complètes aux listes de mots-clés.
Sources, et comment réutiliser les figures
Les sources primaires, dans l’ordre où la page les rencontre :
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022 : l’article de Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020 : les processus direct et inverse et le programme en mille étapes.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021 : CLIP.
- Classifier-Free Diffusion Guidance, Ho et Salimans, 2022 : l’échelle de guidance.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, et Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024 : SDXL et Stable Diffusion 3.
Réutiliser les figures. Les rendus et schémas de cette page sont publiés sous CC BY 4.0 : réutilisez-les dans un cours, une conférence ou un article avec un lien vers cette page. Chaque rendu utilise Stable Diffusion XL, euler, 30 étapes, CFG 6, seed 20220822, le prompt ci-dessous et le prompt négatif « text, watermark, signature, blurry, low quality, storm, dark clouds, sunset ».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesCiter cette page.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion