Stable Diffusion باختصار
Stable Diffusion نموذج انتشار كامن (LDM) مفتوح المصدر: شبكة عصبية دُرّبت على تحويل ضجيج عشوائي إلى صورة، شيئًا فشيئًا، بتوجيه من نص. بناه فريق CompVis في جامعة لودفيغ ماكسيميليان في ميونخ بالتعاون مع Runway، ودُرّب بقدرة حوسبة من Stability AI على صور جمعتها منظمة LAION غير الربحية. وتعود الطريقة إلى ورقة High-Resolution Image Synthesis with Latent Diffusion Models (Rombach وزملاؤه، CVPR 2022).
نُشرت الأوزان في 22 أغسطس 2022. وذلك هو ما غيّر كل شيء. كان DALL-E 2 وMidjourney موجودين، لكن خلف قوائم انتظار ورصيد نقاط، على خوادم غيرك. أما Stable Diffusion فكان ملفًا بحجم 4 غيغابايت يعمل على بطاقة رسومات بذاكرة 8 غيغابايت، دون حساب ومع مرشّح أمان يمكنك تعطيله.
في غضون أسابيع ظهرت واجهات الويب والرسم الداخلي، ثم التعديلات المجتمعية وملفات LoRA وControlNet. وبعد أربع سنوات صار الاسم يعني شيئين. بالمعنى الدقيق، عائلة النماذج من 1.4 إلى 3.5. وبالمعنى الواسع، الممارسة كلها: تشغيل نماذج الصور على جهازك الخاص.
يشرح ما يلي الآلة نفسها، بالمفردات التي ستصادفها في كل واجهة: الفضاء الكامن، VAE، U-Net، CLIP، أداة أخذ العينات، مقياس التوجيه، السييد. لا حاجة إلى أي معادلة، لكن بضعة أرقام تساعد.
كيف يعمل Stable Diffusion؟ ثلاث شبكات وحلقة واحدة
ليس Stable Diffusion شبكة واحدة بل ثلاث شبكات تعمل واحدة تلو الأخرى.
- مشفّر نصوص يقرأ البرومبت ويحوّله إلى قائمة أرقام. في Stable Diffusion 1.5 هي 77 رمزًا، يوصف كل منها بـ768 رقمًا؛ و2,048 في SDXL الذي يشغّل مشفّرين.
- مزيل ضجيج، وهو U-Net في الإصدارات من 1 إلى XL ومحوّل (MMDiT) منذ الإصدار 3، يبدأ من كتلة ضجيج عشوائي وينظّفها على مدى 20 إلى 30 خطوة، مستشيرًا أرقام النص في كل خطوة. وهو لا يعمل على البكسلات بل على نسخة مضغوطة من الصورة، هي الصورة الكامنة (latent)، التي تعيش فيما يُسمى الفضاء الكامن: 4 × 64 × 64 رقمًا لصورة بحجم 512 بكسل، و4 × 128 × 128 لصورة SDXL ذات 1024 بكسل.
- مفكّك يحوّل تلك الصورة الكامنة إلى قيم البكسلات النهائية، الأحمر والأخضر والأزرق: 3 × 512 × 512، أو 3 × 1024 × 1024 في SDXL.
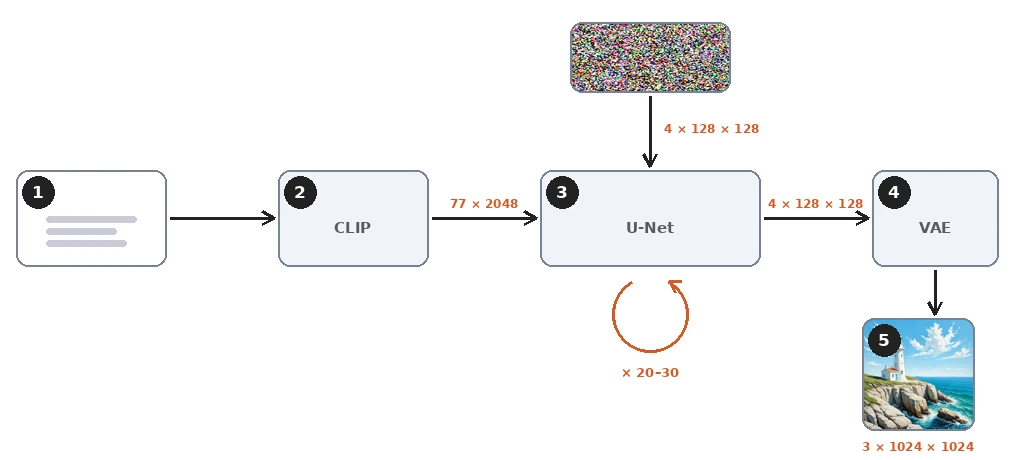
لا يُبحث عن شيء ولا يُنسخ شيء في الطريق. لا توجد قاعدة بيانات صور داخل الملف. الأوزان البالغة 2 إلى 16 غيغابايت تحمل ما تعلمته الشبكة عن كيفية تلازم الأوصاف والصور، وكل مخرَج يُحسب من الضجيج. يبقى أن الشبكة قد تحفظ صورًا ظهرت مرات كثيرة في التدريب، وقد استخرج الباحثون بضع مئات منها، لكن ذلك هو الاستثناء.
ما هو نموذج الانتشار؟ تعلّم إزالة الضجيج
العملية الأمامية: إضافة الضجيج
فكرة الانتشار سهلة الصياغة. خذ صورة مع وصفها. أضف إليها مقدارًا محسوبًا من الضجيج العشوائي. اطلب من شبكة أن تخمّن أي ضجيج أُضيف، وهي تعرف الوصف. قارن تخمينها بالحقيقة وصحّح الشبكة قليلًا.
إضافة الضجيج هي العملية الأمامية. وهي تتبع جدولًا ثابتًا من ألف مستوى، من حُبيبات خفيفة عند المستوى 50 إلى تشويش خالص عند المستوى 999. لا ترى الشبكة الجدول وهو يجري قط؛ هي لا ترى إلا صورة واحدة مشوّشة بالضجيج عند مستوى واحد في كل مرة.
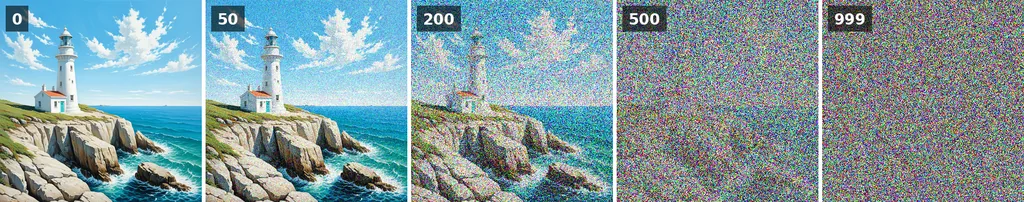
افعل ذلك على مليارات الأمثلة فتحصل على متنبّئ ضجيج: إذا أُعطي صورة مشوّشة بالضجيج ومستوى ضجيجها ونصًا، قال ما هو الضجيج على الأرجح. وهدف التدريب ليس سوى الفرق بين الضجيج المتنبَّأ به والضجيج الحقيقي. استغرق تدريب Stable Diffusion 1 نحو 150,000 ساعة على وحدات A100 الرسومية في مراكز البيانات، بحسب بطاقة النموذج.
العملية العكسية: متنبّئ الضجيج في العمل
يشغّل التوليد الدرس بالمقلوب. تلك هي العملية العكسية. ابدأ من ضجيج خالص، يختاره السييد. اسأل المتنبّئ ما هو الضجيج، أزل جزءًا منه، ثم اسأل مجددًا. كان DDPM، ورقة 2020 التي جعلت الانتشار عمليًا، يفعل ذلك في ألف خطوة صغيرة.
أداة أخذ العينات، وتُسمى المجدوِل في بعض الواجهات، هي القاعدة التي تقرر حجم كل خطوة وما إذا كان يُعاد إضافة قليل من الضجيج الجديد. أدوات أخذ العينات الأفضل، DDIM وEuler وعائلة DPM++، تخطو خطوات أكبر على المسار نفسه، ولهذا تكفي اليوم 20 إلى 30 خطوة.
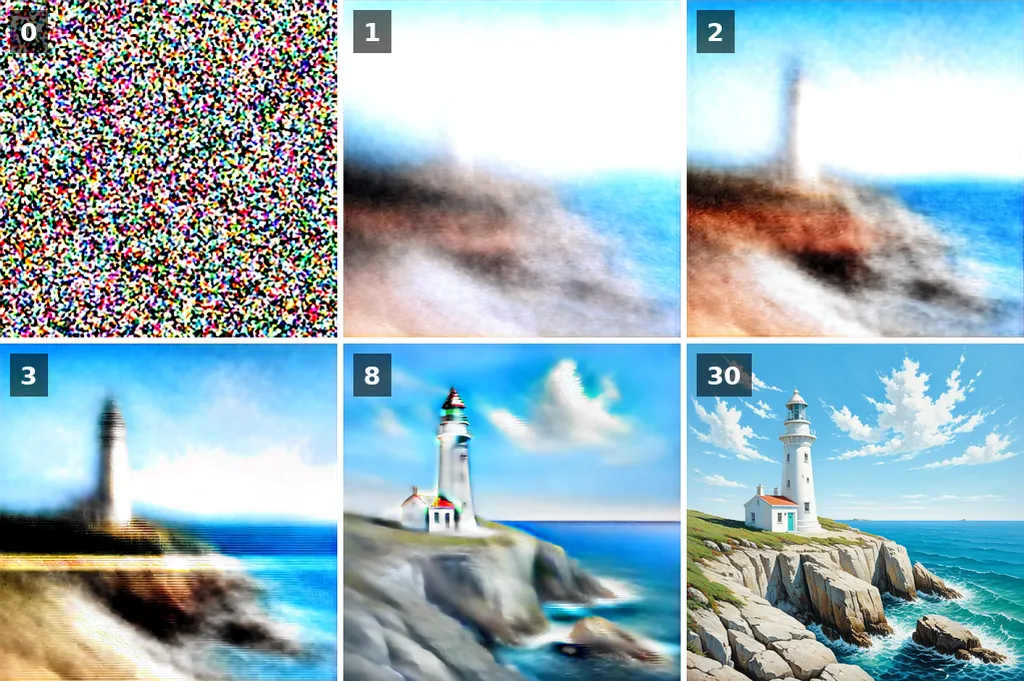
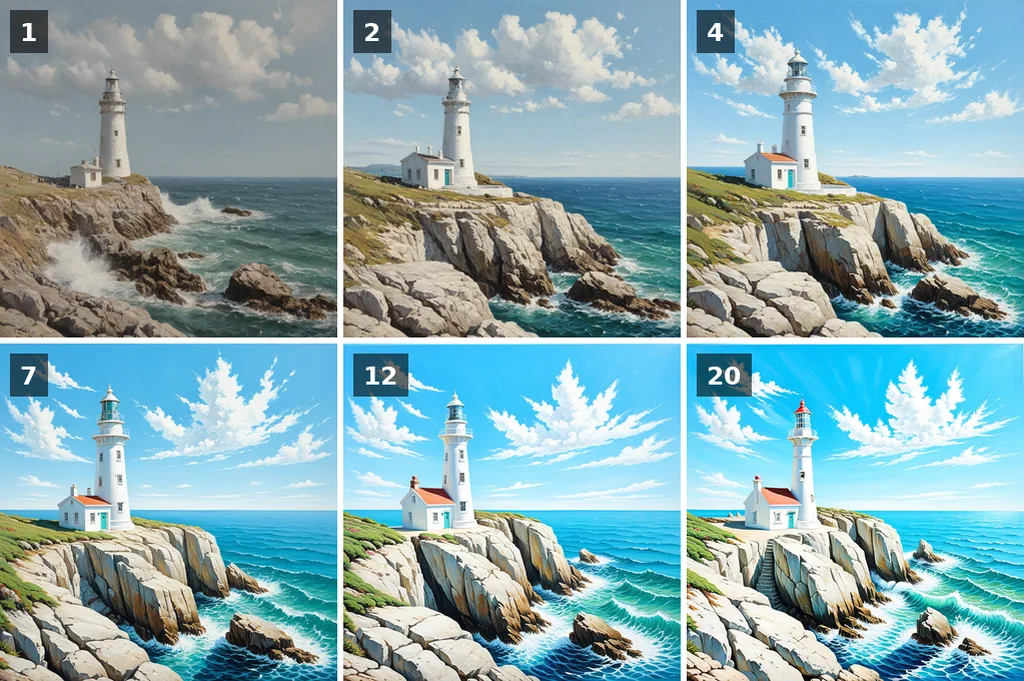
تُظهر الصورة الجزء الذي يستحق التذكر. في كل خطوة يحمل النموذج تخمينًا للصورة المكتملة، وهذا التخمين يستقر مبكرًا. الخطوتان أو الثلاث الأولى، والضجيج ما زال كثيفًا، تثبّت التكوين: أين الأفق، وأين تقف المنارة، وكم من السماء هناك. أما الخطوات اللاحقة فتصقل الملمس والتفاصيل الصغيرة.
يستعرض المنزلق أدناه التخمينات الثلاثين كلها للتوليد نفسه.
تترتب على ذلك نتيجتان عمليتان. تغيير عدد الخطوات يغيّر التفاصيل وأحيانًا التكوين، لأن الخطوات الأولى تحط على قيم أخرى؛ فهو لا يكتفي بزيادة حدة الصورة نفسها. والسييد نفسه بحجم صورة آخر يبدأ من كتلة ضجيج مختلفة، فيعطي صورة مختلفة أيضًا. اختر الحجم أولًا، ثم ابحث عن سييد.
الانتشار الكامن: حيلة VAE التي تجعله يعمل على بطاقة ألعاب
كانت نماذج الانتشار الأولى تعمل على البكسلات. صورة 512 × 512 هي 786,432 رقمًا، وكان على المتنبّئ أن يقرأها ويكتبها كلها في كل خطوة من خطواته. تحايلت نماذج البكسلات مثل DALL-E 2 وImagen على ذلك بالانتشار عند 64 بكسلًا وإضافة شبكات تكبير، ولم تُنشر على أي حال.
يضيف Stable Diffusion مشفّرًا ذاتيًا تبايُنيًا، هو VAE. يضغط مشفّره الصورة بعامل ثمانية على كل ضلع إلى أربع قنوات: 4 × 64 × 64، أي 16,384 رقمًا، أقل بـ48 مرة. ويجري الانتشار كله في ذلك الفضاء المضغوط، الفضاء الكامن. وفي النهاية فقط يوسّع مفكّك VAE النتيجة إلى بكسلات.

الصورة الكامنة ليست صورة صغيرة. قنواتها الأربع شيفرة يعرف المفكّك كيف يقرؤها، ولا تبدو أي قناة بمفردها شبيهة تمامًا بالصورة. لكن التخطيط يصمد أمام الضغط، وهذا ما يتيح لمزيل الضجيج أن يقرر التكوين في فضاء بهذا الصغر.
ولهذا أيضًا يؤثر اختيار VAE في الألوان والتفاصيل الدقيقة: كل رقم كامن يمثل رقعة من 8 × 8 بكسلات، والمفكّك يبتكر ما بداخل الرقعة. انتقل Stable Diffusion 3 إلى صورة كامنة من 16 قناة لهذا السبب بالذات، فتحسنت معه التفاصيل الدقيقة والنصوص الصغيرة.
CLIP والانتباه المتقاطع: كيف يوجّه النص الصورة
ثلاث قطع تحوّل الكلمات إلى اتجاه لمزيل الضجيج.
المُرمِّز ومشفّر النصوص: كيف يقرأ CLIP البرومبت
المُرمِّز يقطّع البرومبت إلى رموز، كلمات شائعة كاملة أو أجزاء من كلمات أندر. يقرأ Stable Diffusion 1.5 وSDXL 77 رمزًا على الأكثر، اثنان منها علامتا بداية ونهاية، أي نحو 50 إلى 60 كلمة إنجليزية. وما بعد ذلك يُقطع، ما لم تقسّمه الواجهة إلى عدة كتل. ضع الأهم في البداية.
مشفّر النصوص في 1.5 هو CLIP، شبكة دربتها OpenAI على 400 مليون زوج من الصور والأوصاف بمهمة واحدة: تقريب الأرقام التي تصف الوصف من الأرقام التي تصف صورته. بعد ذلك التدريب، تحمل أرقام كلمة «lighthouse» مسبقًا شكل المنارات. يشغّل SDXL مشفّرين من هذا النوع جنبًا إلى جنب، الثاني إعادة تدريب مفتوحة أجرتها LAION على ملياري زوج. ويضيف Stable Diffusion 3 ثالثًا، T5، يقرأ الجمل كاملة.
الانتباه المتقاطع داخل U-Net
الانتباه المتقاطع هو موضع التقاء النص بالصورة. U-Net سلسلة من كتل الالتفاف تقلّص الصورة الكامنة ثم تعيد تكبيرها، مع وصلات تخطٍّ بين الأحجام المتطابقة. وبين تلك الكتل تقع طبقات الانتباه. في كل خطوة، تنظر كل منطقة من الصورة الكامنة إلى متجهات الرموز الـ77 وتزن أيها يخصها. منطقة السماء تنتبه إلى «sunset» و«clouds»، والصخرة إلى «cliff». ولهذا يكون لترتيب الكلمات والتكرار وصيغة الأوزان في الواجهات أثر، ولهذا تصبغ كلمة أسلوب في البداية الصورة كلها.
وهذا أيضًا حدّ الإصدارات الأولى. تعلّم CLIP من نصوص بديلة قصيرة، فهو يفهم قوائم المواضيع والأساليب جيدًا والعلاقات بينها بشكل سيئ. «A red cube on a blue sphere» تخرج معكوسة في الغالب في 1.5. يعرض دليل البرومبت ما ينجح بثبات.
مقياس التوجيه والبرومبت السلبي والسييد: الإعدادات الثلاثة
ثلاثة إعدادات تظهر في كل واجهة لـStable Diffusion. وهي تقابل مباشرة الآلية المشروحة أعلاه.
مقياس التوجيه، اختصارًا لعبارة التوجيه الخالي من المصنِّف (classifier-free guidance، CFG)، هو الذي يقرر مدى قوة دفع النص. في كل خطوة يصنع مزيل الضجيج في الواقع تنبؤين: واحدًا بالبرومبت وآخر ببرومبت فارغ. والفرق بين الاثنين هو الاتجاه الذي يعطيه البرومبت. والتنبؤ النهائي هو التنبؤ الفارغ مضافًا إليه ذلك الفرق مضروبًا في مقياس التوجيه. عند 1 يُستخدم التنبؤ بالبرومبت كما هو، دون دفع: تتبع الصورة النص تبعًا فضفاضًا، بألوان باهتة وسماء رمادية حيث طلب البرومبت سماء زرقاء. وحول 5 إلى 8 تتبع البرومبت عن قرب بألوان طبيعية. وبعد 12 يشتد التباين وتتشبع الألوان وتصبح الضربات قاسية.
البرومبت السلبي يحل محل البرومبت الفارغ في ذلك التنبؤ الثاني. فبدل أن يقرأ المرور الثاني لا شيء، يقرأ «blurry, text, watermark»، ويدفع التوجيه بعيدًا عنه. لا يكلف ذلك شيئًا إضافيًا، لأن المرور الثاني يجري على أي حال، ولا يعمل إلا حين يكون التوجيه أعلى من 1. يقدم دليل البرومبت السلبي قوائم جاهزة.
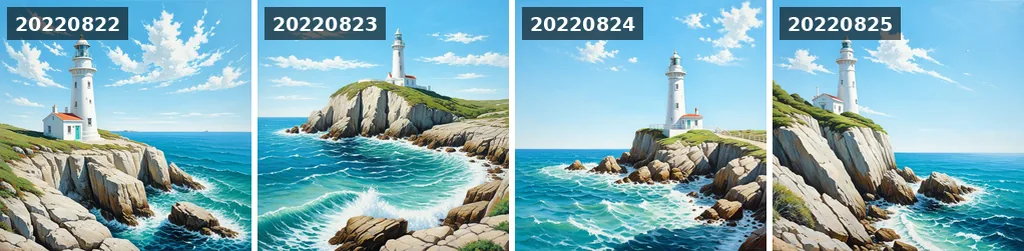
السييد هو الرقم الذي يولّد الضجيج الأولي. السييد نفسه والبرومبت نفسه والإعدادات نفسها والنموذج نفسه تعطي الصورة نفسها، حتى البكسل، على البرمجية والعتاد نفسيهما؛ أما واجهة أخرى أو بطاقة أخرى فترسم الضجيج بشكل مختلف. غيّر السييد فيتغير التكوين، لأن الخطوات الأولى تقرأ كتلة ضجيج أخرى. غيّر كلمة واحدة من البرومبت واحتفظ بالسييد، فيبقى معظم الصورة في العادة. هكذا يُحسَّن البرومبت.
من U-Net إلى المحوّل: الإصدارات من 1.5 إلى 3.5
ظهرت ستة أجيال رئيسية في عامين، الأولان من CompVis وRunway، والبقية من Stability AI. غيّر كل منها واحدة على الأقل من الشبكات الثلاث.
| الإصدار | التاريخ | مزيل الضجيج | مشفّرات النصوص | الحجم الأصلي |
|---|---|---|---|---|
| 1.4 و1.5 | أغسطس وأكتوبر 2022 | U-Net، 860 مليون معامل | CLIP ViT-L | 512 بكسل |
| 2.0 و2.1 | نوفمبر وديسمبر 2022 | U-Net بالتصميم نفسه، أُعيد تدريبه من الصفر | OpenCLIP ViT-H | 768 بكسل |
| SDXL 1.0 | يوليو 2023 | U-Net، 2.6 مليار، مع refiner | CLIP ViT-L وOpenCLIP ViT-bigG | 1024 بكسل |
| SDXL Turbo | نوفمبر 2023 | SDXL مقطَّر إلى 1 إلى 4 خطوات | كما في SDXL | 512 بكسل |
| 3 Medium | يونيو 2024 | محوّل انتشار (MMDiT)، 2 مليار | CLIP ViT-L وOpenCLIP bigG وT5-XXL | 1024 بكسل |
| 3.5 Large وLarge Turbo وMedium | أكتوبر 2024 | MMDiT، 8 مليارات؛ Medium 2.5 مليار | الثلاثة نفسها | 1024 بكسل |
1.5 يبقى واحدًا من أكثر النماذج تعديلًا على الإطلاق، بعشرات الآلاف من ملفات checkpoint وLoRA المجتمعية، وما زال يعمل بذاكرة فيديو 4 غيغابايت. SDXL هو حصان العمل: أيدٍ ووجوه وتكوين أفضل، وإخراج أصلي بحجم 1024 بكسل. 3 و3.5 استبدلا بـU-Net محوّلًا يعالج رموز النص والصورة معًا، وهو ما جعل النص المقروء في الصور ممكنًا أخيرًا: ضع الكلمات بين علامتي اقتباس في البرومبت. تعرض مقارنة SDXL وStable Diffusion 3 البرومبتات نفسها على كليهما.
تغيرت الرخص أيضًا. 1.5 تحت رخصة CreativeML OpenRAIL-M وSDXL تحت OpenRAIL++-M، وكلتاهما مجانية للاستخدام التجاري مع قائمة استخدامات محظورة. أما نماذج 3.x فتحت Stability AI Community License، المجانية دون مليون دولار من الإيرادات السنوية.
ما يمكنك فعله به: image-to-image والرسم الداخلي وControlNet وLoRA
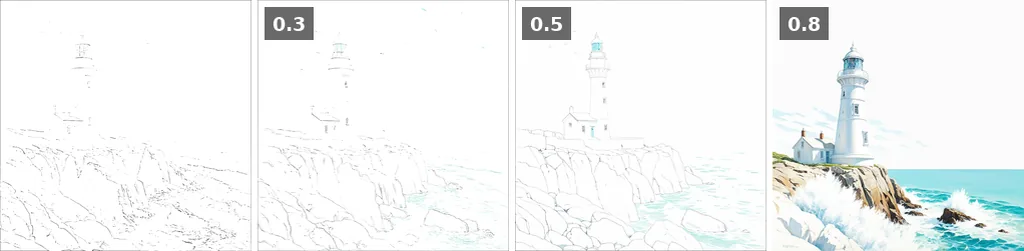
النص إلى صورة ليس إلا البداية، لأن كل قطعة من المسار يمكن إعادة استخدامها. شفّر رسمًا تخطيطيًا إلى صورة كامنة، أضف جزءًا من الضجيج فقط وأزل الضجيج من هناك، فتحصل على التحويل من صورة إلى صورة (image-to-image)، أو img2img في الواجهات: إعداد القوة، أو denoise، هو مقدار الضجيج الذي تضيفه. الفكرة من SDEdit. ضع قناعًا على منطقة واحدة من الصورة الكامنة فتحصل على الرسم الداخلي، أو التوسيع حين يكون القناع خارج الإطار. أضف شبكة جانبية صغيرة تقرأ وضعية أو خريطة عمق أو حوافّ، فتحصل على ControlNet. درّب بضعة ملايين من الأوزان الإضافية على عشرين صورة فتحصل على LoRA يعلّم النموذج وجهًا أو أسلوبًا. وتتولى نماذج الدقة الفائقة المخصصة التكبير.
لتشغيله بنفسك تكفي بطاقة NVIDIA حديثة بذاكرة فيديو (VRAM) 6 غيغابايت لـ1.5 و8 غيغابايت لـSDXL. بطاقات AMD تعمل عبر ROCm، وApple Silicon عبر الواجهة الخلفية MPS. يغطي دليل التثبيت الواجهات الرئيسية الثلاث. ودون بطاقة، لا تحتاج أدوات هذا الموقع إلى أي عتاد: يعمل Stable Diffusion XL وStable Diffusion 1.5 على وحدة GPU الخاصة بالموقع مع عرض الطابور مباشرة، وتُظهر البرومبتات الموثّقة ما يفعله كل إعداد، ويُظهر 1,731 أسلوب فنان ما تعلمه النموذج عن الرسامين.
Stable Diffusion مقابل Midjourney مقابل DALL-E
في مواجهة Midjourney ونماذج الصور من OpenAI، الفرق ليس في الجودة بل في التحكم. الأوزان علنية والنموذج يعمل محليًا: تبقى صورك على قرصك، وأنت تختار النموذج، وتحدد السييد، ويمكنك تغيير أي مكوّن. وفي المقابل يطلب منك أكثر. يطلب Midjourney جملة ويعطي صورة مصقولة؛ ويطلب Stable Diffusion نموذجًا وبرومبتًا وبرومبتًا سلبيًا ومقياس توجيه، ويعطيك بالضبط ما ضبطته.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| الأوزان | علنية، قابلة للتنزيل | مغلقة | مغلقة |
| يعمل على حاسوبك | نعم، 6 إلى 8 غيغابايت من VRAM | لا | لا |
| السعر | مجاني محليًا؛ أدوات مجانية على الإنترنت | اشتراك | اشتراك أو بالصورة |
| التحكم | السييد، النموذج، LoRA، ControlNet، الرسم الداخلي، كل إعداد | معاملات ومراجع أسلوب | محادثة |
| إعادة التدريب | نعم، لأي شخص | لا | لا |
| النص في الصور | ضعيف قبل 3، جيد منذ 3.5 | جيد منذ v6 | جيد جدًا |
مبدأ الانتشار نفسه يشغّل اليوم نماذج من مختبرات أخرى، بمشفّرات أخرى ورخص أخرى: FLUX من Black Forest Labs، التي أسسها مؤلفو Stable Diffusion الأصليون، وQwen-Image من Alibaba. تعمل في الواجهات نفسها، بالسييدات والخطوات وأدوات أخذ العينات نفسها، فمعظم هذه الصفحة ينطبق عليها. يعمل توجيهها بشكل مختلف، وFLUX dev لا برومبت سلبي له، وهي تفضّل الجمل الكاملة على قوائم الكلمات المفتاحية.
المصادر، وكيف تعيد استخدام الصور
المصادر الأولية، بترتيب ورودها في الصفحة:
- High-Resolution Image Synthesis with Latent Diffusion Models، Rombach وآخرون، 2022: ورقة Stable Diffusion.
- Denoising Diffusion Probabilistic Models، Ho وآخرون، 2020: العمليتان الأمامية والعكسية وجدول الألف خطوة.
- Learning Transferable Visual Models From Natural Language Supervision، Radford وآخرون، 2021: CLIP.
- Classifier-Free Diffusion Guidance، Ho وSalimans، 2022: مقياس التوجيه.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis، 2023، وScaling Rectified Flow Transformers for High-Resolution Image Synthesis، 2024: SDXL وStable Diffusion 3.
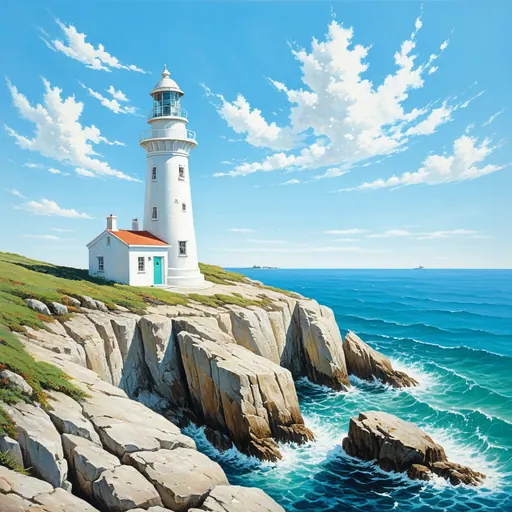
إعادة استخدام الصور. التوليدات والمخططات في هذه الصفحة منشورة تحت رخصة CC BY 4.0: أعد استخدامها في درس أو محاضرة أو مقال مع رابط إلى هذه الصفحة. يستخدم كل توليد Stable Diffusion XL، euler، 30 خطوة، CFG 6، سييد 20220822، البرومبت أدناه، والبرومبت السلبي «text, watermark, signature, blurry, low quality, storm, dark clouds, sunset».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesللاستشهاد بهذه الصفحة.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion