Stable Diffusion 한눈에 보기
Stable Diffusion은 오픈소스 잠재 확산 모델(latent diffusion model, LDM)입니다. 텍스트의 안내를 받아 무작위 노이즈를 조금씩 그림으로 바꾸도록 학습된 신경망입니다. 뮌헨 루트비히 막시밀리안 대학교의 CompVis 그룹이 Runway와 함께 만들었고, Stability AI가 제공한 컴퓨팅 자원으로, 비영리 단체 LAION이 수집한 이미지로 학습되었습니다. 방법론은 논문 High-Resolution Image Synthesis with Latent Diffusion Models(Rombach 외, CVPR 2022)에서 나왔습니다.
가중치는 2022년 8월 22일에 공개되었습니다. 모든 것을 바꾼 것은 바로 이 부분입니다. DALL-E 2와 Midjourney는 이미 있었지만, 대기 명단과 크레딧 뒤에, 남의 서버 위에 있었습니다. Stable Diffusion은 메모리 8 GB 그래픽카드에서 돌아가는 4 GB짜리 파일이었고, 계정이 필요 없었으며, 안전 필터는 직접 끌 수 있었습니다.
몇 주 만에 웹 인터페이스와 인페인팅이 나왔고, 이어서 파인튜닝 모델, LoRA, ControlNet이 등장했습니다. 4년이 지난 지금 이 이름은 두 가지를 뜻합니다. 좁게는 1.4부터 3.5까지의 모델 계열, 넓게는 이미지 모델을 자기 컴퓨터에서 돌리는 활동 전체입니다.
아래에서는 어떤 인터페이스에서든 마주치게 될 용어로 이 기계 자체를 설명합니다. 잠재 공간, VAE, U-Net, CLIP, 샘플러, 가이던스 스케일, 시드. 수식은 필요 없지만 숫자 몇 개는 도움이 됩니다.
Stable Diffusion은 어떻게 작동하나요? 세 개의 네트워크와 하나의 루프
Stable Diffusion은 네트워크 하나가 아니라 셋이며, 차례로 실행됩니다.
- 텍스트 인코더가 프롬프트를 읽어 숫자 목록으로 바꿉니다. Stable Diffusion 1.5에서는 토큰 77개이고 각 토큰은 숫자 768개로 표현됩니다. 인코더 두 개를 쓰는 SDXL에서는 2,048개입니다.
- 디노이저(노이즈 제거기)는 버전 1부터 XL까지는 U-Net, 버전 3부터는 트랜스포머(MMDiT)입니다. 무작위 노이즈 덩어리에서 출발해 20~30스텝에 걸쳐 노이즈를 걷어 내며, 매 스텝마다 텍스트 숫자를 참조합니다. 픽셀이 아니라 이미지의 압축본인 잠재 표현(latent)을 다루며, 이것은 잠재 공간이라 불리는 곳에 있습니다. 512픽셀 이미지는 4 × 64 × 64개, SDXL의 1024픽셀은 4 × 128 × 128개의 숫자입니다.
- 디코더가 그 잠재 표현을 최종 픽셀 값, 즉 빨강, 초록, 파랑으로 바꿉니다. 3 × 512 × 512, SDXL은 3 × 1024 × 1024입니다.
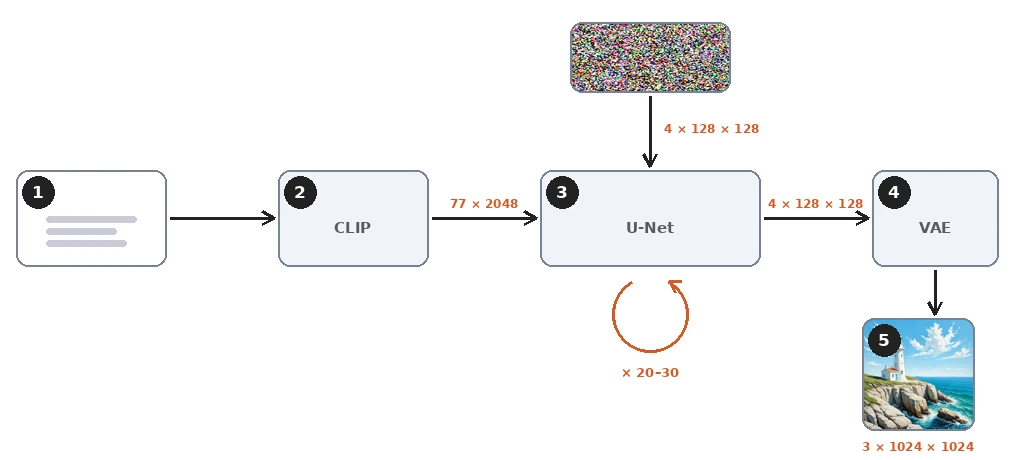
이 과정에서 무언가를 검색하거나 복사하는 일은 없습니다. 파일 안에 이미지 데이터베이스는 없습니다. 2~16 GB의 가중치가 담고 있는 것은 캡션과 이미지가 어떻게 어울리는지 네트워크가 배운 내용이며, 모든 결과물은 노이즈에서 계산됩니다. 그래도 학습 데이터에 여러 번 등장한 이미지를 네트워크가 외울 수는 있고, 연구자들이 그중 수백 장을 추출해 냈지만, 그것은 예외입니다.
확산 모델(디퓨전 모델)이란? 노이즈 제거를 배우다
정방향 과정: 노이즈 더하기
확산의 아이디어는 말로 하면 간단합니다. 캡션이 달린 사진 한 장을 가져옵니다. 거기에 정해진 양의 무작위 노이즈를 더합니다. 캡션을 알고 있는 네트워크에게 어떤 노이즈가 더해졌는지 맞혀 보라고 합니다. 그 추측을 정답과 비교해 네트워크를 조금 고칩니다.
노이즈를 더하는 쪽이 정방향 과정(forward process)입니다. 천 단계의 고정된 스케줄을 따르며, 50단계의 희미한 입자에서 999단계의 완전한 잡음까지 이어집니다. 네트워크는 스케줄이 진행되는 모습을 보지 않습니다. 한 번에 한 단계의 노이즈 이미지 한 장만 봅니다.
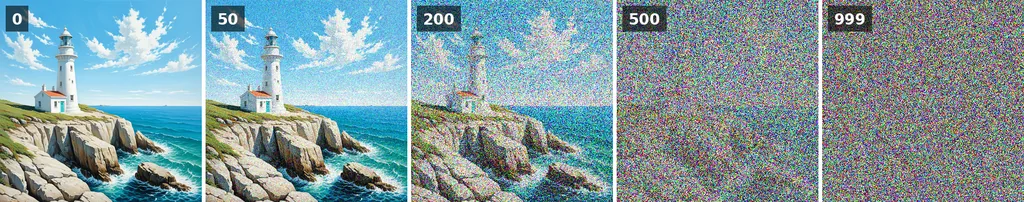
이것을 수십억 개의 예시에 반복하면 노이즈 예측기가 됩니다. 노이즈 낀 이미지, 그 노이즈 단계, 텍스트를 주면 노이즈가 아마 무엇인지 답합니다. 학습 목표는 예측한 노이즈와 실제 노이즈의 차이뿐입니다. 모델 카드에 따르면 Stable Diffusion 1의 학습에는 데이터센터용 A100 GPU로 약 150,000시간이 걸렸습니다.
역방향 과정: 노이즈 예측기의 실전
생성은 이 학습 과정을 거꾸로 돌립니다. 이것이 역방향 과정(reverse process)입니다. 시드가 고른 순수한 노이즈에서 출발합니다. 예측기에게 노이즈가 무엇인지 묻고, 그 일부를 제거하고, 다시 묻습니다. 확산을 실용적으로 만든 2020년 논문 DDPM은 이것을 천 번의 작은 스텝으로 수행했습니다.
샘플러는 일부 인터페이스에서 스케줄러라고도 하며, 각 스텝의 크기와 새 노이즈를 조금 되돌려 넣을지를 정하는 규칙입니다. DDIM, Euler, DPM++ 계열 같은 더 나은 샘플러는 같은 경로를 더 큰 보폭으로 걷기 때문에 오늘날에는 20~30스텝이면 충분합니다.
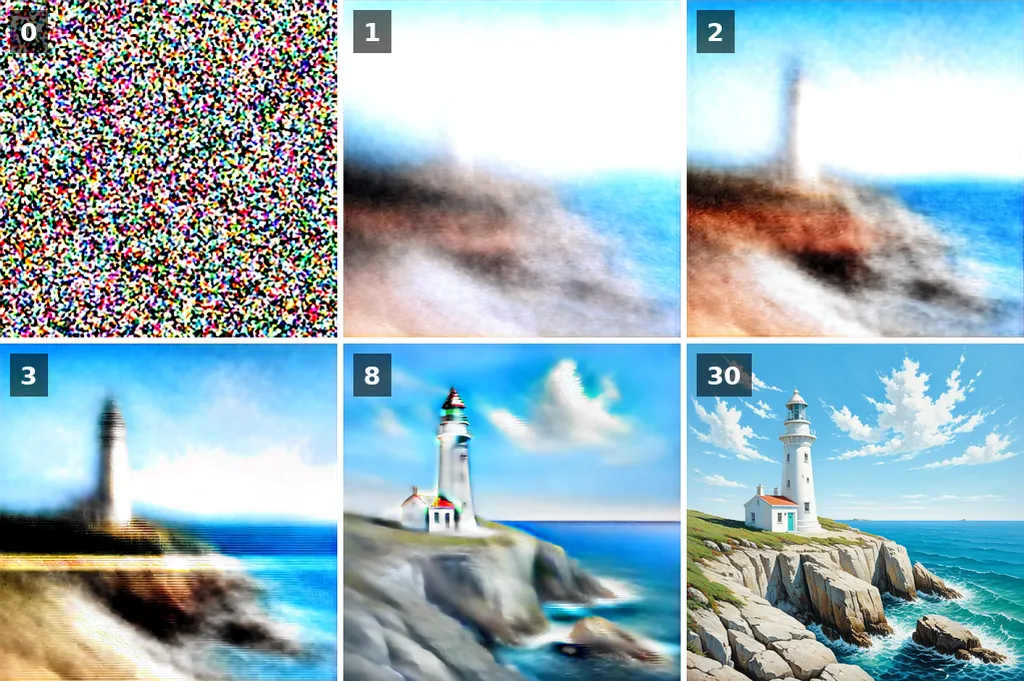
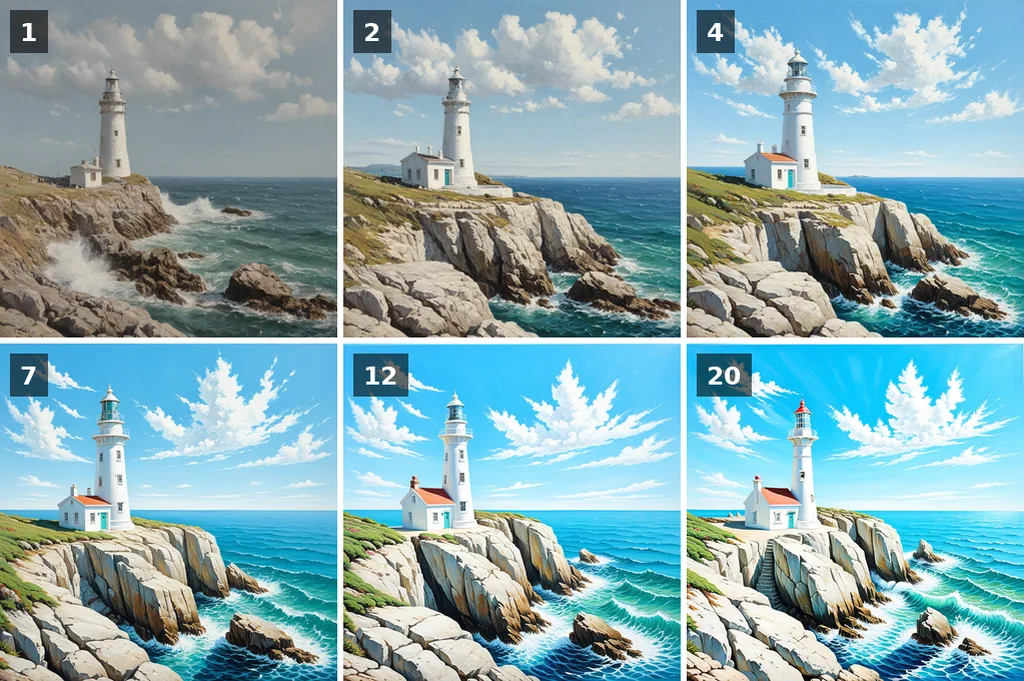
이 그림이 보여 주는 것이 기억해 둘 핵심입니다. 모델은 매 스텝마다 완성 이미지에 대한 추측을 갖고 있고, 그 추측은 일찍 자리를 잡습니다. 노이즈가 아직 짙은 처음 두세 스텝이 구도를 정합니다. 수평선이 어디인지, 등대가 어디에 서는지, 하늘이 얼마나 차지하는지. 이후 스텝은 질감과 작은 디테일을 다듬습니다.
아래 슬라이더로 같은 생성의 서른 가지 추측을 모두 넘겨 볼 수 있습니다.
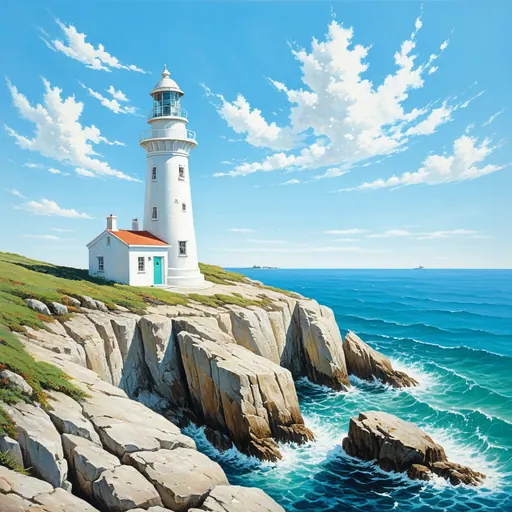
여기서 실용적인 결론 두 가지가 나옵니다. 스텝 수를 바꾸면 디테일이 바뀌고 때로는 구도도 바뀝니다. 초반 스텝이 다른 값에 도달하기 때문이며, 같은 그림이 단순히 더 선명해지는 것이 아닙니다. 그리고 같은 시드라도 이미지 크기가 다르면 다른 노이즈 덩어리에서 출발하므로 역시 다른 그림이 나옵니다. 크기를 먼저 정한 다음 시드를 찾으세요.
잠재 확산(latent diffusion): 게이밍 그래픽카드에 들어가게 한 VAE의 묘수
초기 확산 모델은 픽셀 위에서 작동했습니다. 512 × 512 이미지는 숫자 786,432개이고, 예측기는 매 스텝마다 그 전부를 읽고 써야 했습니다. DALL-E 2나 Imagen 같은 픽셀 모델은 64픽셀에서 확산한 뒤 업스케일링 네트워크를 덧붙여 이를 피했고, 어차피 공개되지도 않았습니다.
Stable Diffusion은 변분 오토인코더, 즉 VAE를 추가합니다. VAE의 인코더는 이미지를 가로세로 각각 여덟 배씩 줄여 네 개의 채널로 압축합니다. 4 × 64 × 64, 즉 16,384개의 숫자로 48배 적습니다. 확산은 전적으로 이 압축된 공간, 곧 잠재 공간에서 이루어집니다. 맨 마지막에야 VAE의 디코더가 결과를 픽셀로 펼칩니다.

잠재 표현은 작은 그림이 아닙니다. 네 채널은 디코더가 읽는 법을 아는 부호이고, 어느 채널도 혼자서는 이미지와 그리 닮지 않았습니다. 하지만 배치는 압축 후에도 남기 때문에, 디노이저가 이렇게 작은 공간에서도 구도를 정할 수 있습니다.
VAE 선택이 색감과 미세한 디테일에 영향을 주는 이유도 여기에 있습니다. 잠재 표현의 숫자 하나는 8 × 8픽셀 조각 하나를 대표하고, 그 조각 안의 내용은 디코더가 지어냅니다. Stable Diffusion 3가 바로 그 이유로 16채널 잠재 표현으로 옮겨 갔고, 미세한 디테일과 작은 글자가 그와 함께 좋아졌습니다.
CLIP과 크로스 어텐션: 텍스트는 어떻게 이미지를 이끄나
세 가지 부품이 단어를 디노이저가 따라갈 방향으로 바꿉니다.
토크나이저와 텍스트 인코더: CLIP은 프롬프트를 어떻게 읽나
토크나이저는 프롬프트를 토큰으로 자릅니다. 흔한 단어는 통째로, 드문 단어는 조각으로 나뉩니다. Stable Diffusion 1.5와 SDXL은 최대 77토큰을 읽으며, 그중 둘은 시작과 끝 표시입니다. 영어 단어로 50~60개 정도입니다. 그 이상은 인터페이스가 여러 패스로 나누지 않는 한 잘립니다. 가장 중요한 내용을 앞에 두세요.
1.5의 텍스트 인코더는 CLIP입니다. OpenAI가 이미지와 캡션 4억(400M) 쌍으로 학습시킨 네트워크로, 과제는 하나였습니다. 캡션을 나타내는 숫자를 그 이미지를 나타내는 숫자에 가깝게 만드는 것. 그 학습을 거치면 "lighthouse"의 숫자에는 이미 등대의 생김새가 담겨 있습니다. SDXL은 이런 인코더 두 개를 나란히 돌리며, 두 번째는 LAION이 20억 쌍으로 다시 학습시킨 공개 버전입니다. Stable Diffusion 3는 문장 전체를 읽는 세 번째 인코더 T5를 추가합니다.
U-Net 안의 크로스 어텐션
크로스 어텐션은 텍스트와 그림이 만나는 곳입니다. U-Net은 잠재 표현을 줄였다가 다시 키우는 합성곱 블록의 묶음이며, 크기가 같은 블록끼리 스킵 연결로 이어져 있습니다. 그 블록들 사이에 어텐션 층이 있습니다. 매 스텝마다 잠재 표현의 각 영역이 77개의 토큰 벡터를 보고 그중 어느 것이 자신과 관계있는지 가중치를 매깁니다. 하늘 영역은 "sunset"과 "clouds"에, 바위는 "cliff"에 주목합니다. 어순, 반복, 인터페이스의 가중치 문법이 효과를 내는 이유, 그리고 앞에 둔 스타일 단어가 이미지 전체를 물들이는 이유가 여기에 있습니다.
이것은 초기 버전의 한계이기도 합니다. CLIP은 짧은 alt 텍스트에서 배웠기 때문에 피사체와 스타일의 나열은 잘 이해하지만 그들 사이의 관계는 잘 모릅니다. "A red cube on a blue sphere"(파란 구 위의 빨간 정육면체)는 1.5에서 종종 뒤바뀌어 나옵니다. 프롬프트 가이드에 확실히 통하는 방법을 정리해 두었습니다.
가이던스 스케일(CFG), 네거티브 프롬프트, 시드: 세 가지 설정
모든 Stable Diffusion 인터페이스에 세 가지 설정이 나옵니다. 위에서 설명한 구조에 그대로 대응합니다.
가이던스 스케일은 분류기 없는 가이던스(classifier-free guidance, CFG)의 줄임말로, 텍스트를 얼마나 세게 밀어붙일지 정합니다. 매 스텝마다 디노이저는 실제로 두 가지 예측을 합니다. 하나는 프롬프트로, 하나는 빈 프롬프트로. 둘의 차이가 프롬프트가 주는 방향입니다. 최종 예측은 빈 프롬프트의 예측에 그 차이를 가이던스 스케일만큼 곱해 더한 것입니다. 1에서는 프롬프트 예측이 그대로 쓰이고 밀어붙이는 힘이 없습니다. 이미지는 텍스트를 느슨하게 따르고, 색은 탁하며, 프롬프트가 파란 하늘을 요구해도 하늘은 회색입니다. 5~8 근처에서는 프롬프트를 충실히 따르고 색도 자연스럽습니다. 12를 넘으면 대비가 딱딱해지고 색이 과포화되며 붓질이 거칠어집니다.
네거티브 프롬프트는 그 두 번째 예측의 빈 프롬프트를 대체합니다. 두 번째 패스는 아무것도 읽지 않는 대신 "blurry, text, watermark"를 읽고, 가이던스는 그 반대 방향으로 밉니다. 두 번째 패스는 어차피 실행되므로 추가 비용이 없고, 가이던스가 1보다 클 때만 작동합니다. 네거티브 프롬프트 가이드에 실제로 쓸 수 있는 목록이 있습니다.
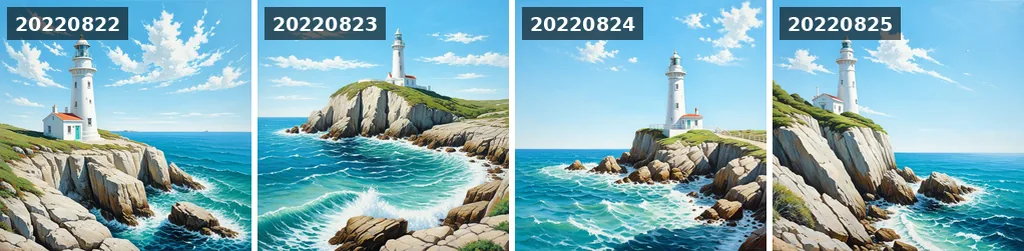
시드는 시작 노이즈를 만들어 내는 숫자입니다. 같은 시드, 같은 프롬프트, 같은 설정, 같은 모델이면 같은 소프트웨어와 하드웨어에서 픽셀 단위로 같은 이미지가 나옵니다. 다른 인터페이스나 다른 그래픽카드는 노이즈를 다르게 뽑습니다. 시드를 바꾸면 첫 스텝들이 다른 노이즈 덩어리를 읽으므로 구도가 바뀝니다. 프롬프트의 단어 하나만 바꾸고 시드를 유지하면 그림의 대부분은 보통 유지됩니다. 프롬프트는 이렇게 다듬습니다.
U-Net에서 트랜스포머로: 1.5부터 3.5까지의 버전
2년 동안 여섯 개의 주요 세대가 나왔습니다. 처음 둘은 CompVis와 Runway, 나머지는 Stability AI가 만들었습니다. 각 세대는 세 네트워크 중 적어도 하나를 바꿨습니다.
| 버전 | 공개일 | 디노이저 | 텍스트 인코더 | 기본 해상도 |
|---|---|---|---|---|
| 1.4와 1.5 | 2022년 8월과 10월 | U-Net, 파라미터 860M | CLIP ViT-L | 512 px |
| 2.0과 2.1 | 2022년 11월과 12월 | 같은 설계의 U-Net을 처음부터 다시 학습 | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | 2023년 7월 | U-Net, 2.6B, 리파이너 추가 | CLIP ViT-L과 OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | 2023년 11월 | 1~4스텝으로 증류한 SDXL | SDXL과 동일 | 512 px |
| 3 Medium | 2024년 6월 | 디퓨전 트랜스포머(MMDiT), 2B | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | 2024년 10월 | MMDiT, 8B; Medium은 2.5B | 같은 세 개 | 1024 px |
1.5는 지금도 가장 많이 파인튜닝된 모델 중 하나로, 커뮤니티 체크포인트와 LoRA가 수만 개에 이르며 여전히 VRAM 4 GB에서 돌아갑니다. SDXL은 주력입니다. 손, 얼굴, 구도가 더 좋아졌고 1024픽셀을 기본으로 출력합니다. 3과 3.5는 U-Net을 텍스트와 이미지 토큰을 함께 처리하는 트랜스포머로 바꿨고, 그 덕분에 마침내 이미지 안에 읽을 수 있는 글자를 넣을 수 있게 되었습니다. 프롬프트에서 단어를 따옴표로 감싸면 됩니다. SDXL과 Stable Diffusion 3 비교에서 같은 프롬프트를 두 모델로 돌려 본 결과를 볼 수 있습니다.
라이선스도 바뀌었습니다. 1.5는 CreativeML OpenRAIL-M 라이선스, SDXL은 OpenRAIL++-M이며, 둘 다 금지 용도 목록이 붙은 채로 상업적 이용이 무료입니다. 3.x 모델은 Stability AI Community License로, 연 매출 백만 달러 미만이면 무료입니다.
무엇을 할 수 있나: 이미지 투 이미지, 인페인팅, ControlNet, LoRA
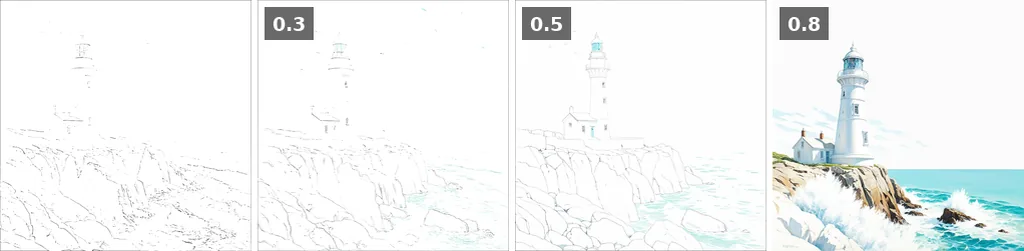
텍스트 투 이미지는 시작일 뿐입니다. 파이프라인의 모든 부품을 재사용할 수 있기 때문입니다. 스케치를 잠재 표현으로 인코딩하고 노이즈를 일부만 더한 뒤 거기서부터 노이즈를 제거하면 이미지 투 이미지, 인터페이스에서 말하는 img2img가 됩니다. strength 또는 denoise 설정이 바로 더하는 노이즈의 양입니다. 이 아이디어는 SDEdit에서 왔습니다. 잠재 표현의 한 영역을 마스크하면 인페인팅, 마스크가 화면 바깥에 있으면 아웃페인팅입니다. 포즈, 깊이 맵, 윤곽선을 읽는 작은 보조 네트워크를 붙이면 ControlNet입니다. 사진 스무 장으로 추가 가중치 수백만 개를 학습시키면 모델에 얼굴이나 스타일을 가르치는 LoRA가 됩니다. 업스케일링은 전용 초해상도 모델이 맡습니다.
직접 실행하려면 1.5는 비디오 메모리(VRAM) 6 GB의 최신 NVIDIA 그래픽카드면 충분하고 SDXL은 8 GB가 필요합니다. AMD 그래픽카드는 ROCm으로, Apple Silicon은 MPS 백엔드로 작동합니다. 설치 가이드에서 주요 인터페이스 세 가지를 다룹니다. 그래픽카드가 없어도 이 사이트의 도구에는 하드웨어가 필요 없습니다. Stable Diffusion XL과 Stable Diffusion 1.5는 사이트 자체 GPU에서 실행되며 대기열이 실시간으로 표시되고, 설명이 달린 프롬프트는 각 설정이 무엇을 하는지 보여 주며, 1,731가지 아티스트 스타일은 모델이 화가들에 대해 무엇을 배웠는지 보여 줍니다.
Stable Diffusion vs Midjourney vs DALL-E
Midjourney와 OpenAI의 이미지 모델과 비교하면 차이는 품질이 아니라 제어입니다. 가중치가 공개되어 있고 모델이 로컬에서 돌아갑니다. 이미지는 내 디스크에 남고, 모델을 직접 고르고, 시드를 직접 정하고, 어떤 부품이든 바꿀 수 있습니다. 그 대신 요구하는 것이 더 많습니다. Midjourney는 문장 하나를 받아 완성도 높은 그림을 주고, Stable Diffusion은 모델, 프롬프트, 네거티브 프롬프트, 가이던스 스케일을 요구한 다음 정확히 설정한 대로 돌려줍니다.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| 가중치 | 공개, 다운로드 가능 | 비공개 | 비공개 |
| 내 컴퓨터에서 실행 | 가능, VRAM 6~8 GB | 불가 | 불가 |
| 가격 | 로컬은 무료, 온라인 무료 도구 | 구독 | 구독 또는 이미지당 과금 |
| 제어 | 시드, 모델, LoRA, ControlNet, 인페인팅, 모든 설정 | 파라미터와 스타일 참조 | 대화 |
| 파인튜닝 | 가능, 누구나 | 불가 | 불가 |
| 이미지 속 글자 | 3 이전은 약함, 3.5부터 양호 | v6부터 양호 | 매우 좋음 |
같은 확산 원리가 이제 다른 연구소의 모델도 움직이며, 인코더와 라이선스는 서로 다릅니다. Stable Diffusion 원저자들이 세운 Black Forest Labs의 FLUX와 Alibaba의 Qwen-Image입니다. 같은 인터페이스에서 같은 시드, 스텝, 샘플러로 돌아가므로 이 페이지의 대부분이 그대로 적용됩니다. 가이던스 방식은 다르고, FLUX dev에는 네거티브 프롬프트가 없으며, 키워드 나열보다 완전한 문장을 선호합니다.
출처, 그리고 그림 재사용 방법
페이지에 등장하는 순서대로 정리한 주요 출처입니다.
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach 외, 2022: Stable Diffusion 논문.
- Denoising Diffusion Probabilistic Models, Ho 외, 2020: 정방향과 역방향 과정, 천 스텝 스케줄.
- Learning Transferable Visual Models From Natural Language Supervision, Radford 외, 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho와 Salimans, 2022: 가이던스 스케일.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, 그리고 Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL과 Stable Diffusion 3.
그림 재사용. 이 페이지의 생성 이미지와 도식은 CC BY 4.0으로 공개합니다. 이 페이지 링크를 달아 강의, 발표, 글에 재사용할 수 있습니다. 모든 생성 이미지는 Stable Diffusion XL, euler, 30스텝, CFG 6, 시드 20220822, 아래 프롬프트, 그리고 네거티브 프롬프트 "text, watermark, signature, blurry, low quality, storm, dark clouds, sunset"을 사용했습니다.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokes이 페이지 인용하기.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion