Stable Diffusion, nói ngắn gọn
Stable Diffusion là một mô hình khuếch tán tiềm ẩn (latent diffusion model, LDM) mã nguồn mở: một mạng nơ-ron được huấn luyện để biến nhiễu ngẫu nhiên thành ảnh, từng chút một, dưới sự dẫn dắt của một đoạn văn bản. Mô hình do nhóm CompVis tại Đại học Ludwig Maximilian ở Munich xây dựng cùng Runway, được huấn luyện bằng năng lực tính toán của Stability AI trên kho ảnh do tổ chức phi lợi nhuận LAION thu thập. Phương pháp đến từ bài báo High-Resolution Image Synthesis with Latent Diffusion Models (Rombach và cộng sự, CVPR 2022).
Trọng số được công bố ngày 22 tháng 8 năm 2022. Đó chính là điều đã thay đổi tất cả. DALL-E 2 và Midjourney đã tồn tại, nhưng nằm sau danh sách chờ và credit trả phí, trên máy chủ của người khác. Stable Diffusion là một tệp 4 GB chạy được trên card đồ họa có 8 GB bộ nhớ, không cần tài khoản và có bộ lọc an toàn tắt được.
Chỉ trong vài tuần, các giao diện web và inpainting xuất hiện, rồi đến các bản fine-tune, LoRA và ControlNet. Bốn năm sau, cái tên này mang hai nghĩa. Theo nghĩa hẹp, đó là họ mô hình từ 1.4 đến 3.5. Theo nghĩa rộng, đó là toàn bộ thói quen chạy mô hình tạo ảnh trên máy của chính mình.
Phần dưới đây giải thích chính cỗ máy ấy, với những từ bạn sẽ gặp trong mọi giao diện: không gian tiềm ẩn, VAE, U-Net, CLIP, sampler, guidance scale, seed. Không cần công thức nào, nhưng vài con số sẽ giúp ích.
Stable Diffusion hoạt động như thế nào? Ba mạng và một vòng lặp
Stable Diffusion không phải một mạng mà là ba mạng, chạy nối tiếp nhau.
- Bộ mã hóa văn bản đọc prompt và biến nó thành một dãy số. Trong Stable Diffusion 1.5, đó là 77 token, mỗi token được mô tả bằng 768 con số; 2.048 trong SDXL, vốn chạy hai bộ mã hóa.
- Bộ khử nhiễu, là U-Net trong các phiên bản từ 1 đến XL và là transformer (MMDiT) từ phiên bản 3 trở đi, xuất phát từ một khối nhiễu ngẫu nhiên và làm sạch nó qua 20 đến 30 bước, mỗi bước đều tham khảo các con số của văn bản. Nó không làm việc trên điểm ảnh mà trên một phiên bản nén của bức ảnh, gọi là latent, nằm trong cái gọi là không gian tiềm ẩn: 4 × 64 × 64 con số cho ảnh 512 pixel, 4 × 128 × 128 cho ảnh 1024 pixel của SDXL.
- Bộ giải mã biến latent đó thành các giá trị điểm ảnh cuối cùng, đỏ, lục và lam: 3 × 512 × 512, hoặc 3 × 1024 × 1024 với SDXL.
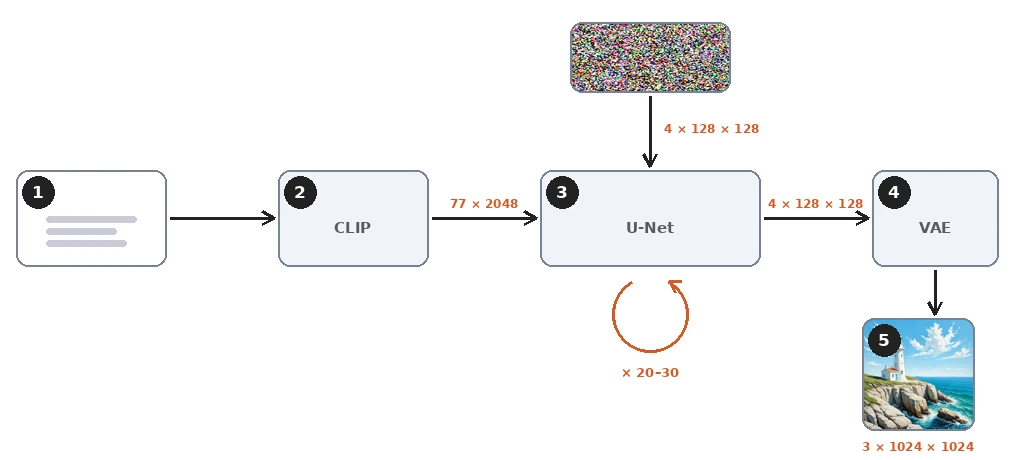
Không có gì được tìm kiếm hay sao chép trên đường đi. Không có cơ sở dữ liệu ảnh nào bên trong tệp. 2 đến 16 GB trọng số chứa những gì mạng đã học về cách chú thích và ảnh đi cùng nhau, và mọi kết quả đều được tính ra từ nhiễu. Mạng vẫn có thể ghi nhớ những ảnh xuất hiện nhiều lần trong quá trình huấn luyện, và các nhà nghiên cứu đã trích xuất được vài trăm ảnh như vậy, nhưng đó là ngoại lệ.
Mô hình khuếch tán là gì? Học cách loại bỏ nhiễu
Quá trình thuận: thêm nhiễu
Ý tưởng đằng sau khuếch tán rất dễ phát biểu. Lấy một bức ảnh kèm chú thích. Thêm vào đó một lượng nhiễu ngẫu nhiên đã đo lường. Yêu cầu một mạng đoán xem nhiễu nào đã được thêm vào, khi biết chú thích. So sánh dự đoán của nó với sự thật và chỉnh mạng một chút.
Thêm nhiễu là quá trình thuận. Nó đi theo một lịch cố định gồm một nghìn mức, từ hạt nhiễu mờ nhạt ở mức 50 đến nhiễu hoàn toàn ở mức 999. Mạng không bao giờ thấy cả lịch này chạy; mỗi lần nó chỉ thấy một ảnh nhiễu ở một mức.
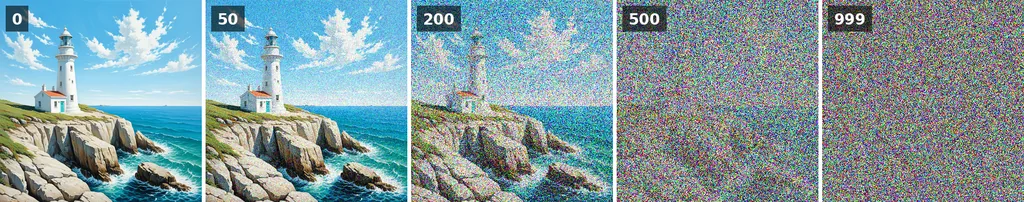
Làm như vậy trên hàng tỷ ví dụ, kết quả là một bộ dự đoán nhiễu: cho một ảnh nhiễu, mức nhiễu của nó và một đoạn văn bản, nó nói nhiễu có lẽ là gì. Mục tiêu huấn luyện chỉ là khoảng cách giữa nhiễu dự đoán và nhiễu thật. Theo thẻ mô hình, việc huấn luyện Stable Diffusion 1 tốn khoảng 150.000 giờ trên GPU A100 trong trung tâm dữ liệu.
Quá trình nghịch: bộ dự đoán nhiễu vào việc
Tạo ảnh là chạy ngược bài học đó. Đó là quá trình nghịch. Bắt đầu từ nhiễu hoàn toàn, do seed chọn. Hỏi bộ dự đoán xem nhiễu là gì, bỏ đi một phần, rồi hỏi lại. DDPM, bài báo năm 2020 giúp khuếch tán trở nên khả thi, làm việc này trong một nghìn bước nhỏ.
Sampler, trong một số giao diện còn gọi là scheduler, là quy tắc quyết định mỗi bước lớn đến đâu và có thêm lại một chút nhiễu mới hay không. Các sampler tốt hơn, DDIM, Euler và họ DPM++, đi những bước dài hơn trên cùng một con đường, nên ngày nay 20 đến 30 bước là đủ.
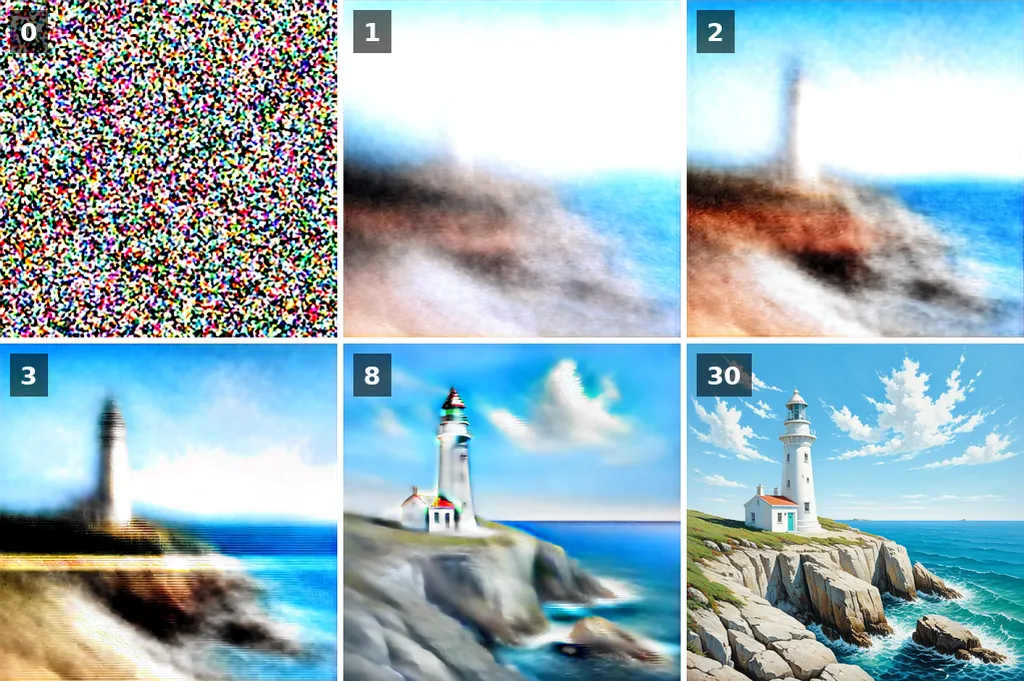
Hình trên cho thấy phần đáng ghi nhớ. Ở mỗi bước, mô hình giữ một phỏng đoán về bức ảnh hoàn chỉnh, và phỏng đoán ấy ổn định từ rất sớm. Hai ba bước đầu, khi nhiễu còn dày, cố định bố cục: đường chân trời ở đâu, ngọn hải đăng đứng chỗ nào, trời chiếm bao nhiêu. Các bước sau tinh chỉnh kết cấu và chi tiết nhỏ.
Thanh trượt bên dưới lần lượt hiện cả ba mươi phỏng đoán của cùng lần tạo ảnh đó.
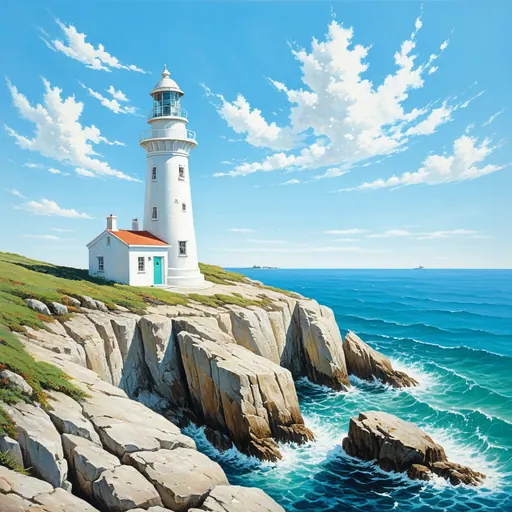
Từ đó rút ra hai hệ quả thực tế. Thay đổi số bước sẽ thay đổi chi tiết và đôi khi cả bố cục, vì các bước đầu rơi vào những giá trị khác; nó không đơn giản là làm nét cùng một bức ảnh. Và cùng một seed ở kích thước ảnh khác sẽ xuất phát từ một khối nhiễu khác, nên cũng cho ra ảnh khác. Hãy chọn kích thước trước, rồi mới đi tìm seed.
Khuếch tán tiềm ẩn: mẹo VAE giúp mô hình chạy vừa card đồ họa chơi game
Các mô hình khuếch tán trước đó làm việc trên điểm ảnh. Một ảnh 512 × 512 là 786.432 con số, và bộ dự đoán phải đọc và ghi toàn bộ chúng ở mỗi bước. Các mô hình pixel như DALL-E 2 và Imagen né vấn đề này bằng cách khuếch tán ở 64 pixel rồi thêm các mạng phóng to, và dù sao chúng cũng chưa bao giờ được phát hành.
Stable Diffusion thêm vào một bộ tự mã hóa biến phân, tức VAE. Bộ mã hóa của nó nén ảnh lại tám lần mỗi chiều thành bốn kênh: 4 × 64 × 64, tức 16.384 con số, ít hơn 48 lần. Toàn bộ quá trình khuếch tán diễn ra trong không gian nén đó, không gian tiềm ẩn. Chỉ đến tận cuối, bộ giải mã của VAE mới mở kết quả ra thành điểm ảnh.

Latent không phải là một bức ảnh nhỏ. Bốn kênh của nó là một mã mà bộ giải mã biết cách đọc, và không kênh nào trông thật sự giống bức ảnh. Nhưng bố cục tổng thể vẫn được giữ lại sau khi nén, và đó là điều cho phép bộ khử nhiễu quyết định bố cục trong một không gian nhỏ đến vậy.
Đây cũng là lý do lựa chọn VAE ảnh hưởng đến màu sắc và chi tiết nhỏ: mỗi con số latent đại diện cho một mảng 8 × 8 điểm ảnh, và bộ giải mã tự nghĩ ra những gì nằm trong mảng đó. Stable Diffusion 3 chuyển sang latent 16 kênh chính vì lý do này, và chi tiết nhỏ cùng chữ nhỏ đã cải thiện theo.
CLIP và cross-attention: văn bản dẫn dắt bức ảnh ra sao
Ba thành phần biến từ ngữ thành một hướng đi cho bộ khử nhiễu.
Tokenizer và bộ mã hóa văn bản: CLIP đọc prompt thế nào
Tokenizer cắt prompt thành các token, là nguyên cả từ thông dụng hoặc mảnh của từ hiếm hơn. Stable Diffusion 1.5 và SDXL đọc tối đa 77 token, trong đó hai token là dấu bắt đầu và kết thúc, tức khoảng 50 đến 60 từ tiếng Anh. Quá mức đó, văn bản bị cắt, trừ khi giao diện chia nó thành nhiều khối. Hãy đặt điều quan trọng nhất lên đầu.
Bộ mã hóa văn bản của 1.5 là CLIP, một mạng do OpenAI huấn luyện trên 400 triệu cặp ảnh và chú thích, với một nhiệm vụ duy nhất: đưa các con số mô tả chú thích đến gần các con số mô tả bức ảnh của nó. Sau quá trình huấn luyện ấy, các con số của từ “lighthouse” đã mang sẵn hình dáng của ngọn hải đăng. SDXL chạy song song hai bộ mã hóa như vậy, bộ thứ hai là bản huấn luyện lại mở do LAION thực hiện trên hai tỷ cặp. Stable Diffusion 3 thêm bộ thứ ba, T5, đọc được cả câu hoàn chỉnh.
Cross-attention bên trong U-Net
Cross-attention là nơi văn bản gặp bức ảnh. U-Net là một chồng các khối tích chập thu nhỏ latent rồi phóng nó trở lại, với các kết nối tắt (skip connection) giữa các kích thước tương ứng. Giữa các khối đó là các lớp attention. Ở mỗi bước, mỗi vùng của latent nhìn vào 77 vector token và cân nhắc xem vector nào liên quan đến mình. Vùng trời chú ý đến “sunset” và “clouds”, vùng đá chú ý đến “cliff”. Đó là lý do thứ tự từ, sự lặp lại và cú pháp trọng số trong các giao diện có tác dụng, và vì sao một từ chỉ phong cách đặt ở đầu sẽ nhuộm cả bức ảnh.
Đó cũng là giới hạn của các phiên bản đầu. CLIP học từ những đoạn alt text ngắn, nên nó hiểu tốt các danh sách chủ thể và phong cách, nhưng hiểu kém quan hệ giữa chúng. “A red cube on a blue sphere” trong 1.5 thường cho kết quả đảo ngược. Hướng dẫn viết prompt chỉ ra những gì hoạt động ổn định.
Guidance scale, negative prompt và seed: ba thiết lập
Ba thiết lập xuất hiện trong mọi giao diện Stable Diffusion. Chúng ánh xạ trực tiếp vào bộ máy mô tả ở trên.
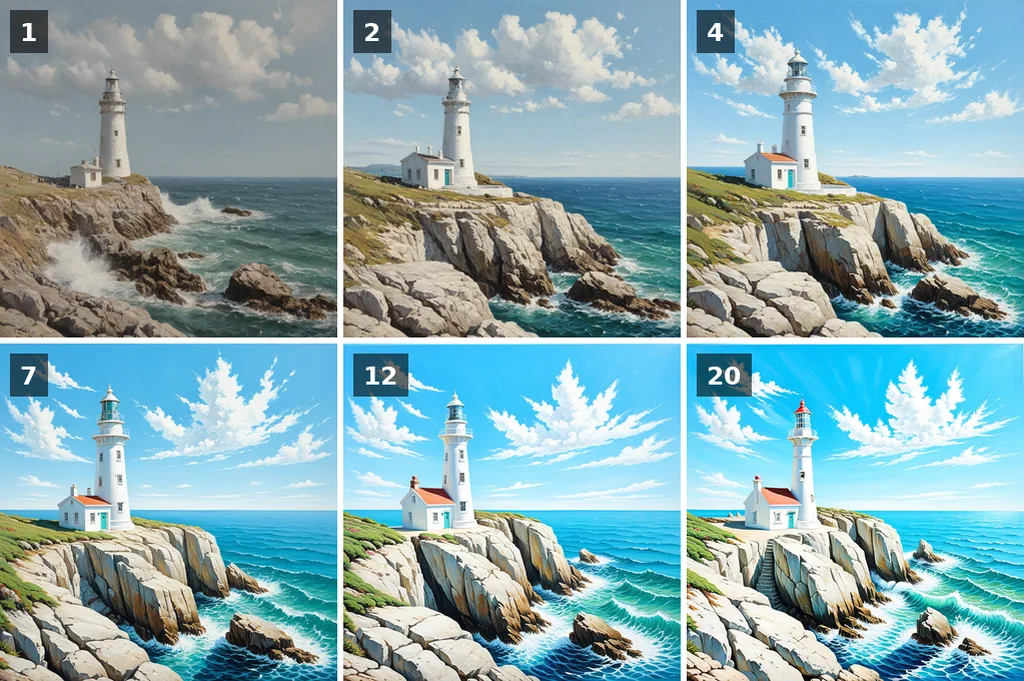
Guidance scale, viết tắt của hướng dẫn không cần bộ phân loại (classifier-free guidance, CFG), là thiết lập quyết định văn bản được đẩy mạnh đến đâu. Ở mỗi bước, bộ khử nhiễu thực ra đưa ra hai dự đoán: một với prompt và một với prompt trống. Hiệu giữa hai dự đoán là hướng đi mà prompt chỉ ra. Dự đoán cuối cùng là dự đoán trống cộng với hiệu đó nhân với guidance scale. Ở mức 1, dự đoán có prompt được dùng nguyên như vậy, không có lực đẩy: bức ảnh bám văn bản một cách lỏng lẻo, màu nhạt và trời xám trong khi prompt yêu cầu trời xanh. Khoảng 5 đến 8, ảnh bám sát prompt với màu sắc tự nhiên. Trên 12, tương phản gắt lên, màu bão hòa và nét cọ trở nên thô.
Negative prompt thay thế prompt trống trong dự đoán thứ hai đó. Thay vì không đọc gì, lượt thứ hai đọc “blurry, text, watermark”, và guidance đẩy ảnh ra xa những thứ ấy. Nó không tốn thêm gì, vì lượt thứ hai dù sao cũng chạy, và chỉ có tác dụng khi guidance lớn hơn 1. Hướng dẫn về negative prompt cung cấp các danh sách dùng được.
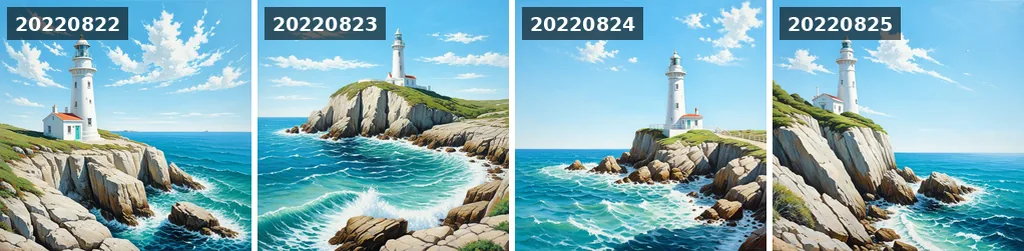
Seed là con số sinh ra nhiễu ban đầu. Cùng seed, cùng prompt, cùng thiết lập và cùng mô hình cho ra cùng một bức ảnh, chính xác đến từng pixel, trên cùng phần mềm và phần cứng; giao diện khác hay card khác sẽ sinh nhiễu theo cách khác. Đổi seed thì bố cục đổi, vì các bước đầu đọc một khối nhiễu khác. Đổi một từ trong prompt mà giữ nguyên seed, phần lớn bức ảnh thường vẫn giữ. Đó là cách người ta tinh chỉnh một prompt.
Từ U-Net đến transformer: các phiên bản từ 1.5 đến 3.5
Sáu thế hệ chính ra đời trong hai năm, hai thế hệ đầu từ CompVis và Runway, phần còn lại từ Stability AI. Mỗi thế hệ thay đổi ít nhất một trong ba mạng.
| Phiên bản | Thời điểm | Bộ khử nhiễu | Bộ mã hóa văn bản | Kích thước gốc |
|---|---|---|---|---|
| 1.4 và 1.5 | Tháng 8 và tháng 10 năm 2022 | U-Net, 860 triệu tham số | CLIP ViT-L | 512 px |
| 2.0 và 2.1 | Tháng 11 và tháng 12 năm 2022 | U-Net cùng thiết kế, huấn luyện lại từ đầu | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Tháng 7 năm 2023 | U-Net, 2,6 tỷ, cộng thêm refiner | CLIP ViT-L và OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Tháng 11 năm 2023 | SDXL chưng cất xuống 1 đến 4 bước | Như SDXL | 512 px |
| 3 Medium | Tháng 6 năm 2024 | Diffusion transformer (MMDiT), 2 tỷ | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Tháng 10 năm 2024 | MMDiT, 8 tỷ; Medium 2,5 tỷ | Cùng ba bộ đó | 1024 px |
1.5 vẫn là một trong những mô hình được fine-tune nhiều nhất từng có, với hàng chục nghìn checkpoint và LoRA của cộng đồng, và vẫn chạy được với 4 GB bộ nhớ video. SDXL là mô hình chủ lực: bàn tay, khuôn mặt và bố cục tốt hơn, đầu ra gốc 1024 pixel. 3 và 3.5 thay U-Net bằng một transformer xử lý token văn bản và token ảnh cùng nhau, điều cuối cùng đã giúp viết được chữ rõ ràng trong ảnh: hãy đặt các từ trong ngoặc kép ở prompt. Bài so sánh SDXL và Stable Diffusion 3 cho thấy cùng những prompt trên cả hai.
Giấy phép cũng thay đổi. 1.5 theo giấy phép CreativeML OpenRAIL-M và SDXL theo OpenRAIL++-M, cả hai đều miễn phí cho mục đích thương mại kèm một danh sách các mục đích bị cấm. Các mô hình 3.x theo Stability AI Community License, miễn phí dưới mức doanh thu một triệu đô la mỗi năm.
Bạn làm được gì với nó: image-to-image, inpainting, ControlNet, LoRA
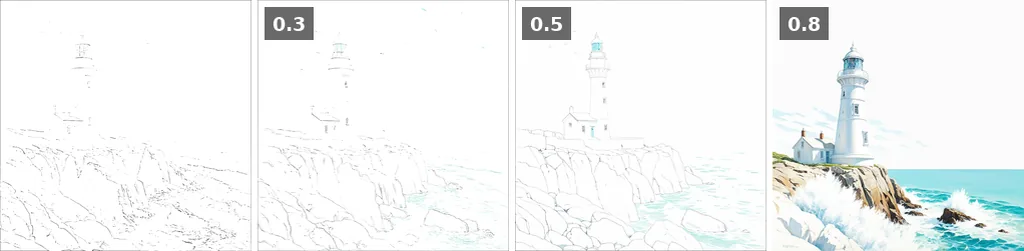
Tạo ảnh từ văn bản mới chỉ là khởi đầu, vì mọi mảnh của pipeline đều tái sử dụng được. Mã hóa một bản phác thảo thành latent, chỉ thêm một phần nhiễu rồi khử nhiễu từ đó, bạn có image-to-image, tức img2img trong các giao diện: thiết lập strength, hay denoise, chính là lượng nhiễu bạn thêm vào. Ý tưởng đến từ SDEdit. Che một vùng của latent, bạn có inpainting, hoặc outpainting khi vùng che nằm ngoài khung. Thêm một mạng phụ nhỏ đọc tư thế, bản đồ độ sâu hay đường nét, bạn có ControlNet. Huấn luyện vài triệu trọng số bổ sung trên hai mươi bức ảnh, bạn có một LoRA dạy mô hình một khuôn mặt hay một phong cách. Các mô hình siêu phân giải chuyên dụng đảm nhận việc upscale.
Để tự chạy, một card NVIDIA đời mới có 6 GB bộ nhớ video (VRAM) là đủ cho 1.5 và 8 GB cho SDXL. Card AMD chạy qua ROCm, Apple Silicon qua backend MPS. Hướng dẫn cài đặt bao quát ba giao diện chính. Nếu không có card, các công cụ trên trang này không cần phần cứng nào: Stable Diffusion XL và Stable Diffusion 1.5 chạy trên GPU riêng của trang với hàng chờ hiển thị trực tiếp, các prompt có chú giải cho thấy mỗi thiết lập làm gì, và 1.731 phong cách nghệ sĩ cho thấy mô hình đã học được gì về các họa sĩ.
Stable Diffusion vs Midjourney vs DALL-E
So với Midjourney và các mô hình tạo ảnh của OpenAI, khác biệt không nằm ở chất lượng mà ở khả năng kiểm soát. Trọng số công khai và mô hình chạy tại chỗ: ảnh của bạn ở lại trên ổ đĩa của bạn, bạn chọn mô hình, bạn đặt seed và bạn có thể thay bất kỳ thành phần nào. Đổi lại, nó đòi hỏi ở bạn nhiều hơn. Midjourney yêu cầu một câu và trả về một bức ảnh bóng bẩy; Stable Diffusion yêu cầu một mô hình, một prompt, một negative prompt và một guidance scale, rồi trả về chính xác những gì bạn đã đặt.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Trọng số | Công khai, tải về được | Đóng | Đóng |
| Chạy trên máy của bạn | Có, 6 đến 8 GB VRAM | Không | Không |
| Giá | Miễn phí tại chỗ; công cụ trực tuyến miễn phí | Thuê bao | Thuê bao hoặc trả theo ảnh |
| Kiểm soát | Seed, mô hình, LoRA, ControlNet, inpainting, mọi thiết lập | Tham số và ảnh tham chiếu phong cách | Hội thoại |
| Fine-tune | Có, ai cũng làm được | Không | Không |
| Chữ trong ảnh | Yếu trước bản 3, tốt từ 3.5 | Tốt từ v6 | Rất tốt |
Cùng nguyên lý khuếch tán ấy nay vận hành các mô hình của những phòng thí nghiệm khác, với bộ mã hóa khác và giấy phép khác: FLUX của Black Forest Labs, do chính các tác giả ban đầu của Stable Diffusion sáng lập, và Qwen-Image của Alibaba. Chúng chạy trong cùng các giao diện, với cùng seed, số bước và sampler, nên phần lớn trang này vẫn áp dụng được. Guidance của chúng hoạt động khác, FLUX dev không có negative prompt, và chúng ưa câu đầy đủ hơn danh sách từ khóa.
Nguồn tham khảo và cách sử dụng lại hình ảnh
Các nguồn gốc, theo thứ tự xuất hiện trong trang:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach và cộng sự, 2022: bài báo về Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho và cộng sự, 2020: quá trình thuận và nghịch cùng lịch một nghìn bước.
- Learning Transferable Visual Models From Natural Language Supervision, Radford và cộng sự, 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho và Salimans, 2022: guidance scale.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, và Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL và Stable Diffusion 3.
Sử dụng lại hình ảnh. Các ảnh và sơ đồ trên trang này được phát hành theo giấy phép CC BY 4.0: bạn có thể dùng lại trong một khóa học, một bài nói hay một bài viết kèm liên kết đến trang này. Mọi ảnh đều dùng Stable Diffusion XL, euler, 30 bước, CFG 6, seed 20220822, prompt bên dưới, và negative prompt “text, watermark, signature, blurry, low quality, storm, dark clouds, sunset”.
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesĐể trích dẫn trang này.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion