Stable Diffusion in het kort
Stable Diffusion is een open-source latent diffusiemodel (LDM): een neuraal netwerk dat is getraind om willekeurige ruis beetje bij beetje om te zetten in een afbeelding, gestuurd door een tekst. Het werd gebouwd door de CompVis-groep van de Ludwig-Maximilians-Universiteit in München samen met Runway, en getraind met rekenkracht van Stability AI op afbeeldingen die de non-profit LAION verzamelde. De methode komt uit het paper High-Resolution Image Synthesis with Latent Diffusion Models (Rombach en collega's, CVPR 2022).
De gewichten werden op 22 augustus 2022 gepubliceerd. Dat is het deel dat alles veranderde. DALL-E 2 en Midjourney bestonden al, maar achter wachtlijsten en credits, op de servers van iemand anders. Stable Diffusion was een bestand van 4 GB dat draaide op een videokaart met 8 GB geheugen, zonder account en met een veiligheidsfilter dat je kon uitzetten.
Binnen enkele weken kwamen de webinterfaces en inpainting, daarna de finetunes, de LoRA's en ControlNet. Vier jaar later betekent de naam twee dingen. Strikt genomen de familie van modellen van 1.4 tot 3.5. In ruime zin de hele praktijk van beeldmodellen op je eigen computer draaien.
Wat volgt, legt de machine zelf uit, met de woordenschat die je in elke interface tegenkomt: latente ruimte, VAE, U-Net, CLIP, sampler, guidance scale, seed. Formules zijn niet nodig, maar een paar getallen helpen.
Hoe werkt Stable Diffusion? Drie netwerken en één lus
Stable Diffusion is niet één netwerk maar drie, die na elkaar draaien.
- Een tekstencoder leest de prompt en zet die om in een lijst getallen. In Stable Diffusion 1.5 zijn dat 77 tokens, elk beschreven door 768 getallen; 2.048 in SDXL, dat twee encoders gebruikt.
- Een denoiser, een U-Net in de versies 1 tot en met XL en een transformer (MMDiT) vanaf versie 3, begint met een blok willekeurige ruis en maakt dat in 20 tot 30 steps schoon, waarbij hij bij elke stap de tekstgetallen raadpleegt. Hij werkt niet op pixels maar op een compacte versie van de afbeelding, de latent, die leeft in wat de latente ruimte heet: 4 × 64 × 64 getallen voor een afbeelding van 512 pixels, 4 × 128 × 128 voor de 1024 pixels van SDXL.
- Een decoder zet die latent om in de uiteindelijke pixelwaarden, rood, groen en blauw: 3 × 512 × 512, of 3 × 1024 × 1024 voor SDXL.
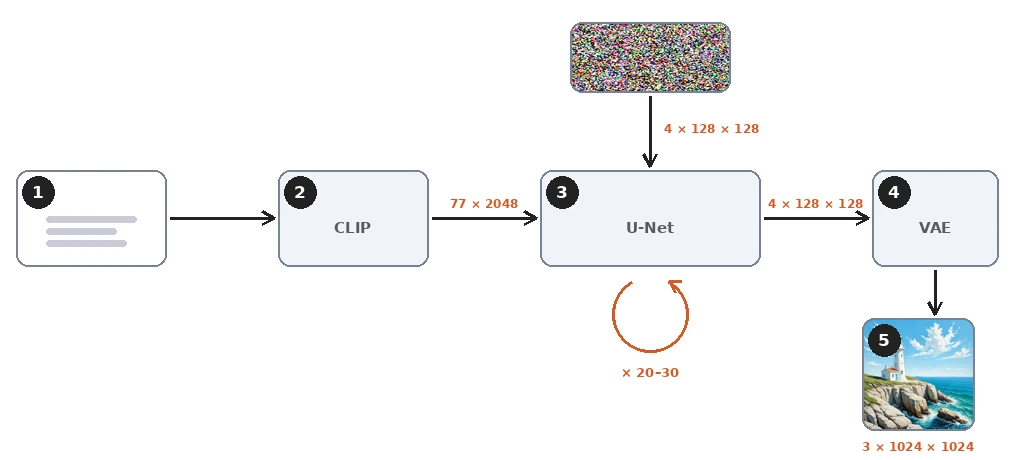
Onderweg wordt niets opgezocht of gekopieerd. Er zit geen database met afbeeldingen in het bestand. De 2 tot 16 GB aan gewichten bevatten wat het netwerk heeft geleerd over hoe bijschriften en afbeeldingen bij elkaar horen, en elke uitvoer wordt berekend uit ruis. Het netwerk kan nog wel afbeeldingen onthouden die heel vaak in de training voorkwamen, en onderzoekers hebben er een paar honderd uit gehaald, maar dat is de uitzondering.
Wat is een diffusiemodel? Leren ruis te verwijderen
Het voorwaartse proces: ruis toevoegen
Het idee achter diffusie is eenvoudig te formuleren. Neem een foto met zijn bijschrift. Voeg er een afgemeten hoeveelheid willekeurige ruis aan toe. Vraag een netwerk te raden welke ruis is toegevoegd, met kennis van het bijschrift. Vergelijk zijn gok met de waarheid en corrigeer het netwerk een beetje.
Het toevoegen van de ruis is het voorwaartse proces. Het volgt een vast schema van duizend niveaus, van een lichte korrel op niveau 50 tot pure sneeuw op niveau 999. Het netwerk ziet het schema nooit doorlopen; het ziet telkens maar één ruisige afbeelding op één niveau.
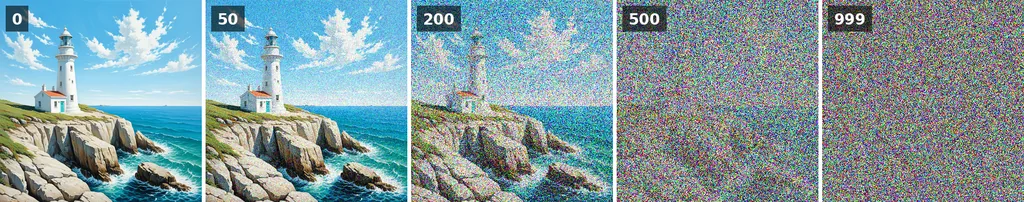
Doe dat over miljarden voorbeelden en het resultaat is een ruisvoorspeller: geef hem een ruisige afbeelding, het ruisniveau en een tekst, en hij zegt wat de ruis waarschijnlijk is. Het trainingsdoel is gewoon het verschil tussen de voorspelde ruis en de echte. Het trainen van Stable Diffusion 1 kostte volgens de modelkaart ongeveer 150.000 uur op A100-GPU's in een datacenter.
Het omgekeerde proces: de ruisvoorspeller aan het werk
Genereren draait de les om. Dat is het omgekeerde proces. Begin met pure ruis, die de seed bepaalt. Vraag de voorspeller wat de ruis is, haal er een deel van weg, vraag opnieuw. DDPM, het paper uit 2020 dat diffusie praktisch bruikbaar maakte, deed dit in duizend kleine stappen.
De sampler, in sommige interfaces ook scheduler genoemd, is de regel die bepaalt hoe groot elke stap is en of er een beetje verse ruis wordt teruggezet. Betere samplers, DDIM, Euler en de DPM++-familie, nemen grotere stappen langs hetzelfde pad, en daarom volstaan vandaag 20 tot 30 steps.
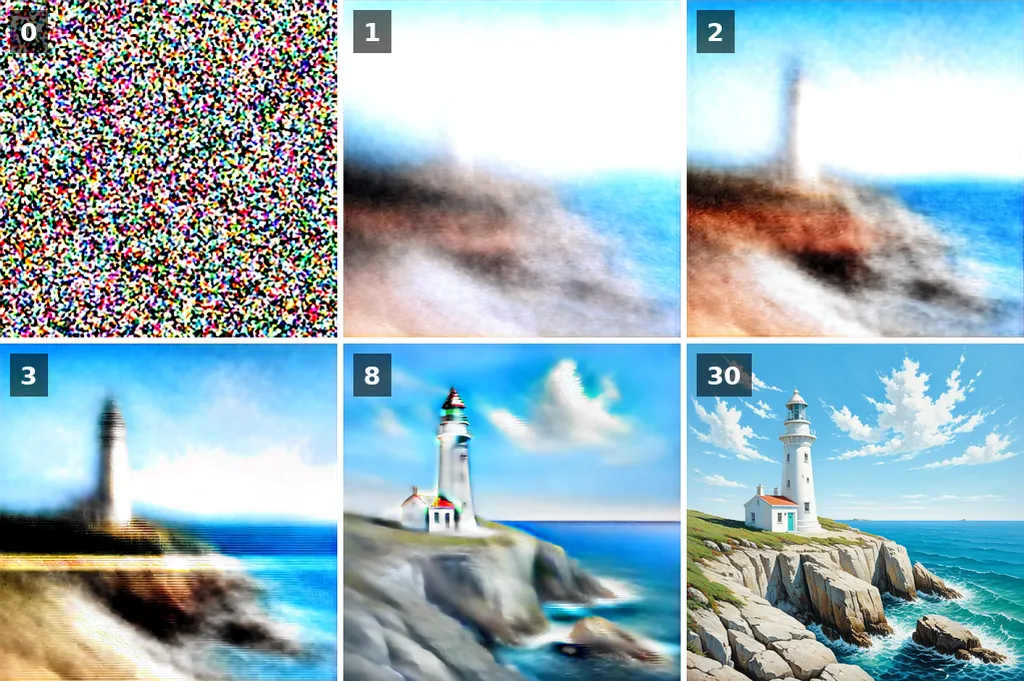
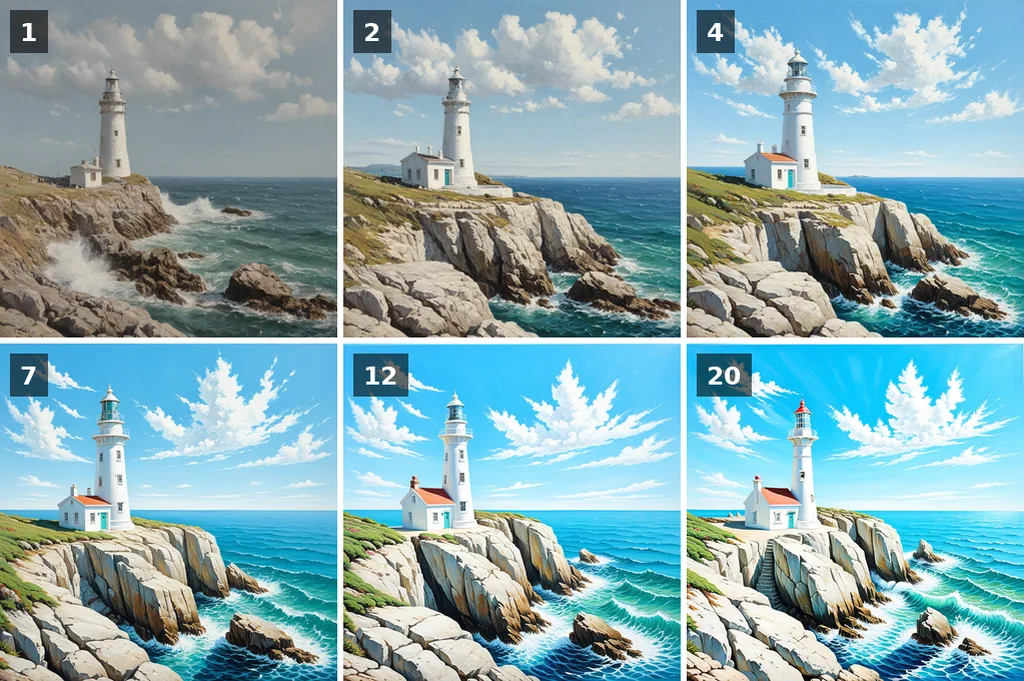
De figuur toont het deel dat je moet onthouden. Bij elke step heeft het model een gok van het eindbeeld, en die gok ligt vroeg vast. De eerste twee of drie steps, terwijl de ruis nog zwaar is, bepalen de compositie: waar de horizon ligt, waar de vuurtoren staat, hoeveel lucht er is. De latere steps verfijnen textuur en kleine details.
De schuifregelaar hieronder loopt door alle dertig gokken van dezelfde render.
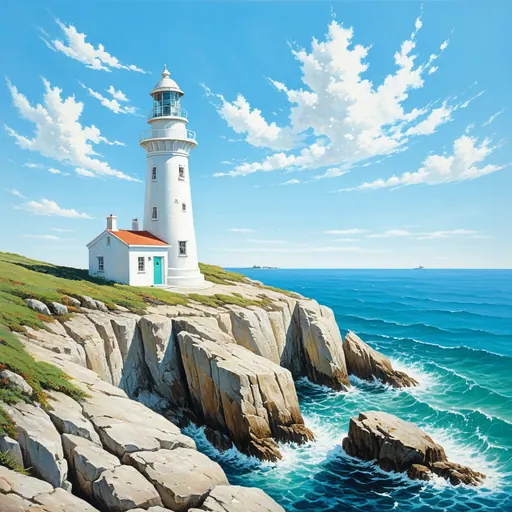
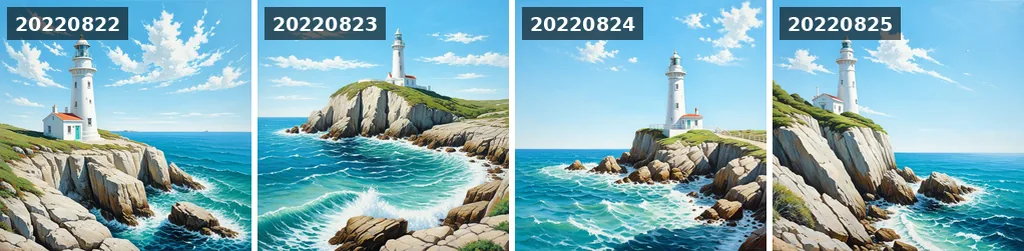
Daar volgen twee praktische gevolgen uit. Het aantal steps veranderen verandert de details en soms de compositie, omdat de eerste steps op andere waarden uitkomen; het maakt niet gewoon hetzelfde beeld scherper. En dezelfde seed op een ander beeldformaat begint met een ander blok ruis, dus geeft ook een andere afbeelding. Kies eerst het formaat, en zoek dan een seed.
Latente diffusie: de VAE-truc die het op een gaming-kaart laat draaien
Eerdere diffusiemodellen werkten op pixels. Een afbeelding van 512 × 512 is 786.432 getallen, en de voorspeller moest die allemaal lezen en schrijven bij elk van zijn steps. Pixelmodellen zoals DALL-E 2 en Imagen omzeilden dat door te diffunderen op 64 pixels en er upscaling-netwerken aan toe te voegen, en ze zijn sowieso nooit vrijgegeven.
Stable Diffusion voegt een variationele autoencoder toe, de VAE. Zijn encoder perst een afbeelding met een factor acht per zijde samen tot vier kanalen: 4 × 64 × 64, oftewel 16.384 getallen, 48 keer minder. De diffusie draait volledig in die gecomprimeerde ruimte, de latente ruimte. Pas helemaal aan het einde zet de decoder van de VAE het resultaat om in pixels.

De latent is geen kleine afbeelding. Zijn vier kanalen zijn een code die de decoder weet te lezen, en geen enkel kanaal lijkt echt op de afbeelding. Maar de indeling overleeft de compressie, en dat is wat de denoiser in staat stelt de compositie in zo'n kleine ruimte te bepalen.
Daarom is de keuze van de VAE ook van belang voor kleur en fijne details: elk latent getal staat voor een vlak van 8 × 8 pixels, en de decoder verzint wat er in dat vlak zit. Stable Diffusion 3 stapte precies om die reden over op een latent met 16 kanalen, en fijne details en kleine tekst werden daarmee beter.
CLIP en cross-attention: hoe de tekst het beeld stuurt
Drie onderdelen zetten woorden om in een richting voor de denoiser.
Tokenizer en tekstencoder: hoe CLIP een prompt leest
De tokenizer knipt de prompt in tokens, hele veelvoorkomende woorden of stukjes van zeldzamere. Stable Diffusion 1.5 en SDXL lezen maximaal 77 tokens, waarvan twee begin- en eindmarkeringen, ongeveer 50 tot 60 Engelse woorden. Daarna wordt de tekst afgekapt, tenzij de interface hem in meerdere passes opsplitst. Zet wat het belangrijkst is vooraan.
De tekstencoder van 1.5 is CLIP, een netwerk dat OpenAI trainde op 400 miljoen paren van afbeeldingen en bijschriften, met één taak: de getallen die een bijschrift beschrijven dicht bij de getallen brengen die de afbeelding beschrijven. Na die training dragen de getallen voor "lighthouse" al in zich hoe vuurtorens eruitzien. SDXL draait twee van zulke encoders naast elkaar, de tweede een open hertraining door LAION op twee miljard paren. Stable Diffusion 3 voegt er een derde aan toe, T5, die hele zinnen leest.
Cross-attention in het U-Net
Cross-attention is waar de tekst het beeld ontmoet. Het U-Net is een stapel convolutieblokken die de latent verkleinen en daarna weer laten groeien, met skip-verbindingen tussen overeenkomende formaten. Tussen die blokken zitten attention-lagen. Bij elke step kijkt elk gebied van de latent naar de 77 tokenvectoren en weegt welke daarvan hem aangaan. Het luchtgebied let op "sunset" en "clouds", de rots op "cliff". Daarom hebben woordvolgorde, herhaling en de wegingssyntaxis van de interfaces effect, en daarom kleurt een stijlwoord aan het begin de hele afbeelding.
Het is ook de beperking van de eerste versies. CLIP leerde van korte alt-teksten, dus begrijpt het lijsten van onderwerpen en stijlen goed en relaties daartussen slecht. "A red cube on a blue sphere" komt er in 1.5 vaak omgewisseld uit. De promptgids laat zien wat betrouwbaar werkt.
Guidance scale, negatieve prompt en seed: de drie instellingen
Drie instellingen komen in elke Stable Diffusion-interface voor. Ze sluiten direct aan op de mechaniek hierboven.
De guidance scale, de CFG-schaal, kort voor classifier-free guidance (CFG), bepaalt hoe hard de tekst wordt doorgedrukt. Bij elke step maakt de denoiser eigenlijk twee voorspellingen: één met de prompt en één met een lege prompt. Het verschil tussen de twee is de richting die de prompt geeft. De uiteindelijke voorspelling is de lege plus dat verschil, vermenigvuldigd met de guidance scale. Op 1 wordt de voorspelling met prompt gebruikt zoals ze is, zonder duw: het beeld volgt de tekst losjes, met gedempte kleuren en een grijze lucht waar de prompt om een blauwe vroeg. Rond 5 tot 8 volgt het de prompt nauwkeurig met natuurlijke kleuren. Boven 12 wordt het contrast hard, raken de kleuren verzadigd en worden de penseelstreken grof.
De negatieve prompt vervangt de lege prompt van die tweede voorspelling. In plaats van niets te lezen, leest de tweede pass "blurry, text, watermark", en de guidance duwt daarvan weg. Het kost niets extra, want de tweede pass draait toch al, en het werkt alleen als de guidance boven 1 staat. De gids over de negatieve prompt geeft lijsten die werken.
De seed is het getal waaruit de beginruis wordt gegenereerd. Dezelfde seed, prompt, instellingen en hetzelfde model geven dezelfde afbeelding, tot op de pixel, op dezelfde software en hardware; een andere interface of een andere kaart trekt de ruis anders. Verander de seed en de compositie verandert, omdat de eerste steps een ander blok ruis lezen. Verander één woord van de prompt en houd de seed, en het grootste deel van het beeld blijft meestal overeind. Zo verfijn je een prompt.
Van U-Net naar transformer: de versies van 1.5 tot 3.5
Zes grote generaties verschenen in twee jaar, de eerste twee van CompVis en Runway, de rest van Stability AI. Elke generatie veranderde minstens één van de drie netwerken.
| Versie | Datum | Denoiser | Tekstencoders | Native formaat |
|---|---|---|---|---|
| 1.4 en 1.5 | augustus en oktober 2022 | U-Net, 860 miljoen parameters | CLIP ViT-L | 512 px |
| 2.0 en 2.1 | november en december 2022 | U-Net van hetzelfde ontwerp, vanaf nul opnieuw getraind | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | juli 2023 | U-Net, 2,6 miljard, plus een refiner | CLIP ViT-L en OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | november 2023 | SDXL gedistilleerd tot 1 tot 4 steps | Zelfde als SDXL | 512 px |
| 3 Medium | juni 2024 | Diffusion transformer (MMDiT), 2 miljard | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | oktober 2024 | MMDiT, 8 miljard; Medium 2,5 miljard | Dezelfde drie | 1024 px |
1.5 blijft een van de meest gefinetunede modellen die er bestaan, met tienduizenden checkpoints en LoRA's van de community, en het draait nog steeds op 4 GB videogeheugen. SDXL is het werkpaard: betere handen, gezichten en compositie, en native uitvoer van 1024 pixels. 3 en 3.5 vervingen het U-Net door een transformer die tekst- en beeldtokens samen verwerkt, en dat is wat leesbare tekst in afbeeldingen eindelijk mogelijk maakte: zet de woorden tussen aanhalingstekens in de prompt. De vergelijking SDXL versus Stable Diffusion 3 toont dezelfde prompts op beide.
De licenties veranderden ook. 1.5 valt onder de CreativeML OpenRAIL-M-licentie en SDXL onder OpenRAIL++-M, beide vrij voor commercieel gebruik met een lijst verboden toepassingen. De 3.x-modellen vallen onder de Stability AI Community License, gratis onder één miljoen dollar jaaromzet.
Wat je ermee kunt doen: img2img, inpainting, ControlNet, LoRA
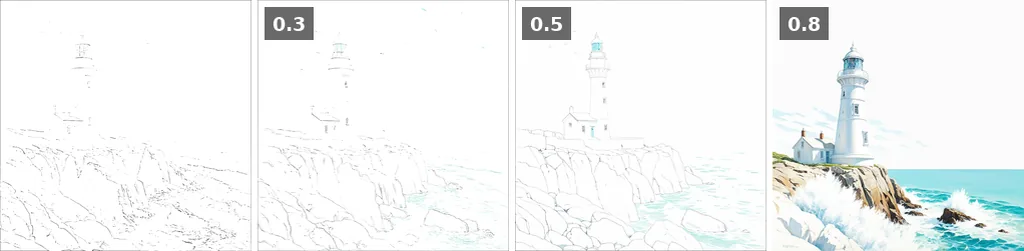
Tekst-naar-beeld is pas het begin, want elk onderdeel van de pipeline is opnieuw te gebruiken. Codeer een schets tot een latent, voeg maar een deel van de ruis toe en ontruis vanaf daar, en je hebt image-to-image, img2img in de interfaces: de instelling strength, of denoise, is hoeveel ruis je toevoegt. Het idee komt van SDEdit. Maskeer één gebied van de latent en je hebt inpainting, of outpainting als het masker buiten het kader ligt. Voeg een klein zijnetwerk toe dat een pose, een dieptekaart of randen leest, en je hebt ControlNet. Train een paar miljoen extra gewichten op twintig foto's en je hebt een LoRA die het model een gezicht of een stijl leert. Speciale superresolutiemodellen doen de upscaling.
Om het zelf te draaien volstaat een recente NVIDIA-kaart met 6 GB videogeheugen (VRAM) voor 1.5 en 8 GB voor SDXL. AMD-kaarten werken via ROCm, Apple Silicon via de MPS-backend. De installatiegids behandelt de drie belangrijkste interfaces. Zonder kaart vragen de tools op deze site geen hardware: Stable Diffusion XL en Stable Diffusion 1.5 draaien op de GPU van de site zelf, met de wachtrij live in beeld, gedocumenteerde prompts laten zien wat elke instelling doet, en 1.731 kunstenaarsstijlen laten zien wat het model over schilders heeft geleerd.
Stable Diffusion vs Midjourney vs DALL-E
Tegenover Midjourney en de beeldmodellen van OpenAI zit het verschil niet in kwaliteit maar in controle. De gewichten zijn openbaar en het model draait lokaal: je afbeeldingen blijven op je schijf, je kiest het model, je stelt de seed in en je kunt elk onderdeel vervangen. In ruil daarvoor vraagt het meer van je. Midjourney vraagt een zin en geeft een gepolijst beeld; Stable Diffusion vraagt een model, een prompt, een negatieve prompt en een guidance scale, en geeft je precies wat je hebt ingesteld.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Gewichten | Openbaar, downloadbaar | Gesloten | Gesloten |
| Draait op je eigen computer | Ja, 6 tot 8 GB VRAM | Nee | Nee |
| Prijs | Gratis lokaal; gratis tools online | Abonnement | Abonnement of per afbeelding |
| Controle | Seed, model, LoRA, ControlNet, inpainting, elke instelling | Parameters en stijlreferenties | Gesprek |
| Finetunen | Ja, door iedereen | Nee | Nee |
| Tekst in afbeeldingen | Zwak vóór 3, goed vanaf 3.5 | Goed sinds v6 | Zeer goed |
Hetzelfde diffusieprincipe drijft nu modellen van andere labs aan, met andere encoders en andere licenties: FLUX van Black Forest Labs, opgericht door de oorspronkelijke auteurs van Stable Diffusion, en Qwen-Image van Alibaba. Ze draaien in dezelfde interfaces, met dezelfde seeds, steps en samplers, dus het meeste van deze pagina gaat ook voor hen op. Hun guidance werkt anders, FLUX dev heeft geen negatieve prompt, en ze geven de voorkeur aan volledige zinnen boven lijsten met trefwoorden.
Bronnen, en hoe je de figuren mag hergebruiken
De primaire bronnen, in de volgorde waarin de pagina ze tegenkomt:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: het Stable Diffusion-paper.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: het voorwaartse en omgekeerde proces en het schema van duizend stappen.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho en Salimans, 2022: de guidance scale.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, en Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL en Stable Diffusion 3.
De figuren hergebruiken. De renders en schema's op deze pagina zijn vrijgegeven onder CC BY 4.0: gebruik ze in een cursus, een lezing of een artikel met een link naar deze pagina. Elke render gebruikt Stable Diffusion XL, euler, 30 steps, CFG 6, seed 20220822, de prompt hieronder en de negatieve prompt "text, watermark, signature, blurry, low quality, storm, dark clouds, sunset".
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesDeze pagina citeren.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion