Stable Diffusion kort fortalt
Stable Diffusion er en open source latent diffusionsmodel (LDM): et neuralt netværk, der er trænet til at forvandle tilfældig støj til et billede, lidt ad gangen, styret af en tekst. Den blev bygget af CompVis-gruppen på Ludwig-Maximilians-Universität i München sammen med Runway og trænet med regnekraft fra Stability AI på billeder indsamlet af den almennyttige organisation LAION. Metoden stammer fra artiklen High-Resolution Image Synthesis with Latent Diffusion Models (Rombach og kolleger, CVPR 2022).
Vægtene blev offentliggjort den 22. august 2022. Det er den del, der ændrede alt. DALL-E 2 og Midjourney fandtes, men bag ventelister og credits, på andres servere. Stable Diffusion var en fil på 4 GB, der kørte på et grafikkort med 8 GB hukommelse, uden konto og med et sikkerhedsfilter, man kunne slå fra.
I løbet af få uger kom webgrænsefladerne og inpainting, derefter finjusteringerne, LoRA'erne og ControlNet. Fire år senere betyder navnet to ting. I snæver forstand modelfamilien fra 1.4 til 3.5. I bred forstand hele den praksis at køre billedmodeller på sin egen maskine.
Det følgende forklarer selve maskinen, med det ordforråd du møder i enhver grænseflade: latent rum, VAE, U-Net, CLIP, sampler, guidance-skala, seed. Der kræves ingen formler, men et par tal hjælper.
Hvordan virker Stable Diffusion? Tre netværk og én løkke
Stable Diffusion er ikke ét netværk, men tre, der kører efter hinanden.
- En tekst-encoder læser prompten og laver den om til en liste af tal. I Stable Diffusion 1.5 er det 77 tokens, hver beskrevet af 768 tal; 2.048 i SDXL, som kører to encodere.
- En denoiser, et U-Net i versionerne 1 til XL og en transformer (MMDiT) fra version 3, starter fra en blok af tilfældig støj og renser den over 20 til 30 steps, mens den ved hvert trin rådfører sig med teksttallene. Den arbejder ikke på pixels, men på en komprimeret udgave af billedet, det latente billede, som lever i det, der kaldes det latente rum: 4 × 64 × 64 tal for et billede på 512 pixels, 4 × 128 × 128 for SDXL's 1024 pixels.
- En decoder laver det latente billede om til de endelige pixelværdier, rød, grøn og blå: 3 × 512 × 512, eller 3 × 1024 × 1024 for SDXL.
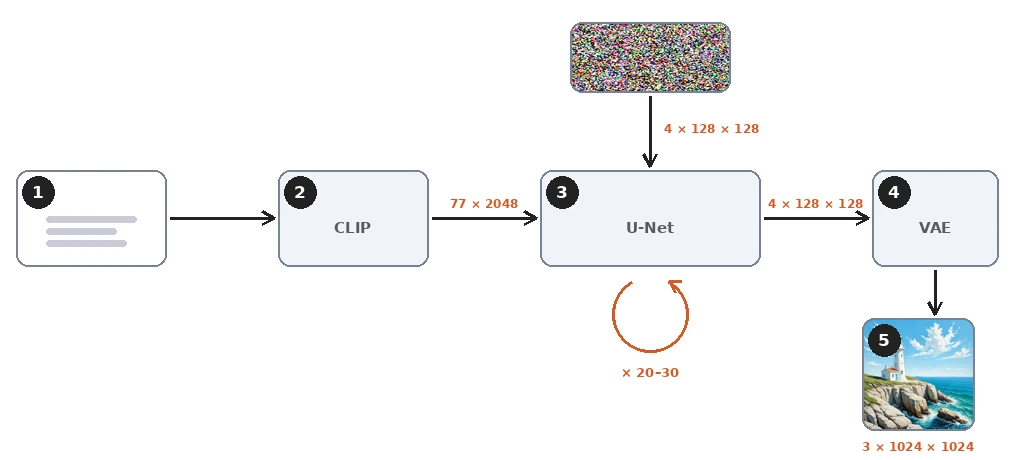
Intet slås op eller kopieres undervejs. Der er ingen billeddatabase inde i filen. De 2 til 16 GB vægte rummer det, netværket har lært om, hvordan billedtekster og billeder hører sammen, og hvert resultat beregnes ud fra støj. Netværket kan stadig huske billeder, der optrådte mange gange i træningen, og forskere har trukket et par hundrede af dem ud, men det er undtagelsen.
Hvad er en diffusionsmodel? At lære at fjerne støj
Den fremadrettede proces: at tilføje støj
Idéen bag diffusion er enkel at formulere. Tag et foto med dets billedtekst. Tilføj en afmålt mængde tilfældig støj. Bed et netværk gætte, hvilken støj der blev tilføjet, når det kender billedteksten. Sammenlign dets gæt med sandheden, og ret netværket en smule.
At tilføje støjen er den fremadrettede proces. Den følger en fast plan med tusind niveauer, fra en svag kornethed ved niveau 50 til ren sne ved niveau 999. Netværket ser aldrig planen blive kørt igennem; det ser kun ét støjende billede på ét niveau ad gangen.
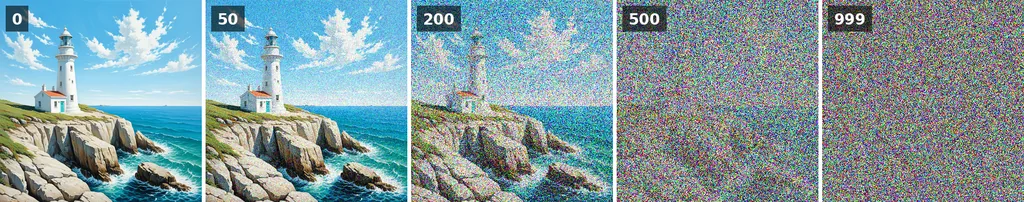
Gør det over milliarder af eksempler, og resultatet er en støjforudsiger: givet et støjende billede, dets støjniveau og en tekst siger den, hvad støjen sandsynligvis er. Træningsmålet er blot afstanden mellem den forudsagte støj og den rigtige. Træningen af Stable Diffusion 1 tog omkring 150.000 timer på A100-GPU'er i et datacenter ifølge dens modelkort.
Den omvendte proces: støjforudsigeren på arbejde
Genereringen kører lektionen baglæns. Det er den omvendte proces. Start fra ren støj, som seedet vælger. Spørg forudsigeren, hvad støjen er, fjern en brøkdel af den, spørg igen. DDPM, artiklen fra 2020, der gjorde diffusion praktisk anvendelig, gjorde det i tusind små trin.
Sampleren, i nogle grænseflader også kaldet scheduler, er den regel, der afgør, hvor stort hvert trin er, og om der lægges lidt frisk støj tilbage. Bedre samplere, DDIM, Euler og DPM++-familien, tager større skridt ad den samme sti, og det er derfor, 20 til 30 steps er nok i dag.
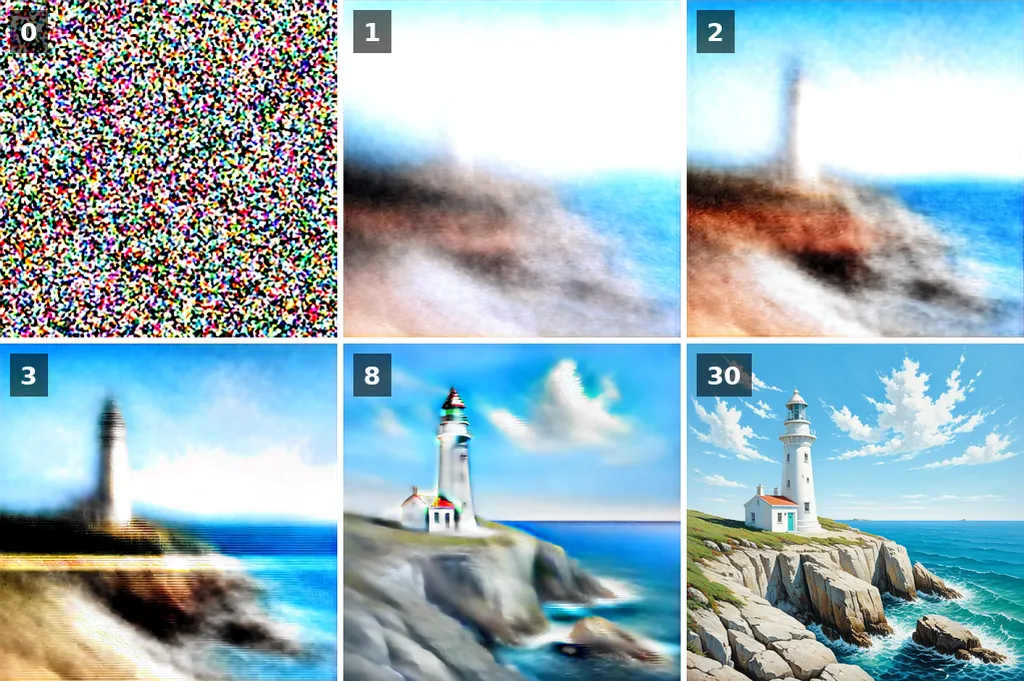
Figuren viser det, der er værd at huske. Ved hvert trin har modellen et gæt på det færdige billede, og gættet falder tidligt på plads. De første to eller tre trin, mens støjen er kraftig, fastlægger kompositionen: hvor horisonten ligger, hvor fyrtårnet står, hvor meget himmel der er. De senere trin forfiner tekstur og små detaljer.
Skyderen herunder gennemgår alle tredive gæt fra den samme rendering.
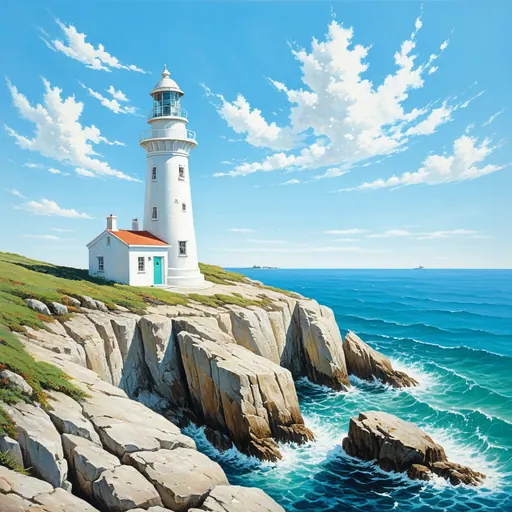
Det har to praktiske konsekvenser. Ændrer du antallet af steps, ændres detaljerne og nogle gange kompositionen, fordi de tidlige trin lander på andre værdier; det gør ikke bare det samme billede skarpere. Og det samme seed i en anden billedstørrelse starter fra en anden blok af støj, så det giver også et andet billede. Vælg størrelsen først, og led så efter et seed.
Latent diffusion: VAE-tricket, der får den til at køre på et gaming-kort
Tidligere diffusionsmodeller arbejdede på pixels. Et billede på 512 × 512 er 786.432 tal, og forudsigeren skulle læse og skrive dem alle ved hvert eneste trin. Pixelmodeller som DALL-E 2 og Imagen kom uden om det ved at diffundere i 64 pixels og tilføje opskaleringsnetværk, og de blev alligevel aldrig frigivet.
Stable Diffusion tilføjer en variational autoencoder, VAE'en. Dens encoder presser et billede sammen med en faktor otte på hver led til fire kanaler: 4 × 64 × 64, altså 16.384 tal, 48 gange færre. Diffusionen kører udelukkende i det komprimerede rum, det latente rum. Først til allersidst folder VAE'ens decoder resultatet ud til pixels.

Det latente billede er ikke et lille billede. Dets fire kanaler er en kode, som decoderen ved, hvordan den skal læse, og ingen enkelt kanal ligner helt billedet. Men layoutet overlever komprimeringen, og det er det, der lader denoiseren afgøre kompositionen i så lille et rum.
Det er også derfor, valget af VAE har betydning for farver og fine detaljer: hvert latent tal står for et felt på 8 × 8 pixels, og decoderen opfinder det, der ligger inde i feltet. Stable Diffusion 3 gik over til et latent billede med 16 kanaler af præcis den grund, og fine detaljer og lille tekst blev bedre med det.
CLIP og cross-attention: sådan styrer teksten billedet
Tre dele forvandler ord til en retning for denoiseren.
Tokenizer og tekst-encoder: sådan læser CLIP en prompt
Tokenizeren klipper prompten op i tokens, hele almindelige ord eller stumper af sjældnere. Stable Diffusion 1.5 og SDXL læser højst 77 tokens, hvoraf to er start- og slutmarkører, omkring 50 til 60 engelske ord. Alt ud over det klippes af, medmindre grænsefladen deler den op i flere gennemløb. Sæt det vigtigste først.
Tekst-encoderen i 1.5 er CLIP, et netværk OpenAI trænede på 400 millioner par af billeder og billedtekster, med én opgave: at bringe de tal, der beskriver en billedtekst, tæt på de tal, der beskriver dens billede. Efter den træning bærer tallene for "lighthouse" allerede på, hvordan fyrtårne ser ud. SDXL kører to sådanne encodere side om side, den anden en åben gentræning udført af LAION på to milliarder par. Stable Diffusion 3 tilføjer en tredje, T5, som læser hele sætninger.
Cross-attention inde i U-Nettet
Cross-attention er der, hvor teksten møder billedet. U-Nettet er en stak af foldningsblokke, der formindsker det latente billede og derefter lader det vokse igen, med skip-forbindelser mellem matchende størrelser. Mellem disse blokke sidder attention-lag. Ved hvert trin kigger hvert område af det latente billede på de 77 token-vektorer og vægter, hvilke af dem der vedrører det. Himmelområdet lytter til "sunset" og "clouds", klippen til "cliff". Det er derfor, ordenes rækkefølge, gentagelse og grænsefladernes vægtningssyntaks har en virkning, og derfor, at et stilord i begyndelsen farver hele billedet.
Det er også de første versioners begrænsning. CLIP lærte af korte alt-tekster, så den forstår lister af motiver og stilarter godt og relationer mellem dem dårligt. "A red cube on a blue sphere" kommer ofte ombyttet ud i 1.5. Promptguiden viser, hvad der virker pålideligt.
Guidance-skala, negativ prompt og seed: de tre indstillinger
Tre indstillinger går igen i enhver Stable Diffusion-grænseflade. De svarer direkte til maskineriet ovenfor.
Guidance-skalaen, CFG-skalaen, kort for classifier-free guidance (CFG), er den, der afgør, hvor hårdt teksten presses igennem. Ved hvert trin laver denoiseren faktisk to forudsigelser: én med prompten og én med en tom prompt. Forskellen mellem de to er den retning, prompten giver. Den endelige forudsigelse er den tomme plus den forskel ganget med guidance-skalaen. Ved 1 bruges forudsigelsen med prompt, som den er, uden skub: billedet følger teksten løst, med matte farver og en grå himmel, hvor prompten bad om en blå. Omkring 5 til 8 følger det prompten tæt med naturlige farver. Over 12 bliver kontrasten hård, farverne mættede og strøgene grove.
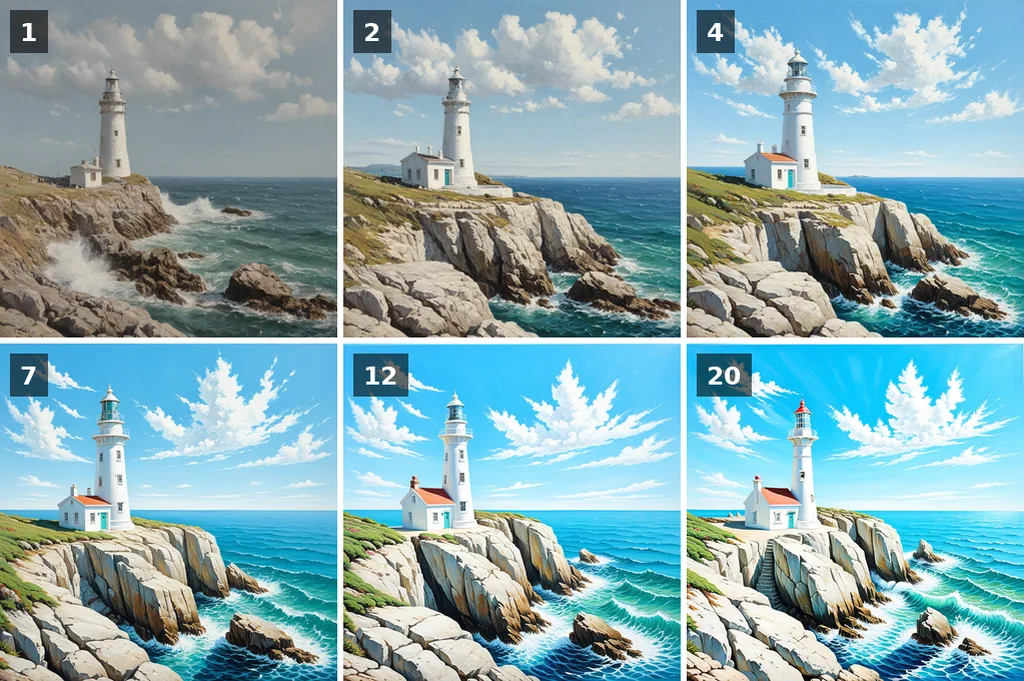
Den negative prompt erstatter den tomme prompt i den anden forudsigelse. I stedet for at læse ingenting læser det andet gennemløb "blurry, text, watermark", og guidance skubber væk fra det. Det koster ikke noget ekstra, da det andet gennemløb alligevel kører, og det virker kun, når guidance er over 1. Guiden til negativ prompt giver lister, der virker.
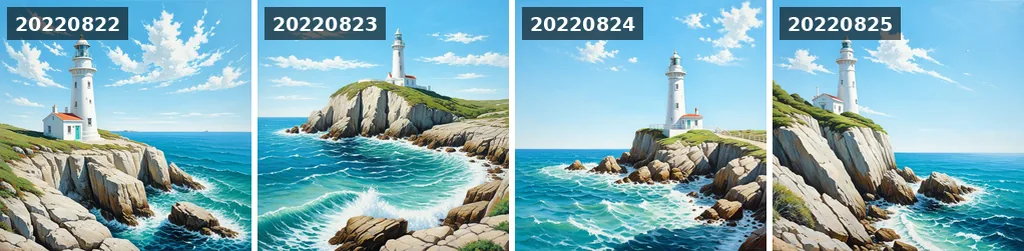
Seedet er det tal, der genererer startstøjen. Samme seed, samme prompt, samme indstillinger og samme model giver det samme billede, ned til pixlen, på samme software og hardware; en anden grænseflade eller et andet kort trækker støjen anderledes. Skift seed, og kompositionen skifter, da de første trin læser en anden blok af støj. Skift ét ord i prompten, og behold seedet, så holder det meste af billedet som regel. Sådan forfiner man en prompt.
Fra U-Net til transformer: versionerne fra 1.5 til 3.5
Seks hovedgenerationer udkom på to år, de to første fra CompVis og Runway, resten fra Stability AI. Hver af dem ændrede mindst ét af de tre netværk.
| Version | Dato | Denoiser | Tekst-encodere | Nativ størrelse |
|---|---|---|---|---|
| 1.4 og 1.5 | august og oktober 2022 | U-Net, 860 millioner parametre | CLIP ViT-L | 512 px |
| 2.0 og 2.1 | november og december 2022 | U-Net med samme design, trænet forfra | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | juli 2023 | U-Net, 2,6 milliarder, plus en refiner | CLIP ViT-L og OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | november 2023 | SDXL destilleret til 1 til 4 steps | Samme som SDXL | 512 px |
| 3 Medium | juni 2024 | Diffusion transformer (MMDiT), 2 milliarder | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | oktober 2024 | MMDiT, 8 milliarder; Medium 2,5 milliarder | De samme tre | 1024 px |
1.5 er stadig en af de mest finjusterede modeller, der findes, med titusindvis af checkpoints og LoRAs fra fællesskabet, og den kører stadig på 4 GB videohukommelse. SDXL er arbejdshesten: bedre hænder, ansigter og komposition og nativt output i 1024 pixels. 3 og 3.5 erstattede U-Nettet med en transformer, der behandler tekst- og billedtokens sammen, og det er det, der endelig gjorde læselig tekst i billeder mulig: sæt ordene i anførselstegn i prompten. Sammenligningen af SDXL og Stable Diffusion 3 viser de samme prompts på begge.
Licenserne ændrede sig også. 1.5 er under CreativeML OpenRAIL-M-licensen og SDXL under OpenRAIL++-M, begge fri til kommerciel brug med en liste over forbudte anvendelser. 3.x-modellerne er under Stability AI Community License, gratis under en million dollars i årlig omsætning.
Hvad du kan bruge den til: img2img, inpainting, ControlNet, LoRA
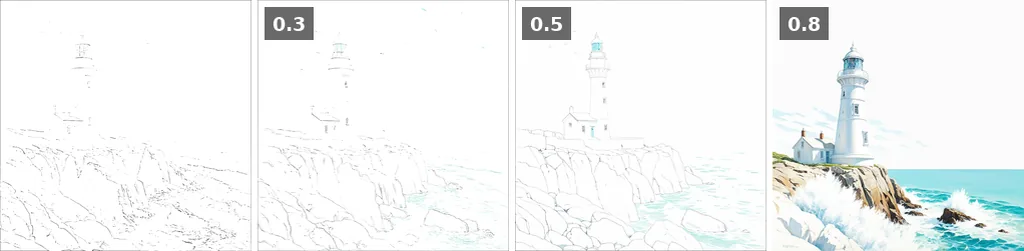
Tekst til billede er kun begyndelsen, for hver del af pipelinen kan genbruges. Kod en skitse til et latent billede, tilføj kun en del af støjen, og fjern støjen derfra, og du har billede til billede, img2img i grænsefladerne: indstillingen strength, eller denoise, er, hvor meget støj du tilføjer. Idéen kommer fra SDEdit. Masker ét område af det latente billede, og du har inpainting, eller outpainting, når masken ligger uden for rammen. Tilføj et lille sidenetværk, der læser en pose, et dybdekort eller kanter, og du har ControlNet. Træn et par millioner ekstra vægte på tyve fotos, og du har et LoRA, der lærer modellen et ansigt eller en stil. Dedikerede superopløsningsmodeller tager sig af opskalering.
Vil du køre den selv, rækker et nyere NVIDIA-kort med 6 GB videohukommelse (VRAM) til 1.5 og 8 GB til SDXL. AMD-kort virker via ROCm, Apple Silicon via MPS-backend. Installationsguiden dækker de tre vigtigste grænseflader. Uden et kort kræver værktøjerne på dette websted ingen hardware: Stable Diffusion XL og Stable Diffusion 1.5 kører på webstedets egen GPU med køen vist live, dokumenterede prompts viser, hvad hver indstilling gør, og 1.731 kunstnerstile viser, hvad modellen har lært om malere.
Stable Diffusion vs Midjourney vs DALL-E
Over for Midjourney og OpenAIs billedmodeller er forskellen ikke kvalitet, men kontrol. Vægtene er offentlige, og modellen kører lokalt: dine billeder bliver på din disk, du vælger modellen, du sætter seedet, og du kan udskifte enhver komponent. Til gengæld kræver den mere af dig. Midjourney beder om en sætning og giver et poleret billede; Stable Diffusion beder om en model, en prompt, en negativ prompt og en guidance-skala og giver dig præcis det, du har indstillet.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Vægte | Offentlige, kan downloades | Lukkede | Lukkede |
| Kører på din egen computer | Ja, 6 til 8 GB VRAM | Nej | Nej |
| Pris | Gratis lokalt; gratis værktøjer online | Abonnement | Abonnement eller pr. billede |
| Kontrol | Seed, model, LoRA, ControlNet, inpainting, hver eneste indstilling | Parametre og stilreferencer | Samtale |
| Finjustering | Ja, af alle | Nej | Nej |
| Tekst i billeder | Svag før 3, god fra 3.5 | God siden v6 | Meget god |
Det samme diffusionsprincip driver nu modeller fra andre laboratorier, med andre encodere og andre licenser: FLUX fra Black Forest Labs, grundlagt af de oprindelige Stable Diffusion-forfattere, og Qwen-Image fra Alibaba. De kører i de samme grænseflader, med de samme seeds, steps og samplere, så det meste af denne side gælder også for dem. Deres guidance virker anderledes, FLUX dev har ingen negativ prompt, og de foretrækker hele sætninger frem for lister af nøgleord.
Kilder, og hvordan du må genbruge figurerne
De primære kilder, i den rækkefølge siden møder dem:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: Stable Diffusion-artiklen.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: den fremadrettede og den omvendte proces og planen med tusind trin.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho og Salimans, 2022: guidance-skalaen.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, og Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL og Stable Diffusion 3.
Genbrug af figurerne. Renderingerne og diagrammerne på denne side er udgivet under CC BY 4.0: genbrug dem i et kursus, et foredrag eller en artikel med et link til denne side. Hver rendering bruger Stable Diffusion XL, euler, 30 steps, CFG 6, seed 20220822, prompten herunder og den negative prompt "text, watermark, signature, blurry, low quality, storm, dark clouds, sunset".
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesSådan citerer du denne side.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion