Stable Diffusion in breve
Stable Diffusion è un modello di diffusione latente (LDM) open source: una rete neurale addestrata a trasformare del rumore casuale in un’immagine, un po’ alla volta, guidata da un testo. È stato costruito dal gruppo CompVis dell’Università Ludwig Maximilian di Monaco insieme a Runway, e addestrato con la potenza di calcolo di Stability AI su immagini raccolte dall’organizzazione non profit LAION. Il metodo viene dall’articolo High-Resolution Image Synthesis with Latent Diffusion Models (Rombach e colleghi, CVPR 2022).
I pesi sono stati pubblicati il 22 agosto 2022. È questo che ha cambiato tutto. DALL-E 2 e Midjourney esistevano già, ma dietro liste d’attesa e crediti, sui server di qualcun altro. Stable Diffusion era un file da 4 GB che girava su una scheda grafica con 8 GB di memoria, senza account e con un filtro di sicurezza che si poteva disattivare.
Nel giro di settimane sono arrivate le interfacce web e l’inpainting, poi i fine-tune, i LoRA e ControlNet. Quattro anni dopo il nome significa due cose. In senso stretto, la famiglia di modelli dalla 1.4 alla 3.5. In senso lato, tutta la pratica di far girare modelli di immagini sulla propria macchina.
Quello che segue spiega la macchina in sé, con il vocabolario che incontrerai in ogni interfaccia: spazio latente, VAE, U-Net, CLIP, sampler, scala di guidance, seed. Non serve nessuna formula, ma qualche numero aiuta.
Come funziona Stable Diffusion? Tre reti e un ciclo
Stable Diffusion non è una rete ma tre, eseguite una dopo l’altra.
- Un codificatore di testo legge il prompt e lo trasforma in una lista di numeri. In Stable Diffusion 1.5 sono 77 token, ciascuno descritto da 768 numeri; 2.048 in SDXL, che esegue due codificatori.
- Un denoiser, una U-Net nelle versioni da 1 a XL e un transformer (MMDiT) dalla versione 3 in poi, parte da un blocco di rumore casuale e lo ripulisce in 20-30 passi, consultando i numeri del testo a ogni passo. Non lavora sui pixel ma su una versione compatta dell’immagine, il latente, che vive in quello che si chiama spazio latente: 4 × 64 × 64 numeri per un’immagine da 512 pixel, 4 × 128 × 128 per i 1024 pixel di SDXL.
- Un decodificatore trasforma quel latente nei valori finali dei pixel, rosso, verde e blu: 3 × 512 × 512, oppure 3 × 1024 × 1024 per SDXL.
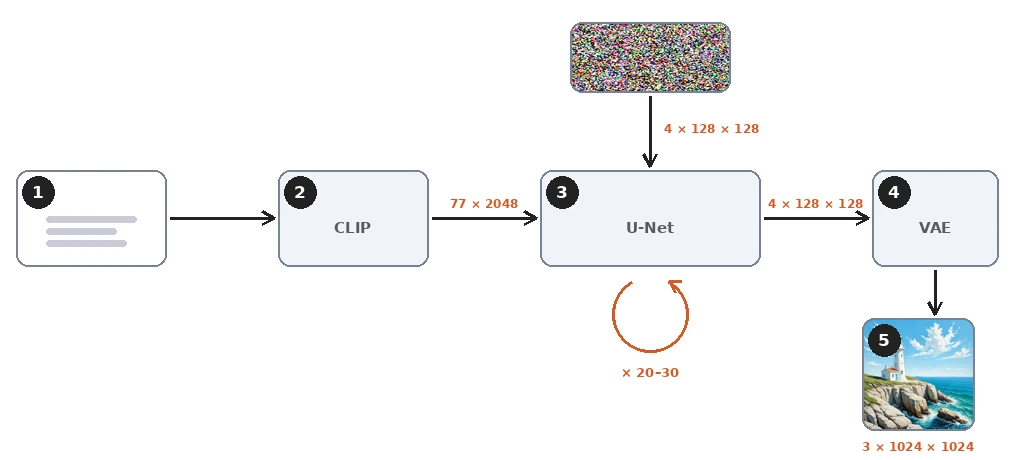
Lungo il percorso non viene cercato né copiato nulla. Dentro il file non c’è nessun database di immagini. I 2-16 GB di pesi contengono ciò che la rete ha imparato su come didascalie e immagini stanno insieme, e ogni risultato è calcolato a partire dal rumore. La rete può comunque memorizzare immagini apparse molte volte nell’addestramento, e alcuni ricercatori ne hanno estratte qualche centinaio, ma è l’eccezione.
Cos’è un modello di diffusione? Imparare a togliere il rumore
Il processo diretto: aggiungere rumore
L’idea della diffusione è semplice da enunciare. Prendi una foto con la sua didascalia. Aggiungici una quantità misurata di rumore casuale. Chiedi a una rete di indovinare quale rumore è stato aggiunto, conoscendo la didascalia. Confronta la sua risposta con la verità e correggi un po’ la rete.
Aggiungere il rumore è il processo diretto. Segue un programma fisso di mille livelli, da una grana leggera al livello 50 a pura neve al livello 999. La rete non vede mai il programma scorrere; vede solo un’immagine rumorosa a un certo livello, una alla volta.
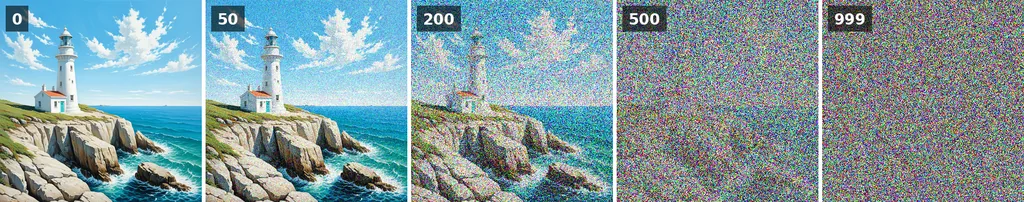
Fallo su miliardi di esempi e il risultato è un predittore di rumore: data un’immagine rumorosa, il suo livello di rumore e un testo, dice qual è probabilmente il rumore. L’obiettivo di addestramento è solo lo scarto tra il rumore previsto e quello reale. Addestrare Stable Diffusion 1 ha richiesto circa 150.000 ore su GPU A100 da data center, secondo la sua scheda del modello.
Il processo inverso: il predittore di rumore al lavoro
La generazione ripete la lezione al contrario. È il processo inverso. Parti da rumore puro, scelto dal seed. Chiedi al predittore qual è il rumore, togline una frazione, chiedi di nuovo. DDPM, l’articolo del 2020 che ha reso la diffusione utilizzabile in pratica, lo faceva in mille piccoli passi.
Il sampler, chiamato anche scheduler in alcune interfacce, è la regola che decide quanto è grande ogni passo e se viene aggiunto un po’ di rumore fresco. I sampler migliori, DDIM, Euler e la famiglia DPM++, fanno passi più grandi lungo lo stesso percorso, ed è per questo che oggi bastano 20-30 passi.
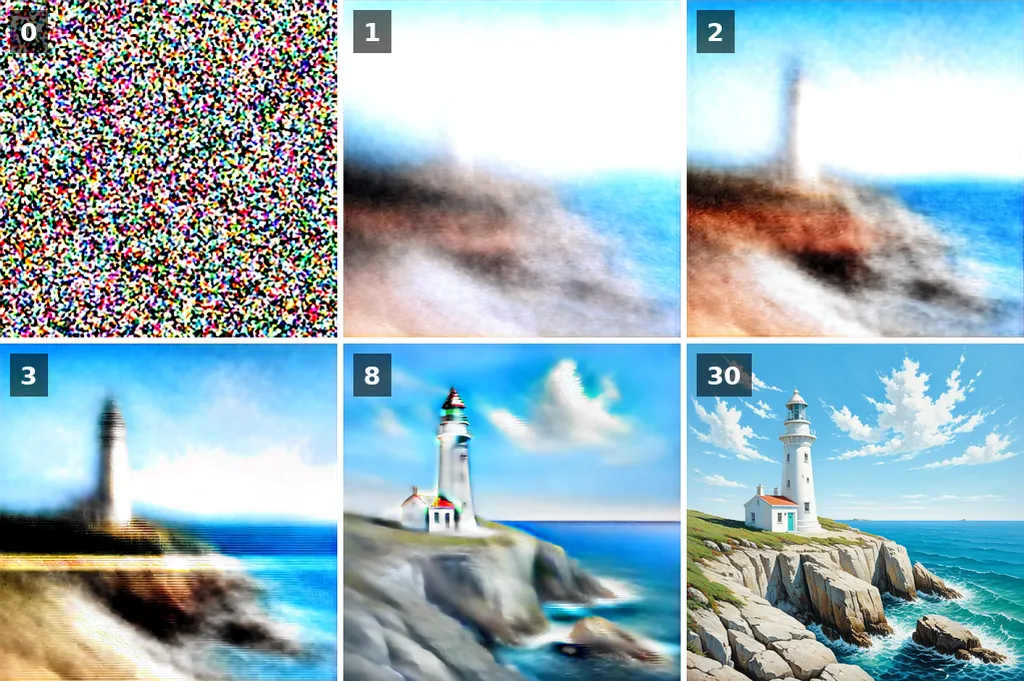
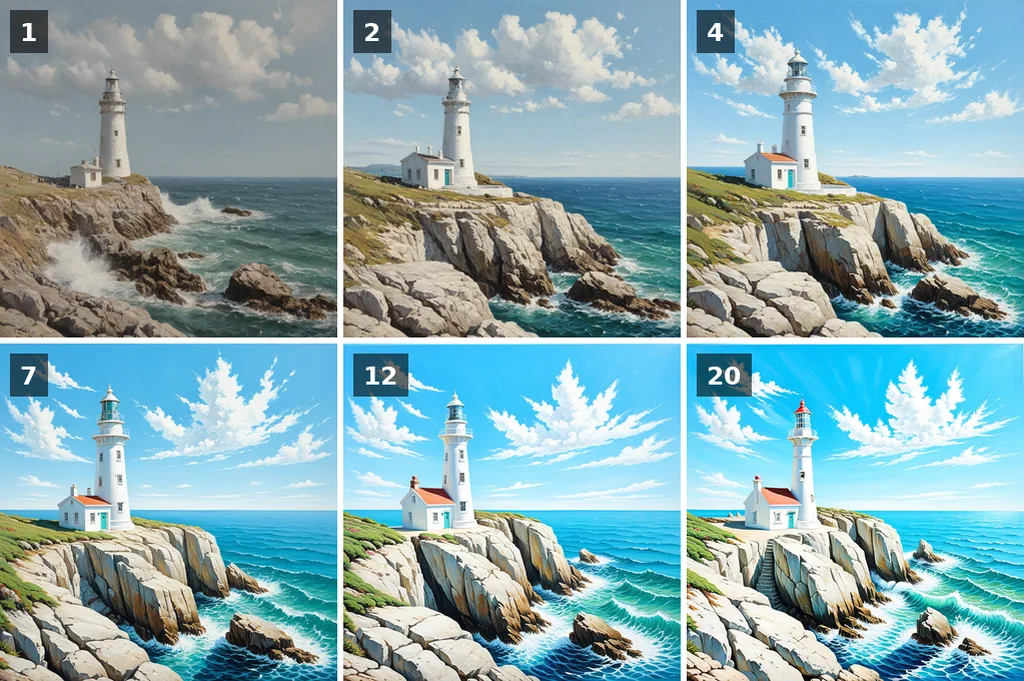
La figura mostra la parte da ricordare. A ogni passo il modello ha una stima dell’immagine finita, e quella stima si assesta presto. I primi due o tre passi, mentre il rumore è ancora pesante, fissano la composizione: dov’è l’orizzonte, dove sorge il faro, quanto cielo c’è. I passi successivi rifiniscono la texture e i piccoli dettagli.
Il cursore qui sotto scorre tutte e trenta le stime dello stesso render.
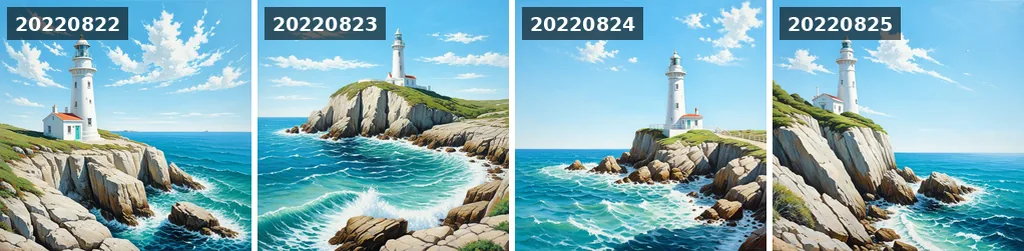
Ne seguono due conseguenze pratiche. Cambiare il numero di passi cambia i dettagli e a volte la composizione, perché i primi passi finiscono su altri valori; non si limita a rendere più nitida la stessa immagine. E lo stesso seed a un’altra dimensione di immagine parte da un altro blocco di rumore, quindi dà anche un’altra immagine. Scegli prima la dimensione, poi cerca un seed.
Diffusione latente: il trucco del VAE che la fa stare su una scheda grafica da gioco
I primi modelli di diffusione lavoravano sui pixel. Un’immagine da 512 × 512 è fatta di 786.432 numeri, e il predittore doveva leggerli e scriverli tutti a ciascuno dei suoi passi. I modelli a pixel come DALL-E 2 e Imagen aggiravano il problema diffondendo a 64 pixel e aggiungendo reti di ingrandimento, e comunque non sono mai stati pubblicati.
Stable Diffusion aggiunge un autoencoder variazionale, il VAE. Il suo codificatore comprime l’immagine di un fattore otto su ogni lato in quattro canali: 4 × 64 × 64, cioè 16.384 numeri, 48 volte meno. La diffusione si svolge interamente in quello spazio compresso, lo spazio latente. Solo alla fine il decodificatore del VAE espande il risultato in pixel.

Il latente non è un’immagine piccola. I suoi quattro canali sono un codice che il decodificatore sa leggere, e nessun canale da solo somiglia davvero all’immagine. Ma la disposizione sopravvive alla compressione, ed è questo che permette al denoiser di decidere la composizione in uno spazio così ridotto.
È anche il motivo per cui la scelta del VAE conta per il colore e i dettagli fini: ogni numero del latente rappresenta un riquadro di 8 × 8 pixel, e il decodificatore inventa ciò che c’è dentro il riquadro. Stable Diffusion 3 è passato a un latente a 16 canali proprio per questa ragione, e con esso sono migliorati i dettagli fini e il testo piccolo.
CLIP e cross-attention: come il testo guida l’immagine
Tre pezzi trasformano le parole in una direzione per il denoiser.
Tokenizer e codificatore di testo: come CLIP legge un prompt
Il tokenizer taglia il prompt in token, parole comuni intere o frammenti di quelle più rare. Stable Diffusion 1.5 e SDXL leggono al massimo 77 token, due dei quali sono marcatori di inizio e fine, circa 50-60 parole inglesi. Oltre, il testo viene tagliato, a meno che l’interfaccia non lo divida in più passate. Metti all’inizio ciò che conta di più.
Il codificatore di testo della 1.5 è CLIP, una rete che OpenAI ha addestrato su 400 milioni di coppie di immagini e didascalie, con un solo compito: avvicinare i numeri che descrivono una didascalia ai numeri che descrivono la sua immagine. Dopo quell’addestramento, i numeri di «lighthouse» portano già con sé l’aspetto di un faro. SDXL esegue due codificatori di questo tipo fianco a fianco, il secondo un riaddestramento aperto di LAION su due miliardi di coppie. Stable Diffusion 3 ne aggiunge un terzo, T5, che legge frasi intere.
La cross-attention dentro la U-Net
La cross-attention, o attenzione incrociata, è il punto in cui il testo incontra l’immagine. La U-Net è una pila di blocchi di convoluzione che rimpiccioliscono il latente e poi lo riportano alla dimensione originale, con connessioni di salto tra le dimensioni corrispondenti. Tra quei blocchi ci sono strati di attenzione. A ogni passo, ogni regione del latente guarda i 77 vettori dei token e valuta quali la riguardano. La regione del cielo presta attenzione a «sunset» e «clouds», la roccia a «cliff». È per questo che l’ordine delle parole, le ripetizioni e la sintassi dei pesi delle interfacce hanno effetto, e che una parola di stile messa all’inizio colora tutta l’immagine.
È anche il limite delle prime versioni. CLIP ha imparato da brevi testi alternativi, quindi capisce bene gli elenchi di soggetti e stili e male le relazioni tra loro. «A red cube on a blue sphere» esce spesso invertito nella 1.5. La guida al prompt mostra cosa funziona in modo affidabile.
Scala di guidance (CFG), prompt negativo e seed: le tre impostazioni
Tre impostazioni compaiono in ogni interfaccia di Stable Diffusion. Corrispondono direttamente al meccanismo descritto sopra.
La scala di guidance, o CFG, abbrevia la guida senza classificatore (classifier-free guidance): è quella che decide con quanta forza viene imposto il testo. A ogni passo il denoiser fa in realtà due previsioni: una con il prompt e una con un prompt vuoto. La differenza tra le due è la direzione che dà il prompt. La previsione finale è quella vuota più quella differenza moltiplicata per la scala di guidance. A 1 la previsione con il prompt viene usata così com’è, senza spinta: l’immagine segue il testo alla lontana, con colori smorti e un cielo grigio dove il prompt ne chiedeva uno azzurro. Intorno a 5-8 segue il prompt da vicino, con colori naturali. Oltre 12 il contrasto si indurisce, i colori si saturano e le pennellate diventano dure.
Il prompt negativo sostituisce il prompt vuoto di quella seconda previsione. Invece di non leggere nulla, la seconda passata legge «blurry, text, watermark», e la guidance spinge nella direzione opposta. Non costa nulla in più, perché la seconda passata gira comunque, e funziona solo quando la guidance è sopra 1. La guida al prompt negativo dà liste che funzionano.
Il seed è il numero che genera il rumore iniziale. Stesso seed, stesso prompt, stesse impostazioni e stesso modello danno la stessa immagine, pixel per pixel, sullo stesso software e sullo stesso hardware; un’altra interfaccia o un’altra scheda genera il rumore in modo diverso. Cambia il seed e cambia la composizione, perché i primi passi leggono un altro blocco di rumore. Cambia una parola del prompt tenendo il seed, e in genere gran parte dell’immagine resta. È così che si rifinisce un prompt.
Dalla U-Net al transformer: le versioni dalla 1.5 alla 3.5
Sei generazioni principali sono uscite in due anni, le prime due da CompVis e Runway, le altre da Stability AI. Ognuna ha cambiato almeno una delle tre reti.
| Versione | Data | Denoiser | Codificatori di testo | Dimensione nativa |
|---|---|---|---|---|
| 1.4 e 1.5 | Agosto e ottobre 2022 | U-Net, 860 milioni di parametri | CLIP ViT-L | 512 px |
| 2.0 e 2.1 | Novembre e dicembre 2022 | U-Net della stessa architettura, riaddestrata da zero | OpenCLIP ViT-H | 768 px |
| SDXL 1.0 | Luglio 2023 | U-Net, 2,6 miliardi, più un refiner | CLIP ViT-L e OpenCLIP ViT-bigG | 1024 px |
| SDXL Turbo | Novembre 2023 | SDXL distillato a 1-4 passi | Gli stessi di SDXL | 512 px |
| 3 Medium | Giugno 2024 | Transformer di diffusione (MMDiT), 2 miliardi | CLIP ViT-L, OpenCLIP bigG, T5-XXL | 1024 px |
| 3.5 Large, Large Turbo, Medium | Ottobre 2024 | MMDiT, 8 miliardi; Medium 2,5 miliardi | Gli stessi tre | 1024 px |
1.5 resta uno dei modelli più riaddestrati in assoluto, con decine di migliaia di checkpoint e LoRA della community, e gira ancora con 4 GB di memoria video. SDXL è il cavallo di battaglia: mani, volti e composizione migliori, e output nativo a 1024 pixel. 3 e 3.5 hanno sostituito la U-Net con un transformer che tratta insieme i token di testo e di immagine, ed è questo che ha finalmente reso possibile un testo leggibile nelle immagini: metti le parole tra virgolette nel prompt. Il confronto tra SDXL e Stable Diffusion 3 mostra gli stessi prompt su entrambi.
Sono cambiate anche le licenze. La 1.5 è sotto licenza CreativeML OpenRAIL-M e SDXL sotto OpenRAIL++-M, entrambe libere per uso commerciale con una lista di usi vietati. I modelli 3.x sono sotto la Stability AI Community License, gratuita sotto il milione di dollari di ricavi annui.
Cosa ci si può fare: image-to-image, inpainting, ControlNet, LoRA
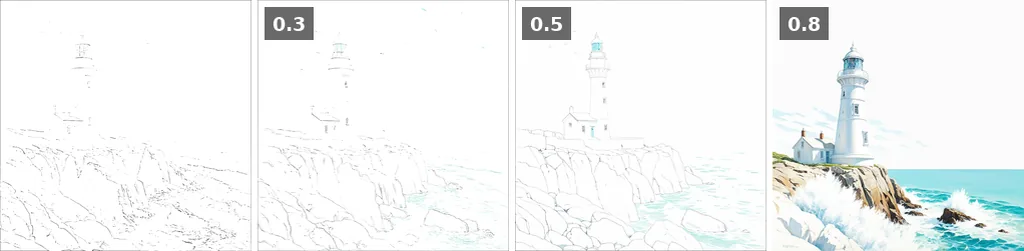
Il testo a immagine è solo l’inizio, perché ogni pezzo della pipeline può essere riutilizzato. Codifica uno schizzo in un latente, aggiungi solo una parte del rumore e rimuovi il rumore da lì, e hai l’image-to-image, img2img nelle interfacce: l’impostazione di forza (strength), o denoise, è quanto rumore aggiungi. L’idea viene da SDEdit. Maschera una regione del latente e hai l’inpainting, o l’outpainting quando la maschera è fuori dall’inquadratura. Aggiungi una piccola rete laterale che legge una posa, una mappa di profondità o dei bordi, e hai ControlNet. Addestra qualche milione di pesi in più su venti foto e hai un LoRA che insegna al modello un volto o uno stile. Modelli di super-risoluzione dedicati si occupano dell’ingrandimento.
Per farlo girare in proprio, basta una scheda NVIDIA recente con 6 GB di memoria video (VRAM) per la 1.5 e 8 GB per SDXL. Le schede AMD funzionano tramite ROCm, Apple Silicon tramite il backend MPS. La guida all’installazione copre le tre interfacce principali. Senza scheda, gli strumenti di questo sito non richiedono alcun hardware: Stable Diffusion XL e Stable Diffusion 1.5 girano sulla GPU del sito con la coda mostrata in tempo reale, i prompt documentati mostrano cosa fa ogni impostazione, e 1.731 stili di artisti mostrano cosa ha imparato il modello sui pittori.
Stable Diffusion vs Midjourney vs DALL-E
Rispetto a Midjourney e ai modelli di immagini di OpenAI, la differenza non è la qualità ma il controllo. I pesi sono pubblici e il modello gira in locale: le tue immagini restano sul tuo disco, scegli tu il modello, imposti tu il seed e puoi cambiare qualsiasi componente. In cambio ti chiede di più. Midjourney chiede una frase e restituisce un’immagine rifinita; Stable Diffusion chiede un modello, un prompt, un prompt negativo e una scala di guidance, e ti dà esattamente ciò che hai impostato.
| Stable Diffusion | Midjourney | DALL-E / GPT Image | |
|---|---|---|---|
| Pesi | Pubblici, scaricabili | Chiusi | Chiusi |
| Gira sul tuo computer | Sì, 6-8 GB di VRAM | No | No |
| Prezzo | Gratis in locale; strumenti gratuiti online | Abbonamento | Abbonamento o a immagine |
| Controllo | Seed, modello, LoRA, ControlNet, inpainting, ogni impostazione | Parametri e riferimenti di stile | Conversazione |
| Fine-tuning | Sì, da parte di chiunque | No | No |
| Testo nelle immagini | Debole prima della 3, buono dalla 3.5 | Buono dalla v6 | Molto buono |
Lo stesso principio di diffusione alimenta oggi modelli di altri laboratori, con altri codificatori e altre licenze: FLUX di Black Forest Labs, fondato dagli autori originali di Stable Diffusion, e Qwen-Image di Alibaba. Girano nelle stesse interfacce, con gli stessi seed, passi e sampler, quindi gran parte di questa pagina vale anche per loro. La loro guidance funziona in modo diverso, FLUX dev non ha il prompt negativo, e preferiscono frasi complete a elenchi di parole chiave.
Fonti, e come riutilizzare le figure
Le fonti primarie, nell’ordine in cui la pagina le incontra:
- High-Resolution Image Synthesis with Latent Diffusion Models, Rombach et al., 2022: l’articolo di Stable Diffusion.
- Denoising Diffusion Probabilistic Models, Ho et al., 2020: i processi diretto e inverso e il programma da mille passi.
- Learning Transferable Visual Models From Natural Language Supervision, Radford et al., 2021: CLIP.
- Classifier-Free Diffusion Guidance, Ho e Salimans, 2022: la scala di guidance.
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis, 2023, e Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, 2024: SDXL e Stable Diffusion 3.
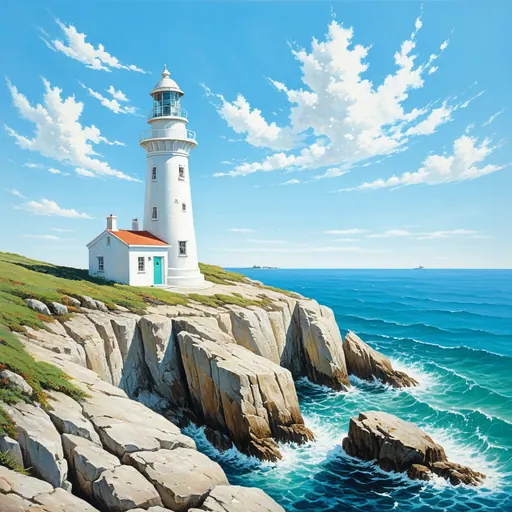
Riutilizzare le figure. I render e gli schemi di questa pagina sono pubblicati sotto CC BY 4.0: riutilizzali in un corso, una conferenza o un articolo con un link a questa pagina. Ogni render usa Stable Diffusion XL, euler, 30 passi, CFG 6, seed 20220822, il prompt qui sotto e il prompt negativo «text, watermark, signature, blurry, low quality, storm, dark clouds, sunset».
An oil painting of a white lighthouse on a rocky cliff, clear blue sky, bright midday sunlight, a few small white clouds, turquoise sea, waves breaking below, visible brush strokesPer citare questa pagina.
Clicheroux, A. (2026). What is Stable Diffusion and how does it work? stablediffusion.fr. https://stablediffusion.fr/guide/what-is-stable-diffusion