Cos'è Qwen-Image 2.1
Qwen-Image 2.1 è un solo checkpoint per due compiti. Genera un'immagine dal testo, e modifica un'immagine esistente a partire da una frase e fino a dieci immagini di riferimento. La parte di generazione è un transformer di diffusione da 7 miliardi di parametri. È abbinata a un codificatore di testo Qwen3-VL 8B, caricato in ComfyUI come file separato.
Un modello linguistico come codificatore è ciò che gli permette di leggere frasi intere, istruzioni di composizione e parole tra virgolette, invece di elenchi di parole chiave.
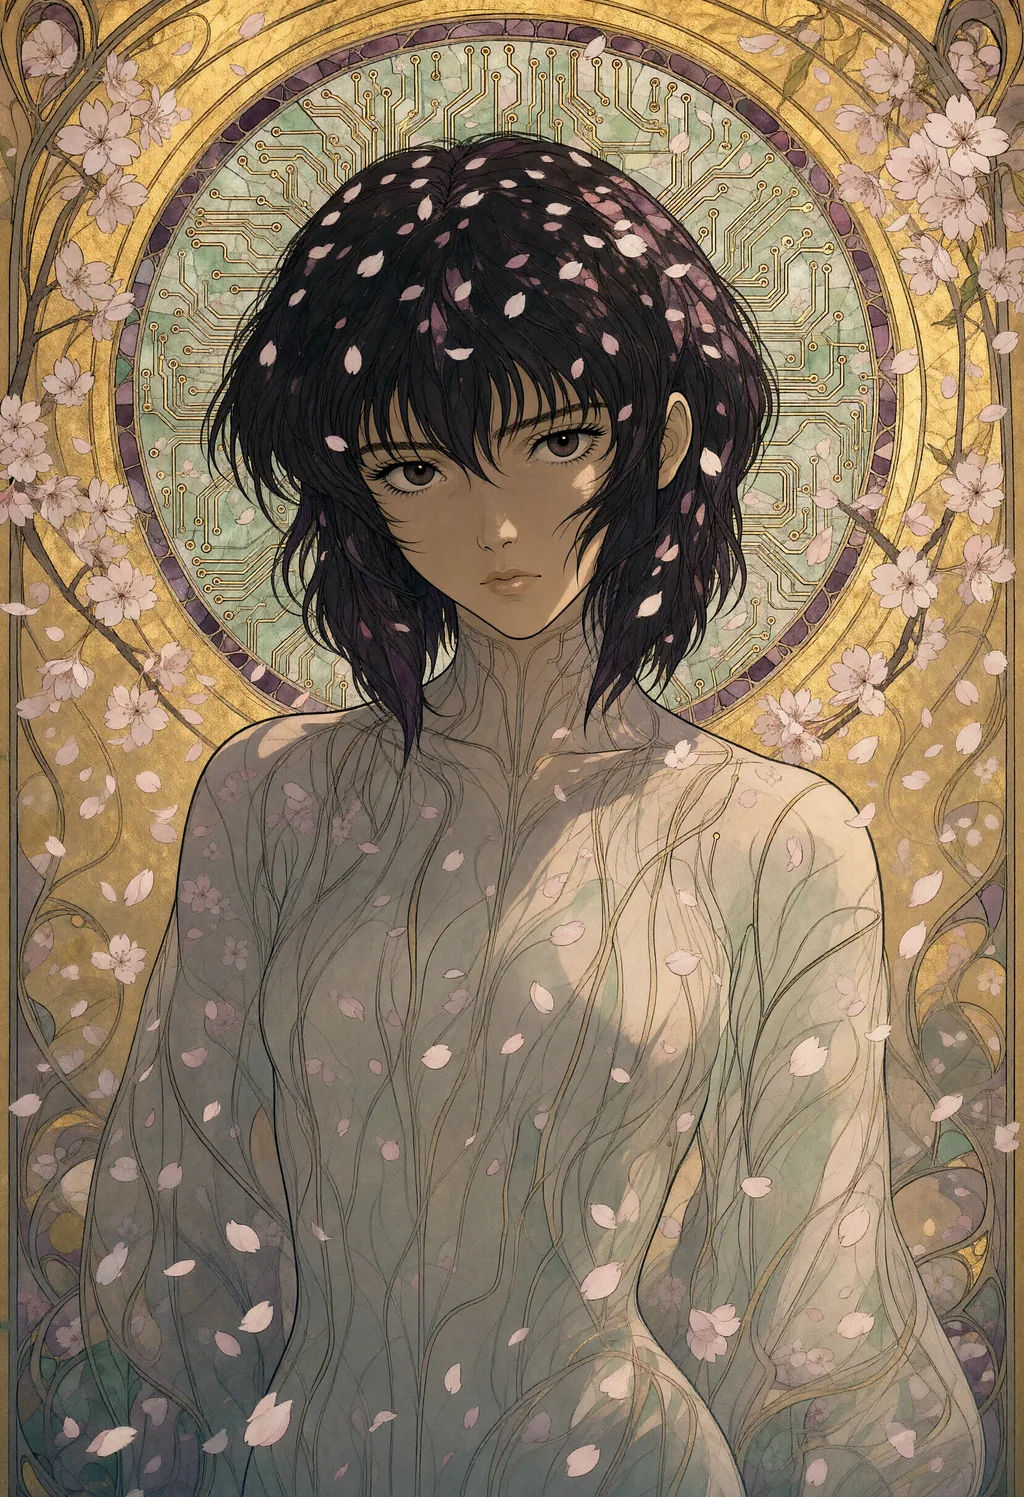
Qwen presenta la 2.1 come migliorata su texture, tipografia e illuminazione dei ritratti. Lavora in 2K nativo senza ingrandimento: 2048 × 2048 per il quadrato, 2528 × 1696 per il 3:2, 2752 × 1536 per il 16:9. Può anche produrre un vero canale alfa quando il prompt chiede uno sfondo trasparente.
Il prezzo è il tempo. Su una scheda consumer con 16 GB di memoria video, i pesi int8 impiegano circa 40 secondi per un'immagine da 1 megapixel. Un'immagine da 4 megapixel richiede circa quattro minuti e mezzo con le impostazioni qui sotto.
Una cosa da sapere prima di scaricare. I pesi sono sotto Qwen Research License: solo ricerca e valutazione. Qualunque uso commerciale richiede una licenza separata da Qwen. Il primo Qwen-Image, uscito ad agosto 2025, era Apache 2.0. La versione 2.1 non lo è.
Come scrivere un prompt per Qwen-Image 2.1
Scrivi frasi, non tag. Il codificatore di testo è un modello linguistico. Legge l'ordine delle parole, le preposizioni e le virgolette, e prende tutto alla lettera. Un «lighthouse cat» diventa un gatto disegnato su un faro.
La struttura qui sotto ha dato i risultati migliori su circa mille immagini. Mantieni quest'ordine.
- Prima tecnica e soggetto: «An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms». La tecnica messa all'inizio colora tutto ciò che segue.
- Ambientazione: luogo, epoca, meteo, o ciò che riempie l'aria. «in falling cherry blossoms», «in the 1980s», «during a blizzard».
- Luce con la sua direzione: «lit from the front by soft diffuse light, with gentle shadows». La direzione viene rispettata. Un semplice «dramatic light» no.
- Inquadratura: «close-up of the subject, looking at the viewer», piano medio, visto dall'alto, il soggetto minuscolo in un paesaggio immenso.
- Materiali e tavolozza: «flowing ink lines, flat gold leaf background, muted jade and plum». È ciò che il modello rende meglio in 2K.
- Restrizioni, scritte nel prompt: «no lettering, no watermark», «five fingers on each hand». A guidance 1 il prompt negativo viene ignorato. Quindi deve farsene carico il prompt stesso.
Il prompt intero dell'illustrazione qui sopra, in quest'ordine: An art nouveau illustration of Motoko Kusanagi standing in falling cherry blossoms, a halo of circuit traces around her head like a stained glass window. Lit from the front by soft diffuse light, with gentle shadows. Close-up of the subject, looking at the viewer. Rendered with flowing ink lines, flat gold leaf background, muted jade and plum, fine ornamental borders. The atmosphere is calm and melancholic. Natural proportions, the face in focus. No text, no watermark.
Il testo funziona quando è tra virgolette e gli si dà un posto. «A banner above the door reads 'OPEN ALL NIGHT'» esce giusto quasi ogni volta, in maiuscolo o no.
Vale anche il contrario. Una vetrina, un diner o una sala giochi senza testo richiesto si riempiono di un'insegna inventata. Quindi scrivi «no lettering» ogni volta che la scena contiene una facciata.
I personaggi che il modello non conosce vengono sostituiti da un sosia senza avviso. Il Marsupilami è diventato una scimmia. Mothra e Marvin the Martian sono usciti giusti.
Ogni card Qwen della pagina di esempi di prompt segue questa struttura, con seed, dimensione e impostazioni.
Impostazioni che funzionano, misurate
Il template ufficiale di ComfyUI gira con una guidance (CFG) di 1 e 25 passi. La scheda del modello usa 40 passi. Le impostazioni qui sotto si sono fermate su CFG 3.
All'ultimo test, il 16 ottobre 2026, sugli stessi seed, queste impostazioni hanno dato le immagini più dettagliate e più fedeli:
| Impostazione | Valore |
|---|---|
| Guidance (CFG) | 3, con un prompt negativo |
| Prompt negativo | artifacts, washed-out colors, low quality, low resolution, blurry, extra fingers, missing fingers, deformed hands, bad anatomy, extra limbs, text, watermark, signature |
| Patch del modello | APG (eta 1, norm threshold 10, momentum 0,3) e poi FreSca (low 1, high 2, cutoff 8), prima del sampler |
| Sampler | euler, scheduler simple |
| Passi | 25 a 1 megapixel, 20 a 2,5 e 4 megapixel |
| LoRA | nessuno |
La guidance è l'unica impostazione che non cambia la scena. A parità di seed e dimensione, CFG 1 e CFG 3 danno quasi la stessa composizione. Ciò che differisce è la resa.
A CFG 1 l'immagine è più piatta e perde la texture fine. I punti di un ricamo diventano stoffa. Un viso da cartone animato perde pupille e bocca. Il metallo perde i rivetti.
Portare CFG 1 a 30 passi riporta la nitidezza, ma non i materiali né il contrasto. A 2 megapixel, una dimensione provata una volta, 40 passi danno un'immagine pulita ma comunque più piatta, e legge il prompt con meno affidabilità.
APG evita che CFG 3 saturi troppo. FreSca affila le alte frequenze. Entrambi agiscono solo quando la guidance è sopra 1.
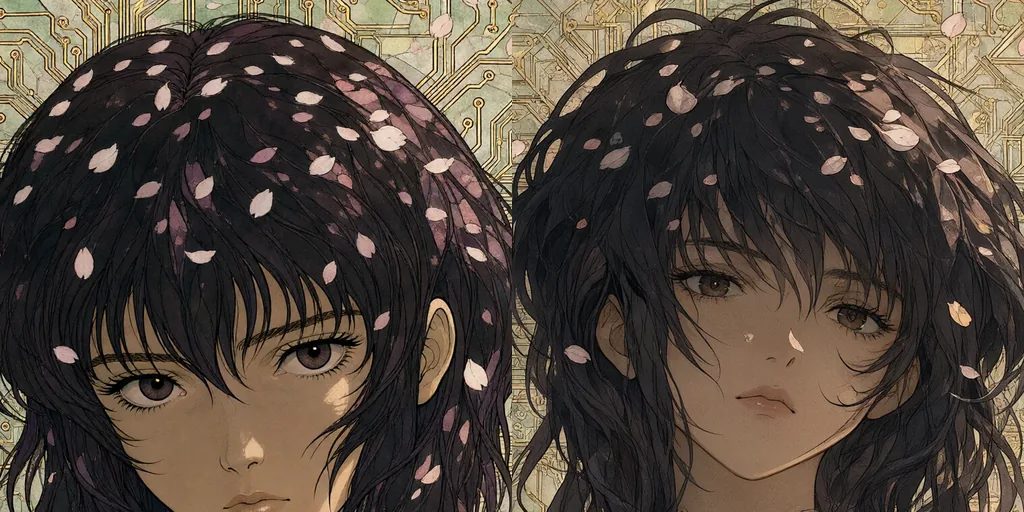
Una guidance sopra 1 costa un secondo passaggio per ogni passo, quindi CFG 1 è due volte più veloce. Sulla scheda di prova sono da 120 a 135 secondi contro 255 a 275 per un'immagine da 4 megapixel. La versione lenta ne è valsa la pena in ognuna delle dieci coppie di prova.
Risoluzione e passi: cosa cambia l'immagine
Come ogni modello di diffusione, Qwen-Image 2.1 non ridimensiona l'immagine quando cambia la dimensione. Produce un'altra ripresa dello stesso seed, quindi un seed trovato a 1 megapixel non si trasferisce a 2K.
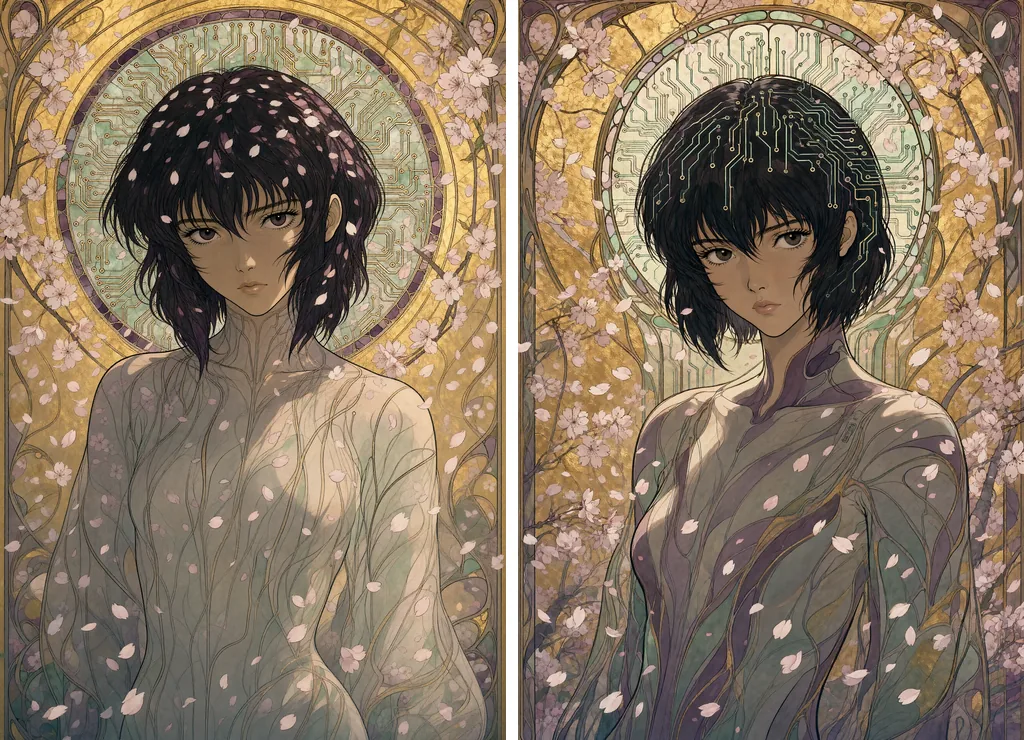
Passare da 1 megapixel a 2,5 o 4 ha dato un'immagine diversa in ogni coppia provata. Tra 2,5 e 4 megapixel la composizione ha tenuto in otto coppie su dieci.
Nell'illustrazione qui sotto si sono mossi solo i dettagli. A 2,5 megapixel le piste di circuito hanno lasciato l'aureola per i capelli.
Anche cambiare il numero di passi cambia l'immagine quando lo scarto è grande. 20 e 25 passi danno quasi la stessa immagine. Con 16 passi se ne allontana. Non c'è quindi modo di fare un'anteprima a 1 megapixel e renderizzare la stessa immagine più grande. Scegli prima la dimensione, poi il seed.
Tempi misurati con CFG 3, APG e FreSca, pesi int8, su una sola scheda consumer da 16 GB, in orizzontale o nell'equivalente verticale:
| Dimensione | Passi | Tempo per immagine |
|---|---|---|
| 1 megapixel (1216 × 832) | 25 | circa 40 s |
| 2,5 megapixel (1920 × 1312) | 20 | da 120 a 135 s |
| 4 megapixel (2432 × 1664) | 20 | da 255 a 275 s |
| 4 megapixel | 25 | da 315 a 335 s |
A 2,5 megapixel il dettaglio è un po' più morbido che a 4 quando si confronta la stessa zona al 100 %. Ma il modello segue lo stile del prompt almeno altrettanto bene, e nelle dieci coppie di prova a volte meglio. Un ricamo ha mostrato i punti più chiaramente a 2,5 megapixel che a 4.
Per una galleria servita a 1024 pixel, 2,5 megapixel a 20 passi è il punto giusto. Per una stampa, 4 megapixel a 20 passi.
Accelerare: Turbo, Turbo guidato e il resto
Il Turbo. Qwen ha pubblicato Qwen-Image-2.1-Turbo il 9 ottobre 2026. È un checkpoint distillato che gira in 8 passi a CFG 1 con una sequenza di sigma fissa. Comfy-Org lo distribuisce come file int8 e come LoRA per il modello base, con i suoi template in ComfyUI. È stato misurato il 17 ottobre sugli stessi dieci seed e dimensioni dei render a CFG 3 di questa guida, con il grafo esatto del template.
| Impostazione | Tempo per immagine |
|---|---|
| Checkpoint Turbo, 8 passi, CFG 1, 1 megapixel | da 9 a 10 s |
| Checkpoint Turbo, 8 passi, CFG 1, 4 megapixel | da 38 a 39 s |
| Turbo guidato, descritto più sotto: checkpoint Turbo, 8 passi, CFG 3 con APG e FreSca, 4 megapixel | da 66 a 71 s |
| Checkpoint base più LoRA Turbo, 8 passi, CFG 1, 4 megapixel | da 52 a 55 s |
| Checkpoint base, CFG 3, 20 passi, 4 megapixel | da 255 a 275 s |
Sette volte più veloce a 4 megapixel, quattro volte a 1. Le immagini sono pulite: nitide, ben illuminate, nessuno scivolone anatomico sui dieci seed, scritte corrette sugli stessi prompt del modello base. Gli oggetti del prompt ci sono, a volte meglio che con il modello base. La tartaruga nella sua auto da corsa, che il modello base aveva lasciato fuori in ogni render, con il Turbo è comparsa.
Ciò che perde è la tecnica. Su ogni prompt non fotografico dei dieci seed, il modello distillato è scivolato verso il realismo fotografico. Un ricamo di un coccodrillo è diventato una fotografia di un coccodrillo. Un disegno a carboncino ha perso la grana. Un Marvin the Martian in carta ritagliata si è trasformato in un giocattolo di vinile. Le scritte inventate sulle facciate sono le stesse del modello base.
Sui dieci seed, il LoRA sul checkpoint base ha dato le stesse immagini del checkpoint Turbo, solo più lentamente. Quindi è il checkpoint quello da scaricare. Un seed dà un'immagine diversa da quella del modello base, come a ogni cambio di dimensione. La licenza è la stessa: solo ricerca e valutazione.
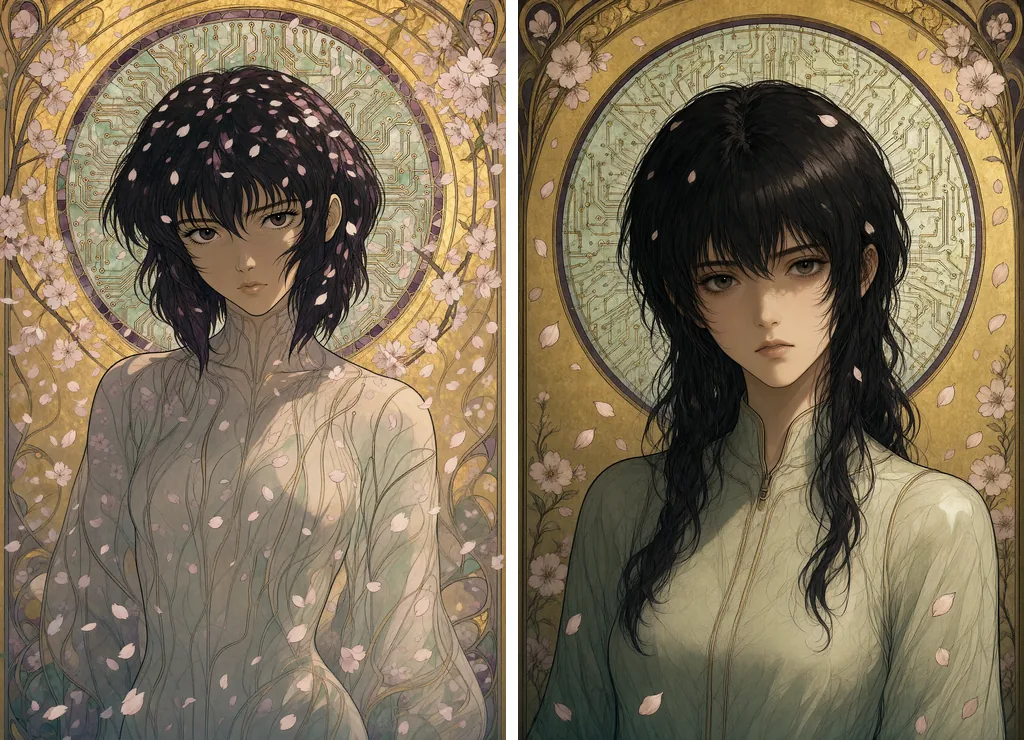
Il Turbo guidato. Il Turbo non è bloccato a CFG 1. Provato il 17 ottobre 2026 sugli stessi dieci seed più l'illustrazione di questa guida. Tieni il suo checkpoint e i suoi 8 sigma fissi, e prendi solo il blocco di guidance del preset base: CFG 3, il prompt negativo, APG e poi FreSca.
Il grafo è il template Turbo stesso. Imposta il suo CFGGuider a 3 invece di 1, compila il prompt negativo e inserisci APG e poi FreSca sul percorso del modello tra il loader e il guider. Il nodo ManualSigmas e il sampler restano come sono.
Il risultato mantiene la composizione del Turbo e recupera ciò che CFG 1 aveva appiattito: contrasto, saturazione e dettaglio fine. Sull'illustrazione di questa guida, le piste di circuito dell'aureola tornano nitide e dorate, e i petali ricompaiono. Sui dieci seed di prova, le squame, il pelo e il gilet ricamato guadagnano nitidezza allo stesso modo. Ciò che non recupera è la tecnica. Il ricamo resta una fotografia di un coccodrillo.
Il costo è il secondo passaggio per ogni passo: da 66 a 71 secondi per un'immagine da 4 megapixel contro 38 a 39. È ancora quasi quattro volte più veloce del modello base.
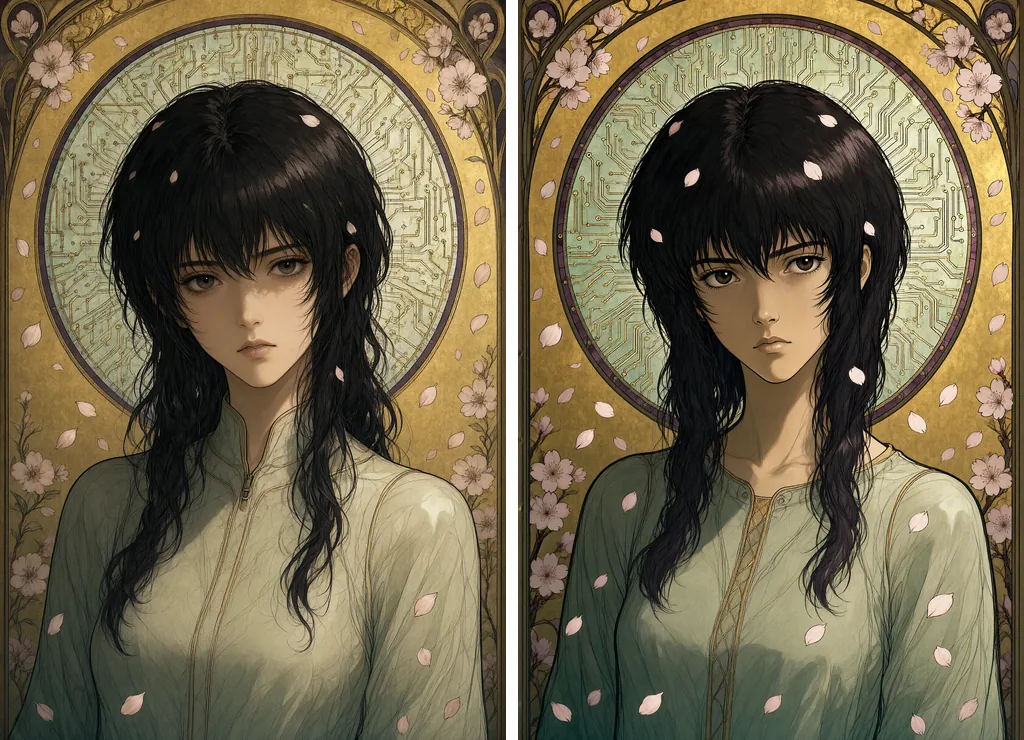
Scarica il workflow. Il workflow ComfyUI del Turbo guidato (JSON) renderizza questa illustrazione così com'è: 1664 × 2432, seed 57658043, CFG 3 con APG e FreSca, il prompt negativo di questa guida. Trascina il file in ComfyUI; si aspetta i tre file di modello indicati nell'ultima sezione. Libero riutilizzo sotto CC BY 4.0, con un link a questa pagina.
Non provare ad aiutare il Turbo con più passi. Con 20 passi e lo scheduler simple a 4 megapixel e CFG 3, come se fosse il modello base, cuoce troppo: ciocche di capelli dure, un'aureola granulosa, contrasto spinto. E impiega 169 secondi. Il checkpoint distillato vuole i suoi 8 sigma.
Una divisione sensata. Il Turbo semplice come modalità bozza, con sette volte più candidate all'ora tra cui scegliere. Il Turbo guidato quando un prompt fotografico o dalle linee pulite ha bisogno di dettaglio in fretta. Il modello base a CFG 3 per tutto ciò che è dipinto, disegnato o artigianale, dove è la tecnica stessa a contare.
Altre distillazioni. LightX2V ha pubblicato un LoRA Lightning a 4 passi per la 2.1 il 13 ottobre 2026. Esiste anche un LoRA della community a 8 passi, Turbo8. Entrambi girano a CFG 1 come il Turbo. Nessuno dei due è stato misurato qui.
Il nodo di cache del prefisso. Il nodo QwenImage21Cache di ComfyUI imposta solo il dispositivo e la precisione della cache che il modello già mantiene. Con i valori predefiniti non cambia nulla. La sua modalità int8 dimezza la cache, il che aiuta quando la memoria scarseggia in 2K o nell'editing con più immagini di riferimento. In queste prove non ha portato alcuna perdita visibile.
Meno passi. 16 passi fanno risparmiare circa un quinto del tempo, ma cambiano la composizione e non guadagnano nitidezza rispetto a 20. Se il vincolo è il tempo, abbassa la dimensione prima dei passi.
Eseguire Qwen-Image 2.1 in locale
ComfyUI supporta il modello nativamente. Tre file vanno nelle cartelle consuete: il modello di diffusione in diffusion_models, il codificatore di testo Qwen3-VL in text_encoders, il VAE in vae.
Su una scheda da 16 GB, prendi le versioni int8 pubblicate da Comfy-Org. I pesi bf16 funzionano anch'essi, ma traboccano nella memoria di sistema e impiegano da due a sei volte di più senza alcun guadagno visibile.
Il grafo è corto:
- UNETLoader, CLIPLoader con il tipo
qwen_image, VAELoader; - TextEncodeQwenImage21, che prende insieme il prompt e il prompt negativo e restituisce entrambi i conditioning;
- un latente vuoto alla dimensione scelta;
- APG e poi FreSca sul percorso del modello;
- un KSampler a CFG 3 con euler e lo scheduler simple, poi VAEDecode.
Per un'immagine trasparente, racchiudi il soggetto nella forma raccomandata dalla scheda del modello: «This is an RGBA image with transparency. [the subject]. The image has alpha channel and the background is transparent.» Poi salva in PNG.
Memoria: a 1 megapixel, il modello int8, il codificatore e il VAE girano in 16 GB senza toccare la memoria di sistema. ComfyUI scarica il codificatore dalla memoria video una volta codificato il prompt. A 4 megapixel la cache del prefisso è stata impostata su int8, e la memoria non si è mai esaurita. La prima immagine di una sessione richiede più tempo mentre i file si caricano.